
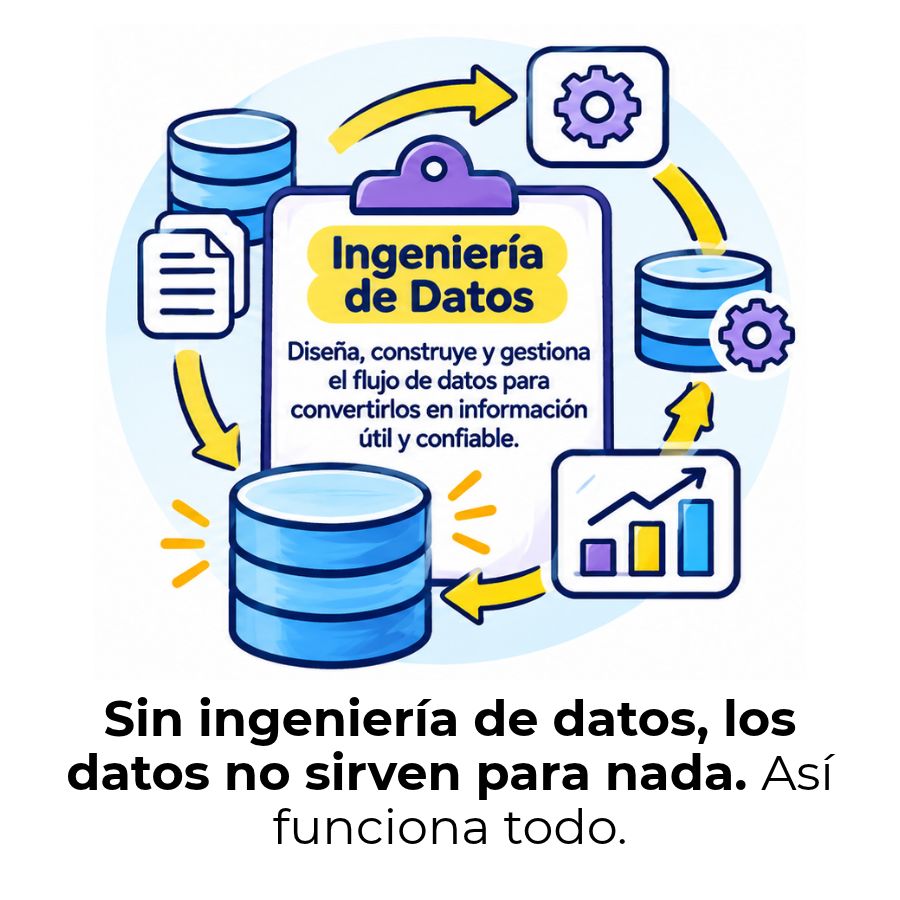
Cada vez que una app te recomienda algo, una empresa toma una decisión o un modelo de inteligencia artificial predice un resultado, hay un trabajo invisible que lo hace posible. No es magia ni casualidad: es infraestructura. Y esa infraestructura tiene nombre: ingeniería de datos.
¿Qué es la ingeniería de datos?
La ingeniería de datos es la disciplina que diseña, construye y mantiene los sistemas que permiten recopilar, mover, transformar y almacenar grandes volúmenes de información de forma confiable y organizada. Su trabajo ocurre antes de cualquier análisis: sin esta base, los datos llegan incompletos, desordenados o simplemente inutilizables para quienes los necesitan.
Piénsalo así: los datos son como el agua de un río. La ingeniería de datos construye el sistema de tuberías, depuradoras y depósitos que garantizan que esa agua llegue limpia, en la cantidad correcta y exactamente donde se necesita. No importa cuánta agua haya si las tuberías no funcionan.
¿Por qué existe la ingeniería de datos?
Las organizaciones acumulan volúmenes enormes de información proveniente de múltiples fuentes: sistemas internos, aplicaciones, sensores, transacciones y redes externas. El problema no es la falta de datos, sino la dificultad de hacerlos accesibles, limpios y coherentes para quienes los necesitan tomar decisiones o construir modelos.
La ingeniería de datos nació como respuesta a ese reto. Antes de que existiera como disciplina formal, los propios científicos de datos dedicaban la mayor parte de su tiempo a limpiar y preparar información en lugar de analizarla. Al separar estas tareas, cada rol puede concentrarse en lo que mejor sabe hacer.
El ciclo de vida de la ingeniería de datos
El trabajo de un ingeniero de datos no empieza y termina en un solo punto: sigue un ciclo completo que abarca desde el momento en que los datos se originan hasta que llegan a manos de quienes los utilizan. Cada etapa del ciclo tiene un propósito específico y depende de la anterior para funcionar correctamente.
Ingesta de datos
La ingesta es el primer paso del ciclo: el momento en que los datos se extraen de sus fuentes originales y se introducen en el sistema. Puede ocurrir de dos formas: en lotes (batch), donde los datos se recopilan periódicamente, o en tiempo real (streaming), donde fluyen de forma continua. La elección entre uno y otro depende de la urgencia con la que el negocio necesite esa información.
En esta etapa es donde entra en juego la ingesta de datos como proceso técnico estructurado. No se trata solo de copiar archivos: implica garantizar que los datos lleguen completos, en el formato esperado y sin pérdidas durante el transporte, independientemente del volumen o la velocidad con que se generen.
Almacenamiento y transformación
Una vez ingestados, los datos necesitan un lugar donde residir y un proceso que los convierta en algo útil. El almacenamiento puede adoptar diferentes formas según el tipo de información y el uso que se le dará. La transformación, por su parte, es el proceso que limpia, normaliza, enriquece y da estructura a los datos brutos para que puedan ser consumidos.
Aquí cobran protagonismo herramientas como DBT para la transformación declarativa, y los conceptos de data warehouse y data lake como repositorios centrales. Cada opción responde a necesidades distintas, y un buen ingeniero sabe cuándo usar cada una.
Servicio y consumo de los datos
La última etapa del ciclo es la que da sentido a todo lo anterior: poner los datos procesados a disposición de quienes los necesitan. Científicos de datos, analistas de negocio, modelos de inteligencia artificial y paneles de visualización son los consumidores finales de este trabajo. Si esta etapa falla, todo el esfuerzo anterior pierde su propósito.
El servicio de datos también incluye el control de accesos, la documentación de lo disponible y la garantía de que la información se mantiene actualizada. Sin estas condiciones, incluso los datos mejor procesados se vuelven poco confiables para quien los usa a diario.
¿Qué hace un ingeniero de datos en su trabajo diario?
El ingeniero de datos no es alguien que analiza resultados ni construye modelos predictivos. Su trabajo es construir y mantener la infraestructura que hace posible que todo lo demás funcione. En la práctica, eso se traduce en un conjunto de tareas técnicas que se repiten, evolucionan y escalan a medida que crece el volumen de información de la organización.
Construcción y mantenimiento de pipelines
Un pipeline de datos es el conjunto de pasos automatizados que mueven y transforman la información desde su origen hasta su destino final. Diseñar un pipeline robusto implica anticipar fallos, gestionar reintentos, monitorizar el rendimiento y garantizar que los datos lleguen íntegros en cada ejecución.
El mantenimiento es igual de importante que la construcción. Los sistemas cambian, las fuentes de datos se modifican y los volúmenes crecen. Un pipeline que funciona hoy puede romperse mañana si nadie lo supervisa activamente. Por eso, el ingeniero de datos también es responsable de la estabilidad continua de estos flujos.
Garantía de calidad de los datos
La calidad de datos es una de las responsabilidades más críticas del rol. Datos duplicados, valores nulos sin justificación, formatos inconsistentes o registros erróneos contaminan cualquier análisis posterior y generan decisiones equivocadas. El ingeniero de datos implementa validaciones automáticas dentro de los pipelines para detectar y corregir estos problemas antes de que lleguen al consumidor final.
Esta tarea incluye definir reglas de validación, establecer alertas cuando los datos se desvían de lo esperado y documentar los criterios de calidad para que el equipo completo trabaje con los mismos estándares. La calidad no es un proceso puntual: es una práctica permanente.
Colaboración con otros roles del ecosistema
El ingeniero de datos no trabaja de forma aislada. Interactúa constantemente con arquitectos de datos, científicos de datos, analistas y equipos de negocio para entender qué información necesitan, en qué formato y con qué frecuencia. Esta colaboración determina cómo se diseñan los sistemas y qué prioridades se establecen en cada etapa.
Las habilidades de comunicación son tan necesarias como las técnicas. Un ingeniero que no entiende las necesidades del negocio construye infraestructura que nadie usa. Uno que no puede explicar las limitaciones técnicas a su equipo genera expectativas imposibles de cumplir. El equilibrio entre ambas dimensiones define a los profesionales más valorados del campo.
Herramientas y tecnologías de la ingeniería de datos
El ecosistema de herramientas de la ingeniería de datos es amplio y evoluciona rápidamente. No existe una sola combinación correcta: la elección depende del tipo de datos, el volumen, la velocidad de procesamiento requerida y la infraestructura disponible en cada organización. Conocer las principales categorías es el primer paso para orientarse en este entorno.
Lenguajes de programación esenciales
Dos lenguajes dominan el día a día de la ingeniería de datos: Python y SQL. Python ofrece una enorme flexibilidad para construir pipelines, automatizar tareas y conectar con múltiples herramientas del ecosistema. SQL, por su parte, sigue siendo el lenguaje fundamental para consultar, transformar y manipular datos en bases de datos relacionales y en la mayoría de los almacenes de datos modernos.
Scala y Java también tienen presencia en entornos de procesamiento distribuido a gran escala. Scala, en particular, es el lenguaje nativo de Apache Spark, una de las plataformas más utilizadas para procesar grandes volúmenes de datos de forma paralela y eficiente.
Plataformas de almacenamiento y procesamiento
Orquestación y transformación de datos
Las herramientas de orquestación son las encargadas de coordinar el orden de ejecución de las tareas dentro de un pipeline. Apache Airflow es la más extendida: permite definir flujos de trabajo como código, gestionar dependencias entre tareas y reintentar automáticamente las que fallan. Alternativas como Dagster o Prefect ofrecen enfoques más modernos con mejor observabilidad.
En el plano de la transformación, DBT (Data Build Tool) se ha convertido en una herramienta de referencia para transformar datos directamente dentro del almacén mediante SQL versionado y con pruebas integradas. Su adopción ha crecido por la claridad que aporta a los procesos de transformación y por la facilidad con que permite colaborar en equipo.
¿En qué se diferencia la ingeniería de datos de otras disciplinas?
El ecosistema de datos tiene varios roles que a veces se confunden porque comparten herramientas o trabajan con la misma información. La clave para diferenciarlos está en el enfoque: quién construye la infraestructura, quién la diseña conceptualmente y quién extrae valor de los datos ya preparados.
Ingeniero de datos vs. científico de datos
El ingeniero de datos construye los sistemas que mueven y preparan la información. El científico de datos usa esa información para construir modelos estadísticos, encontrar patrones y generar predicciones. Son roles complementarios: sin el trabajo previo del ingeniero, el científico no tiene datos limpios ni accesibles con los que trabajar. Sin el científico, la infraestructura no produce valor analítico.
Ingeniero de datos vs. arquitecto de datos
El arquitecto de datos diseña el plano conceptual: decide cómo deben organizarse los datos, qué tecnologías encajan con las necesidades del negocio y cuáles son los estándares que debe seguir la organización. El ingeniero de datos toma ese plano y lo convierte en realidad, implementando los sistemas, escribiendo el código y manteniendo lo construido operativo día a día. Puedes profundizar en esto al conocer la arquitectura de datos como disciplina propia.
Ingeniero de datos vs. analista de datos
Arquitectura de datos: el marco que lo contiene todo
Antes de que el ingeniero de datos construya cualquier sistema, alguien definió cómo deben organizarse los datos en la organización. La arquitectura de datos es ese mapa: establece qué tecnologías se usan, cómo se relacionan entre sí y qué principios rigen el flujo de la información. Sin ese mapa, los sistemas se construyen de forma fragmentada y difícil de mantener.
Data warehouse y data lake
El data warehouse es un repositorio centralizado diseñado para almacenar datos estructurados y ya transformados, optimizado para consultas analíticas rápidas. El data lake, en cambio, almacena datos en su formato original, estructurados o no, y permite procesar grandes volúmenes sin definir la estructura de antemano. Ambos tienen sus casos de uso y muchas organizaciones utilizan los dos de forma complementaria.
Elegir entre uno y otro, o combinarlos en una arquitectura mixta, depende del tipo de datos que maneja la organización, la frecuencia de consulta y el nivel de transformación necesario antes del análisis. Esta decisión es parte del diseño de arquitectura de datos que da coherencia a todo el ecosistema.
Pipelines de datos y procesos ETL
Los procesos ETL (Extraer, Transformar y Cargar) son el motor operativo de la mayoría de los pipelines. Extraen datos de sus fuentes originales, los transforman según las reglas de negocio definidas y los cargan en el destino final, ya sea un data warehouse, un data lake o cualquier otro repositorio. Este flujo es el corazón de la ingeniería de datos en la práctica.
El particionamiento de datos es una técnica que se aplica dentro de este flujo para dividir grandes conjuntos de datos en fragmentos más manejables. Esto mejora notablemente el rendimiento de las consultas y reduce los tiempos de procesamiento cuando se trabaja con volúmenes muy elevados de información.
Habilidades para convertirte en ingeniero de datos
La ingeniería de datos combina conocimientos técnicos profundos con capacidades de comunicación y resolución de problemas. No existe un único camino para llegar a este rol, pero sí un conjunto de habilidades que casi todos los profesionales del campo comparten. Conocerlas te permite evaluar dónde estás y qué necesitas desarrollar para avanzar.
Habilidades técnicas (hard skills)
El dominio técnico es la base del perfil. Las habilidades más valoradas en el mercado actual son:
- SQL avanzado: Consultas complejas, optimización de rendimiento, ventanas de análisis y manipulación de datos en entornos estructurados. Es el lenguaje que todo ingeniero de datos debe dominar sin importar el stack tecnológico.
- Python para datos: Automatización de procesos, construcción de pipelines, integración con APIs y manipulación de datos con librerías como Pandas y PySpark.
- Conocimiento de bases de datos: Tanto relacionales (PostgreSQL, MySQL) como no relacionales (MongoDB, Cassandra). Saber cuándo usar cada modelo es tan importante como saber operarlo. La ingeniería de base de datos es una especialidad complementaria que profundiza en este área.
- Herramientas ETL y orquestación: Apache Airflow, dbt y tecnologías equivalentes para automatizar y coordinar flujos de trabajo de datos de forma confiable.
- Plataformas cloud: AWS, Google Cloud Platform o Microsoft Azure son los entornos donde opera la mayoría de la infraestructura de datos moderna. Conocer al menos uno de ellos marca una diferencia real.
- Procesamiento distribuido: Apache Spark y sistemas similares son esenciales para trabajar con volúmenes de datos que no caben en una sola máquina.
Habilidades blandas (soft skills)
- Comunicación clara: Traducir conceptos técnicos para equipos no técnicos es parte del trabajo diario. Un ingeniero que no comunica bien sus decisiones crea fricciones innecesarias en el equipo.
- Visión de negocio: Entender qué necesita la organización y por qué, no solo cómo construirlo técnicamente. Los mejores ingenieros de datos piensan en el impacto de lo que construyen.
- Resolución de problemas bajo presión: Los sistemas de datos fallan. Saber diagnosticar rápidamente, priorizar la solución y mantener la calma mientras los datos no llegan es una habilidad que se valora enormemente.
- Atención al detalle: Un campo erróneo en un pipeline puede contaminar semanas de análisis. La precisión no es opcional en este rol.
- Aprendizaje continuo: Las herramientas cambian con rapidez. Los ingenieros de datos más efectivos son quienes adoptan nuevas tecnologías con curiosidad y sin resistencia.
¿Cómo aplicar la ingeniería de datos en una empresa?
Llevar la ingeniería de datos a una organización no requiere empezar con la infraestructura más compleja del mercado. El primer paso siempre es identificar qué datos existen, dónde están y quién los necesita. Sin ese mapa inicial, cualquier inversión tecnológica corre el riesgo de construir sistemas que nadie usa o que resuelven problemas equivocados.
Una vez identificadas las fuentes y los consumidores de datos, el siguiente movimiento es definir un catálogo de datos: un inventario documentado de qué información está disponible, qué significa cada campo y quién es responsable de su calidad. Este recurso evita duplicidades, reduce la confusión entre equipos y acelera enormemente el trabajo de cualquier persona que necesite acceder a los datos.
El tercer paso es construir los primeros pipelines, priorizando los flujos de datos más críticos para el negocio. No hace falta automatizar todo de golpe. Empezar con los procesos que generan más valor y escalar progresivamente es la estrategia más efectiva para implementar ingeniería de datos sin colapsar al equipo ni gastar recursos antes de validar que la solución funciona.
En organizaciones más maduras, la ingeniería de datos también incluye la gestión de la observabilidad: saber en todo momento si los pipelines están funcionando, si los datos llegan a tiempo y si su calidad se mantiene dentro de los parámetros esperados. Esta capacidad de monitorización convierte una infraestructura de datos reactiva en un sistema proactivo y confiable.
Preguntas frecuentes
¿Qué estudiar para ser ingeniero de datos?
No existe un único camino formativo. Muchos ingenieros de datos provienen de carreras como Ciencias de la Computación, Ingeniería en Sistemas, Matemáticas o Estadística, aunque también hay profesionales que llegaron al rol desde la programación o el análisis de datos mediante formación autónoma y certificaciones especializadas. Lo más importante es construir una base sólida en SQL, Python, fundamentos de bases de datos y conceptos de procesamiento de datos. Plataformas como Coursera, DataCamp o edX ofrecen rutas estructuradas para adquirir estas habilidades de forma progresiva. El portafolio de proyectos reales pesa tanto o más que el título académico a la hora de acceder al mercado laboral.
¿Cuánto gana un ingeniero de datos?
La remuneración varía considerablemente según el país, el nivel de experiencia, el tamaño de la empresa y el stack tecnológico dominado. En términos generales, la ingeniería de datos se encuentra entre los roles mejor pagados del ecosistema tecnológico, por encima de la media del sector. Los perfiles con dominio de plataformas cloud, procesamiento distribuido y herramientas modernas de orquestación suelen alcanzar las compensaciones más altas. En Latinoamérica, el trabajo remoto para empresas de América del Norte o Europa ha abierto acceso a salarios que antes estaban fuera del alcance de la región, lo que convierte este rol en una de las opciones más atractivas para profesionales técnicos.
¿Es lo mismo ingeniería de datos que big data?
No son lo mismo, aunque están relacionados. Big data es un término que describe el fenómeno de trabajar con volúmenes de datos tan grandes que las herramientas tradicionales no pueden manejarlos. La ingeniería de datos, en cambio, es la disciplina que construye los sistemas y procesos para gestionar cualquier volumen de datos, incluidos los que entran en la categoría de big data. Dicho de otro modo: la ingeniería de datos es la respuesta técnica al reto que plantea el big data, pero también aplica a contextos donde los volúmenes son más moderados y las herramientas no necesitan ser tan complejas.
¿Qué lenguaje de programación necesita un ingeniero de datos?
SQL y Python son los dos lenguajes fundamentales que cualquier ingeniero de datos debe dominar. SQL es imprescindible para consultar, transformar y manipular datos en casi cualquier entorno de almacenamiento. Python ofrece la flexibilidad necesaria para construir pipelines, automatizar procesos e integrarse con el ecosistema de herramientas de datos. Scala también tiene presencia importante, especialmente en entornos de procesamiento distribuido con Apache Spark. Java aparece en algunas organizaciones con infraestructura más antigua. En la práctica, la mayoría de los roles del mercado requieren SQL avanzado y Python como mínimo, con valoración adicional por conocimiento de Scala o herramientas cloud específicas.
¿Cuál es la diferencia entre un data engineer y un data scientist?
La diferencia más clara está en el enfoque de su trabajo. El data engineer construye y mantiene la infraestructura: los pipelines, los almacenes de datos y los sistemas que mueven la información. El data scientist usa esa infraestructura para analizar los datos, encontrar patrones y construir modelos predictivos. El primero garantiza que los datos estén disponibles y en buen estado; el segundo les da sentido analítico. Son roles complementarios y, en muchas organizaciones, colaboran estrechamente. Sin un buen trabajo de ingeniería de datos previo, el científico de datos no tiene material confiable con el que trabajar.
¿Qué es un pipeline de datos y para qué sirve?
Un pipeline de datos es un conjunto de pasos automatizados que extraen datos de una o varias fuentes, los transforman según reglas definidas y los depositan en un destino final donde pueden ser consultados o analizados. Su propósito es que el movimiento y la transformación de los datos ocurran de forma confiable, repetible y sin intervención manual constante. Un pipeline bien construido puede ejecutarse miles de veces sin fallar, gestionar errores de forma automática y mantener un registro de cada ejecución para facilitar la depuración cuando algo sale mal. Son la columna vertebral de cualquier sistema de datos en producción.
¿Es necesario saber matemáticas para trabajar en ingeniería de datos?
En comparación con la ciencia de datos o el aprendizaje automático, la ingeniería de datos requiere un nivel de matemáticas menos profundo. Lo más importante es tener una comprensión sólida de lógica, álgebra básica y estadística descriptiva elemental, que se aplican al entender distribuciones de datos, detectar anomalías y validar transformaciones. No necesitas cálculo avanzado ni álgebra lineal para construir pipelines o diseñar bases de datos. Sin embargo, cuanto más te acerques a los entornos de machine learning o analítica avanzada, más útil resulta tener una base matemática más amplia. Para empezar, la lógica de programación y el pensamiento estructurado son mucho más determinantes que el dominio matemático.
Conclusión
La ingeniería de datos es la disciplina que hace posible que la información de una organización fluya de forma confiable desde sus fuentes originales hasta quienes la necesitan para tomar decisiones, construir modelos o generar análisis. No es el rol más visible del ecosistema, pero sí el que sostiene todo lo demás. Sin una buena ingeniería de datos detrás, ni el análisis más sofisticado ni el modelo de inteligencia artificial más avanzado puede funcionar correctamente.
Ahora conoces los conceptos clave: el ciclo de vida de los datos, las herramientas más utilizadas, las diferencias con otros roles y las habilidades que necesitas desarrollar para moverte en este campo. El siguiente paso es practicar: construye un pipeline sencillo, explora SQL con datos reales o familiarízate con alguna herramienta de orquestación. Cada pequeño proyecto concreto te enseña más que horas de teoría.
Si este tema te ha abierto el apetito, en este sitio web encontrarás contenido sobre cada una de las disciplinas y herramientas que conforman el ecosistema de datos: desde los fundamentos más básicos hasta los conceptos más avanzados del campo. Cada artículo está pensado para que aprendas a tu propio ritmo, con claridad y sin atajos.
Sigue aprendiendo:
Linaje de datos: El mapa oculto detrás de cada dato
Certificaciones para ingeniero de datos
100 preguntas de entrevista para ingeniero de datos
Modelado dimensional: Organiza datos para tomar mejores decisiones
¿Qué es un data lake y cómo funciona?
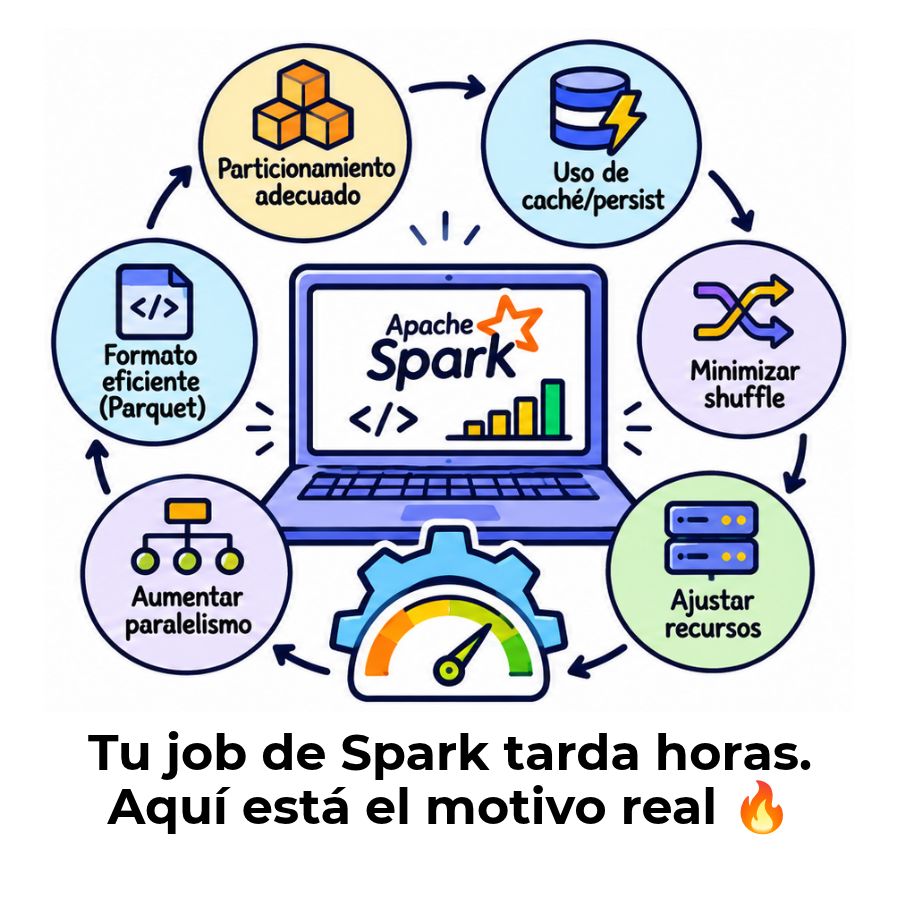
¿Cómo optimizar jobs de Apache Spark?
Dimensiones de cambio lento: Conserva tu historial sin perder datos
Microsoft Fabric y Azure Synapse Analytics
