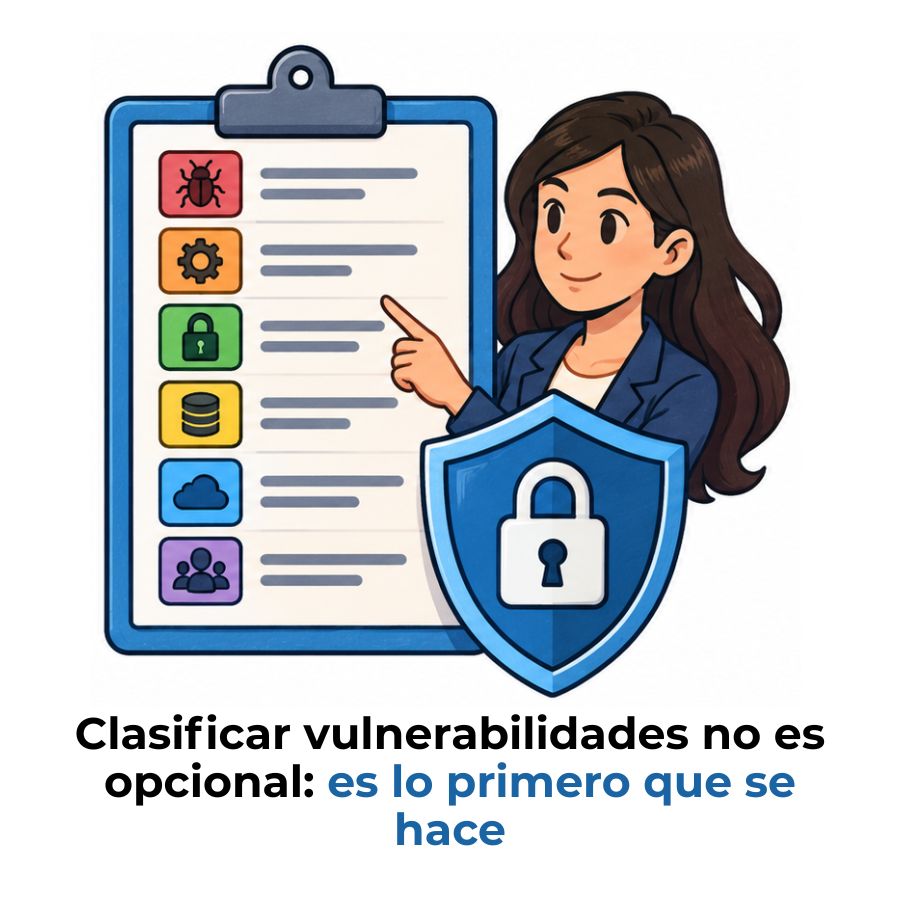
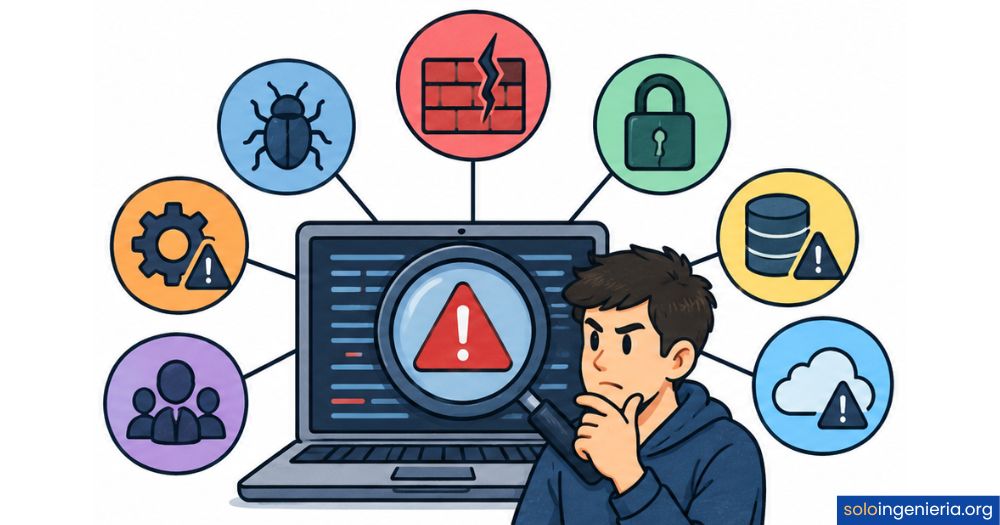
Las vulnerabilidades informáticas no son todas iguales ni representan el mismo nivel de riesgo. Los expertos las clasifican según su origen, el componente que afectan y su nivel de gravedad. Si quieres entender cómo funciona este proceso, a continuación encontrarás los criterios, los tipos más importantes y los estándares internacionales que los profesionales de la seguridad usan para medir y priorizar cada fallo detectado.
¿Qué es una vulnerabilidad informática?
Una vulnerabilidad informática es un fallo, error o debilidad en el diseño, implementación o administración de un sistema, software o red que puede ser aprovechado por un atacante para acceder a información, alterar el funcionamiento del sistema o causar daños. No se trata de un ataque en sí mismo, sino de una condición que hace posible que ese ataque ocurra. Piénsalo como una puerta entreabierta: el riesgo existe aunque nadie haya entrado todavía.
Detectar estas debilidades a tiempo es una de las tareas más importantes dentro de la Ingeniería en Ciberseguridad, porque la mayoría de los ataques exitosos no explotan tecnología sofisticada, sino fallos conocidos que simplemente no se corrigieron a tiempo. Por eso, antes de buscar soluciones, los profesionales primero necesitan entender qué tipo de vulnerabilidad tienen frente a ellos.
Diferencia entre vulnerabilidad, amenaza y riesgo
Estos tres términos suelen mezclarse, pero en ciberseguridad tienen significados precisos y distintos. Una vulnerabilidad es el fallo que existe en el sistema; la amenaza es el agente o acción capaz de aprovecharlo; y el riesgo es la probabilidad de que eso suceda y el impacto que tendría. Un sistema puede tener una vulnerabilidad sin que haya ninguna amenaza activa, y aun así ese fallo debe gestionarse con criterio.
La confusión entre estos conceptos lleva a errores frecuentes: tratar toda vulnerabilidad como un riesgo inmediato o, al contrario, ignorar fallos porque «nadie los ha explotado aún». Entender la diferencia es el punto de partida para gestionar la seguridad de forma ordenada y con criterio real, no solo reactivo. La clasificación de vulnerabilidades es, precisamente, la herramienta que permite hacer eso bien.
¿Cómo se clasifican las vulnerabilidades informáticas?
Las vulnerabilidades informáticas se clasifican usando varios criterios al mismo tiempo, no uno solo. Los tres ejes principales son el origen o naturaleza del fallo, el nivel de gravedad y el tipo de componente afectado. A estos se añaden los estándares internacionales, como el CVE o el CVSS, que aportan un lenguaje común para que los equipos de todo el mundo puedan hablar del mismo problema sin ambigüedades.
Esta clasificación no es un ejercicio teórico. Clasificar una vulnerabilidad correctamente determina con qué urgencia se actúa, qué recursos se destinan y qué tipo de solución se aplica. Un fallo de gravedad baja en un servidor interno no merece el mismo tratamiento que una vulnerabilidad crítica en una aplicación web expuesta a millones de usuarios. La clasificación es lo que permite tomar esa decisión con fundamento.
Clasificación por origen o naturaleza
El primer criterio que usan los profesionales de seguridad es el origen del fallo. Saber de dónde viene una vulnerabilidad ayuda a entender cómo pudo introducirse en el sistema y qué tipo de corrección necesita. Este eje clasifica las vulnerabilidades según el componente o la circunstancia que las generó: el software, el hardware, la red o el propio comportamiento de las personas.
Vulnerabilidades de software
Son las más frecuentes. Nacen de errores en el código, diseño deficiente o falta de actualizaciones en aplicaciones, sistemas operativos o librerías. Un software que no se actualiza puede tener fallos ampliamente documentados y disponibles para cualquier atacante que los busque. Este tipo de vulnerabilidades incluye desde bugs simples hasta problemas estructurales en la lógica del programa.
Vulnerabilidades de hardware
Estas debilidades residen en los componentes físicos del sistema: procesadores, chips de memoria, firmwares o dispositivos de almacenamiento. Un fallo de diseño en el hardware puede afectar a millones de dispositivos al mismo tiempo, porque el error está presente desde la fabricación. A diferencia del software, corregir una vulnerabilidad de hardware suele ser mucho más complejo y costoso, ya que en muchos casos no basta con instalar un parche.
Vulnerabilidades de red
Afectan a la infraestructura que conecta los sistemas: routers, switches, firewalls y protocolos de comunicación. Los puertos innecesarios abiertos o el uso de protocolos que no cifran la información son ejemplos clásicos de este tipo de fallo. Una red mal configurada puede exponer todos los sistemas que conecta, aunque cada uno de ellos individualmente esté bien protegido.
Vulnerabilidades por factor humano
Son las que menos atención técnica reciben, pero pueden tener consecuencias tan graves como cualquier fallo de código. Se asocian con falta de formación, contraseñas débiles, configuraciones incorrectas o comportamientos de riesgo por parte de los usuarios. Un empleado que hace clic en un enlace malicioso o usa la misma contraseña en todos sus sistemas abre una brecha que ningún sistema técnico puede cerrar por sí solo.
Clasificación por nivel de gravedad
No todas las vulnerabilidades representan el mismo peligro. El nivel de gravedad determina la urgencia con la que debe responderse a cada fallo y los recursos que se destinan a corregirlo. Para medirlo de forma objetiva y comparable entre organizaciones, se utiliza el estándar internacional CVSS, que asigna una puntuación numérica a cada vulnerabilidad detectada.
Escala CVSS: de 0 a 10
El Common Vulnerability Scoring System (CVSS) es un marco abierto que puntúa la severidad de cada vulnerabilidad en una escala del 0 al 10. Cuanto mayor es el número, mayor es la gravedad. Esta puntuación se calcula considerando varios factores: la facilidad con la que se puede explotar el fallo, si requiere acceso previo al sistema, si necesita interacción del usuario y el impacto que tendría sobre la confidencialidad, integridad y disponibilidad de la información.
El CVSS se compone de distintos grupos de métricas. Las métricas base reflejan las características intrínsecas del fallo; las métricas temporales consideran factores que pueden cambiar con el tiempo, como la disponibilidad de parches o exploits públicos; y las métricas de entorno permiten ajustar la puntuación al contexto específico de cada organización. La combinación de estos tres grupos da una imagen más precisa del riesgo real.
Niveles de gravedad: baja, media, alta y crítica
La puntuación CVSS se traduce en cuatro niveles de gravedad que orientan la respuesta del equipo de seguridad. Una vulnerabilidad baja tiene un impacto mínimo y puede gestionarse sin urgencia; la moderada tiene mayor alcance, pero también es manejable con los procedimientos habituales. La alta puede comprometer información del sistema y requiere atención prioritaria, mientras que la crítica representa el nivel máximo de riesgo: puede propagarse sin interacción del usuario y exige respuesta inmediata.
Clasificación por el componente afectado
Además del origen y la gravedad, las vulnerabilidades también se clasifican según qué parte del sistema afectan. Este criterio ayuda a identificar qué equipo o área debe actuar y qué tipo de solución técnica es la más adecuada. No es lo mismo un fallo en el sistema operativo que en una aplicación web o en la infraestructura de red, aunque los tres puedan tener un impacto grave si no se gestionan.
| Componente afectado | Descripción | Ejemplos típicos |
|---|---|---|
| Sistema operativo | Fallos en el núcleo o servicios del SO que permiten escalar privilegios o ejecutar código. | Escalada de privilegios, acceso no autorizado al kernel |
| Aplicación web | Errores en aplicaciones accesibles desde el navegador, con gran superficie de exposición. | Inyección SQL, XSS, control de acceso roto |
| Red e infraestructura | Configuraciones débiles en dispositivos de red que exponen el tráfico o los sistemas. | Protocolos sin cifrado, puertos abiertos innecesarios |
| Base de datos | Fallos que permiten leer, modificar o eliminar datos sin autorización. | Inyección SQL, permisos excesivos sobre tablas |
| Firmware y hardware | Vulnerabilidades en el software integrado de dispositivos o en los componentes físicos. | Fallos en BIOS, chips de procesador, dispositivos IoT |
Conocer el componente afectado también permite anticiparse. Si una organización sabe que sus aplicaciones web son su mayor superficie de exposición, puede centrar sus auditorías y controles en ese punto antes de que se produzca un incidente. Esta visión orientada al componente es una de las bases del análisis de riesgos en cualquier programa serio de seguridad.
Clasificación según el tipo de fallo técnico
Más allá del origen o del componente afectado, los fallos también se agrupan por su naturaleza técnica. Esta clasificación es especialmente útil para los equipos de desarrollo y seguridad ofensiva, porque identifica el patrón del fallo y permite diseñar contramedidas específicas. Algunos tipos de fallo aparecen una y otra vez en sistemas distintos, lo que los convierte en categorías bien documentadas con soluciones conocidas.
Desbordamiento de búfer (buffer overflow)
Ocurre cuando un programa no controla correctamente cuántos datos se copian en una zona de memoria (el búfer). Si se introducen más datos de los previstos, los bytes sobrantes se escriben en zonas adyacentes de la memoria, lo que puede sobrescribir instrucciones del programa y permitir que un atacante ejecute código arbitrario. Es uno de los tipos de fallo más antiguos y sigue siendo relevante en sistemas escritos en lenguajes como C o C++.
Inyección de código (SQL, XSS)
Las vulnerabilidades de inyección ocurren cuando una aplicación acepta datos del usuario sin validarlos correctamente y los utiliza en operaciones críticas. En una inyección SQL, el atacante inserta comandos de base de datos dentro de un campo de entrada para leer, modificar o eliminar datos. En un ataque XSS (Cross-Site Scripting), se inyecta código JavaScript en páginas vistas por otros usuarios para robar sesiones o redirigirlos a sitios falsos. Ambos tipos aparecen de forma recurrente en los informes de seguridad de aplicaciones web.
Errores de control de acceso
Este tipo de fallo ocurre cuando una aplicación permite que un usuario consulte datos o ejecute acciones para las que no tiene permiso. El problema puede manifestarse cuando alguien accede a funciones restringidas, modifica identificadores para ver información ajena o usa una API que no verifica correctamente la autorización. Esta categoría es una de las más frecuentes en los análisis de la organización OWASP, que la incluye de forma recurrente entre los principales riesgos de las aplicaciones web.
Estándares internacionales para clasificar vulnerabilidades
Para que los equipos de seguridad de todo el mundo puedan hablar del mismo problema sin ambigüedades, existen estándares internacionales que unifican la forma de identificar y clasificar vulnerabilidades. Sin este lenguaje común, dos organizaciones podrían referirse al mismo fallo con nombres distintos y actuar de forma descoordinada. Los tres estándares más utilizados son el CVE, el CWE y el CVSS, y cada uno cumple una función diferente dentro del proceso de gestión de vulnerabilidades.
CVE: identificador único de vulnerabilidades
El CVE (Common Vulnerabilities and Exposures) es un diccionario público de vulnerabilidades de seguridad, mantenido por la corporación MITRE. Cada vulnerabilidad conocida recibe un identificador único con el formato CVE-AÑO-NÚMERO, lo que permite que cualquier herramienta, base de datos o equipo de seguridad del mundo haga referencia al mismo fallo sin confusiones. Su objetivo es facilitar la correlación de información entre distintas fuentes y sistemas de seguridad.
CWE: clasificación de debilidades comunes
Mientras que el CVE identifica vulnerabilidades concretas, el CWE (Common Weakness Enumeration) clasifica los tipos de debilidades que pueden dar lugar a esas vulnerabilidades. Piénsalo como un catálogo de patrones de error: el desbordamiento de búfer es un CWE, la inyección SQL es otro. Esta clasificación ayuda a los desarrolladores a entender los patrones detrás de los fallos y a diseñar código más robusto desde el principio, antes de que aparezcan vulnerabilidades concretas.
CVSS: puntuación de severidad
El CVSS (Common Vulnerability Scoring System) es el estándar global para medir la gravedad de una vulnerabilidad. Asigna una puntuación del 0 al 10 basada en criterios como el vector de ataque, la complejidad de explotación, los privilegios requeridos y el impacto sobre la confidencialidad, integridad y disponibilidad. Esta puntuación permite comparar vulnerabilidades entre sí y priorizar cuáles corregir primero. La versión más reciente es CVSS v4.0, aunque muchas herramientas aún trabajan con la versión 3.1.
¿Para qué sirve clasificar las vulnerabilidades informáticas?
Clasificar una vulnerabilidad no es un paso burocrático. Es lo que transforma una lista de fallos en un plan de acción con prioridades claras. Sin clasificación, todos los problemas parecen igual de urgentes, y los recursos del equipo de seguridad se dispersan sin criterio. Con ella, se sabe exactamente qué atender primero, qué puede esperar y qué medidas aplicar según el tipo de fallo detectado.
Además, la clasificación facilita la comunicación dentro de la organización. Decirle a un directivo que hay una vulnerabilidad crítica con CVSS 9,5 en la aplicación de pagos transmite mucho más que decir que «hay un problema de seguridad». El lenguaje estructurado que ofrecen los estándares como CVE y CVSS hace que la información llegue con la precisión necesaria para que cada nivel de la organización pueda tomar decisiones informadas y proporcionales al riesgo real.
Entender cómo se clasifican las vulnerabilidades también es parte de las habilidades para trabajar en ciberseguridad que cualquier profesional del sector debe desarrollar. Saber leer un informe de vulnerabilidades, interpretar una puntuación CVSS y relacionarla con el contexto del sistema afectado es una competencia que se exige tanto en auditorías como en equipos de respuesta a incidentes.
- Priorizar la respuesta: Actuar primero sobre los fallos de mayor riesgo real.
- Asignar recursos: Destinar el esfuerzo correcto a cada tipo de vulnerabilidad.
- Comunicar con claridad: Usar un lenguaje común comprensible para todos los equipos.
- Diseñar parches: Aplicar la solución técnica adecuada al tipo de fallo específico.
- Monitorear el historial: Seguir la evolución de las vulnerabilidades a lo largo del tiempo.
- Cumplir normativas: Documentar los fallos de forma estandarizada para auditorías y regulaciones.
El proceso de identificar, clasificar y gestionar vulnerabilidades también está directamente relacionado con la informática forense, ya que cuando un ataque ya se ha producido, analizar qué vulnerabilidad fue explotada y cómo se clasificaba es parte esencial de la investigación para entender el alcance del incidente y prevenir que se repita.
Preguntas frecuentes
¿Cuáles son los tipos de vulnerabilidades más comunes en ciberseguridad?
Los tipos más frecuentes incluyen las vulnerabilidades de software (errores de código y falta de actualizaciones), las de red (puertos abiertos, protocolos sin cifrado) y las causadas por el factor humano (contraseñas débiles, configuraciones incorrectas). Dentro de los fallos técnicos, la inyección SQL, el XSS y el desbordamiento de búfer aparecen de forma recurrente en análisis y auditorías de seguridad en todo tipo de organizaciones, independientemente de su tamaño o sector.
¿Qué diferencia hay entre una vulnerabilidad crítica y una grave?
La diferencia está en el nivel de riesgo que representan según el estándar CVSS. Una vulnerabilidad grave (puntuación entre 7,0 y 8,9) puede comprometer información del sistema y exige atención prioritaria, pero generalmente requiere alguna condición previa para ser explotada. Una vulnerabilidad crítica (puntuación de 9,0 a 10,0) representa el máximo nivel de riesgo: puede propagarse sin interacción del usuario, no requiere privilegios especiales y su explotación puede causar un daño total sobre el sistema afectado.
¿Qué es el CVSS y cómo se usa para clasificar vulnerabilidades?
El CVSS (Common Vulnerability Scoring System) es un estándar internacional que asigna una puntuación numérica del 0 al 10 a cada vulnerabilidad detectada. Se calcula a partir de métricas que evalúan la facilidad de explotación, el tipo de acceso necesario, si se requiere interacción del usuario y el impacto sobre la confidencialidad, integridad y disponibilidad del sistema. Este valor permite comparar distintas vulnerabilidades entre sí y establecer prioridades de corrección con criterio objetivo, más allá de la percepción subjetiva del equipo.
¿Qué es un CVE y para qué sirve?
Un CVE (Common Vulnerabilities and Exposures) es un identificador único asignado a cada vulnerabilidad de seguridad conocida públicamente. Su formato es CVE-AÑO-NÚMERO y permite que cualquier herramienta, base de datos o equipo de seguridad del mundo haga referencia exacta al mismo fallo sin confusiones. Es mantenido por la corporación MITRE y actúa como punto de referencia universal: cuando una empresa publica un parche o un investigador describe un fallo, lo hace referenciando su CVE para que todos entiendan de qué problema se trata.
¿Qué son las vulnerabilidades de día cero?
Una vulnerabilidad de día cero (zero-day) es un fallo que aún no ha sido descubierto ni corregido por el fabricante del software o sistema afectado. El nombre hace referencia a que han pasado cero días desde que el desarrollador tuvo conocimiento del problema, lo que significa que no existe un parche disponible. Este tipo de vulnerabilidad es especialmente peligrosa porque los atacantes que la conocen pueden explotarla sin que haya ninguna defensa activa. Por eso, cuando se descubren, se consideran automáticamente de alta prioridad.
¿Cómo se detectan las vulnerabilidades informáticas?
Los profesionales usan tres métodos principales para detectar vulnerabilidades. El primero es el análisis automático de vulnerabilidades, con herramientas que rastrean la red y los sistemas en busca de fallos conocidos. El segundo son las auditorías de seguridad, revisiones exhaustivas de configuraciones y políticas. El tercero es el pentesting o test de intrusión, en el que expertos simulan ataques reales para descubrir hasta dónde podría llegar un atacante. Estos métodos se complementan entre sí dentro de cualquier programa de seguridad maduro. Además, la informática forense contribuye analizando incidentes pasados para identificar los fallos que fueron explotados.
¿Qué relación tienen las vulnerabilidades con la ciberdelincuencia?
Las vulnerabilidades informáticas son la puerta de entrada principal de la ciberdelincuencia. La mayoría de los ataques exitosos no dependen de técnicas sofisticadas, sino de explotar fallos conocidos que simplemente no se corrigieron a tiempo. Los ciberdelincuentes buscan activamente vulnerabilidades en sistemas expuestos, especialmente aquellas con puntuaciones CVSS altas y parches disponibles que muchas organizaciones aún no han aplicado. Por eso, gestionar y clasificar correctamente las vulnerabilidades es una de las medidas de protección más efectivas frente a este tipo de amenazas.
Conclusión
Las vulnerabilidades informáticas no se gestionan de forma eficaz sin un sistema de clasificación. Saber si un fallo viene del software, el hardware, la red o el factor humano, y conocer su nivel de gravedad según el CVSS, es lo que permite convertir un listado de problemas en un plan de acción con prioridades reales. Sin esta estructura, la seguridad se convierte en una reacción constante sin dirección.
Los estándares CVE, CWE y CVSS no son conceptos abstractos: son herramientas prácticas que ya usan los equipos de seguridad en su trabajo diario. Cuando lees un boletín de seguridad, ves una alerta de tu sistema o participas en una auditoría, estos tres sistemas están detrás. Aprender a interpretarlos te da una ventaja real para entender qué pasa en un sistema y qué decisión tomar frente a cada fallo detectado.
Si quieres seguir construyendo este conocimiento, en este sitio web encontrarás más contenido sobre Ingeniería en Ciberseguridad que te ayudará a avanzar desde los fundamentos hasta los temas más especializados del sector, siempre con un lenguaje claro y orientado a quienes están dando sus primeros pasos en este campo.
Sigue aprendiendo:

Segmentación de redes corporativas
Cifrado simétrico y asimétrico

¿Cómo identificar un correo de phishing?

¿Qué es un firewall y por qué cuida tus datos cada segundo?
Campo laboral de la ingeniería en ciberseguridad
Mejores certificaciones en ciberseguridad en 2026

¿Cómo crear contraseñas seguras y robustas?
Ciberseguridad en aplicaciones móviles