
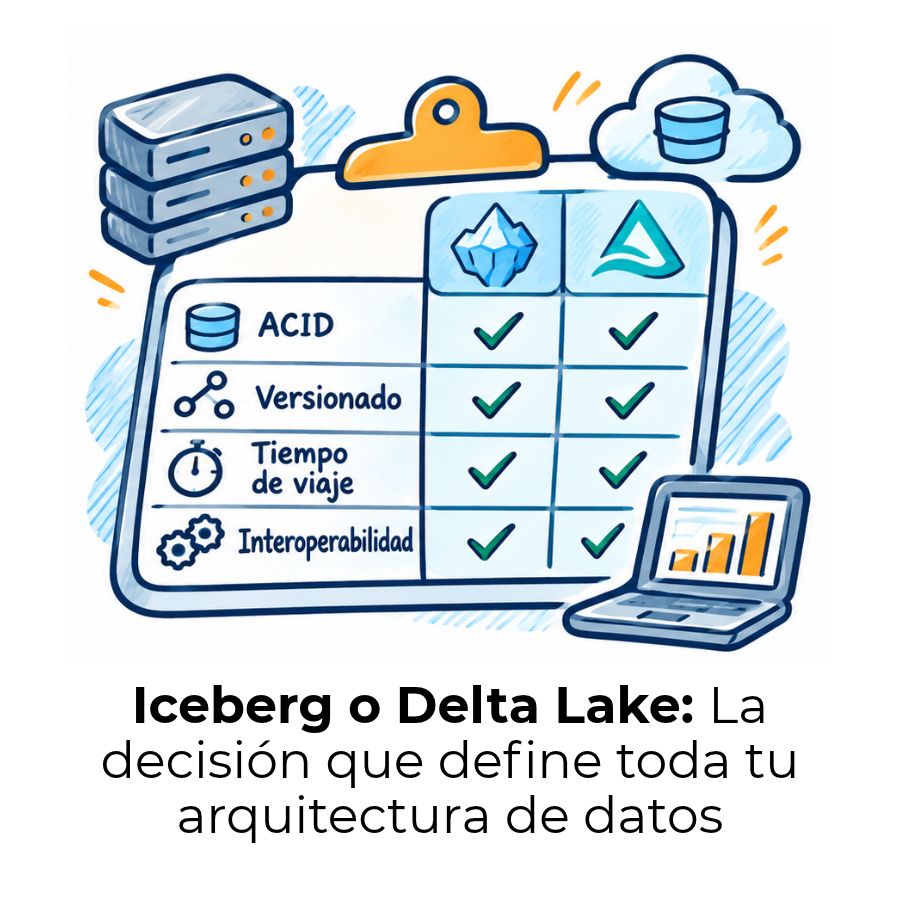
Apache Iceberg y Delta Lake son los dos formatos de tabla más usados en arquitecturas lakehouse modernas. Iceberg destaca por su compatibilidad con múltiples motores de procesamiento, mientras que Delta Lake ofrece la integración más profunda con el ecosistema Databricks y Apache Spark. Elegir bien depende de tu stack actual y de cuánta flexibilidad necesitas a futuro.
¿Qué son Apache Iceberg y Delta Lake?
Antes de comparar, conviene tener claro qué hace cada uno. Apache Iceberg y Delta Lake son formatos de tabla de código abierto diseñados para añadir fiabilidad a los datos almacenados en sistemas de almacenamiento en la nube, como Amazon S3, Azure Data Lake Storage o Google Cloud Storage. Sin ellos, un data lake es básicamente una carpeta con archivos: sin transacciones, sin historial, sin garantías de consistencia.
¿Qué es Apache Iceberg?
Apache Iceberg nació en Netflix como respuesta a los problemas de escala que tenían con Hive. Su diseño parte de un principio clave: el formato debe ser completamente independiente del motor que lo lee o lo escribe. Hoy lo mantiene la Apache Software Foundation con contribuciones de decenas de empresas. Gracias a esa neutralidad, funciona de forma nativa con Spark, Trino, Flink, Snowflake, DuckDB y otros motores sin necesitar conectores especiales para cada uno.
¿Qué es Delta Lake?
Delta Lake surgió dentro de Databricks para resolver los mismos retos de fiabilidad, pero con una prioridad diferente: ofrecer la mejor experiencia posible dentro del ecosistema Spark. Hoy lo gestiona la Linux Foundation, aunque el roadmap técnico sigue influenciado de forma importante por Databricks. Su integración con Unity Catalog, las optimizaciones automáticas y el soporte de streaming lo hacen muy atractivo para equipos que ya viven en Databricks.
Arquitectura y gestión de metadatos
La mayor diferencia entre ambos formatos no está en las funciones visibles, sino en cómo organizan internamente la información sobre tus tablas. Esta decisión de arquitectura afecta directamente el rendimiento a escala, la compatibilidad con distintos motores y la facilidad de mantenimiento a largo plazo.
¿Cómo organiza Iceberg sus metadatos?
Iceberg emplea una estructura jerárquica de metadatos formada por tres capas: un archivo de metadatos JSON en la cima, una lista de manifiestos y, por debajo, los propios archivos de datos en formato Parquet, ORC o Avro. Cada snapshot es inmutable: cuando hay una escritura, Iceberg crea un nuevo snapshot sin tocar el anterior. Esto hace que las lecturas sean consistentes aunque haya escrituras simultáneas, y que el viaje en el tiempo sea una consecuencia natural del diseño, no una función añadida.
¿Cómo organiza Delta Lake sus metadatos?
Delta Lake utiliza un enfoque diferente: mantiene un registro de transacciones secuencial compuesto por archivos JSON que registran cada operación realizada sobre la tabla. Periódicamente, ese log se compacta en un checkpoint de Parquet para evitar que crezca demasiado. Este modelo es más sencillo de entender, pero puede volverse un cuello de botella en tablas con miles de particiones o en escenarios de alta frecuencia de commits.
Transacciones ACID y control de concurrencia
Uno de los motivos principales para adoptar cualquiera de estos formatos es añadir garantías transaccionales a un data lake. Tanto Iceberg como Delta Lake ofrecen transacciones ACID completas, lo que significa que nunca verás una escritura parcial ni datos inconsistentes al hacer una consulta, aunque haya varios procesos escribiendo al mismo tiempo.
El mecanismo concreto es el control de concurrencia optimista: ambos asumen que los conflictos son poco frecuentes y los detectan al momento de confirmar la operación, en lugar de bloquear la tabla desde el inicio. Iceberg escala este mecanismo de forma más predecible con tablas muy grandes, porque sus manifiestos permiten evaluar los conflictos a nivel de archivo sin necesidad de leer todo el log. Delta Lake gestiona los conflictos de forma similar, aunque añade resolución automática en algunos escenarios.
«Apache Iceberg, Delta Lake y Apache Hudi garantizan aislamiento serializable o por snapshot en escrituras de tabla única, de modo que los lectores concurrentes siempre ven una versión completa y consistente, nunca una escritura parcial.»
Evolución de esquema y particionado
En proyectos reales, los datos cambian: aparecen nuevas columnas, se renombran campos o cambia el tipo de un dato. Gestionar esos cambios sin romper las consultas existentes es una de las capacidades más valiosas de estos formatos, y es aquí donde Iceberg lleva ventaja.
Evolución de esquema
Apache Iceberg ofrece evolución de esquema completa y segura en cuanto a tipos: puedes añadir, renombrar, eliminar o reordenar columnas sin reescribir los datos subyacentes. Delta Lake también permite modificar el esquema, pero con restricciones más estrictas en los cambios de tipo y sin soporte nativo para eliminar columnas en todas las versiones. Para equipos con esquemas que evolucionan frecuentemente, esta diferencia es importante.
Evolución de particiones
El particionado es la forma en que los datos se organizan físicamente en el almacenamiento para acelerar las consultas. Iceberg permite cambiar la estrategia de particionado sin reescribir los datos existentes, gracias a lo que se conoce como particionado oculto: el motor calcula automáticamente la partición correcta a partir del valor del dato. Delta Lake introdujo liquid clustering como alternativa moderna al particionado estático tradicional, reorganizando los datos con curvas de relleno espacial, pero es un mecanismo diferente y menos flexible que el de Iceberg en términos de evolución.
¿Qué motor de procesamiento soporta cada formato?
Esta es, probablemente, la pregunta más práctica de toda la comparativa. El motor que uses en tu stack es, con frecuencia, el factor que inclina la balanza hacia uno u otro formato. La compatibilidad con el motor condiciona el rendimiento, el mantenimiento y la velocidad de adopción de tu equipo.
Apache Iceberg fue diseñado desde cero para ser agnóstico respecto al motor. Tiene soporte nativo y de producción con Apache Spark, Apache Flink, Trino, Presto, Snowflake, AWS Athena, ClickHouse y DuckDB, entre otros. Esto significa que puedes leer y escribir tablas Iceberg desde cualquiera de ellos sin depender de un conector de terceros. Si tu arquitectura mezcla varios motores, Iceberg es la opción más segura por defecto.
Delta Lake, en cambio, ofrece su mejor rendimiento e integración con Apache Spark, especialmente dentro de Databricks. Para otros motores, Databricks introdujo Delta Kernel en la versión 4.0, una librería ligera que permite a motores no Spark leer y escribir tablas Delta correctamente. También existe Delta UniForm, que genera metadatos de Iceberg de forma automática para que motores compatibles con Iceberg puedan leer tablas Delta. Es una solución de interoperabilidad muy práctica, aunque con limitaciones: los motores externos solo pueden leer en modo UniForm, no escribir.
Viaje en el tiempo y control de versiones
El viaje en el tiempo te permite consultar el estado de una tabla tal como estaba en un momento anterior o en una versión específica. Es una función enormemente útil para auditorías, para recuperar datos borrados por error o para reproducir un análisis exactamente como se hizo en el pasado. Ambos formatos soportan el viaje en el tiempo, aunque lo implementan de formas distintas.
En Iceberg, el viaje en el tiempo es una consecuencia directa de su arquitectura de snapshots inmutables. Cada operación de escritura genera un nuevo snapshot, y puedes navegar por el historial simplemente apuntando a un snapshot anterior por su ID o por una marca de tiempo. En Delta Lake, el viaje en el tiempo se basa en el log de transacciones: puedes retroceder a cualquier versión anterior consultando el log. Delta Lake también permite restaurar una tabla a una versión anterior con el comando RESTORE TABLE, una operación directa que Iceberg también ofrece mediante rollback.
Rendimiento y escalabilidad a gran escala
El rendimiento de cada formato depende en gran medida del tamaño de la tabla, del motor que uses y del tipo de operación predominante en tu carga de trabajo. No existe una respuesta universal, pero sí patrones claros que se repiten en la práctica.
Iceberg escala mejor en tablas con miles de particiones o con cantidades masivas de metadatos, porque sus archivos de manifiesto pueden recortarse de forma independiente sin necesidad de leer todo el historial. Esto reduce el tiempo de planificación de las consultas a escala de petabytes. Delta Lake, con su log centralizado, puede acumular muchos archivos JSON en escenarios de alta frecuencia de commits, aunque el sistema de checkpoints mitiga ese problema de forma periódica.
En el lado de las escrituras, Delta Lake suele ofrecer velocidades de escritura más altas gracias a su motor optimizado para Spark y a funciones como la compactación automática durante la escritura. Para lecturas intensivas con muchos motores distintos, Iceberg lleva ventaja por su diseño distribuido y por evitar cuellos de botella en el acceso a los metadatos. Ambos resuelven el problema de los archivos pequeños mediante compactación, aunque con distintos grados de automatización.
¿Cuándo usar Apache Iceberg y cuándo Delta Lake?
La elección entre los dos formatos no depende de cuál sea «mejor en abstracto», sino de tu contexto concreto: el motor que ya usas, el tamaño de tu equipo, los proveedores de nube que tienes contratados y cuánta flexibilidad necesitas a futuro. A continuación, los escenarios más habituales para cada uno.
Elige Apache Iceberg si:
- Usas múltiples motores: Tu arquitectura combina Spark, Trino, Flink, Snowflake u otros, y necesitas que todos lean y escriban las mismas tablas sin fricciones.
- Priorizas la neutralidad de proveedor: Quieres evitar la dependencia de Databricks o de cualquier plataforma específica para acceder a tus datos.
- Tienes tablas muy grandes: Tu volumen de datos y de particiones es elevado, y el rendimiento del planning de consultas a escala es un requisito crítico.
- Necesitas evolución de esquema completa: Los cambios de tipo de dato, la eliminación de columnas o la evolución de particiones son operaciones frecuentes en tu proyecto.
Elige Delta Lake si:
- Tu stack es Databricks o Spark: Ya tienes pipelines en Databricks y quieres la integración más profunda, con todas las optimizaciones automáticas disponibles.
- Necesitas transacciones multi-tabla: Delta Lake soporta commits atómicos que afectan a varias tablas simultáneamente, una capacidad que Iceberg no tiene de forma nativa.
- Usas Change Data Feed: Para capturar y propagar cambios a nivel de fila de forma eficiente hacia sistemas downstream, el CDF nativo de Delta Lake tiene un ecosistema de herramientas muy maduro.
- Priorizas la integración con gobernanza: Unity Catalog de Databricks ofrece linaje de datos, control de acceso y auditoría integrados con Delta Lake, sin necesidad de configurar herramientas externas.
Comparativa directa: Iceberg vs. Delta Lake
Para cerrar la comparativa, aquí tienes un resumen de los atributos más relevantes de cada formato en un solo vistazo. Esto te permite identificar rápidamente cuál se ajusta mejor a las necesidades de tu proyecto sin tener que releer toda la información anterior.
| Atributo | Apache Iceberg | Delta Lake |
|---|---|---|
| Gobernanza | Apache Software Foundation | Linux Foundation (influencia de Databricks) |
| Gestión de metadatos | Snapshots inmutables jerárquicos | Log de transacciones JSON + checkpoints |
| Transacciones ACID | Sí | Sí |
| Evolución de esquema | Completa (incluye eliminar columnas) | Parcial (limitaciones en tipos y eliminación) |
| Evolución de particiones | Nativa (particionado oculto) | Liquid clustering (mecanismo diferente) |
| Soporte multi-motor | Amplio y nativo (Spark, Trino, Flink, Snowflake…) | Spark principalmente; otros vía Delta Kernel / UniForm |
| Viaje en el tiempo | Sí (snapshots) | Sí (log de transacciones) |
| Transacciones multi-tabla | No (nativo) | Sí |
| Change Data Feed | Vía Streaming API | Nativo con amplio soporte de herramientas |
| Interoperabilidad | Alta (diseño agnóstico) | Media (Delta UniForm para lectura Iceberg) |
| Integración con Databricks | Compatible | Nativa y profunda |
| Mejor caso de uso | Arquitecturas multi-motor, multi-nube | Stacks Spark-first o Databricks-centric |
Si quieres profundizar en otros aspectos fundamentales del almacenamiento de datos, como entender la diferencia entre Parquet y CSV —dos formatos de archivo que aparecen constantemente al trabajar con Iceberg o Delta Lake—, encontrarás una explicación detallada en este mismo sitio.
Preguntas frecuentes
¿Qué diferencia hay entre Apache Iceberg y Delta Lake?
La diferencia principal está en el diseño y el ecosistema de cada uno. Apache Iceberg nació pensando en la neutralidad de motor: funciona de forma nativa con Spark, Trino, Flink, Snowflake y muchos otros sin depender de ninguno en particular. Delta Lake, en cambio, fue creado por Databricks y ofrece su mayor rendimiento e integración dentro del ecosistema Spark y Databricks. Ambos comparten funciones como transacciones ACID, viaje en el tiempo y evolución de esquema, pero Iceberg es más flexible en evolución de particiones y soporte multi-motor, mientras que Delta Lake destaca en transacciones multi-tabla, Change Data Feed y gobernanza integrada con Unity Catalog.
¿Cuál es mejor para trabajar con Databricks?
Si tu stack está construido sobre Databricks, Delta Lake es la opción más práctica por defecto. La integración con Unity Catalog, las optimizaciones automáticas como liquid clustering y el soporte nativo de streaming están diseñados específicamente para ese entorno. Iceberg también es compatible con Databricks, pero sin el mismo nivel de profundidad ni de optimizaciones automáticas que ofrece Delta Lake dentro de esa plataforma.
¿Pueden usarse Iceberg y Delta Lake juntos?
Sí, es posible tenerlos coexistiendo en la misma arquitectura, aunque no es lo más habitual. Databricks introdujo Delta UniForm, una función que genera automáticamente metadatos de Iceberg sobre tablas Delta, lo que permite que motores compatibles con Iceberg las lean sin necesidad de migrar los datos. También existe Apache XTable, un proyecto de código abierto que actúa como capa de traducción de metadatos entre Delta, Iceberg y Apache Hudi. En cualquier caso, la coexistencia añade complejidad operativa y suele ser una solución de transición más que un estado permanente.
¿Qué es Delta UniForm y para qué sirve?
Delta UniForm es una función de Delta Lake que genera automáticamente metadatos en formato Iceberg cada vez que se escribe en una tabla Delta. Su objetivo es permitir que motores externos compatibles con Iceberg puedan leer las mismas tablas Delta sin necesidad de duplicar los datos. Sin embargo, tiene una limitación importante: los motores externos solo pueden leer en modo UniForm, no escribir. Esto la convierte en una solución de interoperabilidad para lectura, no en una integración bidireccional completa.
¿Cuál escala mejor con tablas muy grandes?
Para tablas a escala de petabytes con miles de particiones, Apache Iceberg escala de forma más predecible gracias a su estructura de metadatos jerárquica y distribuida. Los archivos de manifiesto pueden recortarse de forma independiente sin necesidad de leer todo el historial, lo que reduce el tiempo de planificación de consultas. Delta Lake, con su log centralizado, puede encontrar limitaciones en escenarios de alta frecuencia de commits o en tablas con muchas particiones, aunque el sistema de checkpoints periódicos mitiga ese problema de forma significativa.
¿Iceberg o Delta Lake para Apache Flink?
Para arquitecturas centradas en Apache Flink, Apache Iceberg es la opción más recomendable, ya que cuenta con soporte nativo de lectura y escritura en Flink sin necesitar conectores adicionales. Delta Lake tiene soporte para Flink a través de un conector que ha ido madurando, pero no alcanza el mismo nivel de integración nativa que ofrece Iceberg. Si Flink es tu motor principal de procesamiento de streaming, Iceberg te dará menos fricciones desde el primer día.
¿Cuál de los dos tiene mejor soporte de código abierto?
Ambos son proyectos de código abierto con licencia Apache 2.0, pero su modelo de gobernanza es diferente. Apache Iceberg está gobernado por la Apache Software Foundation con contribuciones de más de treinta empresas, lo que lo convierte en un proyecto verdaderamente comunitario sin un único controlador. Delta Lake está bajo la Linux Foundation, aunque el roadmap técnico sigue siendo impulsado principalmente por Databricks. Para equipos que valoran la neutralidad de gobernanza y la independencia de un único proveedor, Iceberg ofrece una estructura más abierta en la práctica. Puedes explorar más temas relacionados en la sección de ingeniería de datos de este sitio.
Conclusión
Apache Iceberg y Delta Lake son los dos formatos de tabla más maduros y usados en arquitecturas lakehouse modernas. Ambos resuelven el mismo problema central —añadir fiabilidad, transacciones y evolución a un data lake— pero lo hacen con filosofías distintas: Iceberg apuesta por la neutralidad y la interoperabilidad máxima, mientras que Delta Lake prioriza la profundidad de integración dentro del ecosistema Spark y Databricks.
La clave para elegir bien es analizar tu stack actual antes de decidir. Si ya trabajas en Databricks o Spark de forma exclusiva, Delta Lake te ahorrará configuraciones y te dará acceso a optimizaciones automáticas desde el primer momento. Si, en cambio, combinas varios motores o quieres evitar la dependencia de un único proveedor, Iceberg te ofrece una base más flexible y abierta para crecer sin restricciones.
Entender estas diferencias es un paso importante para tomar decisiones de arquitectura más sólidas. En este sitio web encontrarás más contenidos sobre ingeniería de datos que te ayudarán a seguir construyendo ese conocimiento de forma práctica y progresiva.
Sigue aprendiendo:
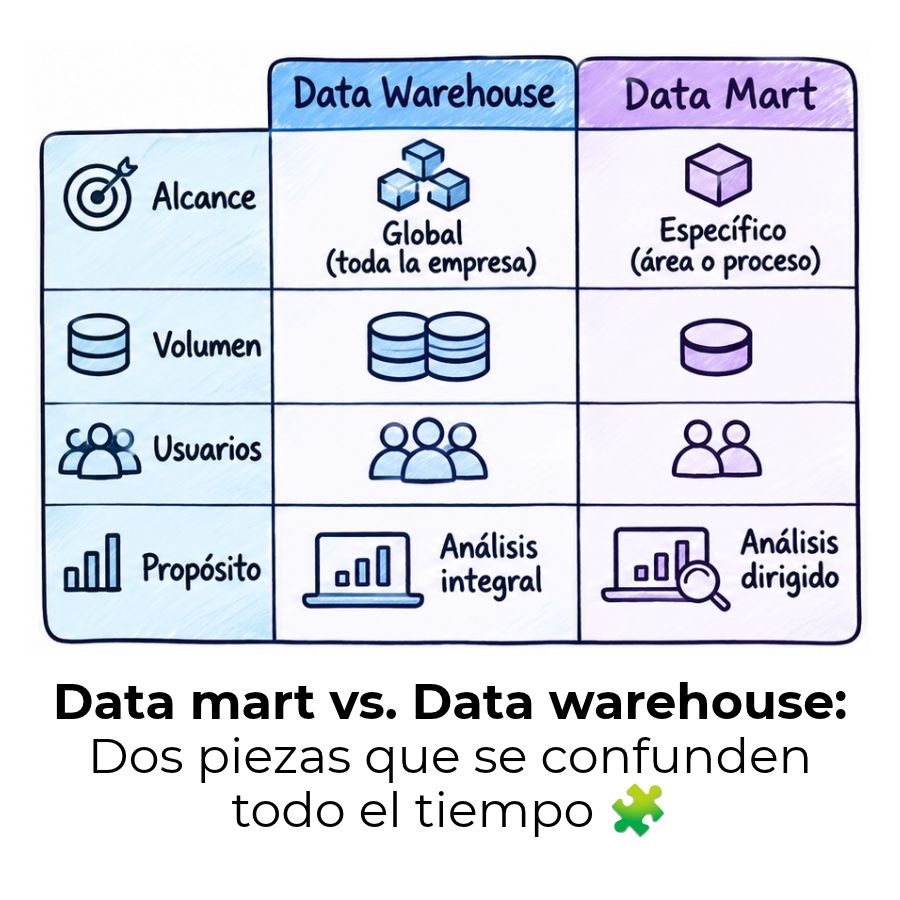
Diferencia entre data mart y data warehouse
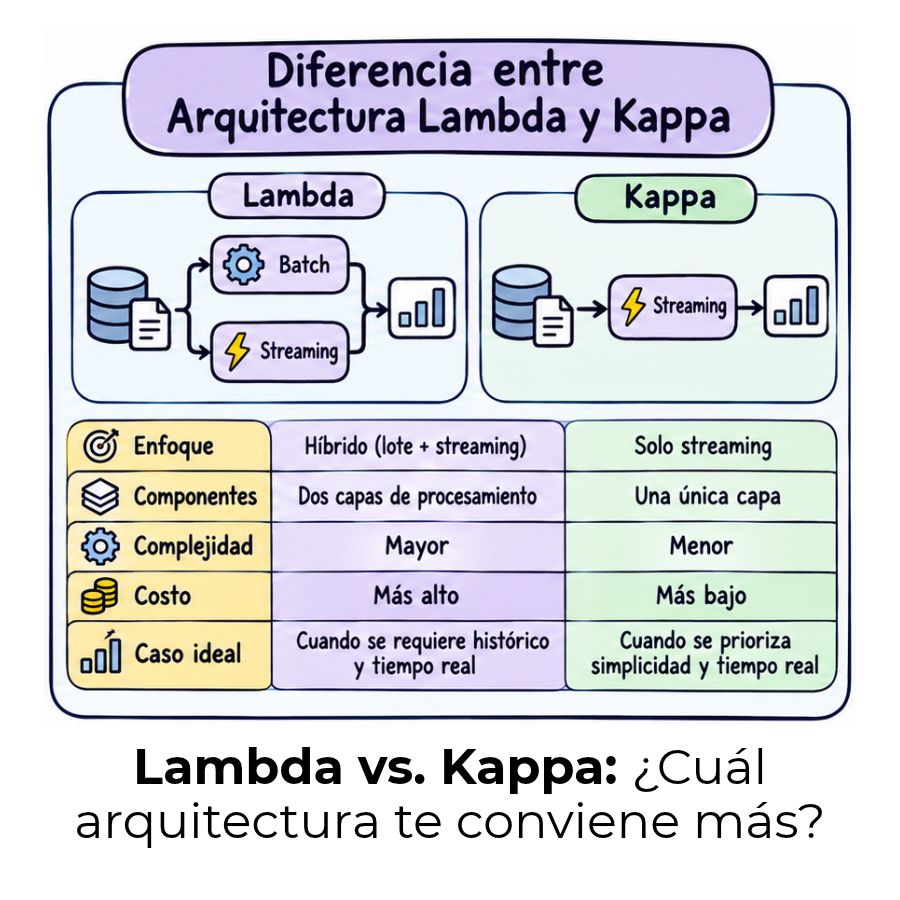
Diferencia entre arquitectura Lambda y Kappa
¿Qué lenguaje aprender para ser ingeniero de datos?
Pipeline de datos: El mecanismo que nadie te explica bien
Diferencia entre Parquet y CSV
¿Qué hace un ingeniero de datos?
Ingesta de datos: Transforma fuentes caóticas en valor real
¿En qué consiste la ingeniería de base de datos?
