
Para ser ingeniero de datos, necesitas dominar, como mínimo, Python y SQL. Python te da la capacidad de procesar y transformar datos; SQL te permite trabajar con bases de datos relacionales desde el primer día. A partir de esa base, lenguajes como Scala o Java entran en escena según el rol y la empresa.
¿Qué lenguajes necesita un ingeniero de datos?
Un ingeniero de datos trabaja a diario con tres tareas principales: mover datos de un lugar a otro, transformarlos para que tengan la forma correcta y almacenarlos de manera que otros puedan usarlos. Para hacer eso, los lenguajes más demandados son Python, SQL y, en contextos más avanzados, Scala. Cada uno tiene un papel distinto, y conocerlos te ayuda a decidir por cuál empezar.
No se trata de aprenderlos todos al mismo tiempo. Se trata de entender qué resuelve cada uno y en qué momento de tu carrera tiene sentido incorporarlo. La confusión más habitual entre quienes empiezan es intentar abarcar demasiado antes de consolidar lo básico, y eso solo alarga el camino sin acelerar el aprendizaje real.
Python: el lenguaje central de la ingeniería de datos
Python es el lenguaje principal de la ingeniería de datos moderna porque permite construir pipelines de datos, automatizar transformaciones, validar información y conectar distintas fuentes en un mismo flujo de trabajo. Su ecosistema de librerías —como Pandas, PySpark o SQLAlchemy— lo convierte en una herramienta versátil desde el primer día de trabajo real.
Lo que hace a Python especialmente valioso en este rol no es solo su sintaxis clara, sino que prácticamente todas las herramientas del ecosistema de datos —Airflow, dbt, Spark— tienen una interfaz o integración directa con él. Aprender Python no es una opción: es el punto de partida que todo lo demás presupone que ya tienes.
SQL: el lenguaje que nunca puede faltar
SQL no es solo útil: un ingeniero de datos sin SQL sólido no puede desempeñar el trabajo. Cada vez que se necesita extraer información de una base de datos, filtrar registros, combinar tablas o preparar datos para su análisis, SQL es el medio. No importa qué empresa ni qué sector: las bases de datos relacionales están en todas partes.
A diferencia de Python, SQL no requiere pensar en flujos completos de código. Se trata de escribir consultas precisas que devuelvan exactamente lo que el sistema necesita. Esa capacidad, que parece simple al principio, se vuelve muy poderosa cuando se trabaja con tablas de millones de filas y múltiples fuentes de datos conectadas.
Scala: potencia para sistemas distribuidos
Scala entra en escena cuando el volumen de datos supera lo que Python puede manejar de forma eficiente por sí solo. Es el lenguaje nativo de Apache Spark, la plataforma más usada para procesar datos a gran escala, y combina la concisión de Python con la velocidad y escalabilidad de Java. Para proyectos con procesamiento en tiempo real o datasets masivos, Scala marca la diferencia.
Dicho esto, Scala no es un lenguaje con el que debas empezar. Tiene una curva de aprendizaje más pronunciada y su valor real aparece cuando ya tienes experiencia trabajando con pipelines complejos. Si estás en tus primeros pasos, déjalo para más adelante y enfócate primero en construir la base correcta.
Java: cuándo tiene sentido aprenderlo
Java no es el primer lenguaje que se menciona cuando alguien pregunta qué aprender para ingeniería de datos, pero tiene un papel real en el ecosistema. Aparece principalmente en entornos de producción a gran escala, en herramientas como Apache Kafka o en empresas con infraestructuras heredadas donde gran parte del sistema ya está escrito en este lenguaje.
Si ya conoces Java de un campo anterior —desarrollo de software, por ejemplo— puedes aprovecharlo como punto de apoyo. Sin esa base previa, tiene más sentido priorizar Python, SQL y Scala antes de añadir Java a tu lista de aprendizaje.
¿Cuál es el primer lenguaje que debes aprender?
La respuesta más directa y respaldada por el mercado laboral actual es: empieza con Python y SQL de forma simultánea. No son competencia entre sí; se complementan. Python te da la lógica de programación y la capacidad de construir flujos de datos. SQL te enseña a pensar en términos de conjuntos y a comunicarte con las bases de datos donde vive la información.
Aprender uno sin el otro desde el principio crea un punto ciego que te costará más adelante. Muchas personas aprenden Python durante meses sin tocar SQL y luego descubren que no pueden completar las tareas más habituales de un ingeniero de datos, que implican consultar bases de datos constantemente. Lo más eficiente es ir construyendo ambos en paralelo.
¿Por dónde empezar en la práctica?
- Dedica las primeras semanas a aprender la sintaxis básica de Python: variables, listas, bucles y funciones.
- Al mismo tiempo, practica consultas SQL sobre bases de datos pequeñas: SELECT, WHERE, JOIN y GROUP BY.
- Cuando te sientas cómodo con ambos, combínalos: accede a bases de datos desde Python usando librerías como SQLAlchemy o psycopg2.
- Solo entonces tiene sentido explorar Pandas, Airflow o Spark como siguientes pasos.
Comparativa de lenguajes para ingeniería de datos
Cada lenguaje tiene un perfil distinto en términos de dificultad, uso real y momento en que aporta más valor. La siguiente tabla te ayuda a ver las diferencias de un vistazo y a tomar una decisión informada sobre en cuál enfocarte según tu punto de partida.
| Lenguaje | Dificultad inicial | Uso principal | ¿Obligatorio? | Momento recomendado |
|---|---|---|---|---|
| Python | Baja–Media | Pipelines, transformaciones, automatización | Sí | Desde el primer día |
| SQL | Baja | Consultas, modelado, bases de datos relacionales | Sí | Desde el primer día |
| Scala | Alta | Sistemas distribuidos, Spark avanzado | No siempre | Etapa intermedia–avanzada |
| Java | Media–Alta | Producción, Kafka, infraestructuras heredadas | No | Solo si el rol lo requiere |
| R | Media | Análisis estadístico, visualización | No | Perfiles más analíticos |
| Bash | Baja | Scripts de sistema, automatización de entornos | Recomendable | Etapa inicial–media |
Ruta de aprendizaje recomendada paso a paso
Una de las ventajas de la ingeniería de datos como campo es que tiene una progresión lógica bastante clara. No es necesario improvisar el orden: hay una secuencia que el mercado valida de forma consistente y que te lleva desde cero hasta un perfil empleable sin dar rodeos innecesarios. A continuación se detalla esa secuencia en tres fases.
Fase 1: Python y SQL como base sólida
El primer objetivo es que puedas escribir código Python limpio —con funciones, estructuras de datos y manejo básico de errores— y realizar consultas SQL de nivel intermedio, incluyendo JOINs, subconsultas y agrupaciones. Sin esta base, todo lo que venga después será más difícil de lo necesario, porque las herramientas avanzadas asumen que ya manejas estos fundamentos con soltura.
El tiempo que necesitas en esta fase depende de cuánto puedas dedicar a la práctica diaria, pero la clave no es la velocidad: es la solidez. Es preferible tomar más tiempo y salir de esta fase sin dudas que avanzar con lagunas que te frenen más adelante.
Fase 2: herramientas y ecosistema de datos
Con Python y SQL como base, el siguiente paso es adentrarte en las herramientas que los ingenieros de datos usan en su trabajo diario. Apache Airflow para orquestar pipelines, Pandas para transformar datos estructurados y dbt para aplicar transformaciones SQL con documentación integrada son tres nombres que aparecen con mucha frecuencia en las descripciones de puestos reales.
En esta misma fase tiene sentido explorar los conceptos básicos de la nube —AWS, Google Cloud o Azure— porque cada vez más empresas almacenan y procesan sus datos en entornos cloud. No necesitas ser experto, pero sí entender cómo funcionan los servicios de almacenamiento y cómo conectar tus pipelines a ellos.
Fase 3: Scala y tecnologías avanzadas
En la fase avanzada aparece Scala como complemento natural si trabajas con Apache Spark a gran escala. También cobra relevancia conocer herramientas de streaming como Apache Kafka para procesar datos en tiempo real, y profundizar en arquitecturas como Data Lakes o Data Warehouses en la nube. Esta fase es la que diferencia a un ingeniero de datos junior de uno senior.
Llegar aquí con una base sólida hace que el aprendizaje sea mucho más rápido. Scala, por ejemplo, comparte lógica con Python en muchos aspectos, y si ya sabes trabajar con Spark desde Python, la transición a Spark con Scala es notablemente más fluida de lo que parece al principio.
¿Qué diferencia hay entre Python para datos y Python general?
Python es un lenguaje de propósito general, lo que significa que se usa para muchas cosas: desarrollo web, scripts de sistema, inteligencia artificial y, también, ingeniería de datos. Pero el Python que necesitas para datos no es el mismo que el de un desarrollador web. El foco es completamente distinto, y eso cambia lo que debes aprender primero.
Un desarrollador web que usa Python aprende frameworks como Django o Flask, gestión de peticiones HTTP y lógica de negocio orientada a usuarios. Un ingeniero de datos, en cambio, necesita dominar la manipulación de conjuntos de datos, la lectura y escritura de archivos en distintos formatos —CSV, Parquet, JSON— y la automatización de flujos que mueven datos de un sistema a otro sin intervención manual.
En la práctica, las librerías que más vas a utilizar como ingeniero de datos son Pandas para manipular tablas de datos, PySpark para procesamiento distribuido y SQLAlchemy o psycopg2 para conectar Python con bases de datos. Aprenderlas te convierte en alguien funcional en el rol, mucho más que memorizar conceptos genéricos de programación sin aplicarlos a casos de datos reales.
Esto también tiene implicaciones prácticas para cómo estudias. Los recursos generales de Python son útiles para las bases, pero necesitas complementarlos con proyectos orientados a datos: ingestar un archivo, transformar columnas, guardar el resultado en una base de datos. Ese tipo de práctica es la que construye el perfil que las empresas buscan.
Errores comunes al elegir el primer lenguaje
Elegir con qué empezar es una de las decisiones que más tiempo puede costar si no se toma con criterio. El error más frecuente es dispersarse entre varios lenguajes al mismo tiempo, creyendo que aprender más opciones en paralelo acelera el proceso, cuando en realidad lo que hace es que ninguno avanza lo suficiente como para ser útil en un entorno real.
❌ Error 1
Intentar aprender Python, SQL, Scala y Java al mismo tiempo desde cero. El resultado es saber poco de todo y no poder aplicar nada con solidez.
❌ Error 2
Estudiar Python durante meses sin tocar SQL. Las dos habilidades son igualmente necesarias y se refuerzan mutuamente cuando se aprenden juntas.
❌ Error 3
Empezar por Scala pensando que es más valorado. Scala tiene sentido solo cuando ya tienes experiencia sólida en Python, SQL y herramientas del ecosistema.
❌ Error 4
Elegir R como primer lenguaje para ingeniería de datos. R es valioso para análisis estadístico, pero el mercado de ingeniería de datos pide Python y SQL como estándar.
❌ Error 5
Aprender Python de forma genérica sin orientar el estudio a datos. Las librerías y los proyectos que practicas deben reflejar tareas reales de ingeniería de datos desde el principio.
✅ Enfoque correcto
Python y SQL en paralelo desde el primer día, con proyectos orientados a datos reales. Suma herramientas del ecosistema cuando tengas esa base y deja Scala para cuando el rol lo pida.
Otro error habitual es confundir popularidad general con relevancia para el rol. JavaScript, por ejemplo, es el lenguaje más usado en el mundo del desarrollo web, pero su presencia en la ingeniería de datos es marginal. Que un lenguaje sea popular no significa que sea el que necesitas aprender para el trabajo concreto al que apuntas.
Si ya tienes experiencia en otro lenguaje —Java, C# o incluso JavaScript— no empieces desde cero con Python de forma excesivamente básica. Los conceptos de programación se transfieren: puedes avanzar más rápido hacia las librerías de datos y el SQL, que son el núcleo específico del rol, sin detenerte demasiado en la sintaxis general del lenguaje.
Si quieres entender mejor el campo antes de decidir qué aprender, puedes echar un vistazo a qué hace exactamente un profesional del área en la sección de ingeniería de datos, donde se explica el rol con detalle.
Preguntas frecuentes
¿Es suficiente aprender solo Python para ser ingeniero de datos?
No. Python es el lenguaje central de la ingeniería de datos moderna y el punto de partida obligado, pero por sí solo no es suficiente. SQL es igualmente necesario porque un ingeniero de datos trabaja constantemente con bases de datos relacionales, y sin SQL no puede extraer, filtrar ni transformar datos desde su origen. La combinación de ambos es el mínimo real que el mercado laboral exige para un puesto de entrada en este campo.
¿SQL se considera un lenguaje de programación en ingeniería de datos?
Técnicamente, SQL es un lenguaje de consulta estructurada, no un lenguaje de programación de propósito general. Sin embargo, en el contexto de la ingeniería de datos, se trata con la misma importancia que cualquier lenguaje de programación, porque es la herramienta principal para comunicarse con bases de datos relacionales. Las ofertas de trabajo lo listan siempre como requisito técnico junto a Python o Scala, y dominarlo a nivel avanzado —subconsultas, funciones de ventana, optimización— es una habilidad muy valorada.
¿Cuánto tiempo se tarda en aprender Python y SQL desde cero?
El tiempo depende de cuántas horas dediques a la práctica diaria y de si ya tienes experiencia previa en programación. Con una dedicación constante de una a dos horas diarias, muchas personas alcanzan un nivel funcional en Python y SQL intermedio en un plazo de cuatro a seis meses. El nivel avanzado, que incluye optimización de consultas complejas y construcción de pipelines reales, puede requerir un año o más de práctica aplicada en proyectos concretos.
¿Scala es obligatorio para trabajar como ingeniero de datos?
No en todos los puestos. Scala es muy valiosa cuando el rol implica trabajar con Apache Spark a gran escala o en entornos de procesamiento distribuido exigentes, pero muchas posiciones de ingeniería de datos, especialmente en empresas medianas o en etapas iniciales de madurez de datos, operan perfectamente con Python y SQL. Antes de invertir tiempo en Scala, conviene revisar las descripciones de los puestos a los que apuntas y ver si aparece como requisito o como complemento deseable.
¿R tiene utilidad en la ingeniería de datos o solo en ciencia de datos?
R tiene un uso muy limitado en la ingeniería de datos propiamente dicha. Su fortaleza está en el análisis estadístico avanzado y la visualización de datos, que son áreas más propias de los científicos de datos y los analistas estadísticos. En roles de ingeniería de datos, Python reemplaza prácticamente todas las tareas que R podría cubrir, con la ventaja adicional de que Python se integra mucho mejor con las herramientas de pipelines, orquestación y almacenamiento que son el núcleo del trabajo diario de un ingeniero de datos.
¿Qué lenguaje piden más las empresas en las ofertas de trabajo?
Python y SQL aparecen de forma consistente como los dos lenguajes más solicitados en las ofertas de trabajo para ingeniería de datos, independientemente del tamaño o el sector de la empresa. Scala ocupa el tercer lugar en entornos con mayor madurez tecnológica o proyectos de Big Data. Java aparece con menos frecuencia, ligado sobre todo a empresas con infraestructuras heredadas o con uso intensivo de Apache Kafka. Si tienes que priorizar, Python y SQL son los que más puertas abren desde el principio. Si quieres complementar tu perfil, explorar las certificaciones para ingeniero de datos disponibles puede ayudarte a validar esas habilidades ante los empleadores.
¿Puedo empezar con Java si ya lo conozco de otro campo?
Sí, tu experiencia en Java te da una base sólida en programación orientada a objetos y lógica de código que acelera el aprendizaje de cualquier otro lenguaje. Sin embargo, te conviene añadir Python y SQL como prioridad, porque son los que el mercado de datos pide de forma más transversal. Java puede ser un activo diferencial en entornos específicos, pero no sustituye a Python para el trabajo cotidiano de un ingeniero de datos. Con lo que ya sabes de Java, aprender Python te llevará menos tiempo del que calculas.
Conclusión
La elección del lenguaje con el que empezar en ingeniería de datos no debería ser una fuente de duda prolongada. Python y SQL son el punto de partida que el mercado valida de forma consistente, y aprenderlos en paralelo desde el primer día es la decisión más eficiente que puedes tomar. Scala, Java y otras herramientas tienen su momento, pero ese momento llega después de tener una base sólida, no antes.
Lo que has visto aquí te da un mapa claro: comienza con la sintaxis básica de Python orientada a datos y con las consultas SQL más habituales, avanza hacia las herramientas del ecosistema y, cuando el rol lo justifique, suma Scala u otros lenguajes según lo que las empresas realmente pidan. Seguir ese orden te ahorra meses de aprendizaje disperso y te coloca antes en una posición funcional para el trabajo real.
Si quieres seguir construyendo tu perfil profesional en este campo, en este sitio web encontrarás más contenido sobre herramientas, conceptos y trayectorias dentro de la ingeniería de datos que pueden ayudarte a dar los siguientes pasos con más claridad.
Sigue aprendiendo:
Great Expectations (GX): El secreto que usan los mejores data engineers
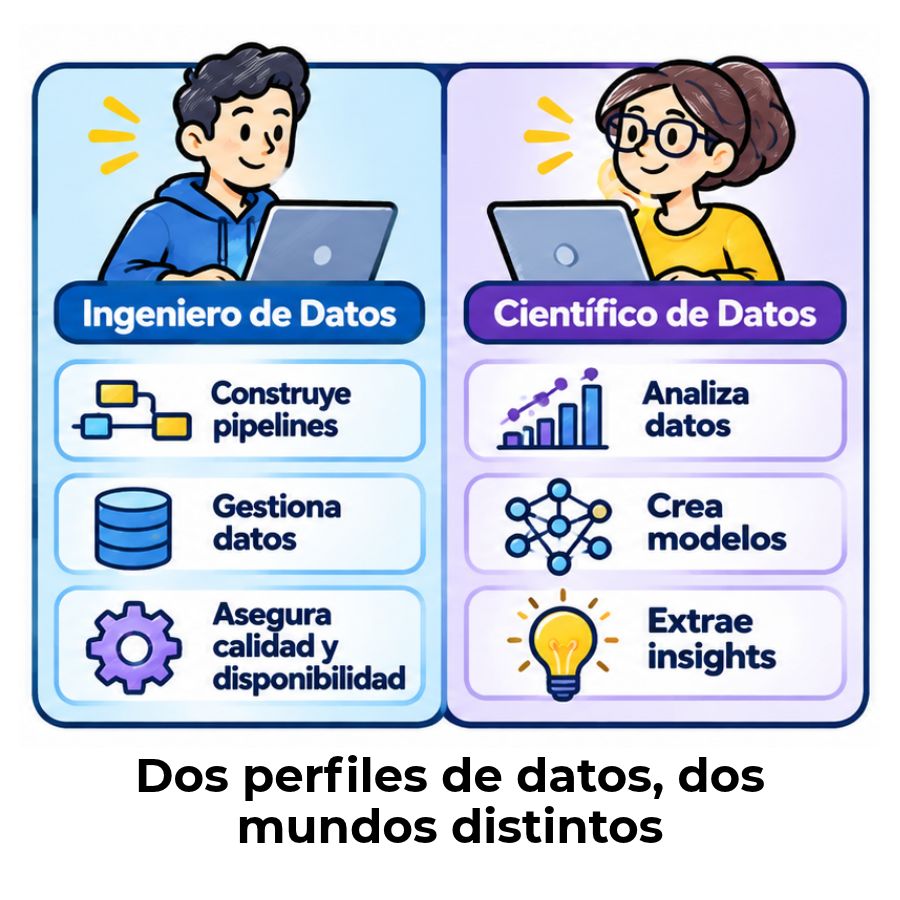
Ingeniero de datos vs. Científico de datos
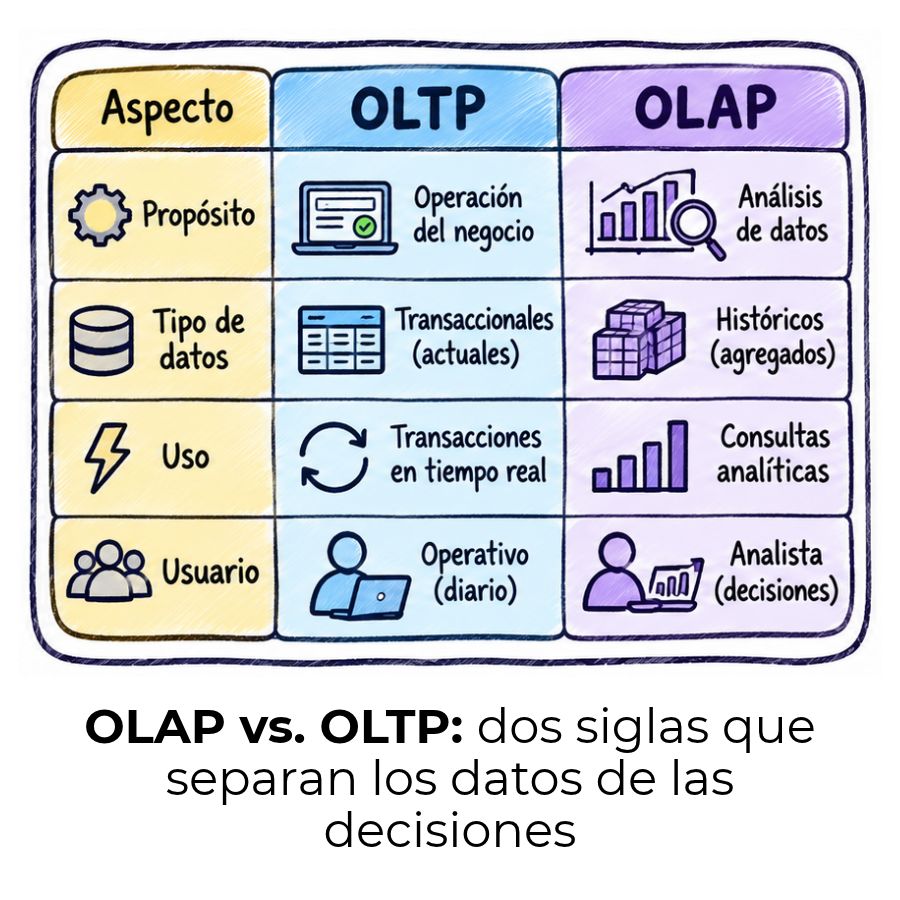
OLAP vs. OLTP: Diferencias clave que debes conocer
Sueldo de un ingeniero de datos: ¿Cuánto gana?
Calidad de datos: El secreto que separa buenos de malos análisis
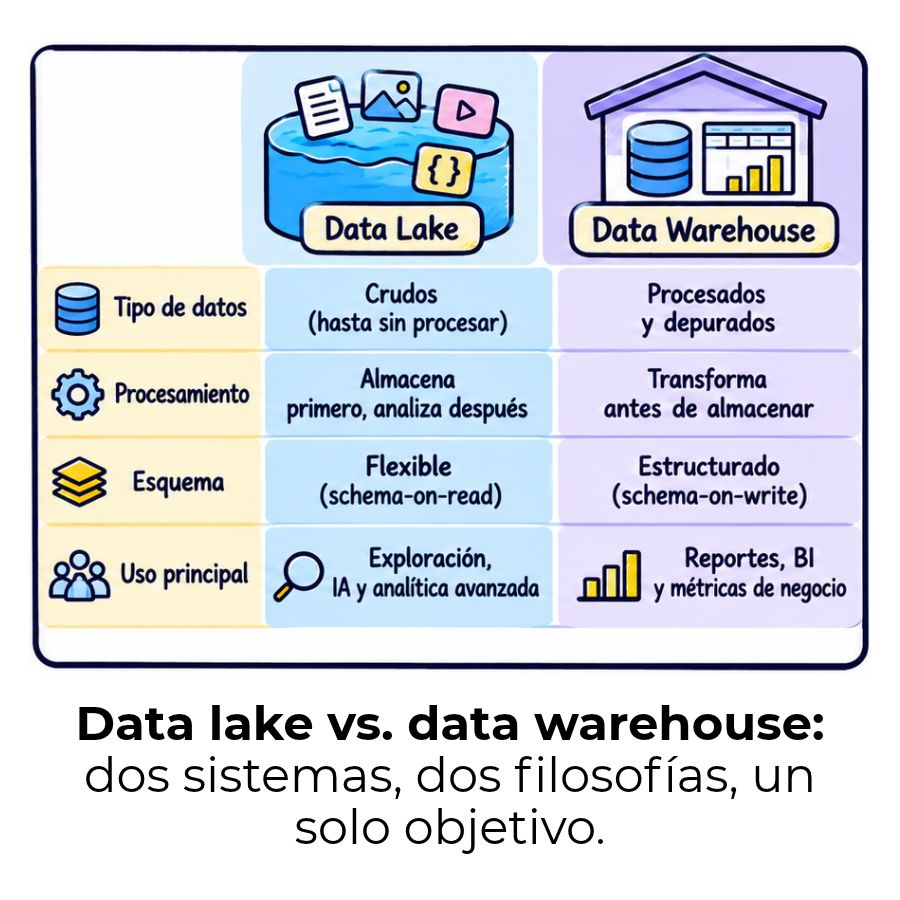
Diferencia entre data lake y data warehouse
AWS Glue: El secreto detrás de los grandes pipelines de datos
Airflow vs. Dagster vs. Prefect: ¿Cuál elegir?
