
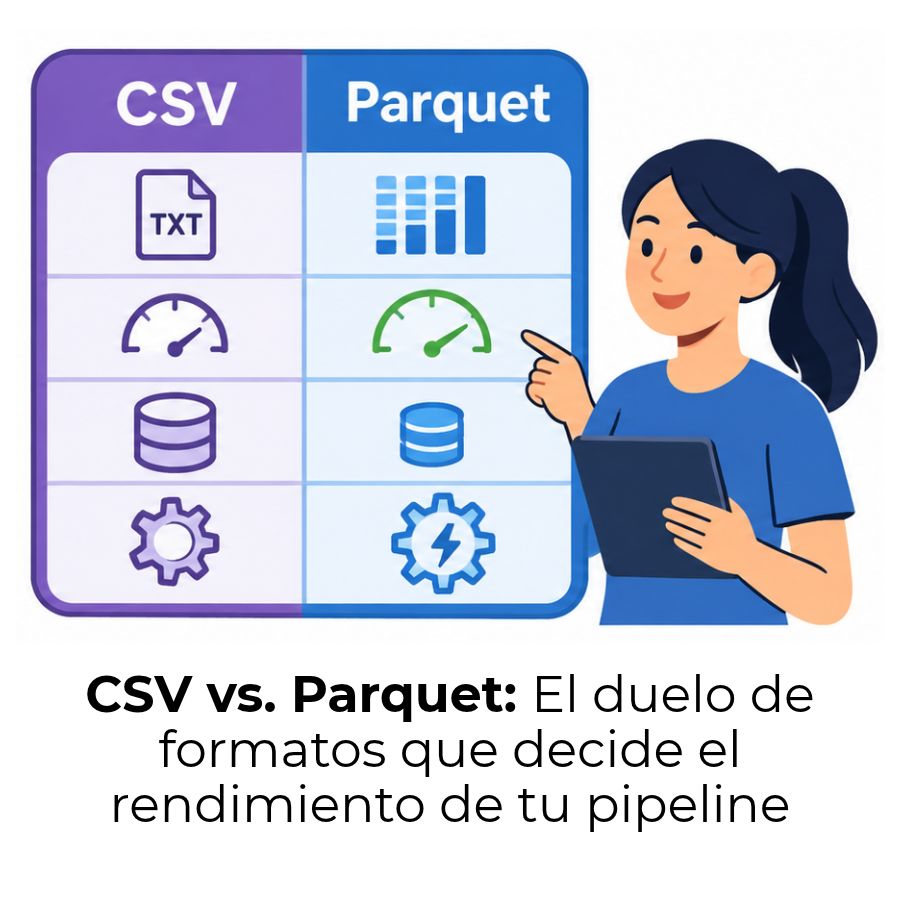
Si alguna vez has cargado un archivo enorme en Python o Spark y has esperado minutos para ver los primeros resultados, es probable que el problema no fuera tu código. El formato en que estaban guardados tus datos tiene mucho más peso del que parece, y entender la diferencia entre Parquet y CSV puede cambiar por completo la forma en que trabajas con ellos.
¿Qué son Parquet y CSV y en qué se diferencian?
Tanto CSV como Parquet son formatos diseñados para guardar datos tabulares, es decir, datos organizados en filas y columnas como los de una hoja de cálculo. Sin embargo, la forma en que cada uno almacena esa información internamente es completamente distinta, y esa diferencia tiene un impacto directo en el rendimiento, el espacio en disco y la compatibilidad con las herramientas que usas en ingeniería de datos.
¿Qué es un archivo CSV?
CSV significa Comma-Separated Values (valores separados por comas). Es un archivo de texto plano donde cada línea representa una fila de datos y cada valor dentro de esa fila se separa con una coma. No tiene estructura interna más allá de eso: no guarda tipos de dato, no comprime nada y cualquier editor de texto puede abrirlo sin instalar nada adicional.
¿Qué es Apache Parquet?
Apache Parquet es un formato de archivo binario y columnar, diseñado específicamente para el procesamiento analítico de grandes volúmenes de datos. A diferencia del CSV, no puedes abrirlo en un bloc de notas porque su contenido no es texto: está codificado en binario, incluye el esquema de los datos dentro del propio archivo y aplica compresión de forma nativa.
Apache Parquet es un formato orientado a columnas diseñado para ofrecer un almacenamiento eficiente en comparación con formatos basados en filas como CSV.
Parquet fue desarrollado como un proyecto de código abierto bajo la Apache Software Foundation y hoy es el formato predeterminado en herramientas como Apache Spark, Google BigQuery, Amazon Athena y DuckDB. Su adopción masiva en entornos de datos modernos no es casualidad: responde a necesidades concretas de rendimiento y eficiencia que CSV no puede cubrir.
Almacenamiento por filas vs. almacenamiento por columnas
Esta es la diferencia más importante entre ambos formatos y la raíz de todo lo demás. Cuando un archivo guarda los datos fila por fila, como hace CSV, para leer una sola columna de un millón de registros tienes que recorrer todas las filas completas. Cuando los datos se guardan columna por columna, como en Parquet, puedes leer únicamente los valores de esa columna sin tocar el resto.
Imagina que tienes una tabla con 50 columnas y 10 millones de filas, y solo necesitas calcular el promedio de una columna. Con CSV, tu sistema tiene que leer los 10 millones de filas completos para llegar a esa columna. Con Parquet, lee únicamente esa columna y omite las otras 49 por completo, lo que reduce el tiempo de procesamiento y el consumo de memoria de forma drástica.
Comparativa técnica: Parquet frente a CSV
Para entender en qué se diferencian realmente, conviene revisar sus características técnicas una al lado de la otra. Aquí no hay un ganador absoluto: cada característica responde a un contexto diferente, y conocer ambas te permite tomar decisiones informadas al diseñar tu flujo de datos.
| Característica | CSV | Parquet |
|---|---|---|
| Tipo de archivo | Texto plano | Binario |
| Organización de datos | Por filas | Por columnas |
| Compresión nativa | No | Sí (Snappy, Gzip, Zstd) |
| Esquema embebido | No | Sí |
| Tipos de dato | Todo como texto | Tipado (int, float, string, etc.) |
| Legible por humanos | Sí | No |
| Compatible con Excel | Sí, nativo | Limitado (requiere complementos) |
| Tamaño del archivo | Referencia base | Entre 5 y 10 veces más pequeño |
| Velocidad de consulta | Lenta en grandes volúmenes | Muy rápida en análisis columnares |
| Tipos de dato complejos | No soporta | Arrays, mapas, estructuras anidadas |
| Inmutabilidad | Editable con texto | Inmutable una vez creado |
| Compatibilidad de herramientas | Universal | Spark, Pandas, Athena, BigQuery… |
Una de las diferencias que más sorprende a quienes empiezan es la del esquema embebido. En CSV, cuando cargas el archivo en Python o en cualquier otra herramienta, necesitas definir o inferir el tipo de cada columna en ese momento. ¿Es un número entero, un texto o una fecha? El archivo no lo dice. En Parquet, esa información viaja dentro del propio archivo, lo que evita errores de tipo y acelera el proceso de carga.
Compresión y tamaño de archivo: ¿cuál ocupa menos?
CSV no ofrece ningún tipo de compresión de forma nativa. Puedes comprimir el archivo externamente con gzip o zip, pero el formato en sí no hace nada al respecto. Parquet, en cambio, aplica compresión a nivel de columna usando algoritmos como Snappy, Gzip o Zstd. Esto funciona especialmente bien porque los valores de una misma columna tienden a parecerse entre sí, lo que hace que compriman mucho mejor que si los mezclas con datos de otras columnas.
El resultado práctico es significativo. Con compresión Snappy, un archivo Parquet suele ocupar alrededor de un tercio del tamaño original en CSV. Con Zstd, puede llegar a reducir ese tamaño al 15 % o menos. En conjuntos de datos de decenas de gigabytes, esto se traduce en miles de dólares menos en costes de almacenamiento en la nube y en tiempos de transferencia mucho menores entre servicios.
¿Cuándo deberías usar Parquet y cuándo CSV?
Ninguno de los dos formatos es universalmente superior. La elección correcta depende de qué vas a hacer con los datos, con qué herramientas trabajas y quién más necesita acceder a esos archivos. Conocer el contexto de uso es más valioso que seguir una regla fija.
Casos donde CSV sigue siendo la mejor opción
CSV tiene ventajas reales en situaciones muy concretas. No requiere ninguna librería especial para leerlo, se abre con Excel sin pasos adicionales y cualquier sistema, desde una base de datos antigua hasta una API básica, lo acepta. Es el formato más portable que existe para datos tabulares.
- Archivos pequeños: Para conjuntos de datos de pocos megabytes, el overhead de Parquet no tiene sentido. CSV es más rápido de crear y leer en ese rango.
- Intercambio con usuarios no técnicos: Si la persona que recibirá el archivo necesita abrirlo en Excel o editarlo manualmente, CSV es la única opción razonable.
- Depuración y revisión visual: Cuando necesitas inspeccionar el contenido de un archivo a simple vista para detectar errores, CSV te permite hacerlo desde cualquier editor de texto.
- Integración con sistemas legacy: Muchos sistemas heredados solo aceptan CSV. No tiene sentido forzar Parquet donde no hay soporte.
- Exportaciones puntuales: Para un informe que se genera una vez y se envía por correo, CSV cumple perfectamente sin añadir complejidad innecesaria.
Casos donde Parquet marca la diferencia
Parquet está diseñado para el mundo del análisis a escala. Cuando el volumen de datos crece y las consultas se vuelven más complejas, las diferencias entre ambos formatos dejan de ser teóricas y se convierten en horas de procesamiento ahorradas y costes de infraestructura reducidos.
- Data lakes y almacenes de datos: Herramientas como Amazon Athena, Google BigQuery o Azure Synapse están optimizadas para leer Parquet. Usarlo puede reducir los costes de consulta directamente.
- Pipelines de datos recurrentes: Si el mismo conjunto de datos se consulta repetidamente en un pipeline, Parquet amortiza su ventaja de velocidad en cada ejecución.
- Conjuntos de datos mayores de 100 MB: A partir de ese tamaño, la diferencia de rendimiento respecto a CSV empieza a ser perceptible y justifica el cambio de formato.
- Modelos de machine learning: Frameworks como Spark y la librería Pandas con PyArrow tratan Parquet como el formato nativo para entrenar y procesar datos.
- Datos con esquema fijo y tipado: Cuando el esquema de los datos es estable y los tipos de dato importan (fechas, enteros de precisión, booleanos), Parquet evita errores de interpretación que CSV no puede prevenir.
Un flujo de trabajo muy habitual en equipos de datos es usar CSV para las entradas del sistema, donde la compatibilidad universal importa, y convertir esos datos a Parquet una vez validados, para todo el procesamiento analítico posterior. Ambos formatos coexisten dentro del mismo pipeline sin ningún problema.
Parquet en pipelines y ecosistemas de datos modernos
Uno de los motivos por los que Parquet se ha convertido en el estándar de facto en el mundo del análisis de datos es su integración profunda con las herramientas del stack de datos moderno. No es una preferencia estética: la mayoría de los motores de consulta y plataformas de procesamiento distribuido están construidos para sacar el máximo rendimiento de este formato.
Herramientas del ecosistema que usan Parquet de forma nativa
Apache Spark
Lee y escribe Parquet como formato predeterminado en trabajos distribuidos.
DuckDB
Consulta archivos Parquet con SQL directamente, sin carga previa en memoria.
Amazon Athena
Cobra por datos escaneados: Parquet reduce el coste por consulta al leer menos datos.
Google BigQuery
Importa y exporta Parquet de forma nativa y lo recomienda para grandes cargas.
Pandas + PyArrow
Lee archivos Parquet directamente con pd.read_parquet() sin configuración adicional.
Delta Lake / Iceberg
Estos formatos de tabla abiertos usan Parquet como capa de almacenamiento interna.
Que herramientas tan distintas como DuckDB, Spark o BigQuery coincidan en usar Parquet como formato de referencia dice mucho de su solidez técnica. No es una moda pasajera: es la consecuencia lógica de un formato diseñado desde el principio para el análisis de datos a escala, con una comunidad de código abierto activa que lleva más de una década mejorándolo.
¿Cómo convertir un CSV a Parquet?
La conversión de CSV a Parquet es una operación sencilla con cualquiera de las herramientas habituales en ingeniería de datos. No necesitas instalar nada complejo ni conocer en profundidad el formato para hacerlo: en la mayoría de los casos, una sola línea de código es suficiente para hacer la transformación.
Conversión de CSV a Parquet: ejemplos por herramienta
Python con Pandas
import pandas as pd

df = pd.read_csv("datos.csv")
df.to_parquet("datos.parquet", engine="pyarrow")
DuckDB (SQL)
COPY (SELECT * FROM 'datos.csv')
TO 'datos.parquet' (FORMAT PARQUET);
Apache Spark (PySpark)
df = spark.read.csv("datos.csv", header=True, inferSchema=True)
df.write.parquet("datos.parquet")
Recuerda instalar las dependencias necesarias: pyarrow para Pandas y el conector correspondiente para Spark.
Al convertir de CSV a Parquet con Pandas o PySpark, es recomendable revisar los tipos de dato antes de guardar el archivo. Si el CSV tiene una columna de fechas almacenada como texto, es buen momento para convertirla al tipo correcto antes de escribir el Parquet, ya que el esquema quedará embebido y definirá cómo se leen los datos en adelante. Corregir tipos en este paso evita problemas más adelante en el pipeline.
También puedes elegir el algoritmo de compresión en el momento de la escritura. snappy ofrece un buen equilibrio entre velocidad y tamaño, mientras que zstd comprime más, pero es ligeramente más lento de generar. Para la mayoría de los pipelines analíticos, Snappy es la opción predeterminada más común y funciona bien sin necesidad de ajustes adicionales.
Preguntas frecuentes
¿Parquet es siempre mejor que CSV?
No, Parquet no es mejor en todos los escenarios. Para archivos pequeños, exportaciones puntuales, intercambio con usuarios no técnicos o situaciones donde necesitas leer el contenido del archivo a simple vista, CSV sigue siendo la opción más práctica. Parquet brilla cuando trabajas con grandes volúmenes de datos, consultas analíticas repetidas o entornos donde el coste de almacenamiento y el tiempo de procesamiento importan. La clave está en elegir el formato según el contexto, no de forma automática.
¿Se puede abrir un archivo Parquet en Excel?
De forma nativa y directa, no. Excel no abre archivos Parquet con un doble clic como lo hace con CSV. Microsoft 365 incluye una opción para importar Parquet a través de Power Query en versiones recientes, pero el proceso requiere pasos adicionales y no está disponible en todas las versiones. Si necesitas que el archivo sea accesible en Excel, lo más práctico es mantener una copia en CSV o convertirlo desde Python antes de compartirlo.
¿Qué compresión usa Parquet por defecto?
Depende de la herramienta que uses para escribir el archivo. Pandas con PyArrow usa Snappy como compresión predeterminada, que ofrece un buen equilibrio entre velocidad de lectura y escritura y reducción de tamaño. Apache Spark también utiliza Snappy por defecto. Zstd es una alternativa más agresiva en compresión, útil cuando el espacio en disco es crítico y puedes asumir un tiempo de escritura ligeramente mayor.
¿Qué herramientas soportan el formato Parquet?
Parquet cuenta con soporte nativo en la mayoría de las herramientas modernas de análisis y procesamiento de datos: Apache Spark, DuckDB, Pandas (con PyArrow o fastparquet), Apache Hive, Presto, Amazon Athena, Google BigQuery, Azure Synapse, Snowflake y Apache Flink, entre otras. También está integrado en los formatos de tabla abierta más populares como Delta Lake y Apache Iceberg, que lo usan como capa de almacenamiento subyacente.
¿Qué significa que Parquet es un formato columnar?
Significa que los datos se almacenan físicamente agrupados por columna, no por fila. En un archivo CSV, todos los valores de una misma fila están juntos en el disco. En Parquet, todos los valores de una misma columna están juntos. Esto tiene consecuencias directas en el rendimiento: cuando una consulta solo necesita tres columnas de una tabla con cincuenta, Parquet puede leer únicamente esas tres y saltarse el resto por completo, algo que CSV no puede hacer porque sus datos están mezclados fila a fila.
¿Es Parquet más lento de escribir que CSV?
En general, sí. Escribir un archivo Parquet requiere más trabajo que escribir un CSV porque el sistema tiene que reorganizar los datos por columnas, aplicar compresión y construir los metadatos del esquema. Este coste adicional en la escritura se recupera con creces en las lecturas posteriores, especialmente si el mismo archivo se va a consultar muchas veces. Para archivos que se escriben una vez y se leen cientos de veces, como ocurre en un data lake, esta diferencia es completamente irrelevante en la práctica.
¿Qué pasa con el esquema de datos en un archivo CSV?
En un archivo CSV, el esquema no existe como parte del archivo. Todo el contenido se guarda como texto plano, y es la herramienta que lo carga la que debe inferir o recibir instrucciones sobre qué tipo de dato tiene cada columna. Esto puede generar errores silenciosos: una columna de fechas puede cargarse como texto, o un identificador numérico puede perder ceros a la izquierda. En Parquet, el esquema viaja dentro del archivo y define con precisión el tipo de cada columna, eliminando esa ambigüedad desde el origen.
Conclusión
CSV y Parquet no compiten por el mismo espacio: cada uno responde a necesidades distintas dentro de un flujo de trabajo con datos. CSV es el formato universal, legible y portable, ideal para compartir información, hacer exportaciones rápidas o trabajar con archivos pequeños. Parquet, en cambio, es el formato del análisis a escala: columnar, comprimido, tipado y optimizado para los motores de consulta modernos.
Lo que aprendiste aquí tiene aplicación directa desde el primer día: si estás construyendo un pipeline de datos, puedes usar CSV en las etapas de entrada donde necesitas compatibilidad, y convertir a Parquet en cuanto los datos estén validados y listos para ser procesados. Esa combinación es exactamente la que usan los equipos de datos profesionales en sus proyectos reales.
Si te interesa seguir profundizando en el mundo de los datos, este sitio web tiene más contenido sobre herramientas, formatos y arquitecturas que te ayudarán a construir una base sólida para trabajar con datos a cualquier escala.
Sigue aprendiendo:
Librerías de Python para ingeniería de datos
100 preguntas de entrevista para ingeniero de datos
¿Qué es un data warehouse y para qué sirve?
Procesamiento de datos en tiempo real
¿En qué consiste la ingeniería de base de datos?
Stack de datos moderno: La revolución silenciosa del análisis
Apache Flink vs. Spark Streaming
Lakehouse: La arquitectura que unifica todo
