
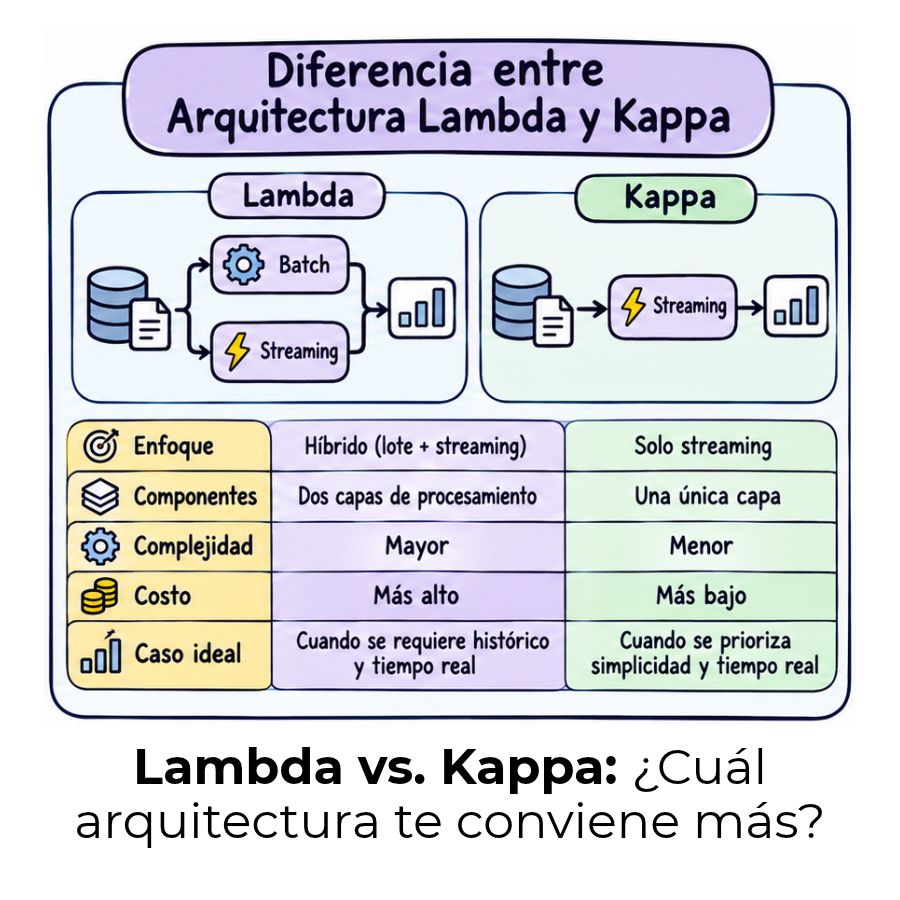
La diferencia entre la arquitectura Lambda y Kappa está en cómo procesan los datos. Lambda combina un pipeline batch y uno de streaming para obtener precisión e inmediatez. Kappa elimina el batch y trabaja solo con streaming, apostando por la simplicidad operativa sin sacrificar el tiempo real.
¿Qué es la arquitectura Lambda y cómo funciona?
La arquitectura Lambda es un modelo de procesamiento de datos diseñado para manejar grandes volúmenes de información, combinando dos rutas paralelas: una para el procesamiento por lotes (batch) y otra para el procesamiento en tiempo real (streaming). Su principio central es que ninguna capa por sí sola puede ofrecer precisión histórica y baja latencia al mismo tiempo, por lo que las dos operan juntas y sus resultados se fusionan en una capa de servicio.
Fue propuesta por Nathan Marz alrededor de 2011 como respuesta a los límites que tenían los sistemas de procesamiento de la época, donde los motores de streaming aún no eran lo suficientemente fiables para garantizar exactitud en cálculos complejos. La solución fue mantener dos sistemas independientes que se complementan, en lugar de depender de uno solo.
Las tres capas de la arquitectura Lambda
Lambda se organiza en tres capas con funciones bien diferenciadas. Cada capa resuelve un problema específico, y juntas ofrecen un sistema capaz de responder tanto a consultas históricas complejas como a eventos que acaban de ocurrir.
Capa Batch
Procesa todos los datos históricos disponibles mediante trabajos programados. Opera sobre grandes volúmenes y genera vistas precalculadas muy precisas, aunque tarda horas en reflejar cambios recientes.
Capa Speed (o de velocidad)
Procesa los datos más recientes en tiempo real para compensar la latencia de la capa batch. Sus resultados son aproximados, pero llegan en segundos o milisegundos, lo que la hace ideal para alertas y dashboards en vivo.
Capa Serving (o de servicio)
Combina los resultados de las dos capas anteriores y los expone para consultas. Es el punto de acceso del sistema: quien consulta recibe una respuesta que mezcla precisión histórica con actualidad inmediata.
¿Qué herramientas se usan en Lambda?
El ecosistema de herramientas de Lambda refleja su naturaleza dual. Apache Hadoop y Apache Spark son las referencias habituales para la capa batch, mientras que Apache Flink, Spark Streaming o Apache Storm se ocupan de la capa de velocidad. Para la capa de servicio se utilizan sistemas como Apache HBase, Cassandra o Elasticsearch, dependiendo del tipo de consulta que se necesite atender.
¿Qué es la arquitectura Kappa y en qué se diferencia?
La arquitectura Kappa nació como una respuesta directa a la complejidad de Lambda. Su propuesta central es eliminar la capa batch por completo y tratar todos los datos como un flujo continuo, sin importar si son recientes o históricos. Fue planteada por Jay Kreps, uno de los creadores de Apache Kafka, quien argumentó que mantener dos sistemas paralelos generaba más problemas de los que resolvía.
En Kappa, cuando necesitas reprocesar datos históricos, no cambias de sistema: simplemente vuelves a reproducir el flujo desde el inicio del log de eventos, usando el mismo motor de streaming que procesa los datos en tiempo real. Esto elimina la duplicación de lógica y reduce considerablemente el esfuerzo de mantenimiento.
¿Cómo funciona el pipeline único de Kappa?
En Kappa, todos los datos entran por un sistema de mensajería persistente, típicamente Apache Kafka, que actúa como un registro inmutable de eventos. El motor de streaming lee este registro de forma continua y procesa cada evento a medida que llega, almacenando los resultados en una capa de servicio para consultas posteriores. Si en algún momento necesitas recalcular resultados con una lógica diferente, simplemente replanteas el procesamiento desde el inicio del log.
¿Qué herramientas se usan en Kappa?
El stack de Kappa es más reducido que el de Lambda porque todo el peso recae en el motor de streaming. Apache Kafka es la pieza central para la ingestión y el almacenamiento del log de eventos, mientras que Apache Flink o Apache Spark Structured Streaming se encargan del procesamiento. Para la capa de servicio se utilizan bases de datos como Apache Cassandra, Redis o soluciones equivalentes optimizadas para consultas de baja latencia.
Diferencia entre arquitectura Lambda y Kappa
La diferencia más importante entre ambas arquitecturas no es técnica, sino filosófica. Lambda cree que el procesamiento batch y el streaming son dos problemas distintos que requieren soluciones distintas; Kappa cree que el streaming, bien implementado, es suficiente para ambos. Todo lo demás — complejidad, coste, herramientas, casos de uso — deriva de esta decisión de diseño.
| Aspecto | Arquitectura Lambda | Arquitectura Kappa |
|---|---|---|
| Número de pipelines | Dos (batch + speed) | Uno (solo streaming) |
| Procesamiento histórico | Capa batch dedicada | Replay del log de eventos |
| Complejidad operativa | Alta: dos sistemas a mantener | Menor: un sistema unificado |
| Latencia | Mixta (baja en speed, alta en batch) | Baja de forma consistente |
| Precisión histórica | Muy alta | Alta (con reprocesamiento) |
| Duplicación de lógica | Sí, en batch y speed | No |
| Coste de infraestructura | Mayor | Menor |
| Curva de aprendizaje | Pronunciada | Más accesible |
| Herramientas típicas | Hadoop, Spark, Flink, HBase | Kafka, Flink, Cassandra |
| Ideal para | Análisis histórico profundo y tolerancia a fallos robusta | Tiempo real, simplicidad, equipos ágiles |
Otro punto que marca la diferencia en la práctica es el mantenimiento del código. En Lambda debes implementar la misma lógica de negocio dos veces: una para el batch y otra para el streaming. Cuando esa lógica cambia, debes actualizarla en ambos sistemas simultáneamente, lo que aumenta el riesgo de inconsistencias y eleva el coste de operación a largo plazo.
Ventajas y desventajas de cada arquitectura
Elegir entre Lambda y Kappa no es una cuestión de cuál es mejor en términos absolutos. Cada una tiene fortalezas claras y limitaciones reales que solo cobran sentido al contrastarlas con las necesidades concretas de tu proyecto. Conocerlas te ayuda a evitar sobrediseñar una solución o, al contrario, quedarte corto.
Ventajas y limitaciones de Lambda
✔ Ventajas
- Tolerancia a fallos muy robusta gracias a la redundancia entre capas.
- Precisión histórica excepcional para grandes volúmenes de datos pasados.
- Capacidad de ofrecer tanto análisis en tiempo real como informes históricos detallados.
- Madurez del ecosistema: gran cantidad de documentación y casos probados.
✖ Limitaciones
- Alta complejidad operativa: dos sistemas que sincronizar y mantener.
- Duplicación de lógica de negocio entre la capa batch y la capa speed.
- Mayor coste de infraestructura y recursos humanos especializados.
- Los cambios en las reglas de negocio implican actualizaciones en dos lugares.
Ventajas y limitaciones de Kappa
✔ Ventajas
- Un solo pipeline: menor complejidad, menos puntos de fallo potenciales.
- Sin duplicación de lógica: las actualizaciones se aplican en un único lugar.
- Menor coste de infraestructura y mantenimiento a largo plazo.
- Más accesible para equipos pequeños o con experiencia limitada en big data.
✖ Limitaciones
- El reprocesamiento histórico masivo puede consumir muchos recursos de cómputo.
- No siempre es la opción más eficiente para cálculos muy complejos sobre datos históricos.
- Requiere que el motor de streaming sea lo suficientemente maduro y fiable.
- Gestionar eventos duplicados o fuera de orden puede ser más delicado que en batch.
¿Cuándo usar Lambda y cuándo usar Kappa?
La respuesta depende de tres variables: el tipo de análisis que necesitas, el tamaño de tu equipo y los recursos de infraestructura disponibles. No existe una regla universal, pero sí hay señales claras que apuntan hacia una u otra opción. Revisarlas antes de diseñar tu sistema puede ahorrarte meses de trabajo innecesario.
Un caso práctico ayuda a entenderlo mejor: si construyes un sistema de comercio electrónico que necesita tanto actualizar el inventario al instante como generar informes de ventas mensuales con alta exactitud, Lambda tiene más sentido. Si, en cambio, desarrollas un sistema de detección de fraude que solo necesita reaccionar a eventos en tiempo real, Kappa es la elección más eficiente y fácil de operar. Para arquitecturas nuevas, Kappa generalmente reduce tiempo y costes de arranque.
Casos de uso reales de Lambda y Kappa
Entender cómo se aplican estas arquitecturas en escenarios concretos facilita mucho la decisión de diseño. Los casos de uso no son intercambiables: cada arquitectura brilla en contextos distintos, y forzar una donde encaja mejor la otra termina generando deuda técnica y costes operativos innecesarios.
Casos de uso típicos de Lambda
- Plataformas de análisis de redes sociales: combinan métricas históricas acumuladas (batch) con tendencias de los últimos minutos (streaming).
- Retail y comercio electrónico: generan informes de ventas históricos precisos mientras actualizan el inventario en tiempo real.
- Sistemas financieros regulados: requieren registros exactos auditables de datos pasados junto con alertas inmediatas ante operaciones sospechosas.
- Análisis de logs de servidores: procesan millones de eventos históricos para tendencias y, al mismo tiempo, detectan errores críticos al momento.
Casos de uso típicos de Kappa
- Detección de fraude bancario: cada transacción se evalúa en milisegundos con el mismo pipeline que procesa el histórico cuando es necesario.
- Monitorización de infraestructura IoT: miles de sensores emiten datos continuamente y el sistema reacciona a anomalías en tiempo real.
- Plataformas de streaming de contenido: recomiendan contenido al usuario basándose en su comportamiento reciente dentro de la misma sesión.
- Seguridad de redes: detecta intrusiones o patrones de tráfico anómalos procesando cada paquete como un evento del flujo de datos.
Vale la pena mencionar que, en el panorama actual de la ingeniería de datos, muchos equipos optan por variantes híbridas o arquitecturas modernas que toman lo mejor de ambos modelos. Para profundizar en cómo se organizan los datos dentro de estas soluciones, puedes explorar la arquitectura medallion, que propone una estructura por capas muy utilizada junto a pipelines de streaming modernos.
Preguntas frecuentes
¿Qué diferencia principal hay entre Lambda y Kappa?
La diferencia principal radica en el número de pipelines de procesamiento. Lambda mantiene dos rutas paralelas: una para datos históricos mediante procesamiento batch y otra para datos en tiempo real mediante streaming; ambas convergen en una capa de servicio. Kappa, en cambio, elimina la capa batch y procesa todo a través de un único flujo de streaming continuo, recurriendo al replay del log de eventos cuando necesita reanalizar datos históricos. Esto hace que Lambda sea más precisa y robusta, mientras que Kappa es más simple y eficiente de operar.
¿Cuál arquitectura es más sencilla de mantener?
Kappa es considerablemente más sencilla de mantener porque centraliza toda la lógica de procesamiento en un único sistema. En Lambda, cualquier cambio en las reglas de negocio debe aplicarse de forma separada en la capa batch y en la capa speed, lo que duplica el esfuerzo y multiplica el riesgo de que ambas versiones presenten resultados inconsistentes. Para equipos con recursos limitados, Kappa reduce significativamente la carga operativa, aunque exige que el motor de streaming sea lo suficientemente maduro y confiable para el volumen de datos del proyecto.
¿Puede Kappa reemplazar completamente a Lambda?
En la mayoría de los casos modernos, sí. Los motores de streaming actuales como Apache Flink han madurado lo suficiente para manejar escenarios que antes solo eran viables con una capa batch dedicada. Sin embargo, hay situaciones donde Lambda sigue siendo preferible: cuando los volúmenes históricos son tan grandes que el reprocesamiento completo vía replay resulta prohibitivo en tiempo y coste, o cuando las regulaciones exigen registros batch auditables con garantías de exactitud muy estrictas. Kappa no reemplaza a Lambda en todos los casos, pero sí es suficiente — y más eficiente — para la gran mayoría de los proyectos actuales de ingeniería de datos.
¿Qué es el procesamiento batch en la arquitectura Lambda?
El procesamiento batch consiste en acumular datos durante un período de tiempo y procesarlos todos juntos en un único trabajo programado, en lugar de tratarlos uno a uno al instante. En Lambda, la capa batch opera sobre el conjunto completo de datos históricos y genera vistas precalculadas de alta precisión. Esta operación puede tardar horas, pero el resultado es extremadamente exacto. Herramientas como Apache Hadoop o Apache Spark son las más utilizadas para esta capa, ya que están diseñadas para manejar volúmenes masivos de datos de forma distribuida.
¿Qué lenguajes y tecnologías se asocian a cada arquitectura?
Ambas arquitecturas se implementan principalmente con Python, Scala o Java, que son los lenguajes dominantes en el ecosistema de procesamiento distribuido. Para Lambda, las tecnologías más habituales son Apache Hadoop y Apache Spark en la capa batch, Apache Flink o Storm en la capa speed y sistemas como HBase o Cassandra para la capa de servicio. Kappa gira principalmente alrededor de Apache Kafka como log de eventos y Apache Flink o Spark Structured Streaming como motor de procesamiento. La elección del lenguaje depende más del framework que del modelo de arquitectura en sí.
¿Qué arquitectura es mejor para datos en tiempo real?
Para datos exclusivamente en tiempo real, Kappa es la opción más adecuada. Al eliminar la capa batch, todo el sistema está diseñado y optimizado para procesar eventos en cuanto llegan, con latencias bajas y consistentes. Lambda también gestiona datos en tiempo real a través de su capa speed, pero lo hace de manera secundaria, ya que su fuerza real está en combinar esa inmediatez con el análisis histórico profundo. Si tu sistema no necesita análisis histórico complejo, Kappa ofrece mejor rendimiento en tiempo real con menos complejidad operativa.
¿Cómo se relacionan Lambda y Kappa con la arquitectura medallion?
Lambda y Kappa son modelos de procesamiento de datos, mientras que Medallion es un patrón de organización y calidad de los datos. No son mutuamente excluyentes: puedes implementar un pipeline Kappa o Lambda y organizar los datos resultantes según el modelo medallion, con sus capas Bronze, Silver y Gold. La combinación de ambos enfoques es habitual en plataformas modernas de datos, donde Kappa aporta la velocidad y simpleza del procesamiento y Medallion garantiza que los datos estén bien estructurados, validados y listos para análisis. Si quieres entender mejor este patrón complementario, puedes explorar el apartado dedicado a la ingeniería de datos en este sitio web.
Conclusión
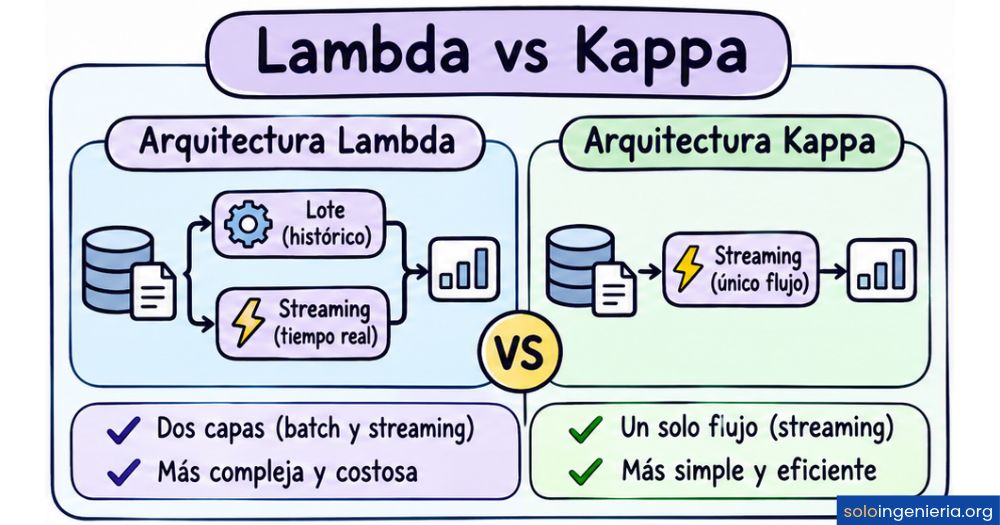
La diferencia entre la arquitectura Lambda y Kappa se resume en una decisión de diseño fundamental: ¿necesitas dos pipelines especializados o uno solo que lo haga todo? Lambda apuesta por la dualidad para lograr precisión histórica y tiempo real de forma simultánea; Kappa simplifica ese planteamiento y confía en la madurez del streaming moderno para cubrir ambos frentes desde un único sistema.
Ahora que conoces las diferencias, las ventajas y los escenarios de uso de cada modelo, puedes aplicar ese conocimiento de forma práctica: si tu proyecto requiere análisis histórico profundo y tolerancia a fallos robusta, Lambda es tu punto de partida. Si priorizas la velocidad, la simplicidad operativa y un equipo ágil, Kappa te dará mejores resultados con menos esfuerzo. La clave no es elegir la arquitectura más compleja, sino la que mejor encaja con tus datos, tu equipo y tus objetivos.
La ingeniería de datos es un campo que evoluciona rápido, y entender estos modelos es solo el primer paso. En este sitio web encontrarás más contenido que te ayudará a seguir construyendo una base sólida, desde los fundamentos hasta las decisiones de arquitectura más avanzadas.
Sigue aprendiendo:
AWS Glue: El secreto detrás de los grandes pipelines de datos
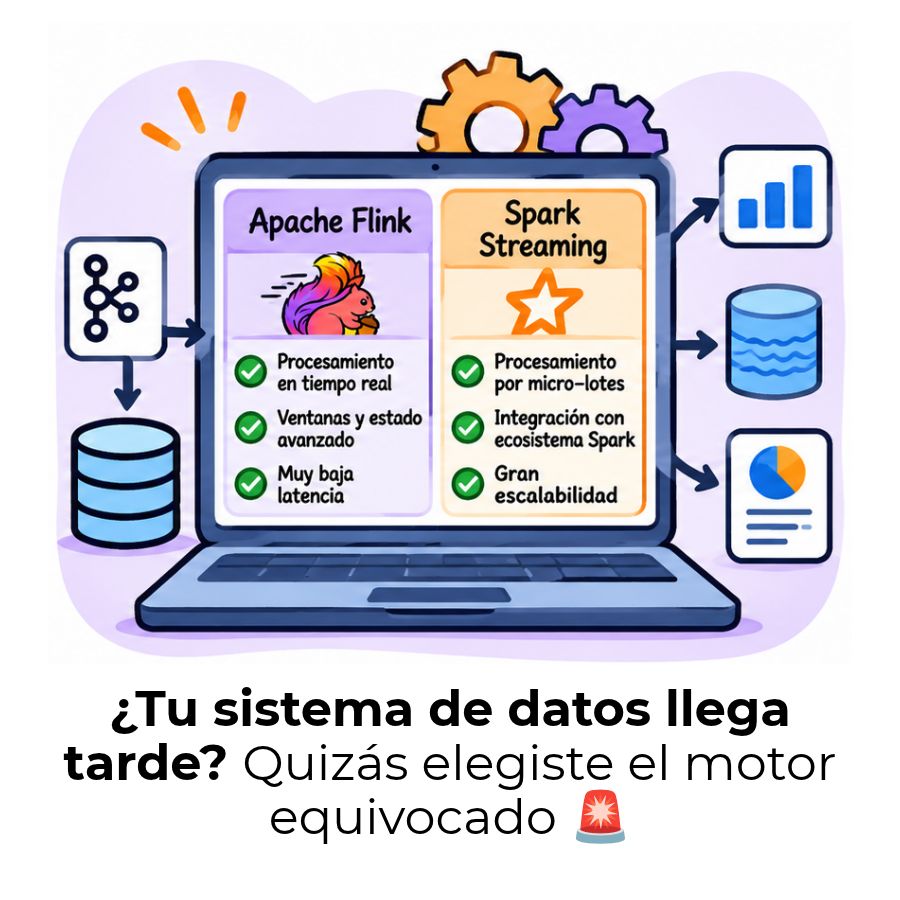
Apache Flink vs. Spark Streaming
Certificaciones para ingeniero de datos
DBT: La herramienta que cambió cómo se trabajan los datos
¿Qué hace un data steward y cuál es su rol?
Diferencia entre Databricks y Snowflake
Buenas prácticas de ingeniería de datos
Herramientas ETL: Elige la correcta y ahorra horas de trabajo
