
Cada vez que una empresa toma una decisión basada en datos, hay alguien que ya hizo el trabajo más difícil: recoger, limpiar y organizar esa información antes de que nadie la vea. Ese alguien es el ingeniero de datos, un perfil técnico cuyo trabajo ocurre entre bastidores y que, sin embargo, sostiene todo el ecosistema de datos de una organización.
¿Qué es un ingeniero de datos?
Un ingeniero de datos es el profesional que diseña, construye y mantiene los sistemas que permiten recopilar, transformar y poner a disposición los datos de una organización. No trabaja con los datos para analizarlos ni para extraer conclusiones: su misión es garantizar que esos datos lleguen al lugar correcto, en el momento adecuado y con la calidad necesaria para que otros puedan usarlos.
Dentro del ecosistema de ingeniería de datos, este perfil actúa como el arquitecto de la infraestructura técnica. Sin su trabajo, los científicos de datos no tendrían información fiable con la que trabajar, los analistas no podrían generar reportes consistentes y los sistemas de inteligencia artificial no dispondrían de los insumos que necesitan para funcionar.
Su papel dentro del equipo de datos
Dentro de un equipo de datos, el ingeniero ocupa una posición puente entre las fuentes de información y quienes la consumen. Sienta las bases tecnológicas para que otros perfiles, como el científico de datos o el analista, puedan hacer su trabajo sin preocuparse por la calidad ni la disponibilidad de la información. Sin esa base, todo el análisis que venga después queda en entredicho.
En organizaciones pequeñas, este profesional suele asumir también algunas tareas de análisis. En empresas más grandes, el rol se especializa: algunos ingenieros se centran en construir pipelines, mientras otros se dedican exclusivamente a gestionar almacenes de datos o garantizar la calidad del dato en cada etapa del proceso.
¿Qué hace un ingeniero de datos en su día a día?
El trabajo cotidiano de un ingeniero de datos no sigue un guion único, pero sí gira siempre alrededor de los mismos ejes: construir sistemas que mueven datos, transformarlos para que sean útiles y asegurarse de que todo funcione de forma estable y escalable. Dependiendo del tamaño de la empresa y del sector, el peso de cada tarea varía, pero el objetivo siempre es el mismo: que el dato llegue limpio, a tiempo y en el formato correcto.
Construcción y mantenimiento de pipelines de datos
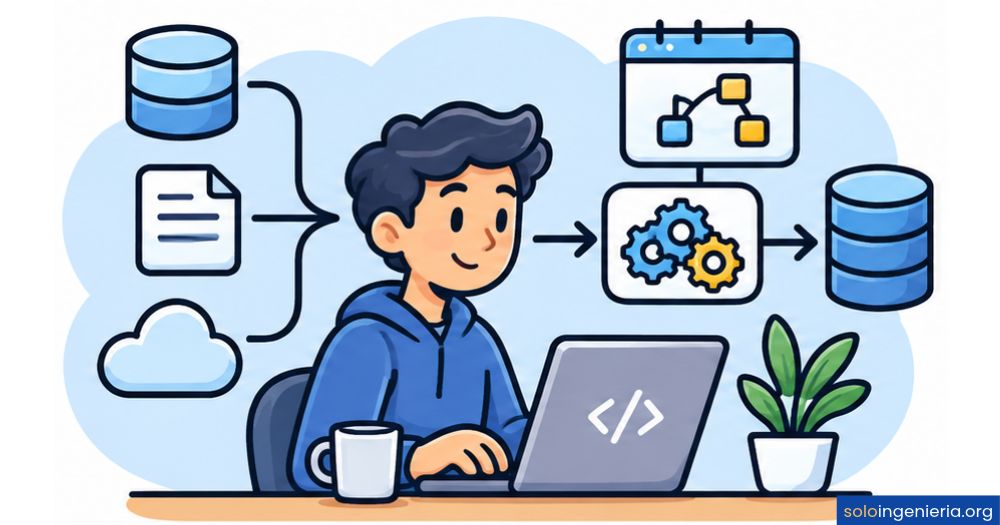
Un pipeline de datos es el camino automatizado que recorre la información desde su origen hasta su destino final. El ingeniero diseña, construye y da mantenimiento a estos canales para que los datos fluyan de forma continua, sin interrupciones ni pérdidas. Si una fuente falla o el volumen de datos se dispara, el pipeline debe responder con solidez.
Pipeline de datos: flujo paso a paso
Procesos ETL y ELT: extracción, transformación y carga
El proceso ETL (Extracción, Transformación y Carga) es una de las tareas más reconocibles dentro de la ingesta de datos. Consiste en extraer información de distintas fuentes, transformarla para que cumpla un estándar de calidad y cargarla después en el sistema de destino. El ingeniero de datos define y automatiza este proceso para que ocurra de forma periódica y sin intervención manual.
En los últimos años, el modelo ELT (Extracción, Carga y Transformación) ha ganado terreno. La diferencia es sutil pero relevante: en este caso, los datos se cargan primero en bruto y se transforman después dentro del propio sistema de destino. Esto aprovecha la potencia de los almacenes de datos modernos en la nube para realizar transformaciones más rápidas y flexibles.
Modelado y almacenamiento de datos
Una vez que los datos llegan al sistema de destino, el ingeniero define cómo se organizan y se almacenan. El modelado de datos determina la estructura lógica que permitirá consultar la información de forma eficiente, sin que el sistema se ralentice ni colapse bajo la presión de miles de consultas simultáneas. Un buen modelo de datos puede marcar la diferencia entre un análisis que tarda segundos y uno que tarda horas.
Los sistemas de almacenamiento más habituales son los data warehouses (almacenes estructurados para análisis) y los data lakes (repositorios que almacenan datos en su forma original, sin esquema previo). La elección entre uno u otro depende del tipo de datos y del uso que se les vaya a dar.
Responsabilidades principales del ingeniero de datos
Aunque cada empresa ajusta el rol a sus propias necesidades, existe un núcleo de responsabilidades que comparte prácticamente todo ingeniero de datos. Conocer estas funciones es la forma más directa de entender qué valor aporta este profesional dentro de una organización orientada a datos.
Desarrolla, prueba y mantiene las arquitecturas técnicas que soportan el flujo de datos en la organización.
Diseña sistemas de almacenamiento que crecen con el volumen de datos sin perder rendimiento ni fiabilidad.
Detecta errores, duplicados e inconsistencias, y aplica procesos de validación para garantizar la fiabilidad de cada registro.
Configura flujos de trabajo automáticos para que los datos se procesen y actualicen sin intervención manual constante.
Prepara y organiza los datos para que científicos y analistas puedan trabajar con ellos sin barreras técnicas ni limpiezas adicionales.
Adapta la infraestructura de datos a los objetivos estratégicos de la empresa, identificando qué información aporta valor real.
¿En qué se diferencia del científico de datos y el analista?
Una de las confusiones más frecuentes entre quienes se acercan a este campo es mezclar estos tres roles. Los tres trabajan con datos, pero lo hacen en momentos distintos del proceso y con objetivos muy diferentes. Entender esa diferencia es clave para saber qué carrera quieres construir o qué perfil necesita tu equipo.
| Aspecto | Ingeniero de datos | Científico de datos | Analista de datos |
|---|---|---|---|
| Enfoque principal | Infraestructura y flujo de datos | Modelos predictivos y estadística | Análisis e interpretación de resultados |
| ¿Con qué trabaja? | Pipelines, almacenes, transformaciones | Algoritmos de machine learning | Dashboards, reportes, KPIs |
| Perfil predominante | Muy técnico e ingenieril | Técnico con base estadística | Analítico con visión de negocio |
| Resultado de su trabajo | Datos disponibles y fiables | Modelos y predicciones | Insights y decisiones |
| Herramientas habituales | Spark, Airflow, SQL, Python | TensorFlow, scikit-learn, Python | Tableau, Power BI, SQL |
Una forma sencilla de recordarlo: el ingeniero construye la carretera, el científico de datos diseña los vehículos que circulan por ella y el analista interpreta a dónde están llegando esos vehículos. Los tres roles son complementarios y, en muchas organizaciones, trabajan de forma estrecha.
Habilidades técnicas que necesita un ingeniero de datos
El perfil técnico de un ingeniero de datos es amplio y sigue evolucionando a medida que aparecen nuevas herramientas. No obstante, existe un conjunto de competencias que se repite de forma consistente en las ofertas de trabajo y que cualquier persona que quiera dedicarse a esto debería dominar. Dominar estas habilidades te permitirá moverte con soltura en casi cualquier entorno de datos, independientemente del sector.
Lenguajes de programación y bases de datos
El lenguaje más utilizado en la ingeniería de datos es Python, por su versatilidad y la cantidad de bibliotecas disponibles para procesar y transformar datos. SQL es igual de imprescindible: prácticamente toda la interacción con bases de datos relacionales pasa por este lenguaje, y un ingeniero que no lo domine con fluidez tiene una limitación real. Además del trabajo con ingeniería de base de datos, también resulta muy valioso conocer sistemas NoSQL como MongoDB o Cassandra, que se usan cuando el dato no encaja en un esquema tabular.
Herramientas y plataformas más usadas
Más allá de los lenguajes, el ingeniero de datos trabaja con un ecosistema de herramientas especializadas. Conocerlas no significa saberlas todas de memoria, sino entender para qué sirve cada una y cuándo aplicarla. Las que aparecen con más frecuencia en el mercado laboral son las siguientes:
- Apache Spark: Motor de procesamiento distribuido que permite trabajar con volúmenes de datos masivos de forma paralela y eficiente.
- Apache Airflow: Plataforma de orquestación de flujos de trabajo que automatiza la ejecución de tareas en el orden correcto y gestiona dependencias.
- Kafka: Sistema de mensajería distribuida pensado para el procesamiento de datos en tiempo real, muy usado en entornos con flujos continuos de información.
- Plataformas cloud (AWS, Google Cloud, Azure): Los grandes proveedores de nube ofrecen servicios específicos para almacenar, procesar y orquestar datos a escala sin gestionar servidores físicos.
- dbt (data build tool): Herramienta que permite transformar datos directamente dentro del almacén de datos usando SQL, con control de versiones y pruebas integradas.
Habilidades blandas que marcan la diferencia
El trabajo de un ingeniero de datos no ocurre en soledad. Este profesional interactúa constantemente con analistas, científicos de datos, equipos de producto y responsables de negocio. Por eso, las habilidades técnicas por sí solas no son suficientes: la forma en que te comunicas y colaboras determina en gran medida el impacto real de tu trabajo.
Traducir conceptos técnicos a un lenguaje comprensible para perfiles no técnicos.
Identificar la causa raíz de un fallo en el pipeline antes de que afecte al negocio.
Coordinarse con distintos equipos para que los datos sirvan a múltiples propósitos a la vez.
Entender qué información aporta valor real para priorizar lo que merece esfuerzo técnico.
Cuestionar si un dato tiene sentido antes de darlo por válido y propagarlo por el sistema.
¿En qué sectores trabaja un ingeniero de datos?
La ingeniería de datos no está atada a un solo sector. Cualquier organización que maneje un volumen significativo de información necesita a alguien que se encargue de gestionarla bien. Esto convierte al ingeniero de datos en uno de los perfiles con mayor movilidad laboral entre industrias. A continuación se describen los sectores donde la demanda es más alta y el impacto del rol más visible.
- Sector financiero: Detección de fraudes, análisis de riesgo crediticio y cumplimiento regulatorio son algunas de las áreas donde el dato tiene consecuencias directas y donde los errores cuestan muy caro.
- Salud: Gestión de historiales clínicos electrónicos, apoyo a la investigación médica y análisis de datos genómicos para personalizar tratamientos.
- Comercio electrónico y retail: Sistemas de recomendación, gestión de inventario en tiempo real y análisis del comportamiento de compra para mejorar la experiencia del cliente.
- Telecomunicaciones: Monitorización de redes, análisis de tráfico de datos y detección de anomalías en tiempo real para mantener la calidad del servicio.
- Medios y entretenimiento: Plataformas de streaming como las de música o vídeo dependen de la ingeniería de datos para personalizar recomendaciones y gestionar el consumo masivo de contenido.
- Sector público: Análisis demográfico, gestión de servicios ciudadanos y apoyo a políticas basadas en evidencia son usos cada vez más frecuentes en administraciones públicas.
¿Qué estudiar para convertirse en ingeniero de datos?
No existe un único camino para llegar a ser ingeniero de datos, pero sí hay ciertas bases formativas que aparecen con mucha frecuencia entre los profesionales de este campo. La combinación de formación técnica, práctica con proyectos reales y actualización constante suele ser más valorada que un título académico concreto. Lo que buscan las empresas es que sepas resolver problemas reales con datos, no que hayas cursado una carrera específica.
Las titulaciones más habituales entre los ingenieros de datos son las relacionadas con informática, ingeniería de sistemas, matemáticas o estadística. Sin embargo, hay profesionales que llegan desde otras disciplinas gracias a bootcamps especializados, cursos certificados y un portafolio sólido de proyectos. Lo que sí es constante en todos los casos es la necesidad de mantenerse actualizado, ya que las herramientas y las plataformas de este campo evolucionan con rapidez.
«Convertirse en ingeniero de datos no es solo aprender herramientas: es aprender a transformar información en valor real.»
Preguntas frecuentes
¿Qué hace exactamente un ingeniero de datos?
Un ingeniero de datos diseña, construye y mantiene los sistemas que permiten recoger información de distintas fuentes, transformarla y ponerla a disposición de quienes la necesitan. Su trabajo garantiza que los datos lleguen de forma limpia, estructurada y fiable a los analistas, científicos de datos y otros sistemas que los utilizan para tomar decisiones o entrenar modelos. No analiza resultados ni interpreta tendencias: su rol es asegurarse de que la infraestructura del dato funcione correctamente.
¿Cuál es la diferencia entre un ingeniero de datos y un científico de datos?
El ingeniero de datos construye y mantiene la infraestructura que hace posible el trabajo con datos, mientras que el científico de datos utiliza esos datos para crear modelos estadísticos y predictivos. El primero se centra en que el dato esté disponible y sea fiable; el segundo, en extraer conocimiento de él. Son roles complementarios: el científico de datos depende del trabajo previo del ingeniero para poder operar con garantías.
¿Qué lenguajes de programación usa un ingeniero de datos?
Los lenguajes más usados por los ingenieros de datos son Python y SQL. Python se emplea para construir pipelines, transformar datos y automatizar procesos, mientras que SQL es el estándar para consultar y manipular bases de datos relacionales. En entornos más avanzados también se usa Scala, especialmente cuando se trabaja con Apache Spark a gran escala. Conocer al menos Python y SQL con fluidez es el punto de partida para cualquier posición en este campo.
¿Qué es un pipeline de datos?
Un pipeline de datos es el sistema automatizado que mueve información desde su origen hasta su destino siguiendo una secuencia de pasos definida. Incluye la extracción de los datos de una o varias fuentes, su transformación para que cumplan ciertos criterios de calidad y formato, y su carga en el sistema donde serán utilizados. El ingeniero de datos es quien diseña, construye y mantiene estos pipelines para que funcionen de forma continua y sin errores.
¿Qué es un proceso ETL en ingeniería de datos?
ETL son las siglas de Extracción, Transformación y Carga, y describe el proceso por el cual los datos se recogen de distintas fuentes, se procesan para darles el formato y la calidad adecuados, y se cargan en un sistema de almacenamiento como un data warehouse. Es uno de los procesos centrales en la ingeniería de datos y su correcta implementación determina en gran medida la fiabilidad de todo el análisis que se apoye en esos datos.
¿En qué sectores trabaja un ingeniero de datos?
El ingeniero de datos puede trabajar en prácticamente cualquier sector que maneje grandes volúmenes de información. Los más demandantes son el financiero, la salud, el comercio electrónico, las telecomunicaciones y los medios de comunicación. También hay una demanda creciente en el sector público y en startups tecnológicas, donde este perfil suele asumir un rol más amplio por las necesidades propias de equipos más pequeños.
¿Qué formación se necesita para ser ingeniero de datos?
No existe una formación única obligatoria, pero la mayoría de los ingenieros de datos provienen de titulaciones en informática, ingeniería de sistemas, matemáticas o estadística. También hay quienes llegan a este rol desde otros campos a través de programas intensivos especializados y proyectos prácticos. Lo que las empresas valoran por encima del título es el dominio real de las herramientas, la capacidad para resolver problemas y un portafolio de proyectos demostrables.
¿Cuánto gana un ingeniero de datos?
La remuneración de un ingeniero de datos varía considerablemente según el país, el sector, el tamaño de la empresa y la experiencia del profesional. En términos generales, se trata de uno de los perfiles mejor pagados dentro del ecosistema tecnológico, especialmente a partir del nivel senior. Las posiciones en empresas de tecnología, finanzas y startups con alto volumen de datos suelen ofrecer los rangos salariales más elevados. Las certificaciones en plataformas cloud y la experiencia con herramientas de procesamiento en tiempo real también tienen un impacto positivo en la retribución.
Conclusión
El ingeniero de datos es el profesional que hace posible que todo el ecosistema de datos funcione. Diseña las tuberías por las que viaja la información, garantiza su calidad y la pone a disposición de quienes la necesitan, sin que tú tengas que preocuparte por los detalles técnicos que hay detrás. Sin su trabajo, los análisis perderían fiabilidad y las decisiones basadas en datos perderían su base.
Si te estás planteando orientar tu carrera hacia este campo, ya sabes por dónde empezar: Python, SQL, herramientas de orquestación como Airflow y una plataforma cloud son los pilares sobre los que construir tu perfil. El camino combina formación técnica con práctica real, y cada proyecto que completes te acerca más a un rol que hoy ocupa una posición central en casi cualquier organización orientada a datos.
Hay mucho más por explorar dentro de este campo: arquitecturas de datos, herramientas emergentes, perfiles afines y tendencias que están redefiniendo cómo las organizaciones gestionan su información. En este sitio web encontrarás más contenidos que te ayudarán a seguir avanzando a tu propio ritmo.
Sigue aprendiendo:
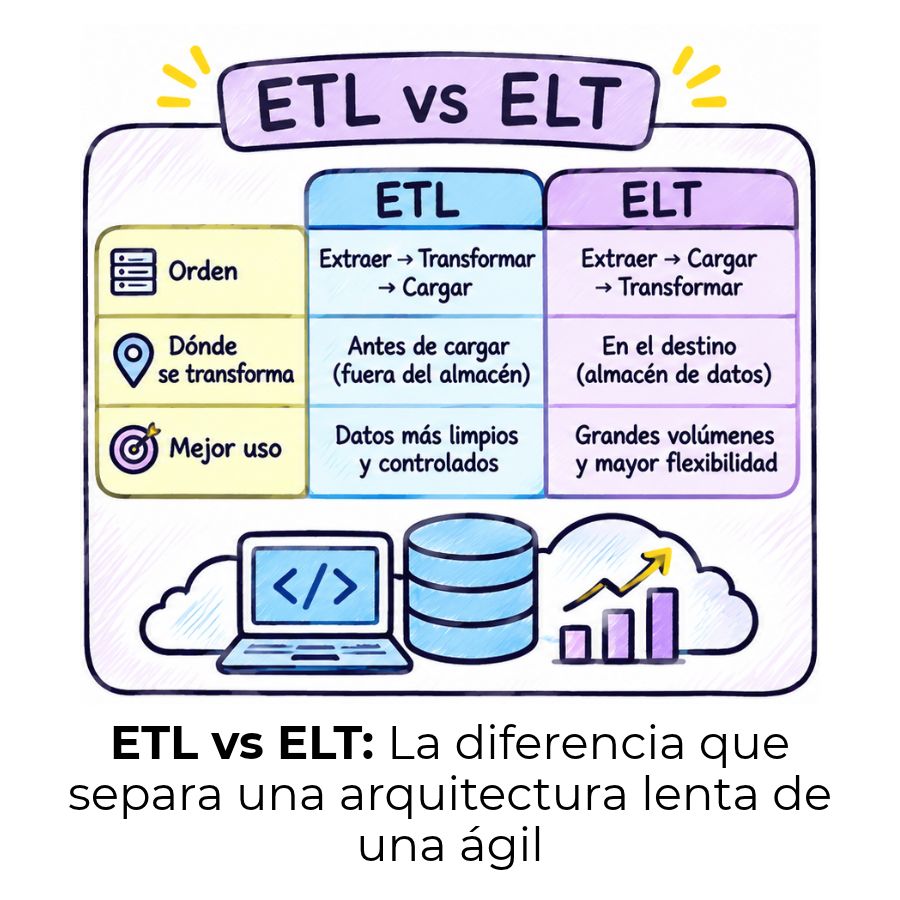
ETL vs. ELT: Transforma tus datos con la estrategia correcta
Azure Data Factory (ADF): El servicio que mueve tus datos en la nube ☁️
Herramientas ETL: Elige la correcta y ahorra horas de trabajo
Gobierno de datos: Controla tu información y toma mejores decisiones 📊
Apache Spark: El motor de datos que no conocías
AWS Glue: El secreto detrás de los grandes pipelines de datos
Data Mesh: La arquitectura que descentraliza datos
Catálogo de datos: El mapa que nadie te enseñó a leer
