
Antes de que cualquier herramienta procese un solo dato, alguien tuvo que recogerlo, trasladarlo y dejarlo listo para usarse. Ese trabajo tiene nombre: ingesta de datos. Es el punto de partida de cualquier proyecto de ingeniería de datos y, aunque casi nunca aparece en los titulares, todo lo demás depende de que esté bien hecho.
¿Qué es la ingesta de datos?
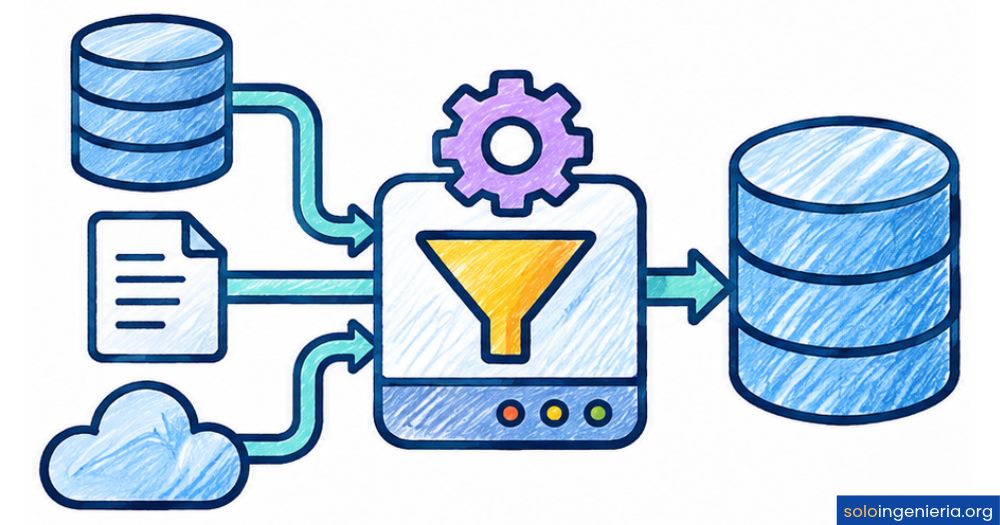
La ingesta de datos es el proceso de recopilar información desde distintas fuentes externas y transferirla a un sistema centralizado donde puede almacenarse, procesarse y analizarse. No se trata simplemente de mover archivos de un lado a otro: es la primera capa funcional de cualquier arquitectura de datos moderna y la que determina qué información estará disponible para todo lo que venga después.
En términos prácticos, cuando una empresa recibe datos de una base de datos relacional, una API externa, un sensor IoT o un archivo CSV, necesita un mecanismo que los recoja, los valide mínimamente y los deposite en un repositorio común. Ese mecanismo es precisamente la ingesta de datos, y sin él, cada equipo trabajaría con su propia isla de información sin posibilidad de cruzarla o analizarla de forma conjunta.
Su papel dentro de la arquitectura de datos
Dentro de cualquier arquitectura de datos por capas, la ingesta ocupa siempre el primer nivel: es el punto de entrada por donde llega toda la información antes de ser procesada, transformada o analizada. Si esta capa falla o está mal diseñada, los errores se propagan hacia arriba y contaminan cada análisis posterior. No hay forma de compensar una mala ingesta con una buena transformación.
Esto también significa que las decisiones tomadas en la capa de ingesta condicionan directamente el resto del sistema. Si decides qué fuentes incluir, con qué frecuencia recoger los datos y en qué formato recibirlos, estás definiendo los límites de lo que tu plataforma de datos podrá responder. Por eso los equipos de ingeniería de datos dedican tanto tiempo a diseñar bien esta capa desde el principio.
¿Cómo funciona el proceso de ingesta de datos?
El proceso de ingesta de datos no se reduce a un solo movimiento. Detrás de cada transferencia existe una secuencia de pasos que garantizan que los datos lleguen al destino de forma ordenada, completa y utilizable. Entender esa secuencia te ayuda a anticipar dónde pueden aparecer problemas y cómo prevenirlos antes de que afecten al análisis.
Etapas principales de la ingesta
Aunque el proceso varía según la herramienta y el caso de uso, la mayoría de las implementaciones siguen una secuencia reconocible que arranca en la fuente y termina en el repositorio de destino. Conocer estas etapas te da una base sólida para entender cualquier arquitectura de ingesta, independientemente de su complejidad técnica.
Recopilación de datos
El sistema accede a las fuentes definidas (bases de datos, APIs, archivos, sensores) y extrae la información disponible. Esta etapa puede ejecutarse de forma programada o de manera continua, según el tipo de ingesta elegida.
Validación y detección de errores
Antes de continuar, el sistema verifica que los datos recibidos cumplen con el formato esperado y detecta valores duplicados, nulos o inconsistentes. No es una transformación profunda, pero sí un filtro básico de calidad que evita corromper el repositorio.
Transferencia al repositorio
Los datos validados se trasladan al sistema de destino: un data lake, un data warehouse o un lakehouse. Esta transferencia puede incluir alguna conversión de formato mínima para garantizar la compatibilidad con el repositorio receptor.
Monitorización y registro
Una vez completada la transferencia, el sistema registra métricas del proceso: volumen de datos recibidos, errores detectados, tiempo de ejecución y estado de cada fuente. Este registro es el que permite detectar fallos antes de que afecten al análisis.
Fuentes de datos más habituales
Las fuentes que alimentan un proceso de ingesta pueden ser muy diversas, y esa variedad es precisamente uno de los retos más comunes al diseñar esta capa. Cada fuente tiene su propio formato, frecuencia de actualización y protocolo de acceso, lo que obliga al sistema de ingesta a ser suficientemente flexible para gestionarlas todas sin perder coherencia.
- Bases de datos relacionales: Son las fuentes más comunes en entornos empresariales. Se accede a ellas mediante consultas SQL y los datos suelen estar bien estructurados, aunque pueden contener inconsistencias históricas.
- APIs externas: Permiten recibir datos de servicios de terceros como plataformas de marketing, redes sociales o sistemas de pago. Su acceso depende de autenticación y límites de llamadas por intervalo de tiempo.
- Archivos planos: Formatos como CSV, JSON, XML o Parquet son habituales cuando los datos provienen de sistemas legacy o de intercambios manuales entre organizaciones.
- Sensores e IoT: Generan flujos de datos continuos a alta velocidad. Son la principal razón por la que la ingesta en tiempo real existe como modalidad especializada.
- Logs del sistema: Registros de aplicaciones, servidores o plataformas web que contienen información operacional valiosa para análisis de comportamiento y detección de errores.
- Aplicaciones SaaS: Herramientas como CRMs, ERPs o plataformas de analítica web que exponen sus datos a través de conectores nativos o APIs propias.
Tipos de ingesta de datos
No existe una única forma de hacer ingesta de datos. La elección del tipo correcto depende de cuánta latencia tolera tu caso de uso, del volumen de datos que manejas y del coste computacional que puedes asumir. Elegir mal en este punto tiene consecuencias directas sobre la calidad del análisis y la eficiencia del sistema completo.
Ingesta por lotes (batch)
La ingesta por lotes recoge datos de forma periódica: cada hora, cada noche o una vez a la semana, según lo que necesite el proyecto. Es la opción más rentable para manejar grandes volúmenes de datos cuando no importa tener la información al instante. Un informe financiero mensual o una carga de datos históricos son casos donde el batch encaja perfectamente sin añadir complejidad innecesaria al sistema.
Su principal limitación es la latencia: los datos no están disponibles hasta que el lote se procesa por completo. Esto significa que, entre una ejecución y la siguiente, el sistema trabaja con información que puede estar desactualizada. Para casos de uso donde esa demora es aceptable, el batch sigue siendo la alternativa más sencilla de implementar y mantener en el tiempo.
Ingesta en tiempo real (streaming)
La ingesta en tiempo real procesa cada dato en el momento exacto en que llega al sistema, sin esperar a que se acumule un volumen determinado. La latencia se reduce a milisegundos, lo que la convierte en la única opción viable para casos donde la velocidad de respuesta es crítica: detección de fraude, monitorización de infraestructura o análisis de comportamiento en aplicaciones con miles de usuarios activos.
El precio a pagar por esa inmediatez es una mayor exigencia técnica y un coste computacional más elevado. Mantener un flujo de ingesta continua requiere infraestructura preparada para absorber picos de datos sin perder registros, y herramientas especializadas como Apache Kafka o AWS Kinesis que gestionen esa corriente sin interrupciones.
Ingesta híbrida
La ingesta híbrida, también conocida como arquitectura Lambda, combina los dos enfoques anteriores. Un canal de streaming gestiona los datos más recientes con baja latencia, mientras que un canal batch consolida y recalcula los datos históricos con mayor precisión. El resultado es un sistema capaz de responder preguntas en tiempo real sin sacrificar la exactitud de los datos acumulados a lo largo del tiempo.
La contrapartida es la complejidad añadida: hay que mantener dos pipelines activos, sincronizarlos y garantizar que las respuestas de ambos canales sean coherentes. Por eso esta arquitectura se recomienda cuando los requisitos del proyecto realmente la justifican y el equipo tiene capacidad técnica para gestionarla sin que se convierta en una carga operativa.
Ingesta de datos vs. ETL: ¿en qué se diferencian?
Es habitual confundir la ingesta de datos con el proceso ETL (Extract, Transform, Load), y la confusión tiene sentido porque ambos conceptos comparten parte del camino. Sin embargo, se refieren a etapas distintas dentro de un flujo de datos y tienen objetivos diferentes que vale la pena entender por separado antes de diseñar cualquier arquitectura.
La ingesta de datos recoge la información y la lleva a un repositorio central. El ETL la extrae, la transforma según reglas de negocio y la carga ya preparada para el análisis. Son pasos complementarios, no sinónimos.
| Característica | Ingesta de datos | ETL |
|---|---|---|
| Objetivo principal | Recopilar y trasladar datos al repositorio | Extraer, transformar y cargar datos listos para análisis |
| Transformación | Mínima o ninguna | Profunda, con reglas de negocio definidas |
| Momento en el flujo | Primera capa del pipeline | Después de la ingesta, antes del análisis |
| Datos de entrada | En bruto, desde múltiples fuentes | Ya almacenados, generalmente en el repositorio |
| Herramientas típicas | Fivetran, Airbyte, Apache Kafka | DBT, Talend, Apache Spark |
| Latencia típica | Variable (batch o streaming) | Generalmente mayor, por la complejidad de transformación |
En la práctica, la ingesta y el ETL trabajan en tándem dentro de un pipeline de datos. La ingesta se encarga de que los datos lleguen; el ETL se encarga de que esos datos tengan la forma y la calidad necesarias para ser útiles. Saltarse la ingesta correctamente diseñada hace que el ETL reciba datos inconsistentes, y el problema se amplifica cuanto más compleja es la transformación posterior.
Herramientas de ingesta de datos más utilizadas
El mercado ofrece un amplio catálogo de herramientas para gestionar la ingesta de datos, desde soluciones de código abierto hasta plataformas gestionadas en la nube. La elección depende del tipo de ingesta que necesitas, del volumen de datos, del presupuesto disponible y de si tu equipo prefiere configurar infraestructura propia o delegar esa responsabilidad en un servicio externo.
Apache Kafka es la referencia en ingesta en tiempo real para grandes volúmenes de eventos, especialmente en entornos donde el orden y la tolerancia a fallos son críticos. Fivetran y Airbyte destacan en escenarios de ingesta batch con múltiples fuentes, porque ofrecen cientos de conectores preconstruidos que eliminan buena parte del trabajo de integración manual. Para proyectos donde la transformación posterior usa DBT, la combinación con Fivetran o Airbyte es especialmente natural dentro del stack ELT moderno.
Las soluciones nativas de los proveedores cloud, como AWS Glue, Google Dataflow o Azure Data Factory, son una buena opción cuando todo el stack ya vive en un único proveedor y se prefiere minimizar la gestión de infraestructura propia. Ofrecen integración directa con los servicios de almacenamiento y procesamiento de cada plataforma, reduciendo la fricción entre capas.
Buenas prácticas para una ingesta de datos eficiente
Diseñar un proceso de ingesta que funcione bien desde el principio ahorra una cantidad enorme de trabajo correctivo más adelante. Los problemas que no se atajan en esta capa tienden a multiplicarse a medida que los datos avanzan por el sistema. Aplicar estas prácticas desde el inicio marca la diferencia entre una arquitectura sólida y una que requiere mantenimiento constante.
- Define el esquema de datos antes de ingestar: Conocer la estructura esperada de cada fuente permite detectar anomalías desde el primer registro y evitar que datos malformados lleguen al repositorio sin control.
- Implementa validaciones en la capa de entrada: Comprueba valores nulos, tipos de datos incorrectos y duplicados antes de que los datos sean almacenados. Cuanto antes se detecten los errores, menos costoso es corregirlos.
- Prioriza la ingesta incremental sobre la completa: Recoger solo los datos nuevos o modificados desde la última ejecución reduce drásticamente el tiempo de procesamiento y el consumo de recursos, especialmente en fuentes que crecen continuamente.
- Registra métricas de cada ejecución: Volumen procesado, errores detectados, duración y estado de cada fuente deben quedar registrados. Sin esa trazabilidad, detectar un fallo silencioso puede tardar días o semanas.
- Diseña el proceso para fallos parciales: Si una fuente falla durante una ejecución, el sistema debe ser capaz de reintentar solo esa fuente sin afectar al resto. Los fallos en cascada son uno de los problemas más frecuentes en pipelines mal diseñados.
- Documenta cada fuente y su frecuencia de actualización: Saber con qué periodicidad se actualiza cada fuente te permite calibrar cuándo tiene sentido ejecutar la ingesta y evitar recoger datos que no han cambiado.
Preguntas frecuentes
¿Qué diferencia hay entre ingesta de datos e integración de datos?
La ingesta de datos se centra en recoger información desde múltiples fuentes y depositarla en un repositorio centralizado, con una transformación mínima o inexistente. La integración de datos, en cambio, ocurre después: aplica transformaciones más profundas, unifica criterios de negocio y prepara los datos para que sean comparables y analizables. Se puede decir que la ingesta lleva los datos hasta la puerta del sistema, y la integración los ordena dentro de casa.
¿Cuándo conviene usar ingesta en tiempo real y cuándo por lotes?
La ingesta en tiempo real es la opción correcta cuando la demora en recibir los datos tiene un impacto directo en el negocio: detección de fraude, alertas críticas, monitorización de sistemas o personalización instantánea de aplicaciones. La ingesta por lotes conviene cuando la información puede esperarse unas horas sin consecuencias, como en informes periódicos, cargas de datos históricos o sincronizaciones nocturnas entre sistemas. La regla práctica es: si los datos pierden valor rápidamente, opta por streaming; si no, el batch es suficiente y más económico.
¿Qué herramientas se usan para la ingesta de datos en la nube?
Los tres grandes proveedores cloud ofrecen sus propias soluciones de ingesta: AWS Glue y AWS Kinesis para Amazon Web Services, Google Cloud Dataflow y Pub/Sub para Google Cloud, y Azure Data Factory con Event Hubs para Microsoft Azure. Además, herramientas independientes como Fivetran, Airbyte y Apache Kafka se integran con cualquiera de estas plataformas y son ampliamente utilizadas en stacks multicloud o cuando se prefiere una solución neutral respecto al proveedor.
¿Cómo se relaciona la ingesta de datos con un pipeline de datos?
La ingesta de datos es el primer eslabón de cualquier pipeline de datos: sin ella, no hay información disponible para el resto del flujo. El pipeline orquesta toda la secuencia, desde la ingesta inicial hasta la transformación, almacenamiento y consumo de los datos, pero su punto de partida siempre es la capa de ingesta. Si la ingesta falla o entrega datos de baja calidad, los eslabones posteriores del pipeline heredan esos problemas sin poder resolverlos por sí solos.
¿Qué tipos de fuentes de datos pueden alimentar un proceso de ingesta?
Las fuentes más habituales son bases de datos relacionales y NoSQL, APIs REST o GraphQL de servicios externos, archivos en formatos estructurados como CSV, JSON o Parquet, sensores y dispositivos IoT que generan flujos de datos continuos, logs de aplicaciones y servidores, y herramientas SaaS como CRMs, plataformas de e-commerce o herramientas de marketing. La diversidad de fuentes es precisamente uno de los retos que hace que la ingesta de datos sea una capa compleja de diseñar bien desde el inicio.
¿Cuáles son los errores más comunes en un proceso de ingesta de datos?
Los errores más frecuentes incluyen no validar los datos al recibirlos, lo que permite que registros corruptos o duplicados lleguen al repositorio; no gestionar correctamente los fallos de fuentes individuales, lo que puede bloquear toda la ejecución; hacer ingestas completas cuando debería usarse la incremental, desperdiciando recursos; no registrar métricas del proceso, lo que dificulta detectar problemas silenciosos; y no documentar el esquema esperado de cada fuente, generando confusión cuando los datos cambian de estructura sin previo aviso.
¿Qué es el Change Data Capture (CDC) en la ingesta de datos?
El Change Data Capture, o CDC, es una técnica de ingesta incremental que monitoriza los registros de transacciones de una base de datos para detectar únicamente las filas que han sido insertadas, modificadas o eliminadas desde la última ejecución. En lugar de leer toda la tabla cada vez, el CDC extrae solo los cambios, lo que reduce drásticamente el volumen de datos transferidos y la carga sobre la fuente. Es especialmente útil cuando se trabaja con bases de datos grandes que se actualizan con frecuencia y no se puede permitir una ingesta completa periódica.
Conclusión
La ingesta de datos no es un detalle técnico menor: es el punto de partida de todo lo que haces con los datos. Sin una capa de ingesta bien diseñada, cualquier análisis, modelo o dashboard que construyas estará sobre una base frágil. Entender cómo funciona, qué tipos existen y qué herramientas tienes disponibles te da una ventaja real a la hora de trabajar en proyectos de datos con criterio propio.
A lo largo de este artículo has visto que la elección entre batch, streaming o híbrida no es arbitraria, sino que depende de la latencia que toleras, del volumen que manejas y de los recursos con los que cuentas. También has aprendido que la ingesta no sustituye al ETL, sino que lo precede, y que aplicar validaciones desde el primer momento evita problemas que luego son difíciles de rastrear. Puedes usar todo esto como referencia cuando empieces a diseñar tus propios flujos de datos.
Si este tema te ha resultado útil y quieres seguir profundizando en la ingeniería de datos, en este sitio web encontrarás más contenido sobre los distintos componentes que forman una arquitectura de datos moderna. Cada concepto que domines te acerca a construir sistemas de datos más sólidos, eficientes y escalables.
Sigue aprendiendo:
AWS Glue: El secreto detrás de los grandes pipelines de datos
ETL con Python: Extrae, transforma y carga datos
¿En qué consiste la ingeniería de base de datos?
Calidad de datos: El secreto que separa buenos de malos análisis
¿Qué es PySpark y para qué sirve?
¿Qué es un data warehouse y para qué sirve?
Data Mesh: La arquitectura que descentraliza datos
Herramientas ETL: Elige la correcta y ahorra horas de trabajo
