
Detrás de cada dashboard que se actualiza solo, de cada reporte que llega a tiempo y de cada decisión que se toma con datos reales, hay un mecanismo trabajando sin descanso. No es magia ni automatización genérica: es un pipeline de datos. Y entender cómo funciona cambia por completo la forma en que ves el mundo de los datos.
¿Qué es un pipeline de datos?
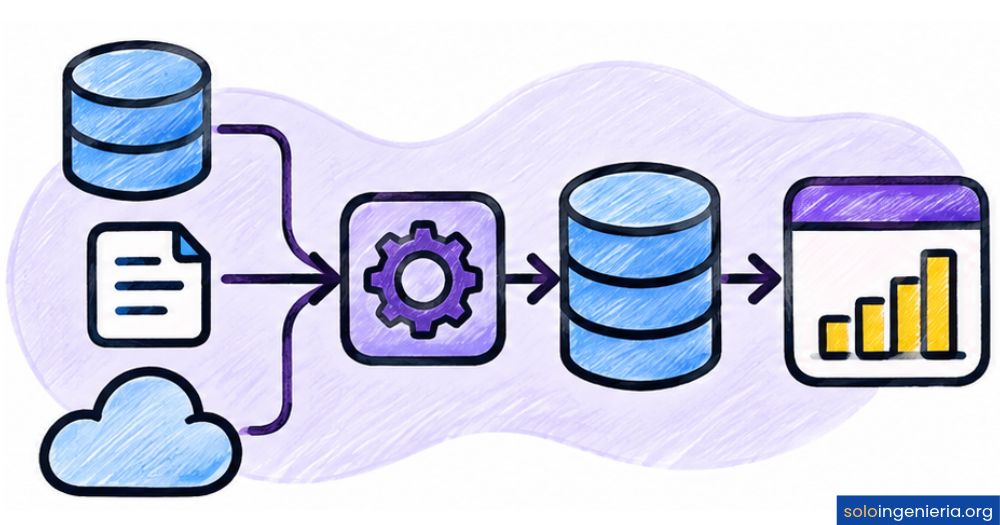
Un pipeline de datos es un sistema automatizado de etapas interconectadas que mueve información desde su origen hasta su destino final, transformándola en el camino. Cada etapa recibe los datos de la anterior, los procesa de alguna forma y los pasa a la siguiente, creando un flujo continuo y ordenado. La palabra «pipeline» viene del inglés y significa literalmente «tubería»: una metáfora directa de cómo la información viaja de un punto a otro sin interrupciones.
En el campo de la ingeniería de datos, este concepto es central. Un pipeline no solo mueve datos: los extrae de múltiples fuentes, los limpia, los estructura y los deposita donde serán útiles, ya sea en un sistema de análisis, en un modelo de machine learning o en una herramienta de visualización. Todo esto ocurre de forma automática, sin que nadie tenga que ejecutar el proceso a mano cada vez.
Origen del término y por qué se usa en ingeniería
El término «pipeline» se tomó prestado de la industria del petróleo, donde una tubería transporta crudo desde los pozos hasta las refinerías. En ingeniería de software, la idea es la misma: datos que fluyen de un extremo a otro a través de etapas especializadas. Cada etapa hace una parte del trabajo y pasa el resultado a la siguiente, igual que una cadena de montaje. No es casual que este concepto haya enraizado con tanta fuerza: describe con precisión lo que ocurre.
La adopción masiva del término en ingeniería de datos ocurrió a medida que las organizaciones empezaron a manejar volúmenes de información que ya no podían gestionarse a mano. Automatizar el recorrido de los datos se volvió una necesidad operativa, no un lujo tecnológico. Hoy, cualquier equipo que trabaje con datos con regularidad depende de uno o varios pipelines para mantener su información actualizada y fiable.
Diferencia entre pipeline de datos y ETL
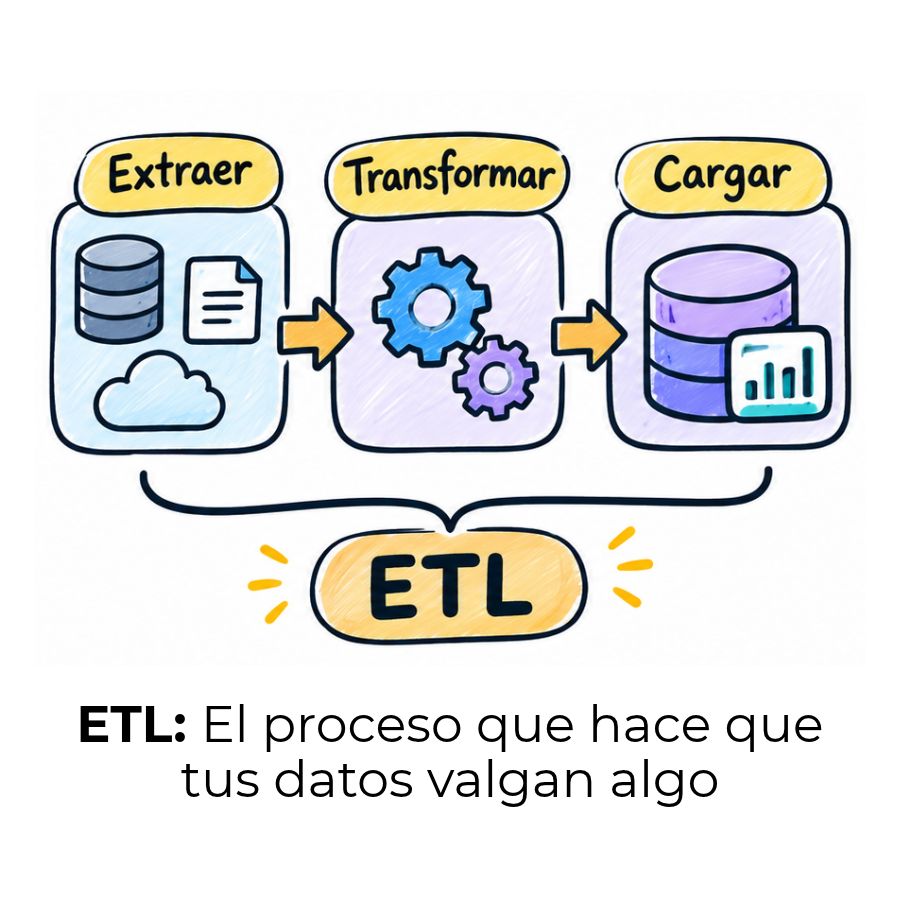
ETL (del inglés Extract, Transform, Load) es uno de los tipos más conocidos de pipeline de datos, pero no son sinónimos. El pipeline de datos es el concepto general; el ETL es un caso particular dentro de ese concepto. Un ETL sigue siempre ese orden concreto: extrae, transforma y luego carga. Un pipeline puede seguir ese mismo orden, o puede invertirlo (como en el ELT), o puede limitarse a mover datos sin transformarlos, o puede procesar eventos en tiempo real.
¿Cómo funciona un pipeline de datos?
El funcionamiento de un pipeline de datos sigue una secuencia ordenada donde cada etapa depende de que la anterior haya concluido correctamente. Si una falla, el pipeline puede detenerse, enviar una alerta o reintentar el proceso, dependiendo de cómo esté configurado. Esta capacidad de respuesta ante errores es una de las características que lo distingue de un simple script ejecutado manualmente.
Ingesta: el punto de entrada de los datos
La ingesta es la primera etapa del pipeline y su función es simple pero crítica: conectarse a todas las fuentes de datos definidas y extraer la información disponible. Esas fuentes pueden ser una base de datos relacional, una API de un proveedor externo, un archivo que llega por correo electrónico o los registros de eventos de una aplicación. El pipeline sabe a dónde conectarse, con qué frecuencia y cómo autenticarse.
Lo que diferencia la ingesta dentro de un pipeline de una extracción manual es la automatización y la escala. Un pipeline puede conectarse simultáneamente a cientos de fuentes diferentes y recoger datos de todas ellas sin intervención humana. Además, gestiona los errores de conexión, los reintentos y los registros de lo que se extrajo y cuándo, dejando un historial auditable de cada ejecución.
Transformación: limpiar y dar forma a los datos
Los datos que llegan de las fuentes rara vez están listos para usarse directamente. Pueden contener valores nulos, formatos inconsistentes, registros duplicados o campos con nombres distintos en cada fuente. La etapa de transformación se ocupa de limpiar, normalizar, enriquecer y estructurar los datos para que sean coherentes y útiles al llegar a su destino.
En esta fase también pueden ocurrir operaciones más complejas, como combinar datos de dos fuentes distintas, calcular métricas derivadas o aplicar reglas de negocio específicas. La calidad del análisis final depende casi por completo de lo que ocurra en esta etapa. Si los datos llegan sucios al destino, los reportes y modelos que los usen arrojarán resultados poco fiables.
Carga: llevar los datos a su destino final
Una vez transformados, los datos se escriben en el sistema de destino. Ese destino puede ser un data warehouse, un data lake, una base de datos analítica, una herramienta de visualización o incluso la entrada de un modelo de machine learning. La carga puede realizarse de forma completa (reemplazando todos los datos) o incremental (añadiendo solo los registros nuevos o modificados).
La carga incremental es la estrategia más habitual en entornos de producción porque resulta más eficiente: no tiene sentido reprocesar millones de registros históricos cuando solo han cambiado unos pocos miles. Un pipeline bien configurado identifica qué datos son nuevos o han cambiado desde la última ejecución y carga únicamente esos, reduciendo el tiempo de procesamiento y el consumo de recursos.
Componentes de un pipeline de datos
Un pipeline de datos no es una pieza única de software: es un conjunto de componentes que trabajan de forma coordinada. Conocer cada componente ayuda a entender dónde puede aparecer un problema y quién es responsable de cada parte del flujo. Aunque el diseño varía según el caso de uso, hay componentes que aparecen prácticamente en todos los pipelines modernos.
- Conector de fuente: El módulo que se conecta al sistema original para leer los datos. Puede ser un conector nativo, un adaptador de API o un lector de archivos.
- Motor de transformación: El componente que aplica las reglas de limpieza, normalización y enriquecimiento sobre los datos extraídos antes de enviarlos al destino.
- Orquestador: El sistema que coordina cuándo y en qué orden se ejecuta cada etapa del pipeline. También gestiona reintentos y dependencias entre tareas.
- Almacenamiento intermedio: Una zona temporal donde los datos se guardan entre etapas, útil cuando las fases tienen velocidades de procesamiento distintas o cuando se requiere tolerancia a fallos.
- Sistema de monitoreo: El componente que registra métricas de cada ejecución, detecta anomalías y lanza alertas cuando algo falla o cuando la calidad de los datos cae por debajo de un umbral.
- Conector de destino: El módulo que escribe los datos transformados en el sistema final, ya sea un warehouse, un data lake, una base de datos analítica o una herramienta de visualización.
Tipos de pipeline de datos
No existe un único modelo de pipeline válido para todas las situaciones. El tipo que se elige depende principalmente de la velocidad a la que necesitas que los datos estén disponibles y del volumen de información que el sistema debe procesar. Entender las diferencias entre los tipos principales te permitirá identificar cuál encaja mejor con un caso de uso concreto.
Pipeline por lotes (batch)
El pipeline batch procesa los datos en grupos, también llamados lotes, según un calendario definido. Por ejemplo, cada hora, una vez al día o cada semana. Acumula los datos durante un período y los procesa todos juntos en el momento programado. Es el tipo más antiguo y sigue siendo uno de los más usados porque resulta sencillo de construir, gestionar y depurar cuando algo falla.
El procesamiento por lotes es ideal cuando los datos no necesitan estar disponibles al instante. Un informe de ventas del día anterior, una consolidación de registros contables o la actualización nocturna de un catálogo de productos son casos donde el pipeline batch ofrece eficiencia sin la complejidad adicional del tiempo real.
Pipeline en tiempo real (streaming)
El pipeline de streaming procesa cada dato en cuanto llega, sin esperar a que se acumule un lote. La latencia entre la generación del dato y su disponibilidad para el análisis puede medirse en milisegundos o segundos. Esto lo hace indispensable en casos donde la respuesta inmediata importa, como la detección de fraudes en transacciones bancarias, el monitoreo de sistemas o los motores de recomendación.
El streaming requiere una infraestructura más sofisticada que el batch y es más difícil de depurar cuando algo falla. Por eso conviene evaluarlo con cuidado: no todo problema necesita una solución en tiempo real, y añadir esa complejidad sin justificación técnica solo encarece y complica el sistema innecesariamente.
Pipeline ETL y pipeline ELT
ETL y ELT representan dos filosofías distintas sobre cuándo transformar los datos dentro del pipeline. En el modelo ETL (Extract, Transform, Load), los datos se transforman antes de llegar al destino, lo que significa que el sistema de destino recibe información ya limpia y estructurada. Este enfoque funcionó muy bien durante décadas en entornos con almacenes de datos tradicionales y capacidad de procesamiento limitada en destino.
El modelo ELT (Extract, Load, Transform) invierte el orden: primero carga los datos crudos en el destino y luego aplica las transformaciones allí mismo, aprovechando la potencia de cómputo de plataformas modernas en la nube. Con herramientas como Apache Spark o BigQuery, transformar directamente en el destino se volvió no solo viable, sino en muchos casos más rápido y flexible que el ETL clásico.
¿Para qué sirve un pipeline de datos en la práctica?
En términos prácticos, un pipeline de datos resuelve un problema real que tiene cualquier organización que trabaja con información: los datos viven dispersos en múltiples sistemas que no se hablan entre sí. Una empresa puede tener su información de ventas en un CRM, su inventario en un ERP, sus métricas web en Google Analytics y sus datos de logística en una plataforma externa. Sin un pipeline, alguien tiene que extraer todo eso a mano y unirlo.
Con un pipeline correctamente implementado, todo ese trabajo de integración ocurre de forma automática y recurrente. Los equipos de análisis reciben datos actualizados, limpios y coherentes sin tener que solicitarlos ni prepararlos. Eso les libera tiempo para enfocarse en interpretar la información y tomar decisiones, que es precisamente la parte de mayor valor en cualquier organización.
Herramientas más usadas para construir pipelines de datos
El ecosistema de herramientas para construir pipelines de datos ha crecido enormemente en los últimos años. Existen opciones para cada escala, cada presupuesto y cada nivel de madurez técnica. Elegir la herramienta correcta depende principalmente del volumen de datos, la frecuencia de procesamiento y si el equipo prefiere código o interfaces visuales.
Buenas prácticas al diseñar un pipeline de datos
Un pipeline que funciona hoy pero que colapsa cuando el volumen de datos se triplica no es un buen pipeline. El diseño desde el principio con criterios de calidad, escalabilidad y mantenibilidad marca la diferencia entre un sistema que aguanta años en producción y uno que genera problemas cada semana. Estas son las prácticas que separan un pipeline sólido de uno frágil.
- Idempotencia: Si el pipeline se ejecuta dos veces con los mismos datos de entrada, el resultado debe ser idéntico. Esto protege contra duplicados en caso de reintentos por error.
- Validación de datos en cada etapa: Comprobar que los datos cumplen las reglas esperadas (tipos, rangos, campos obligatorios) antes de pasarlos a la siguiente etapa evita que los errores se propaguen silenciosamente.
- Observabilidad: El pipeline debe registrar métricas de cada ejecución (duración, registros procesados, errores encontrados) para que el equipo sepa exactamente qué ocurrió y cuándo.
- Separación de responsabilidades: Cada etapa debe hacer una sola cosa y hacerla bien. Un pipeline monolítico donde todo ocurre en un único script es difícil de depurar, mantener y escalar.
- Gestión de errores explícita: Define qué debe ocurrir cuando una etapa falla: ¿se reintenta automáticamente?, ¿se envía una alerta?, ¿el pipeline se detiene o continúa con los registros válidos?
- Control de versiones del código: El código del pipeline debe vivir en un repositorio con historial de cambios, igual que cualquier otro software. Esto permite revertir cambios problemáticos y auditar quién modificó qué.
- Pruebas antes de producción: Validar el pipeline con un subconjunto de datos reales en un entorno de prueba antes de desplegarlo en producción reduce significativamente el riesgo de incidentes.
Preguntas frecuentes
¿Qué diferencia hay entre un pipeline de datos y un ETL?
Un pipeline de datos es el concepto más amplio: engloba cualquier sistema automatizado que mueve y transforma datos de un origen a un destino. El ETL es un tipo específico de pipeline que sigue un orden concreto: primero extrae, luego transforma y finalmente carga. Existen pipelines que no transforman los datos antes de cargarlos (ELT), pipelines de streaming que procesan eventos en tiempo real y pipelines diseñados exclusivamente para alimentar modelos de machine learning. Todos son pipelines, pero no todos son ETL.
¿Qué lenguajes de programación se usan para crear pipelines de datos?
Python es el lenguaje más usado en la construcción de pipelines de datos, principalmente porque cuenta con librerías muy maduras para este propósito, como Pandas, PySpark o el SDK de Apache Beam. SQL también tiene un rol central, especialmente en la etapa de transformación cuando se trabaja con herramientas como dbt. Scala es habitual en entornos con Apache Spark de alto rendimiento. En plataformas cloud gestionadas, muchas tareas pueden configurarse sin escribir código, aunque conocer los fundamentos de programación siempre aporta mayor control sobre el comportamiento del pipeline.
¿Qué es la orquestación en un pipeline de datos?
La orquestación es el mecanismo que coordina cuándo y en qué orden se ejecutan las distintas tareas que forman un pipeline. Un orquestador sabe que la tarea B no puede empezar hasta que la tarea A haya terminado correctamente, que si una tarea falla, debe reintentarse un número determinado de veces y que si el reintento también falla, debe enviar una alerta al equipo responsable. Apache Airflow es el orquestador de pipelines de datos más extendido en la industria y representa bien este concepto con su sistema de grafos acíclicos dirigidos (DAG).
¿Cuándo conviene usar un pipeline batch y cuándo uno en tiempo real?
La respuesta depende de cuánto puede tardar el dato en estar disponible para quien lo necesita. Si un retraso de horas o incluso de un día es aceptable para el caso de uso, un pipeline batch es suficiente y mucho más sencillo de mantener. Si la decisión que depende del dato debe tomarse en segundos, como bloquear una transacción sospechosa o actualizar el precio de un producto en función de la demanda, entonces el streaming es la opción necesaria. La complejidad adicional del tiempo real solo se justifica cuando el negocio realmente requiere esa latencia baja.
¿Qué es Apache Airflow y para qué sirve en un pipeline?
Apache Airflow es una plataforma de código abierto diseñada para definir, programar y monitorear flujos de trabajo complejos. En el contexto de los pipelines de datos, permite describir mediante código Python todas las tareas que componen el pipeline y las dependencias entre ellas, formando lo que se conoce como un DAG (grafo acíclico dirigido). Airflow se encarga de ejecutar cada tarea en el momento adecuado, registrar el resultado de cada ejecución y ofrecer una interfaz visual donde puedes ver el estado de cada tarea en tiempo real. Es una de las herramientas más adoptadas en equipos de ingeniería de datos de todo el mundo y cuenta con el respaldo de la Apache Software Foundation.
¿Qué rol tiene el ingeniero de datos en un pipeline?
El ingeniero de datos es el profesional responsable de diseñar, construir, mantener y mejorar los pipelines de datos de una organización. Su trabajo implica decidir qué arquitectura usar, escribir el código de cada etapa, configurar el sistema de orquestación, establecer las alertas de monitoreo y garantizar que los datos lleguen al destino con la calidad y la frecuencia esperadas. También colabora con los analistas de datos y los científicos de datos para entender qué información necesitan y en qué formato, y adapta el pipeline en consecuencia cuando los requisitos cambian.
¿Un pipeline de datos y un data warehouse son lo mismo?
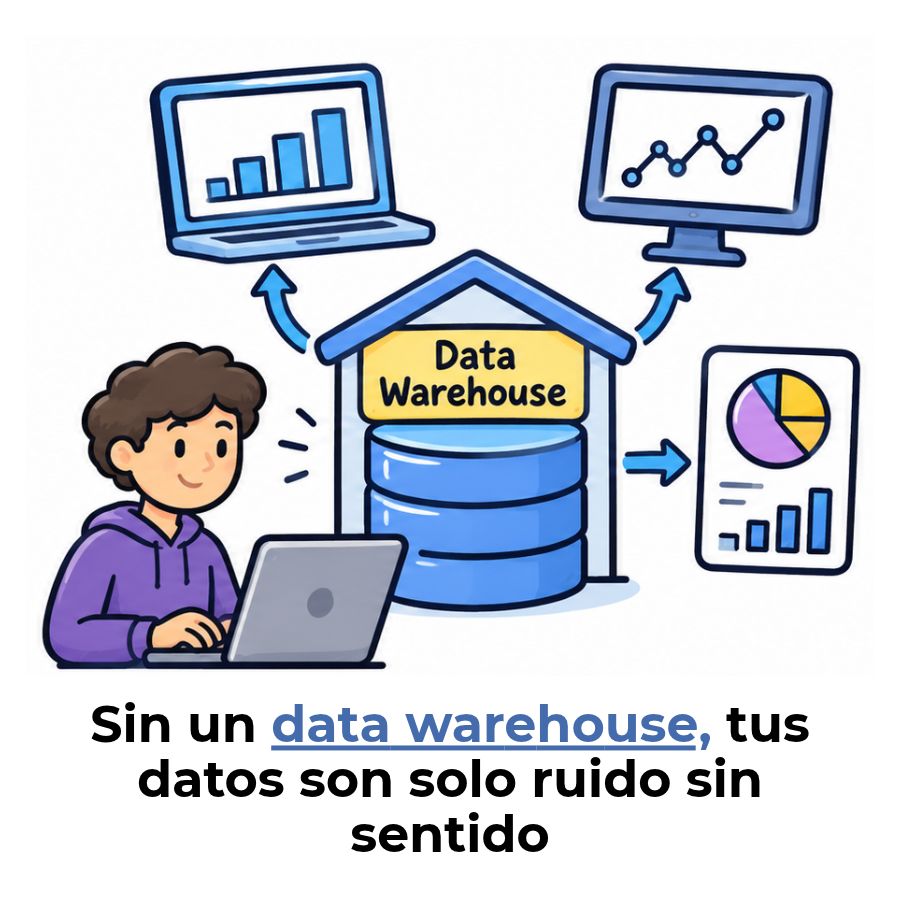
No, son conceptos complementarios pero distintos. Un pipeline de datos es el proceso que mueve y transforma la información. Un data warehouse es el destino donde esa información se almacena de forma estructurada para su análisis. Podría decirse que el pipeline es el sistema de transporte y el data warehouse es el almacén al que llegan los datos. Sin un pipeline que los alimente de forma continua y limpia, el data warehouse solo contiene información estática y desactualizada. Ambos forman parte de la misma arquitectura de datos, pero cumplen funciones completamente diferentes.
Conclusión
Un pipeline de datos es el sistema que hace posible que la información pase de estar dispersa en múltiples fuentes a estar disponible, limpia y estructurada donde alguien puede analizarla y actuar sobre ella. No es un concepto abstracto: es la infraestructura real que sostiene cualquier proyecto serio de análisis de datos, inteligencia de negocio o machine learning.
Ahora que conoces sus etapas, sus tipos y los componentes que lo forman, puedes identificar con más claridad qué tipo de pipeline necesita un caso de uso concreto, qué herramientas encajan mejor y qué prácticas conviene aplicar desde el primer día. Ese conocimiento marca la diferencia entre construir algo que funcione una vez y algo que aguante en producción durante años.
Si este tema te ha resultado útil y quieres seguir profundizando en ingeniería de datos, en este sitio web encontrarás más contenido sobre arquitecturas, herramientas y conceptos que te ayudarán a construir una base sólida en el campo.
Sigue aprendiendo:
Ingeniería en Análisis / Ciencia de Datos
¿Qué es PySpark y para qué sirve?
Herramientas ETL: Elige la correcta y ahorra horas de trabajo
Azure Data Factory (ADF): El servicio que mueve tus datos en la nube ☁️
Data Mesh: La arquitectura que descentraliza datos
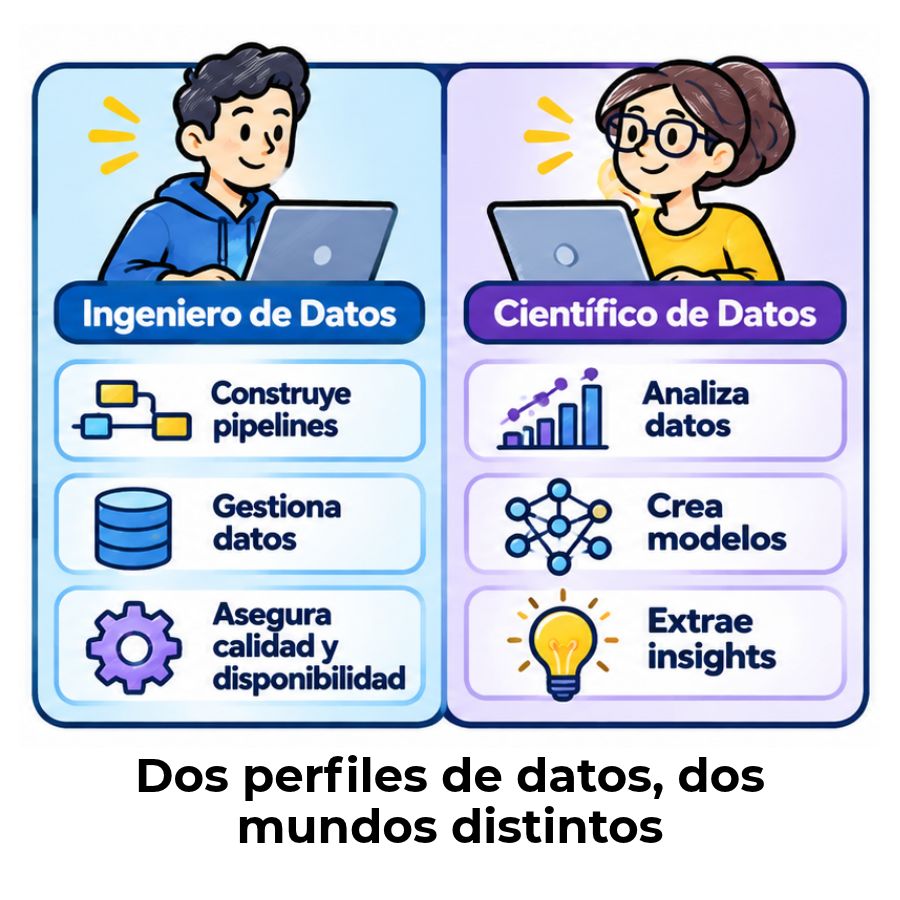
Ingeniero de datos vs. Científico de datos
¿Qué es ETL? – Extracción, Transformación y Carga
¿Qué es un data warehouse y para qué sirve?
