
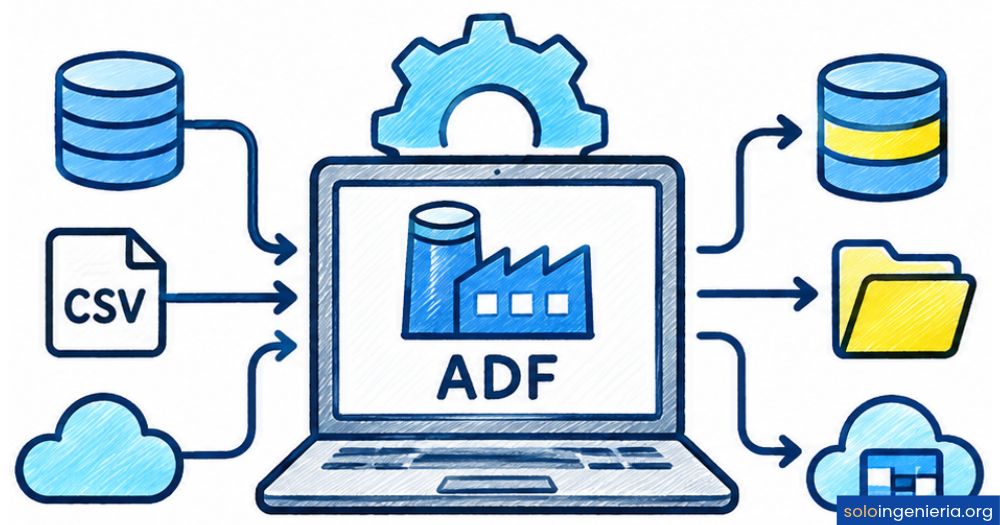
Imagina que tienes datos repartidos entre una base de datos local, un archivo en la nube y una API externa. ¿Cómo los unes, los limpias y los llevas donde los necesitas, sin hacerlo a mano cada vez? Eso es exactamente lo que resuelve Azure Data Factory: un servicio que orquesta todos esos movimientos de forma automática.
¿Qué es Azure Data Factory (ADF)?
Azure Data Factory (ADF) es un servicio en la nube administrado de Microsoft diseñado para orquestar, mover y transformar datos entre sistemas heterogéneos a gran escala. A diferencia de una base de datos o un almacén de datos, ADF no guarda información: su función es actuar como el motor que conecta fuentes de datos dispersas y coordina los flujos de trabajo que las vinculan.
Dentro del ecosistema de ingeniería de datos, ADF ocupa el rol de plataforma de integración y orquestación. Esto significa que tú defines de dónde vienen los datos, qué transformaciones deben aplicarse y dónde deben terminar: ADF se encarga de ejecutar ese proceso de forma automática, en el momento que configures y con la frecuencia que necesites.
Su lugar en el ecosistema de datos de Microsoft
ADF forma parte de la plataforma Azure junto a otros servicios como Azure Synapse Analytics, Azure Databricks y Azure Data Lake Storage. Su papel dentro de esa constelación es el de plano de control: no almacena ni procesa datos de forma intensiva por sí solo, sino que coordina qué herramienta hace qué cosa y cuándo. Piensa en él como el director de orquesta que sincroniza a todos los músicos sin tocar ningún instrumento directamente.
Microsoft ha señalado que Azure Data Factory evoluciona hacia su integración con Microsoft Fabric, la próxima generación de la plataforma de datos de la compañía. Aun así, ADF sigue siendo la opción más extendida para equipos que ya trabajan dentro del ecosistema Azure y necesitan una solución madura y bien documentada.
ADF como plataforma PaaS administrada
ADF es una solución PaaS (Platform as a Service), lo que significa que Microsoft gestiona toda la infraestructura subyacente: servidores, actualizaciones, disponibilidad y escalado. Tú solo te preocupas por diseñar los flujos de trabajo. No necesitas instalar nada en tus propios servidores ni mantener máquinas virtuales dedicadas al procesamiento de datos.
Esta característica lo convierte en una opción atractiva para equipos que quieren resultados rápidos sin destinar recursos a operaciones de infraestructura. Al ser serverless, ADF escala automáticamente según el volumen de datos que proceses en cada momento, sin que tengas que intervenir manualmente en ese ajuste.
Componentes clave de Azure Data Factory
Entender ADF es, en buena medida, entender sus piezas. Cada componente cumple una función específica dentro del flujo de datos, y juntos forman el mecanismo que hace posible la integración automatizada. A continuación encontrarás los bloques fundamentales que toda persona que trabaja con ADF debe conocer.
Pipelines y actividades
Un pipeline es la unidad de trabajo principal en ADF: agrupa un conjunto de actividades que se ejecutan en un orden determinado para completar una tarea de integración. Puedes pensar en él como una receta de cocina donde cada paso depende del anterior. Dentro del pipeline, las actividades son los pasos concretos: copiar un archivo, ejecutar una consulta SQL, llamar a una función de Azure o lanzar un proceso en Databricks.
La actividad más usada es la Copy Activity, que mueve datos de un origen a un destino sin que tengas que escribir código de transferencia. Pero ADF también incluye actividades de control de flujo —como condicionales y bucles— que permiten construir pipelines inteligentes que reaccionan al estado de los datos o al resultado de pasos anteriores.
Datasets y servicios vinculados
Un dataset describe los datos con los que va a trabajar una actividad: su formato (CSV, Parquet, JSON), su ubicación y su estructura. No almacena datos en sí mismo; simplemente proporciona a ADF la información necesaria para leerlos o escribirlos correctamente. Es el equivalente a un mapa que le dice al servicio dónde están los datos y cómo están organizados.
Los servicios vinculados (Linked Services) completan ese mapa con las credenciales y parámetros de conexión al sistema externo: la cadena de conexión a una base de datos, el token de autenticación de una API o las claves de acceso a un contenedor de almacenamiento. Separar la descripción de los datos (dataset) de las credenciales de acceso (linked service) aporta seguridad y reutilización en el diseño.
Flujos de datos (Data Flows)
Los Data Flows son el componente de ADF dedicado a las transformaciones visuales de datos sin necesidad de escribir código. Mediante un diseñador gráfico de arrastrar y soltar, defines operaciones como filtros, uniones, agregaciones, conversiones de tipo y derivaciones de columnas. Por detrás, ADF ejecuta esas transformaciones sobre un clúster Apache Spark que administra de forma automática.
El tipo más habitual es el Mapping Data Flow, orientado a transformaciones por lotes de alta escala. Existe también el Wrangling Data Flow, pensado para exploración y preparación de datos de forma más interactiva. La elección entre uno y otro depende de si tu prioridad es el rendimiento a escala o la agilidad en la exploración.
Integration Runtime: el motor de ejecución
El Integration Runtime (IR) es la infraestructura de cómputo sobre la que se ejecutan las actividades de un pipeline. ADF ofrece tres tipos: el Azure IR, completamente administrado en la nube; el Self-hosted IR, que se instala en un servidor propio para acceder a datos locales o en redes privadas; y el SSIS IR, diseñado para ejecutar paquetes heredados de SQL Server Integration Services.
La selección del IR correcto es una decisión de arquitectura de datos que influye directamente en el rendimiento y en el costo. Si todos tus datos están en la nube de Azure, el Azure IR es suficiente. Si necesitas conectarte a sistemas locales protegidos por un firewall, el Self-hosted IR es el camino.
¿Cómo funciona un pipeline en Azure Data Factory?
Cuando diseñas un pipeline en ADF, estás definiendo una secuencia de instrucciones que el servicio ejecutará de forma automática. El ciclo completo pasa por cuatro fases: conexión, lectura, transformación y escritura. Cada una de ellas se configura visualmente desde el portal de Azure o mediante archivos JSON para los equipos que prefieren la gestión por código.
Proceso de orquestación paso a paso
ADF usa el Linked Service para autenticarse y conectarse al sistema de origen, ya sea una base de datos SQL, un bucket de S3 o una API REST.
La Copy Activity o el Data Flow lee los datos según la definición del Dataset, con el esquema y el formato indicados en la configuración.
Si el pipeline incluye un Data Flow o una actividad de cómputo externo (Databricks, Azure Functions), los datos se procesan antes de ser escritos en el destino.
ADF escribe los datos en el sistema de destino configurado: un data lake, una base de datos analítica, un data warehouse o cualquier otro almacén compatible.
ADF registra cada ejecución en su panel de monitoreo. Puedes revisar el estado de cada actividad, los tiempos de ejecución y configurar alertas ante fallos.
Tipos de desencadenadores (triggers)
Un pipeline no se ejecuta solo: necesita un desencadenador que lo ponga en marcha. ADF ofrece tres tipos principales. El trigger programado ejecuta el pipeline en un horario fijo (cada hora, cada día, cada semana). El trigger por evento reacciona a sucesos externos, como la llegada de un nuevo archivo a un contenedor de Azure Blob Storage. El trigger de ventana de saltos procesa datos históricos en intervalos de tiempo consecutivos, ideal para cargas por lotes.
La elección del tipo de trigger determina la frecuencia y el costo del pipeline. Un trigger que se dispara cada minuto generará muchas más ejecuciones facturables que uno diario, por lo que conviene analizar la frecuencia real con la que tus datos cambian antes de configurarlo.
ETL y ELT en Azure Data Factory
Uno de los puntos de confusión más comunes para quienes se acercan a ADF es entender su relación con los procesos ETL y ELT. Ambos son estrategias de integración de datos, y ADF soporta las dos modalidades, aunque de formas distintas.
Diferencias entre ETL y ELT en ADF
| Aspecto | ETL en ADF | ELT en ADF |
|---|---|---|
| Orden del proceso | Extrae → Transforma → Carga | Extrae → Carga → Transforma |
| Dónde ocurre la transformación | En ADF (Mapping Data Flows) | En el destino (Synapse, Databricks) |
| Cuándo usarlo | Datos que deben limpiarse antes de llegar al destino | Destino con alta capacidad de cómputo |
| Herramienta principal | Data Flows dentro de ADF | ADF + Azure Synapse o Databricks |
En la práctica, muchos proyectos combinan ambos enfoques. ADF copia los datos en bruto hacia un data lake (ELT), y posteriormente un proceso separado en Synapse o Databricks aplica las transformaciones complejas. ADF actúa principalmente como orquestador, no como motor de transformación intensiva.
Mapping Data Flows: transformaciones sin código
El Mapping Data Flow es la funcionalidad de ADF que permite diseñar transformaciones de datos con una interfaz visual, sin necesidad de escribir código Spark directamente. Desde el lienzo gráfico, puedes encadenar operaciones como filtros de filas, derivación de nuevas columnas, uniones entre tablas, pivoteo de datos y agregaciones.
Por detrás de esa interfaz visual, ADF genera automáticamente el código Spark correspondiente y lo ejecuta en un clúster gestionado. Esto significa que tus transformaciones escalan desde megabytes hasta terabytes sin que tengas que gestionar la infraestructura de cómputo. La ventaja para equipos pequeños es clara: acceden a la potencia de Spark sin necesitar un especialista dedicado.
Casos de uso reales de Azure Data Factory
ADF no es una herramienta genérica: brilla en situaciones concretas donde los datos deben moverse entre sistemas con regularidad, a escala y de forma confiable. Estos son los escenarios donde más se utiliza en la práctica.
Mover bases de datos locales o sistemas heredados hacia Azure Data Lake Storage o Azure SQL Database, con transformaciones incluidas durante el traslado.
Cargar y actualizar periódicamente Azure Synapse Analytics o bases de datos analíticas con datos procesados, listos para consumo en Power BI u otras herramientas de visualización.
Consolidar datos procedentes de CRMs como Salesforce, ERPs como SAP y plataformas de marketing externas en un único repositorio centralizado.
Recopilar datos de ventas, inventario y comportamiento de usuario de múltiples canales y unificarlos para análisis de rendimiento en tiempo casi real.
Automatizar la ingesta y limpieza de datos que alimentan modelos de aprendizaje automático en Azure Machine Learning, garantizando que siempre trabajen con información actualizada.
Cuando dos organizaciones se fusionan y necesitan unificar sus sistemas de datos, ADF permite orquestar la migración y consolidación sin interrumpir las operaciones.
Uno de los ejemplos documentados públicamente es el del Aeropuerto de Heathrow en Londres, que adoptó un entorno Azure unificado para mantener sistemas de datos conectados y coherentes en toda su operación. Este tipo de caso ilustra cómo ADF encaja como capa de integración en infraestructuras complejas que combinan múltiples fuentes y destinos de datos.
Azure Data Factory vs. otras herramientas de datos
ADF no es la única opción para orquestar y mover datos. Compararlo con otras herramientas populares ayuda a entender cuándo es la elección correcta y cuándo otra solución puede encajar mejor con tus necesidades.
| Criterio | Azure Data Factory | Azure Databricks | Apache Airflow |
|---|---|---|---|
| Rol principal | Orquestación e integración de datos | Procesamiento y transformación avanzada | Orquestación de flujos de trabajo |
| Código requerido | Mínimo (interfaz visual) | Alto (Python, Scala, SQL) | Alto (Python) |
| Gestión de infraestructura | Completamente administrada | Parcialmente administrada | Requiere despliegue propio |
| Mejor para | ETL/ELT sin código intensivo | Transformaciones Spark a gran escala | Orquestación personalizada y flexible |
| Integración con Azure | Nativa y profunda | Nativa | Mediante conectores externos |
La comparativa más frecuente es ADF frente a Databricks. La diferencia clave es que ADF está optimizado para orquestar y mover datos, mientras que Databricks está diseñado para procesarlos de forma intensiva con Spark. No son rivales: en muchos proyectos trabajan juntos, con ADF orquestando el flujo y Databricks ejecutando las transformaciones más complejas.
El buen gobierno de datos también influye en esta elección: ADF ofrece integración nativa con Microsoft Purview para catalogar y rastrear el linaje de los datos a lo largo de los pipelines, algo que herramientas de código abierto como Airflow no incluyen de forma nativa.
Ventajas y limitaciones de Azure Data Factory
Ninguna herramienta es perfecta para todos los escenarios. Conocer las fortalezas y los puntos débiles de ADF antes de adoptarlo te ayuda a tomar una decisión informada y a planificar mejor el diseño de tu solución.
Ventajas principales
- ✔ Más de 100 conectores nativos: Se integra de forma directa con bases de datos locales, servicios en la nube, APIs REST, sistemas de archivos y plataformas SaaS como Salesforce o Google AdWords.
- ✔ Interfaz visual de arrastrar y soltar: Permite diseñar pipelines complejos sin escribir código, lo que acelera la adopción por parte de perfiles con poca experiencia en programación.
- ✔ Escalado automático y sin servidor: ADF ajusta los recursos de cómputo según el volumen de datos procesado, sin necesidad de intervención manual ni gestión de infraestructura.
- ✔ Monitoreo y alertas integrados: El panel de monitoreo de ADF registra cada ejecución, muestra métricas de rendimiento y permite configurar notificaciones ante fallos o anomalías.
- ✔ Pago por uso: Solo pagas por las ejecuciones de pipelines, el tiempo de procesamiento de Data Flows y las operaciones realizadas, sin costos fijos por tener el servicio disponible.
Limitaciones a tener en cuenta
- ✗ No apto para procesamiento en tiempo real: ADF está diseñado para cargas por lotes o micro-lotes. Si necesitas procesamiento de flujos de datos en tiempo real, debes combinarlo con Azure Stream Analytics o Event Hubs.
- ✗ Curva de aprendizaje en Data Flows: Aunque el diseñador visual es accesible, dominar los Mapping Data Flows complejos y depurar errores de Spark requiere tiempo y práctica.
- ✗ Modelo de precios complejo: Los costos se acumulan por diferentes conceptos (orquestación, movimiento de datos, Data Flows, IR), lo que hace difícil estimar el gasto total sin ejecutar una prueba de concepto previa.
- ✗ Dependencia del ecosistema Azure: La integración con servicios fuera de Azure (como AWS o entornos puramente locales) a veces requiere configuraciones adicionales o conectores personalizados.
¿Cuánto cuesta Azure Data Factory?
ADF usa un modelo de pago por consumo: no hay una tarifa fija mensual por el servicio en sí. Los costos se generan a partir de distintos conceptos que se suman según el uso real. Entender cómo funciona este modelo es clave para evitar sorpresas en la factura de Azure.
* Los precios son orientativos y varían según la región de Azure. Consulta la calculadora oficial de Azure para obtener estimaciones precisas para tu caso de uso.
ADF no cuenta con una capa gratuita permanente, aunque las cuentas nuevas de Azure pueden recibir créditos iniciales aplicables al servicio. Para proyectos con alta frecuencia de ejecución o transformaciones intensivas en Data Flows, el costo puede crecer rápidamente, por lo que se recomienda estimar el consumo con la calculadora de precios de Azure antes de diseñar la arquitectura definitiva.
Preguntas frecuentes
¿Para qué sirve Azure Data Factory?
Azure Data Factory sirve para orquestar, mover y transformar datos entre sistemas heterogéneos de forma automatizada. Te permite construir pipelines que extraen datos de múltiples fuentes —bases de datos locales, APIs, servicios en la nube—, aplican transformaciones si es necesario y los cargan en un destino como un data warehouse, un data lake o una base de datos analítica. Su uso principal es automatizar procesos de integración de datos que, de hacerse manualmente, serían lentos, costosos y propensos a errores.
¿Qué diferencia hay entre Azure Data Factory y Databricks?
La diferencia fundamental está en el rol que cumple cada uno. Azure Data Factory es principalmente un orquestador e integrador de datos: su punto fuerte es conectar sistemas, mover información y coordinar flujos de trabajo automatizados. Azure Databricks, en cambio, es una plataforma de procesamiento intensivo basada en Apache Spark, diseñada para ejecutar transformaciones complejas, modelos de aprendizaje automático y análisis a gran escala. En muchos proyectos, ambas herramientas coexisten: ADF gestiona la orquestación y Databricks ejecuta el procesamiento pesado.
¿Azure Data Factory es un servicio ETL o ELT?
Azure Data Factory soporta ambos enfoques. En el modo ETL, transforma los datos durante su tránsito mediante Mapping Data Flows antes de cargarlos en el destino. En el modo ELT, copia los datos en bruto al destino y delega la transformación a un motor externo como Azure Synapse Analytics o Databricks. La elección entre ETL y ELT en ADF depende del volumen de datos, la complejidad de las transformaciones y la capacidad de cómputo disponible en el destino.
¿Qué es el Integration Runtime en ADF?
El Integration Runtime es la infraestructura de cómputo sobre la que ADF ejecuta sus actividades. Existen tres tipos: el Azure Integration Runtime, completamente administrado en la nube y adecuado para datos que ya están en Azure o en internet; el Self-hosted Integration Runtime, que se instala en un servidor propio para acceder a datos en redes privadas o entornos locales; y el SSIS Integration Runtime, diseñado para ejecutar paquetes de SQL Server Integration Services heredados en la nube de Azure.
¿Azure Data Factory tiene capa gratuita?
Azure Data Factory no ofrece una capa gratuita permanente. Las cuentas nuevas de Azure pueden recibir créditos iniciales durante el periodo de prueba que se pueden aplicar al uso de ADF, pero una vez agotados, el servicio se factura según el consumo real. Para proyectos de aprendizaje o pruebas de concepto, estos créditos iniciales suelen ser suficientes para explorar el servicio sin incurrir en costos inmediatos.
¿Qué lenguajes de programación se usan en ADF?
Azure Data Factory puede usarse sin código mediante su interfaz visual, que cubre la mayoría de los casos de uso habituales. Para escenarios más avanzados, los pipelines y los componentes de ADF se definen mediante archivos JSON, que es el formato nativo del servicio. Además, ADF se puede gestionar programáticamente desde Python, PowerShell, .NET y la API REST de Azure, lo que permite integrar su gestión en pipelines de CI/CD y flujos de desarrollo automatizados.
¿Con qué fuentes de datos se conecta Azure Data Factory?
Azure Data Factory soporta más de 100 conectores nativos que cubren una amplia variedad de sistemas. Entre las fuentes más habituales están bases de datos relacionales como SQL Server, MySQL, PostgreSQL y Oracle; almacenes en la nube como Azure Blob Storage, Amazon S3 y Google Cloud Storage; sistemas SaaS como Salesforce, SAP, Marketo y Google AdWords; y formatos de archivo como CSV, Parquet, JSON y ORC. Para fuentes no cubiertas de forma nativa, ADF también admite conectores genéricos mediante ODBC o APIs REST.
Conclusión
Azure Data Factory es el servicio de Microsoft que resuelve uno de los problemas más comunes en proyectos de datos: coordinar fuentes heterogéneas, aplicar transformaciones y entregar información limpia donde se necesita, todo de forma automática. Su diseño como plataforma administrada y sin servidor lo convierte en una opción accesible tanto para equipos que comienzan como para organizaciones con infraestructuras complejas.
A lo largo de este recorrido has visto sus componentes —pipelines, actividades, datasets, linked services, Data Flows e Integration Runtime—, cómo funciona el proceso de orquestación, en qué casos destaca y dónde tiene sus límites. Con ese marco claro, puedes evaluar si ADF encaja en tu proyecto y qué arquitectura tiene más sentido según tus necesidades reales de datos.
Si este tema te ha abierto el apetito, en este sitio web encontrarás más contenido sobre ingeniería de datos, arquitecturas cloud y herramientas del ecosistema Azure que te ayudarán a seguir construyendo tu base de conocimiento paso a paso.
Sigue aprendiendo:
Herramientas ETL: Elige la correcta y ahorra horas de trabajo
Ingeniería en Análisis / Ciencia de Datos
¿Qué es un data lake y cómo funciona?
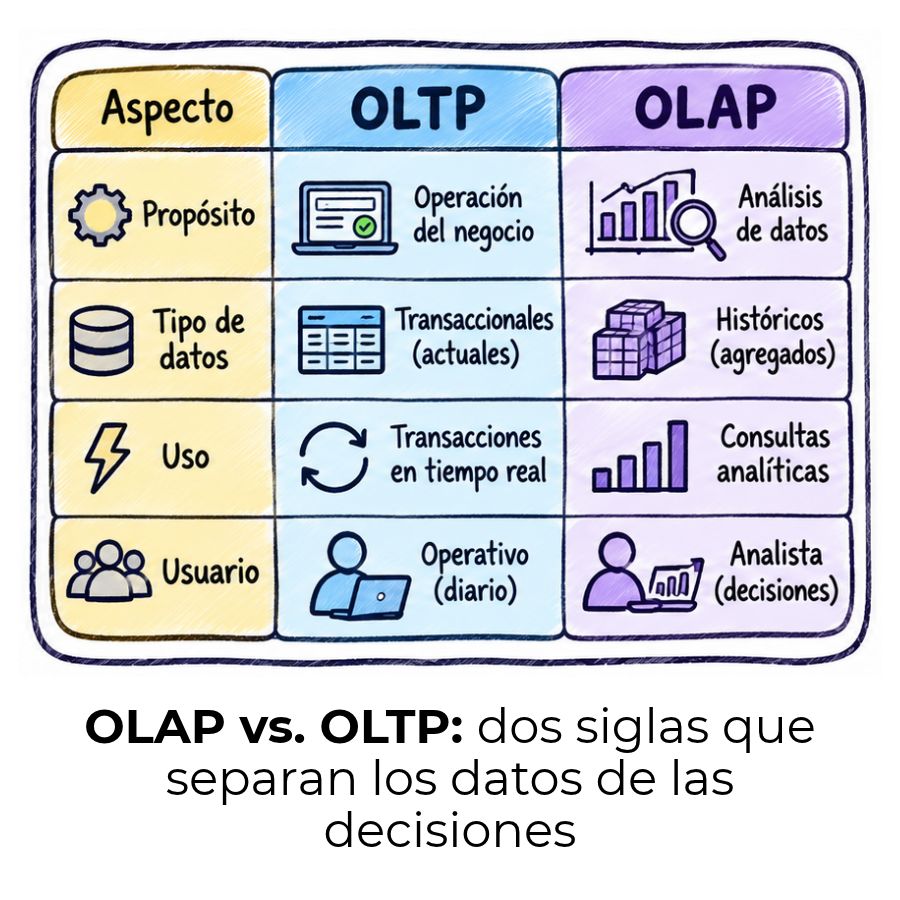
OLAP vs. OLTP: Diferencias clave que debes conocer
Apache Airflow: Automatiza y controla tus flujos de datos con Python
¿Qué es un data warehouse y para qué sirve?
Data Mesh: La arquitectura que descentraliza datos
Gobierno de datos: Controla tu información y toma mejores decisiones 📊
