
Cada vez que un sistema mueve, limpia y organiza datos de forma automática, hay una herramienta ETL detrás. Son el motor invisible de la ingeniería de datos, pero elegir mal puede convertir un pipeline sencillo en un problema de semanas. Antes de decidir cuál usar, vale la pena entender qué hace cada una y por qué no todas sirven para lo mismo.
¿Qué son las herramientas ETL y para qué sirven?
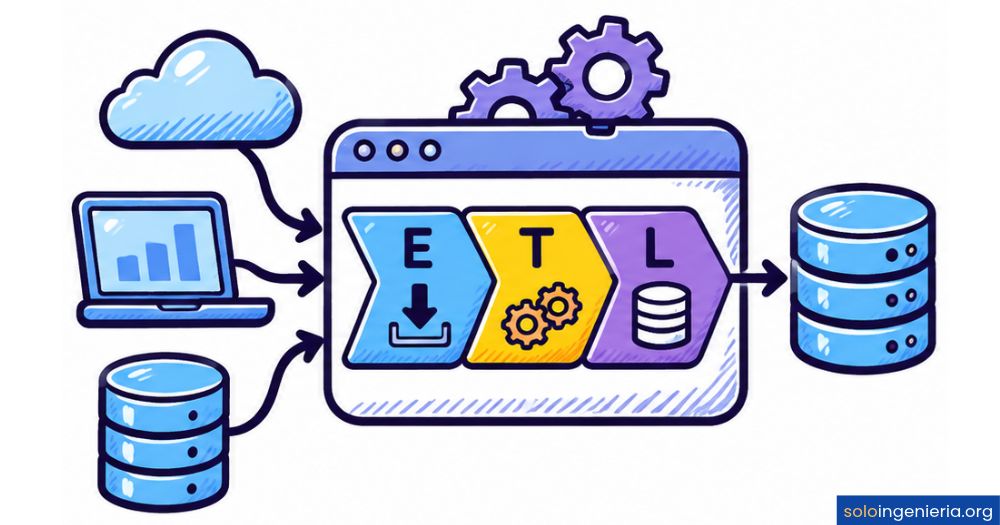
Una herramienta ETL es un software que automatiza tres operaciones sobre los datos: extraerlos de una o varias fuentes, transformarlos para que cumplan un formato o regla de negocio y cargarlos en un destino final, que puede ser un almacén de datos, un data lake o cualquier otro sistema de análisis. Sin este proceso, los datos quedarían dispersos, inconsistentes e inutilizables para tomar decisiones.
El término ETL proviene del inglés Extract, Transform, Load. Aunque el concepto existe desde hace décadas, las herramientas actuales han evolucionado enormemente: hoy puedes encontrar soluciones visuales sin código, servicios completamente serverless y motores de código abierto con miles de conectores. Si quieres profundizar en la base conceptual, puedes revisar qué es el proceso de ETL antes de continuar.
¿Cómo funciona una herramienta ETL por dentro?
Cuando ejecutas un proceso ETL, la herramienta se conecta a la fuente de datos, lee los registros disponibles y los transfiere a un área de procesamiento intermedia. Ahí aplica las transformaciones definidas: elimina duplicados, convierte tipos de datos, cruza tablas o aplica filtros. Este paso intermedio es lo que diferencia a las herramientas ETL de los sistemas que simplemente copian datos, ya que el dato llega al destino ya preparado para el análisis.
El resultado final es un conjunto de datos limpio, consistente y listo para alimentar dashboards, modelos de aprendizaje automático o informes de negocio. Dependiendo de la herramienta, este proceso puede ejecutarse en lotes programados (batch) o en tiempo real (streaming), lo que cambia considerablemente la arquitectura necesaria.
Diferencia entre ETL clásico y ETL moderno
Las herramientas ETL clásicas transformaban los datos en un servidor dedicado antes de cargarlos. Las herramientas modernas han adoptado el patrón ELT, donde los datos se cargan primero en el destino y la transformación ocurre dentro del propio almacén, aprovechando la potencia de plataformas cloud como Snowflake, BigQuery o Redshift. Esto ha cambiado radicalmente cómo se elige una herramienta.
Además, las soluciones modernas incorporan conectores preconstruidos, interfaces visuales y capacidades de orquestación que antes requerían desarrollo a medida. Si te interesa explorar esta evolución con más detalle, el artículo sobre ETL vs. ELT explica con claridad cuándo conviene cada enfoque.
Tipos de herramientas ETL que existen
No todas las herramientas ETL funcionan igual ni están pensadas para los mismos equipos. El mercado se divide en cuatro grandes categorías según el modelo de despliegue, el nivel técnico requerido y el tipo de organización al que se dirigen. Conocer estas categorías te ayuda a descartar rápidamente las opciones que no encajan con tu contexto.
Herramientas ETL de código abierto
Las herramientas de código abierto no tienen coste de licencia y permiten modificar su comportamiento en profundidad. Son la opción favorita de los equipos técnicos que necesitan control total sobre el pipeline y no quieren depender de un proveedor. El precio es el tiempo de configuración y la necesidad de un equipo con conocimientos sólidos en programación y administración de sistemas.
Herramientas ETL en la nube (SaaS y cloud-native)
Estas herramientas viven completamente en la nube: no instalas nada, no gestionas servidores y el proveedor se encarga del mantenimiento y la escala. Son ideales cuando tu infraestructura ya está en un proveedor cloud como AWS, Azure o Google Cloud, y quieres reducir al mínimo el tiempo de puesta en marcha. El modelo de pago por uso puede resultar económico para proyectos pequeños, pero los costes escalan con el volumen de datos.
Herramientas ETL empresariales (enterprise)
Las herramientas empresariales están diseñadas para organizaciones que manejan volúmenes masivos de datos con requisitos estrictos de seguridad, auditoría y gobernanza. Informatica o IBM DataStage son referentes en este segmento, con funcionalidades como la gestión de datos maestros y el linaje del dato. Su coste es elevado, pero las empresas que las eligen lo hacen porque los riesgos de un pipeline mal gestionado son mayores que la inversión.
Herramientas ETL de bajo código (low-code y no-code)
El auge de las interfaces visuales ha abierto la puerta a perfiles no técnicos para construir pipelines de datos sin escribir una sola línea de código. Herramientas como Hevo Data o Stitch permiten conectar fuentes y destinos en minutos mediante paneles visuales. Esta categoría ha crecido especialmente en equipos de marketing y análisis donde los datos son importantes, pero los ingenieros de datos son un recurso escaso.
Las principales herramientas ETL explicadas una a una
A continuación encontrarás las herramientas más usadas en la industria con una explicación detallada de qué hacen, cómo funcionan y para qué tipo de proyecto encajan mejor. Ninguna es universalmente superior: cada una brilla en un contexto específico, y conocerlas te permite tomar una decisión fundamentada.
Apache Airflow
Apache Airflow es la herramienta de orquestación de pipelines más extendida en equipos de ingeniería de datos. No es una herramienta ETL en sentido estricto: no mueve ni transforma datos por sí sola, sino que programa, monitoriza y coordina las tareas que lo hacen. Los flujos de trabajo se definen como DAGs (grafos acíclicos dirigidos) escritos en Python, lo que le da una flexibilidad enorme para conectar prácticamente cualquier sistema.
Su ecosistema de operadores preconstruidos cubre GCP, AWS, Azure, bases de datos relacionales y docenas de servicios de terceros. Es la elección habitual cuando tienes pipelines con muchas dependencias entre pasos y necesitas reintentos automáticos, alertas y una vista clara del historial de ejecuciones. Si ya usas Python en tu stack, la curva de aprendizaje es razonable.
AWS Glue
AWS Glue es el servicio ETL serverless de Amazon Web Services. No requiere configurar ni mantener servidores: defines la lógica de extracción y transformación en Python o Scala, y AWS gestiona automáticamente el cómputo necesario. Incluye un catálogo de datos (Glue Catalog) que descubre y almacena los metadatos de tus fuentes, y una interfaz visual (Glue Studio) para diseñar pipelines sin código.
Su modelo de precios es de pago por uso, medido en horas de DPU (Data Processing Unit). Es la opción natural si toda tu infraestructura ya vive en AWS: se integra de forma nativa con S3, Redshift, RDS, DynamoDB y Kinesis. Su principal limitación es el vendor lock-in: fuera del ecosistema de Amazon, su utilidad cae significativamente. También puedes explorar Azure Data Factory (ADF) si tu stack es Microsoft.
Azure Data Factory (ADF)
Azure Data Factory es el servicio de integración de datos de Microsoft. Funciona con un modelo de pipelines visuales donde conectas actividades de copia, transformación y orquestación sin escribir código. Se integra de forma natural con todo el ecosistema Azure (Azure Blob Storage, Azure SQL, Synapse Analytics, Databricks) y admite conexiones hacia más de noventa fuentes de datos externas.
Una de sus ventajas más valoradas es la capacidad de combinar pipelines de datos con lógica de orquestación compleja mediante disparadores basados en tiempo, eventos o dependencias. Es la elección más sólida para empresas cuyo stack de datos ya vive en Microsoft Azure. Si quieres entender más sobre su arquitectura y casos de uso, el artículo dedicado a Azure Data Factory (ADF) lo explica en detalle.
Talend
Talend es una de las plataformas ETL más completas del mercado y lleva más de una década siendo referente en integración de datos empresariales. Su versión Talend Open Studio es de código abierto y gratuita; las versiones de pago añaden gobernanza del dato, gestión de calidad y soporte dedicado. Tiene más de 900 conectores nativos y una interfaz visual que permite construir pipelines sin escribir código, aunque dominar sus capacidades avanzadas requiere práctica.
Desde su adquisición por parte de Qlik, Talend se ha integrado en un ecosistema más amplio de análisis y visualización de datos. Es una opción equilibrada entre funcionalidad y coste para equipos que necesitan tanto ETL como ELT en entornos híbridos (cloud y on-premise). Su curva de aprendizaje es moderada comparada con herramientas puramente de código como Airflow.
Informatica PowerCenter
Informatica PowerCenter es la herramienta ETL más citada en entornos corporativos de gran escala. Es conocida por su robustez, su rendimiento en volúmenes masivos de datos y sus capacidades de gobernanza del dato, calidad y gestión de datos maestros (MDM). Es la opción preferida de los departamentos de TI en grandes corporaciones que gestionan datos críticos de negocio con requisitos estrictos de auditoría y cumplimiento normativo.
Su precio es elevado y su implementación requiere tiempo y personal especializado. No es una herramienta para equipos pequeños ni proyectos con presupuesto limitado. Su modelo de consumo basado en IPUs (Informatica Processing Units) puede resultar difícil de predecir en costes si el volumen de datos varía. Para proyectos de ingeniería de datos a gran escala, sigue siendo una referencia ineludible.
Fivetran
Fivetran es una solución ETL completamente gestionada y orientada a la simplicidad. Su propuesta de valor es clara: conecta una fuente de datos en minutos con más de 500 conectores preconstruidos y listo. No necesitas programar transformaciones en la carga; Fivetran aplica el patrón ELT, dejando que el data warehouse destino haga el trabajo de transformación. Esto lo hace ideal junto con herramientas como dbt.
Su modelo de precios basado en el volumen de filas activas mensuales (MAR) puede resultar costoso si manejas grandes volúmenes, pero a cambio obtienes una herramienta que apenas requiere mantenimiento. Es la favorita de los equipos de analytics pequeños y medianos que quieren datos siempre actualizados sin dedicar tiempo a mantener pipelines.
Airbyte
Airbyte es la alternativa de código abierto a Fivetran. Tiene más de 300 conectores disponibles y permite desplegarlo en tu propia infraestructura (self-hosted) o usarlo como servicio en la nube. Su gran diferencia respecto a las soluciones de pago es que puedes construir conectores personalizados cuando no encuentres el que necesitas, algo que las herramientas cerradas no permiten.
La versión cloud de Airbyte tiene un modelo de precios por créditos, mientras que la versión self-hosted es gratuita, pero requiere que gestiones la infraestructura. Es la opción más flexible para equipos técnicos que necesitan conectores a fuentes poco comunes o que prefieren no depender de un proveedor externo para sus pipelines.
Pentaho Data Integration
Pentaho Data Integration, también conocida como Kettle, es una plataforma ETL de código abierto con una interfaz gráfica llamada Spoon que permite diseñar transformaciones de datos de forma visual. Es una de las herramientas más maduras del mercado y tiene una comunidad activa que ha contribuido cientos de plugins y extensiones a lo largo de los años.
Su versión comunitaria es completamente gratuita y funciona bien para proyectos de tamaño medio. La versión empresarial de Hitachi Vantara añade soporte y componentes adicionales de gobernanza del dato. Es habitual encontrarla en entornos on-premise donde no existe una migración planificada a la nube a corto plazo.
Hevo Data
Hevo Data es una plataforma ETL de bajo código especialmente pensada para equipos sin ingenieros de datos dedicados. Permite conectar más de 150 fuentes de datos y cargar información en un data warehouse en cuestión de minutos, con transformaciones básicas que se configuran visualmente. Es una de las herramientas mejor valoradas en facilidad de uso según revisiones de usuarios en plataformas especializadas.
Su modelo de precios es por eventos procesados, lo que lo hace asequible para volúmenes bajos y moderados. Para equipos de marketing, e-commerce o startups que necesitan análisis de datos sin un equipo técnico grande, Hevo Data elimina la barrera de entrada que representan herramientas como Airflow o AWS Glue.
Apache NiFi
Apache NiFi es una herramienta ETL de código abierto diseñada para el procesamiento de datos en tiempo real y la automatización de flujos de datos entre sistemas. Su interfaz visual de arrastrar y soltar permite construir pipelines de datos complejos sin escribir código, lo que la diferencia de otras herramientas open source como Airflow. Es especialmente potente en escenarios de IoT, ciberseguridad y flujos de datos continuos.
Tiene más de 280 procesadores nativos y permite extender su funcionalidad con procesadores personalizados. Su arquitectura es horizontalmente escalable, lo que la hace adecuada para pipelines de alto volumen en streaming. Su curva de aprendizaje es mayor que la de herramientas low-code, pero menor que la de herramientas puramente basadas en código como Airflow.
¿Cuál es la mejor herramienta ETL según tu caso de uso?
La respuesta más honesta es: depende de tu stack, tu equipo y el volumen de datos que manejas. No existe una herramienta ETL universalmente superior. Cada una tiene un contexto donde brillar, y elegir la incorrecta puede costarte semanas de reconfiguración. Antes de decidir, conviene analizar al menos cuatro factores clave que determinan qué herramienta se adapta mejor a tu realidad.
Factores clave para elegir la herramienta adecuada
- Proveedor cloud de tu infraestructura: Si ya usas AWS, AWS Glue es la opción más integrada. Si tu stack es Azure, Azure Data Factory encaja de forma natural. Si trabajas en entornos multicloud u on-premise, herramientas como Talend o Airbyte son más flexibles.
- Nivel técnico del equipo: Para equipos con ingenieros de datos con experiencia en Python, Airflow ofrece el mayor control. Para perfiles menos técnicos o equipos mixtos, Hevo Data, Stitch o Fivetran son más accesibles sin sacrificar funcionalidad.
- Volumen y velocidad de los datos: Los pipelines de streaming en tiempo real requieren herramientas con soporte específico, como AWS Glue en modo streaming, Apache NiFi o Apache Kafka con conectores ETL. Para lotes programados, prácticamente cualquier herramienta funciona.
- Presupuesto disponible: Si el presupuesto es limitado, las opciones open source como Airflow, Airbyte o Pentaho son válidas. Si el tiempo del equipo es más valioso que el coste de licencia, las soluciones gestionadas como Fivetran o AWS Glue amortizan rápidamente su precio.
- Requisitos de gobernanza y cumplimiento: Proyectos con normativas estrictas (GDPR, HIPAA, SOX) suelen requerir herramientas empresariales como Informatica o IBM DataStage, que incluyen auditoría, linaje del dato y controles de acceso avanzados.
Comparativa de herramientas ETL: tabla resumen
La siguiente tabla recoge las principales características de cada herramienta para que puedas comparar de un vistazo y tomar una decisión informada. Los criterios más relevantes son el modelo de despliegue, el nivel técnico requerido, el soporte a streaming y el modelo de precios, ya que son los que más impactan en la decisión real de un equipo.
| Herramienta | Tipo | Despliegue | Nivel técnico | Streaming | Precio base |
|---|---|---|---|---|---|
| Apache Airflow | Orquestador | Self-hosted / Cloud | Alto (Python) | No nativo | Gratuito (open source) |
| AWS Glue | ETL serverless | AWS Cloud | Medio-Alto | Sí (Kinesis/Kafka) | Pago por DPU/hora |
| Azure Data Factory | ETL / Orquestación | Azure Cloud | Medio | Sí | Pago por actividad |
| Talend | ETL / ELT | Cloud / Híbrido | Medio | Sí (versión enterprise) | Open source / Suscripción |
| Informatica | ETL Enterprise | Cloud / On-premise | Alto | Sí | Por consumo (IPU) |
| Fivetran | ELT gestionado | Cloud gestionado | Bajo | No (batch) | Por filas activas (MAR) |
| Airbyte | ELT | Self-hosted / Cloud | Medio | Limitado | Gratuito / Por créditos |
| Pentaho PDI | ETL | On-premise / Cloud | Medio | Limitado | Gratuito (community) |
| Hevo Data | ELT Low-code | Cloud gestionado | Bajo | Sí | Por eventos procesados |
| Apache NiFi | ETL en tiempo real | Self-hosted / Cloud | Medio-Alto | Sí (nativo) | Gratuito (open source) |
¿Qué herramienta ETL se usa más con Python?
Python es el lenguaje dominante en ingeniería de datos, y varias herramientas ETL lo integran de forma nativa o lo utilizan como lenguaje principal. Apache Airflow es la herramienta que más profundamente se integra con Python, ya que los pipelines se definen completamente en este lenguaje mediante DAGs. No es una integración superficial: Python es el núcleo de Airflow.
AWS Glue también utiliza Python (específicamente PySpark) para definir las transformaciones en sus ETL Jobs. Por otro lado, si prefieres construir pipelines ETL completamente a medida, puedes hacerlo con librerías como Pandas, PySpark o Polars sin necesitar una herramienta ETL externa. Este enfoque se conoce como ETL con código personalizado y tiene pleno sentido cuando los pipelines son simples o muy específicos. El artículo sobre ETL con Python explica cómo construir este tipo de pipelines desde cero.
Python no es una herramienta ETL por sí solo, pero con las librerías adecuadas y un orquestador como Airflow, se convierte en una plataforma ETL completamente funcional.
🐍 Herramientas ETL con mejor integración en Python
Apache Airflow
DAGs 100 % en Python. Mayor control y flexibilidad.
AWS Glue
PySpark y Python para transformaciones en la nube.
Airbyte
Permite crear conectores personalizados en Python.
ETL con Python puro
Pandas, PySpark o Polars para pipelines a medida.
Preguntas frecuentes
¿Qué es una herramienta ETL y cómo funciona?
Una herramienta ETL es un software que automatiza el proceso de extraer datos de una o varias fuentes, aplicarles transformaciones (limpieza, conversión de formatos, cruces entre tablas) y cargarlos en un sistema destino como un data warehouse o un data lake. El proceso garantiza que los datos llegan al destino en un formato limpio y consistente, listo para ser analizado sin manipulación adicional. Existen versiones que ejecutan este proceso en lotes programados y otras que lo hacen en tiempo real.
¿Cuáles son las herramientas ETL más usadas en la industria?
Las herramientas ETL más extendidas en la industria incluyen Apache Airflow (especialmente en equipos con Python), AWS Glue (en empresas con infraestructura Amazon), Informatica PowerCenter (en grandes corporaciones con requisitos de gobernanza), Talend (en entornos híbridos cloud y on-premise) y Fivetran (en equipos de analytics que buscan simplicidad). Informatica PowerCenter es consistentemente citado como uno de los más usados en entornos enterprise, mientras que Airflow domina en equipos de ingeniería de datos con perfiles técnicos avanzados.
¿Qué diferencia hay entre una herramienta ETL y ELT?
En el modelo ETL clásico, los datos se transforman en un servidor intermedio antes de llegar al destino. En el modelo ELT, los datos se cargan primero en bruto en el destino (normalmente un data warehouse cloud) y la transformación ocurre ahí dentro, aprovechando la potencia de cómputo del propio almacén. El modelo ELT ha ganado protagonismo con la popularización de plataformas cloud como Snowflake, BigQuery y Redshift. Puedes profundizar en las diferencias entre ambos enfoques en el artículo sobre ETL vs. ELT.
¿Es Apache Airflow una herramienta ETL?
No exactamente. Apache Airflow es un orquestador de workflows, no una herramienta ETL en sentido estricto. No extrae ni transforma datos por sí solo: su función es programar, coordinar y monitorizar las tareas que lo hacen. Se suele usar junto con herramientas de movimiento de datos (como Airbyte o scripts Python) para construir pipelines completos. Es un error común adoptarlo esperando conectores de datos que en realidad no incluye de forma nativa.
¿Qué herramienta ETL es mejor para principiantes?
Para alguien que se acerca por primera vez a la integración de datos, las opciones más accesibles son Hevo Data, Fivetran y Stitch, ya que ofrecen interfaces visuales y conectores preconstruidos que permiten mover datos en minutos sin escribir código. Si tienes conocimientos básicos de Python y quieres aprender la herramienta que más se usa en la industria, Apache Airflow es el camino más recomendable, aunque requiere más tiempo de aprendizaje inicial. Para entender el proceso antes de elegir una herramienta, conviene comenzar leyendo sobre la base conceptual del proceso ETL.
¿Qué herramienta ETL se usa más con Python?
Apache Airflow es la herramienta que más profundamente integra Python, ya que sus pipelines se definen íntegramente en este lenguaje mediante DAGs. AWS Glue usa PySpark para las transformaciones. Airbyte permite crear conectores personalizados en Python cuando no existe uno preconstruido. Para proyectos donde prefieres control total sin depender de una herramienta externa, construir pipelines ETL directamente con librerías como Pandas o PySpark es una alternativa completamente válida.
¿Cuándo conviene usar una herramienta ETL en la nube?
Una herramienta ETL en la nube tiene sentido cuando tu infraestructura de datos ya vive en un proveedor cloud, cuando no tienes capacidad de gestionar servidores propios o cuando necesitas escalar el proceso de integración de datos sin dedicar tiempo a administración de sistemas. El modelo serverless de opciones como AWS Glue o Azure Data Factory elimina la necesidad de aprovisionar recursos, lo que acelera la puesta en marcha. Para equipos pequeños o startups, el ahorro en tiempo de operaciones suele justificar el coste de uso.
¿Qué herramienta ETL es gratuita o de código abierto?
Las principales herramientas ETL gratuitas y de código abierto son Apache Airflow, Airbyte (versión self-hosted), Apache NiFi, Pentaho Data Integration (versión community) y Talend Open Studio. Gratuito no significa sin coste: todas requieren infraestructura para ejecutarse (servidores propios o cloud) y tiempo de configuración y mantenimiento por parte del equipo técnico. Para proyectos con presupuesto limitado pero con capacidad técnica interna, estas opciones ofrecen una funcionalidad muy completa sin pagar licencias.
Conclusión
Las herramientas ETL son el motor que permite mover, limpiar y preparar datos para que sean útiles en la toma de decisiones. Desde opciones serverless en la nube hasta orquestadores de código abierto basados en Python, el ecosistema es amplio y cada herramienta tiene un contexto donde aporta su mayor valor. Entender qué hace cada una es el primer paso para construir pipelines de datos sólidos y mantenibles.
A lo largo de este artículo has visto que la elección depende de factores concretos: tu proveedor cloud, el nivel técnico de tu equipo, el volumen de datos y tus requisitos de gobernanza. Si tu infraestructura vive en AWS, AWS Glue te facilita la vida. Si necesitas flexibilidad y controlas Python, Airflow es tu aliado. Si quieres empezar sin código, Hevo o Fivetran te permiten arrancar en horas. Aplicar este criterio desde el principio te ahorrará semanas de reconfiguración más adelante.
La ingeniería de datos es un campo que evoluciona rápido, y conocer las herramientas disponibles te da una ventaja real. Si quieres seguir explorando conceptos relacionados, en este sitio web encontrarás más contenidos sobre pipelines, arquitecturas de datos y tecnologías que están dando forma al trabajo con datos hoy.
Sigue aprendiendo:
¿Qué hace un ingeniero de datos?
Diferencia entre Databricks y Snowflake
Ingeniería en Análisis / Ciencia de Datos
¿Qué es un data lake y cómo funciona?
Arquitectura de datos: El secreto que mueve los datos de tu empresa
Cómo ser ingeniero de datos desde cero
¿Qué es PySpark y para qué sirve?
¿Qué es un data warehouse y para qué sirve?
