
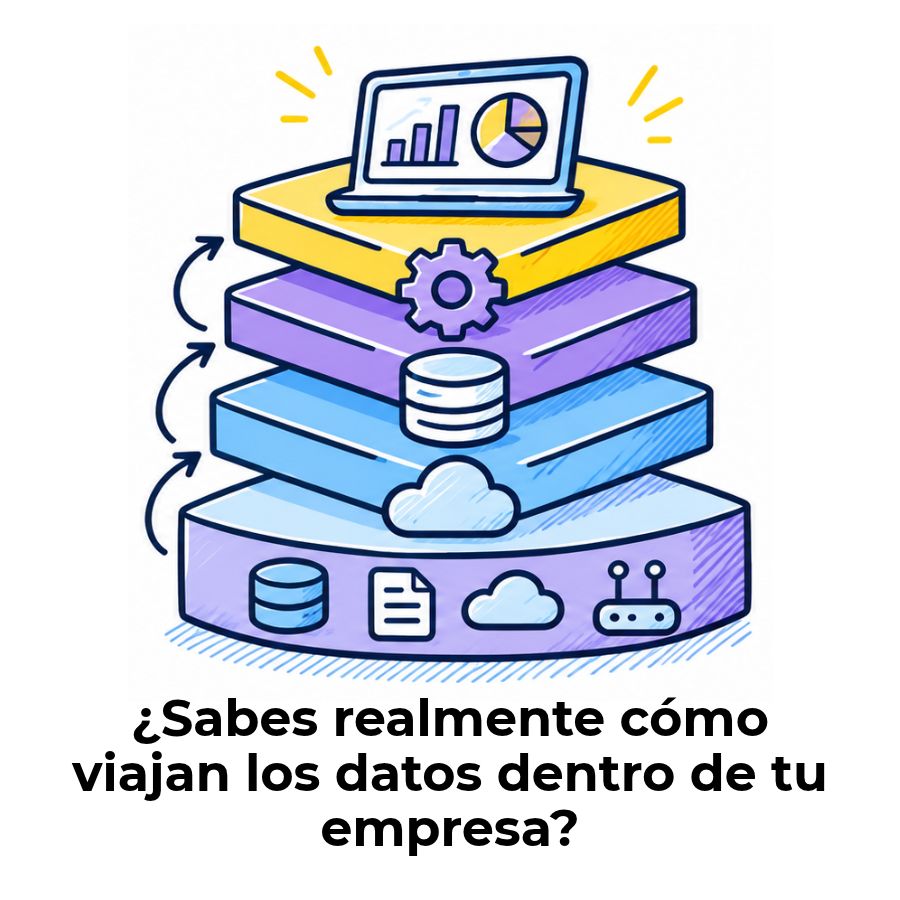
La arquitectura de datos es el diseño que define cómo se recopilan, almacenan, procesan y consumen los datos dentro de una organización. Si alguna vez te has preguntado por qué algunas empresas toman decisiones rápidas y precisas mientras otras no logran aprovechar su propia información, la respuesta casi siempre está aquí.
¿Qué es la arquitectura de datos?
La arquitectura de datos es el diseño estructural que define cómo se recopilan, almacenan, procesan y consumen los datos dentro de una organización. No se trata de una tecnología concreta, sino de un conjunto de modelos, reglas y estándares que determinan cómo fluye la información desde su origen hasta el momento en que alguien la usa para tomar una decisión.
Piénsalo como el plano de un edificio: antes de levantar las paredes, necesitas saber cuántos pisos tendrá, dónde irán las instalaciones eléctricas y cómo se conectarán todas las habitaciones. Con los datos ocurre lo mismo. Sin un diseño previo, los sistemas de información crecen de forma caótica, generando duplicados, inconsistencias y datos que nadie puede interpretar con confianza.
«La arquitectura de datos es el puente entre los datos sin procesar y las necesidades reales del negocio.» — SAP
Una arquitectura bien diseñada responde a tres preguntas fundamentales: ¿de dónde vienen los datos?, ¿dónde y cómo se guardan?, y ¿quién puede usarlos y para qué? Cuando estas tres preguntas tienen respuesta clara, la organización puede operar con información fiable, segura y disponible en el momento preciso.
Componentes principales de una arquitectura de datos
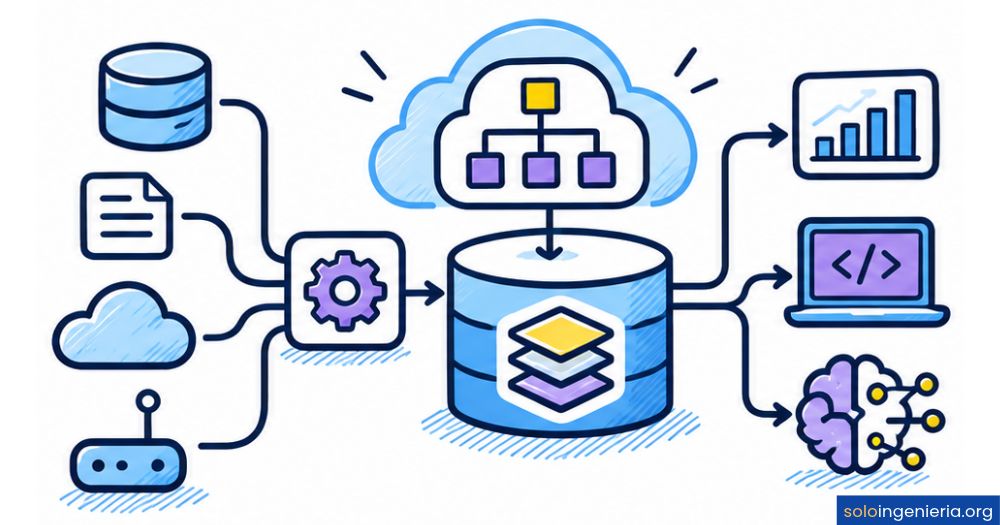
Una arquitectura de datos no es un elemento único, sino un sistema formado por piezas que trabajan de forma coordinada. Cada componente cumple una función específica dentro del ciclo de vida del dato: desde que nace en una fuente hasta que llega a manos de quien lo necesita para tomar una decisión.
Fuentes de datos
Las fuentes de datos son el punto de partida de toda arquitectura. Pueden ser bases de datos relacionales, aplicaciones empresariales, formularios web, sensores IoT, archivos de texto, APIs de terceros o registros de sistemas internos. La variedad y el volumen de estas fuentes determinan en gran medida la complejidad de la arquitectura que se necesita para gestionarlas de forma ordenada.
Capa de ingesta
La ingesta es el proceso mediante el cual los datos se mueven desde sus fuentes originales hacia el sistema de almacenamiento. Puede ocurrir en modo batch (en lotes programados, por ejemplo, cada noche) o en modo streaming (en tiempo real, de forma continua). La elección entre uno u otro depende de la urgencia con la que la organización necesite acceder a los datos más recientes.
Almacenamiento de datos
El almacenamiento define dónde y cómo se guardan los datos una vez ingeridos. Aquí entran en juego opciones como los data warehouses, los data lakes y los data lakehouses, cada uno con características distintas según el tipo de datos que aloja y el uso que se le dará. Un buen diseño de almacenamiento equilibra el coste, la velocidad de acceso y la facilidad para consultar la información según las necesidades del negocio.
Capa de procesamiento
Los datos raramente llegan en condiciones óptimas para ser analizados directamente. La capa de procesamiento se encarga de limpiarlos, transformarlos, enriquecerlos y prepararlos para su uso. Este proceso suele conocerse como ETL (Extracción, Transformación y Carga) o ELT cuando la transformación ocurre después de la carga. Sin esta capa, los análisis posteriores estarían basados en datos incompletos o incorrectos.
Capa de servicio y consumo
Una vez que los datos están limpios y transformados, la capa de servicio los pone a disposición de los usuarios finales: analistas, científicos de datos, sistemas de inteligencia de negocio o aplicaciones que dependen de ellos. La eficiencia de esta capa determina la velocidad con la que una organización puede convertir datos en decisiones, por lo que su diseño tiene un impacto directo en la operación diaria.
Gobierno y seguridad de datos
El gobierno de datos no es una capa técnica aislada, sino un conjunto de políticas y controles que atraviesa toda la arquitectura. Incluye la gestión de la calidad de datos, el control de accesos, el cumplimiento de normativas de privacidad y la gestión de metadatos. Una arquitectura sin gobierno sólido produce datos que no se puede confiar, aunque sean técnicamente correctos.
Capas de una arquitectura de datos moderna
Cuando se habla de las capas de una arquitectura de datos, se hace referencia a los niveles lógicos por los que transita la información desde su origen hasta su uso final. Entender estas capas ayuda a identificar dónde se producen los cuellos de botella y qué parte del sistema necesita atención cuando algo falla.
¿Cuáles son los tipos de arquitectura de datos?
No existe un único modelo de arquitectura de datos que sirva para todas las organizaciones. Con el tiempo han surgido distintos enfoques, cada uno pensado para resolver necesidades específicas. Conocer las diferencias entre ellos te permitirá entender qué modelo encaja mejor con el tipo de datos y los objetivos de cada proyecto.
Data warehouse
El data warehouse es el modelo más tradicional y consolidado. Almacena datos estructurados, ya modelados y listos para ser consultados. Su esquema se define antes de cargar los datos (schema on-write), lo que garantiza consistencia y velocidad en las consultas analíticas. Es la opción ideal cuando el objetivo principal es generar reportes financieros, operativos o de negocio con alta fiabilidad.
Data lake
El data lake nació como respuesta a la limitación del data warehouse frente a datos no estructurados. Permite almacenar cualquier tipo de dato en su formato original, sin necesidad de un esquema previo (schema on-read). Esto lo hace ideal para proyectos de ciencia de datos y aprendizaje automático, aunque requiere un gobierno sólido para evitar convertirse en un «pantano de datos» donde nadie sabe qué hay ni cómo usarlo.
Data lakehouse
El data lakehouse combina las ventajas del data lake y del data warehouse en una sola plataforma. Ofrece la flexibilidad de almacenar datos en crudo junto con las capacidades de consulta rápida y gobierno del warehouse. Es una arquitectura especialmente útil para organizaciones que necesitan soportar tanto análisis estructurado como cargas de trabajo de inteligencia artificial y machine learning desde un mismo entorno.
Data mesh
El data mesh responde a un problema organizativo más que técnico: cuando un equipo central de datos se convierte en un cuello de botella para toda la organización. Propone distribuir la propiedad de los datos entre los equipos de cada dominio de negocio, quienes son responsables de gestionar y publicar sus propios productos de datos bajo estándares comunes. Es el modelo que mejor escala en empresas grandes con múltiples áreas independientes.
| Característica | Data warehouse | Data lake | Data lakehouse | Data mesh |
|---|---|---|---|---|
| Tipo de datos | Estructurados | Todos los tipos | Todos los tipos | Todos los tipos |
| Esquema | Schema on-write | Schema on-read | Mixto | Por dominio |
| Uso principal | Reportes y BI | Ciencia de datos, ML | BI + ML unificados | Productos de datos |
| Gestión | Centralizada | Centralizada | Centralizada | Distribuida |
| Ideal para | Empresas con datos estructurados | Grandes volúmenes y variedad | Cargas mixtas | Organizaciones grandes |
Diferencia entre arquitectura de datos y modelado de datos
Es habitual que estos dos conceptos se confundan, especialmente cuando se empieza en el mundo de los datos. La arquitectura de datos define el mapa general del sistema: cómo fluye la información, dónde se almacena y cómo se gobierna. El modelado de datos, en cambio, trabaja dentro de ese mapa y se ocupa de representar las estructuras concretas: las entidades, sus relaciones y los formatos con los que se organiza la información dentro de cada sistema.
Una forma sencilla de entenderlo: la arquitectura decide que los datos de ventas irán a un data warehouse en la nube; el modelado define exactamente cómo se estructura la tabla de ventas, qué campos contiene y cómo se relaciona con la tabla de clientes. Ambas disciplinas son complementarias y necesarias, pero operan en niveles de abstracción distintos.
- Define el sistema completo
- Establece flujos y almacenamiento
- Fija reglas y estándares globales
- Visión de alto nivel
- La diseña el arquitecto de datos
- Define estructuras concretas
- Establece entidades y relaciones
- Fija formatos y restricciones
- Visión detallada dentro del sistema
- Lo desarrolla el modelador o DBA
Principios de una buena arquitectura de datos
Diseñar una arquitectura de datos no consiste solo en elegir tecnologías. Detrás de cada decisión técnica hay principios que guían el diseño para que el sistema sea sostenible, seguro y capaz de crecer con la organización. Estos principios no son opcionales: ignorarlos genera deuda técnica que se acumula rápidamente y se vuelve muy costosa de corregir.
- Escalabilidad: La arquitectura debe poder crecer en volumen y complejidad sin necesidad de rediseñarla desde cero cuando los datos aumenten.
- Modularidad (bajo acoplamiento): Los componentes deben ser independientes entre sí para que cambiar uno no provoque fallos en cadena en los demás.
- Reversibilidad: Las decisiones de diseño deben poder revisarse. Una arquitectura que no permite cambiar de tecnología sin coste prohibitivo es una arquitectura frágil.
- Seguridad desde el diseño: La protección de los datos no se añade al final como un parche, sino que se integra desde el primer momento en cada capa del sistema.
- Calidad como prioridad: Los datos incorrectos generan decisiones incorrectas. La arquitectura debe incluir mecanismos para validar y monitorizar la calidad de la información en todo su ciclo.
- Agilidad operativa: Un diseño que minimiza el movimiento innecesario de datos reduce costes y mejora la velocidad con la que la organización accede a información actualizada.
¿Quién diseña y construye la arquitectura de datos?
La arquitectura de datos no es responsabilidad de una sola persona ni de un único perfil profesional. Detrás de un sistema funcional suele haber varios roles que colaboran con responsabilidades distintas y complementarias. Entender quién hace qué dentro de este ecosistema es útil tanto si quieres trabajar en el sector como si necesitas contratar a alguien para tu organización.
Arquitectura de datos y su relación con la ingeniería de datos
La arquitectura de datos y la ingeniería de datos son dos disciplinas que van de la mano, aunque con objetivos distintos. La arquitectura define el diseño: qué sistemas existirán, cómo se comunicarán y bajo qué reglas operarán. La ingeniería se encarga de construir y mantener ese diseño en funcionamiento, día a día, con herramientas y pipelines concretos.
Sin una buena arquitectura, el ingeniero de datos trabaja sin plano: construye soluciones parciales que con el tiempo se vuelven incoherentes entre sí. Sin ingeniería, la arquitectura más brillante sobre el papel nunca se convierte en un sistema real. La diferencia entre ambas es la misma que existe entre el arquitecto y el constructor de un edificio: sin diseño no hay dirección, y sin ejecución no hay resultado.
Una de las herramientas más usadas para implementar la capa de orquestación de pipelines dentro de una arquitectura de datos es Apache Airflow. Permite programar, monitorizar y gestionar flujos de trabajo de datos de forma automatizada, lo que convierte en práctica real lo que la arquitectura plantea en teoría.
Preguntas frecuentes
¿Para qué sirve la arquitectura de datos en una empresa?
La arquitectura de datos sirve para que una organización pueda gestionar su información de forma ordenada, segura y eficiente. Sin ella, los datos crecen de manera desordenada, generando duplicados, inconsistencias y sistemas que no se comunican entre sí. Con una arquitectura bien definida, la empresa puede acceder a datos fiables en el momento que los necesita, cumplir con normativas de privacidad y tomar decisiones respaldadas en información verificable, no en intuiciones.
¿Cuántas capas tiene una arquitectura de datos?
El número de capas varía según el modelo y el autor de referencia, pero en términos generales, una arquitectura de datos moderna incluye entre cinco y siete capas: fuentes de datos, ingesta, almacenamiento, procesamiento, servicio/consumo y, de forma transversal, gobierno y seguridad. Algunas arquitecturas añaden una capa de metadatos o de orquestación para gestionar los flujos entre capas de forma automatizada, especialmente en entornos de gran escala.
¿Qué diferencia hay entre un data lake y un data warehouse?
La diferencia principal está en el tipo de datos que almacenan y en el momento en que se les da estructura. El data warehouse solo admite datos estructurados, con un esquema definido antes de la carga, lo que garantiza consultas rápidas y fiables para reportes de negocio. El data lake, en cambio, acepta cualquier tipo de dato en su formato original, sin esquema previo, lo que da flexibilidad para proyectos de ciencia de datos, aunque requiere mayor disciplina de gobierno para evitar que se convierta en un repositorio caótico.
¿Qué es el data mesh y cuándo conviene usarlo?
El data mesh es un enfoque organizativo que distribuye la responsabilidad sobre los datos entre los equipos de cada dominio de negocio, en lugar de concentrarla en un equipo central. Conviene usarlo cuando la organización es suficientemente grande como para que un solo equipo de datos se convierta en un cuello de botella que ralentiza a todas las demás áreas. No reemplaza a las tecnologías existentes (data lake, warehouse), sino que redefine quién es responsable de cada parte del ecosistema.
¿Qué herramientas se usan para implementar una arquitectura de datos?
Las herramientas varían según la capa de la arquitectura. Para la ingesta y orquestación de pipelines se usan plataformas como Apache Kafka o Apache Airflow. Para el almacenamiento, soluciones como Amazon S3, Google BigQuery, Snowflake o Databricks. Para la transformación, herramientas como dbt (data build tool). Y para el gobierno y la calidad de datos, plataformas especializadas como Apache Atlas o soluciones nativas de los proveedores de nube. No existe una herramienta única que cubra toda la arquitectura; la combinación depende del contexto y los requisitos de cada proyecto.
¿Qué es el gobierno de datos dentro de una arquitectura?
El gobierno de datos es el conjunto de políticas, procesos y responsabilidades que garantizan que los datos sean correctos, seguros, accesibles solo para quien debe acceder a ellos y conformes con las normativas vigentes. Dentro de la arquitectura, el gobierno no es una capa aislada, sino una dimensión transversal que atraviesa todas las demás. Sin gobierno, incluso la arquitectura técnicamente más avanzada produce datos que nadie confía usar para tomar decisiones importantes.
¿Cuánto tiempo lleva implementar una arquitectura de datos?
No existe un plazo universal porque depende del tamaño de la organización, el volumen y variedad de datos, el número de sistemas existentes y la madurez tecnológica del equipo. Una implementación inicial funcional puede llevarse a cabo en semanas para organizaciones pequeñas, mientras que en empresas grandes con múltiples fuentes y requisitos de cumplimiento, el proceso puede extenderse durante meses e incluso años en fases iterativas. Lo más habitual es adoptar un enfoque incremental, priorizando los casos de uso de mayor valor para el negocio antes de ampliar la arquitectura.
¿Puede una empresa pequeña tener una arquitectura de datos?
Sí, y de hecho debería. La arquitectura de datos no es exclusiva de grandes corporaciones. Una empresa pequeña también genera datos en sus sistemas de ventas, facturación, comunicación con clientes o logística, y necesita una estructura para gestionarlos correctamente. A menor escala, la arquitectura puede ser más sencilla: una base de datos bien diseñada con procesos claros de ingesta y control de calidad ya constituye una arquitectura funcional. Lo importante no es la sofisticación, sino la coherencia del diseño.
Conclusión
La arquitectura de datos es el diseño que da coherencia a todo el ciclo de vida de la información en una organización: desde que un dato aparece en una fuente hasta que alguien lo usa para tomar una decisión. Sin esa estructura, los datos existen pero no funcionan. Con ella, cada pieza del sistema tiene un propósito claro y una conexión lógica con las demás.
Los conceptos que has conocido aquí —componentes, capas, tipos como data warehouse, data lake, data mesh y principios de diseño— son el vocabulario fundamental para entender cómo se construye cualquier sistema de datos real. Puedes aplicarlos tanto si estás evaluando la situación de tu propia organización como si estás dando tus primeros pasos hacia un rol técnico en el sector.
El campo de los datos tiene mucho más por explorar: desde la orquestación de flujos hasta el gobierno avanzado y los modelos de inteligencia artificial que se alimentan de estas arquitecturas. En este sitio web encontrarás más contenidos que te ayudarán a seguir construyendo ese conocimiento, paso a paso y sin atajos innecesarios.
Sigue aprendiendo:
Cómo ser ingeniero de datos desde cero
¿Qué es PySpark y para qué sirve?
¿Qué es un data lake y cómo funciona?
Calidad de datos: El secreto que separa buenos de malos análisis
AWS Glue: El secreto detrás de los grandes pipelines de datos
Ingesta de datos: Transforma fuentes caóticas en valor real
Apache Airflow: Automatiza y controla tus flujos de datos con Python
Azure Data Factory (ADF): El servicio que mueve tus datos en la nube ☁️
