
Imagina que tienes veinte tareas automatizadas que deben ejecutarse en un orden exacto, cada noche, sin que tú estés presente. Si una falla, todo lo demás se detiene. Apache Airflow existe precisamente para ese escenario: coordinar, programar y vigilar flujos de trabajo de datos sin que tengas que hacerlo tú.
¿Qué es Apache Airflow?
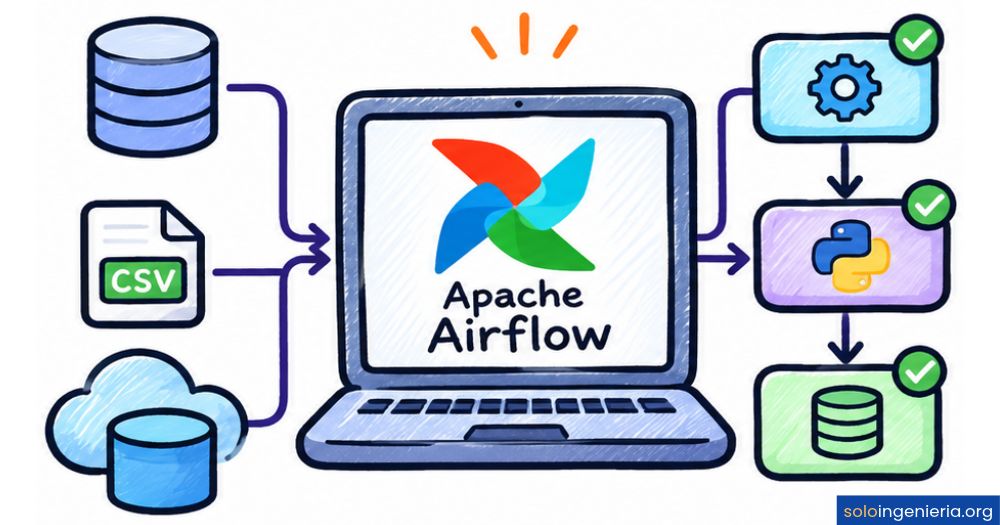
Apache Airflow es una plataforma de código abierto para diseñar, programar y supervisar flujos de trabajo mediante código Python. No es una herramienta que procese datos por sí misma: su función es coordinar qué tarea se ejecuta, en qué momento y en qué orden, garantizando que cada paso de un proceso de datos ocurra exactamente cuando debe. Si alguna tarea falla, Airflow lo detecta, registra el error y puede reintentar la ejecución de forma automática.
Dentro del ecosistema de ingeniería de datos, Airflow ocupa el rol de orquestador: el componente que conecta todas las piezas de un pipeline y les dice cuándo actuar. Piensa en él como el director de una orquesta que no toca ningún instrumento, pero sin el cual cada músico tocaría a su propio ritmo y en su propio momento.
Su origen: de Airbnb a la Apache Software Foundation
Apache Airflow nació en 2014 dentro del equipo de ingeniería de datos de Airbnb, que necesitaba una forma de coordinar procesos de datos cada vez más complejos sin perder visibilidad sobre ellos. La solución que desarrollaron internamente resultó tan útil que decidieron compartirla con la comunidad. En abril de 2016, el proyecto ingresó a la incubadora oficial de la Apache Software Foundation y, en enero de 2019, alcanzó el estatus de proyecto de máxima categoría dentro de esa fundación.
Desde entonces, Airflow se ha convertido en uno de los proyectos de código abierto más activos del ecosistema de datos, con miles de contribuyentes en todo el mundo y versiones que siguen incorporando mejoras sustanciales. Puedes consultar la documentación oficial y el historial de versiones directamente en el sitio oficial de Apache Airflow, donde también encontrarás ejemplos y guías de instalación mantenidas por la comunidad.
¿Por qué se considera un orquestador y no una herramienta ETL?
Esta distinción es una de las que más confunde a quienes empiezan. Airflow no extrae, transforma ni carga datos por sí mismo: su trabajo es decidir cuándo y en qué orden lo hacen otras herramientas. Un proceso ETL mueve datos; Airflow coordina ese movimiento. Puedes pensar en él como el semáforo de una intersección: no conduce ningún vehículo, pero sin él el tráfico sería un caos.
«Airflow es un orquestador de tareas: permite ejecutar cada tarea en el momento correcto, de la forma correcta y en el orden correcto.»
¿Cómo funciona Apache Airflow por dentro?
El funcionamiento de Airflow gira en torno a un concepto central: el DAG. Todo lo demás —operadores, hooks, ejecutores— existe para servir a esa estructura. Cuando defines un pipeline en Airflow, en realidad estás escribiendo un DAG en Python que describe qué tareas deben ejecutarse, en qué orden y bajo qué condiciones. Una vez que el Scheduler detecta ese DAG, lo lee, lo valida y comienza a programar su ejecución según las reglas que tú estableciste.
El DAG: la estructura central de todo flujo de trabajo
DAG son las siglas de Directed Acyclic Graph, que en español significa grafo dirigido acíclico. Un DAG es, en términos simples, un mapa de tareas con un orden definido y sin ciclos que se repitan indefinidamente. Cada nodo del grafo representa una tarea, y las flechas entre nodos indican las dependencias: «Esta tarea solo puede ejecutarse cuando la anterior haya terminado con éxito».
Lo que hace a los DAGs especialmente potentes es la combinación de dependencias explícitas y ejecución paralela. Dos tareas que no dependen entre sí pueden correr al mismo tiempo, lo que reduce drásticamente el tiempo total de un pipeline. Y como todo el DAG está escrito en Python, puedes versionarlo, revisarlo y colaborar con tu equipo exactamente igual que con cualquier otro código.
Tareas y operadores: las unidades de trabajo
Dentro de un DAG, cada nodo es una tarea, y cada tarea se define mediante un operador. Los operadores son las plantillas que describen qué debe hacer exactamente esa tarea. Airflow incluye un amplio catálogo de operadores listos para usar, y además puedes crear los tuyos propios si ninguno se ajusta a tu caso.
Hooks: la conexión con sistemas externos
Los hooks son interfaces que Airflow proporciona para comunicarse con sistemas externos de forma estandarizada. Mientras que un operador define qué hace una tarea, el hook se encarga de cómo conectarse con el sistema externo que esa tarea necesita. Por ejemplo, si una tarea tiene que leer datos desde Amazon S3, el S3Hook gestiona toda la autenticación y la comunicación con ese servicio, sin que tengas que escribir ese código desde cero.
La diferencia práctica entre operadores y hooks es que los hooks son reutilizables: varios operadores distintos pueden usar el mismo hook para conectarse a la misma plataforma. Airflow incluye hooks para servicios como Amazon S3, Google Cloud Storage, MySQL, PostgreSQL, Apache Hive y muchos más. También puedes crear hooks personalizados para sistemas propietarios o APIs internas de tu empresa.
Arquitectura de Apache Airflow
Airflow no es un programa monolítico: está formado por varios componentes que trabajan juntos. Entender su arquitectura te ayuda a saber exactamente qué ocurre desde que defines un DAG hasta que sus tareas se ejecutan en producción. Los cuatro componentes principales son el Scheduler, el Webserver, el Executor con sus Workers y el Metastore.
El Scheduler o planificador
El Scheduler es el componente que mantiene Airflow en marcha de forma continua. Su función es leer todos los DAGs disponibles, calcular cuándo debe ejecutarse cada tarea y enviar esas tareas al Executor en el momento oportuno. También verifica que las dependencias entre tareas se respeten: si la tarea A aún no ha terminado, el Scheduler no lanza la tarea B aunque ya haya llegado la hora programada.
El Webserver y la interfaz de usuario
Airflow incluye una interfaz web construida con Flask y Gunicorn que te permite ver el estado de tus DAGs, revisar los registros de cada tarea, relanzar ejecuciones fallidas y activar o pausar flujos de trabajo con un clic. Desde la interfaz puedes ver el grafo completo de un DAG, identificar exactamente en qué tarea falló el proceso y acceder a los logs para entender qué ocurrió. Es la ventana de observación de todo tu ecosistema de pipelines.
El Executor y los Workers
El Executor es el componente que decide cómo se van a ejecutar las tareas: en el mismo proceso del Scheduler, en procesos separados o distribuidos entre varios servidores. En entornos de producción con muchas tareas simultáneas, se usa el CeleryExecutor o el KubernetesExecutor, que distribuyen el trabajo entre múltiples Workers. Los Workers son los procesos que realmente realizan el trabajo: ejecutan el código de cada tarea y reportan el resultado al Metastore.
El Metastore o base de datos de metadatos
El Metastore es una base de datos relacional —habitualmente PostgreSQL o MySQL— donde Airflow guarda toda la información de estado: qué DAGs existen, qué ejecuciones han ocurrido, qué tareas fallaron, cuánto tardaron y cuál es el resultado de cada una. Sin el Metastore, Airflow no tendría memoria: no sabría qué ya se ejecutó ni en qué estado quedó. También es el medio a través del cual el Webserver y el Scheduler se mantienen sincronizados.
¿Para qué se usa Apache Airflow en proyectos reales?
Airflow aparece en proyectos de datos de muy distinto tamaño y sector, porque cualquier proceso que tenga pasos ordenados y dependencias entre ellos es un candidato natural para ser orquestado con él. El caso de uso más común es el pipeline ETL: extraer datos de múltiples fuentes a distintas horas, transformarlos según reglas de negocio y cargarlos en un almacén de datos antes de que el equipo de análisis empiece su jornada.
Además de estos usos habituales, Airflow se integra con facilidad en flujos de calidad de datos, donde cada paso del pipeline incluye validaciones automáticas que detienen el proceso si los datos no cumplen los estándares definidos. Esto convierte a Airflow en algo más que un simple programador de tareas: se vuelve el guardián de la confiabilidad de tus datos.
Ventajas y limitaciones de Apache Airflow
Antes de decidir si Airflow encaja en tu proyecto, conviene tener una imagen clara de lo que ofrece y de dónde tiene sus puntos débiles. No existe la herramienta perfecta, y Airflow no es la excepción: sus fortalezas son reales, pero su curva de aprendizaje y sus requisitos de infraestructura también lo son.
| Ventajas | Limitaciones |
|---|---|
| Los DAGs se escriben en Python, lo que facilita la colaboración y el versionado con Git. | La curva de aprendizaje inicial puede ser pronunciada para quienes no dominan Python o los conceptos de orquestación. |
| Interfaz web visual que permite monitorizar y depurar pipelines sin necesidad de revisar logs manualmente. | No está diseñado para pipelines de streaming en tiempo real; su modelo es por lotes (batch processing). |
| Amplio ecosistema de operadores y hooks para conectarse a prácticamente cualquier servicio externo. | El Scheduler puede convertirse en un cuello de botella si hay miles de DAGs activos con alta frecuencia de ejecución. |
| Código abierto, con una comunidad activa y soporte de proveedores cloud como AWS, GCP y Azure. | Configurar un entorno de producción robusto requiere conocimientos de infraestructura que van más allá del código de los DAGs. |
| Escalable: desde un entorno local hasta clústeres distribuidos con Celery o Kubernetes. | Los DAGs no deben contener lógica que dependa de los datos en tiempo de definición; eso puede resultar contraintuitivo al principio. |
Apache Airflow frente a otras herramientas de orquestación
Airflow no es la única opción para orquestar pipelines de datos, y conocer sus diferencias con otras herramientas te ayuda a elegir la más adecuada para cada contexto. La comparación más frecuente es entre Airflow, Prefect y Dagster, tres orquestadores modernos que comparten el objetivo, pero difieren en su filosofía de diseño y en la experiencia que ofrecen al desarrollador.
| Característica | Apache Airflow | Prefect | Dagster |
|---|---|---|---|
| Lenguaje principal | Python | Python | Python |
| Estructura de flujos | DAGs escritos en Python | Flows y tasks con decoradores | Assets y jobs |
| Gestión de errores | Reintentos configurables por tarea | Gestión de estados más flexible | Orientado a la observabilidad de datos |
| Curva de aprendizaje | Media-alta | Baja-media | Media |
| Madurez y adopción | Muy alta (estándar de la industria) | Alta y en crecimiento | Alta y en crecimiento |
| Opciones cloud gestionadas | AWS MWAA, Cloud Composer, Azure | Prefect Cloud | Dagster Cloud |
La diferencia clave de Airflow frente a sus competidores más modernos es su madurez y adopción industrial. Airflow lleva más de una década siendo el estándar de facto en ingeniería de datos, lo que significa que hay más documentación, más integraciones y más profesionales que lo conocen. Para equipos que buscan estabilidad y un ecosistema consolidado, sigue siendo la primera opción. Para proyectos nuevos donde la experiencia del desarrollador importa más que la madurez, Prefect o Dagster pueden ser alternativas a considerar.
¿Cómo se escribe un DAG básico en Python?
Escribir tu primer DAG en Airflow es más accesible de lo que parece si ya tienes una base de Python. Un DAG mínimo necesita tres elementos: la definición del DAG, al menos una tarea con su operador y las dependencias entre tareas. A continuación se muestra la estructura de un pipeline de ejemplo que extrae datos, los transforma y los carga, con las tres tareas enlazadas en secuencia.
El operador >> es la forma en que Airflow establece las dependencias: «ejecuta primero extraer, luego transformar y finalmente cargar». Si quisieras que dos tareas se ejecuten en paralelo, simplemente las apuntarías desde la misma tarea anterior con tarea_extraer >> [tarea_a, tarea_b]. Este modelo declarativo hace que el flujo sea legible incluso para alguien que no escribió el código original.
El parámetro schedule_interval="@daily" indica que este DAG se ejecutará una vez al día. Puedes usar expresiones cron para controlar el horario con precisión o valores predefinidos como @hourly, @weekly o @monthly. Cuando conectas este tipo de pipelines con herramientas de procesamiento distribuido como PySpark, Airflow se convierte en el coordinador que lanza los trabajos de Spark en el momento adecuado y verifica su resultado antes de continuar con el siguiente paso.
Preguntas frecuentes
¿Qué lenguaje de programación usa Apache Airflow?
Apache Airflow está escrito en Python y los DAGs también se definen íntegramente en Python. Esto significa que para crear flujos de trabajo necesitas tener una base en este lenguaje: saber definir funciones, importar módulos y entender la sintaxis básica. No hace falta ser un experto en Python, pero sí manejar los fundamentos con soltura. La documentación oficial y la comunidad están orientadas a perfiles con conocimientos de Python de nivel básico o intermedio.
¿Cuál es la diferencia entre un DAG, una tarea y un operador en Airflow?
Son tres conceptos anidados: el DAG es el contenedor completo del flujo de trabajo, como el plano de un proceso. Dentro del DAG hay tareas, que son los pasos individuales del proceso. Cada tarea se define mediante un operador, que especifica exactamente qué debe hacer ese paso: ejecutar una función de Python, lanzar un comando de Bash, hacer una consulta a una base de datos o esperar a que ocurra un evento. Sin operador, una tarea no tiene contenido; sin tarea, el DAG está vacío; sin DAG, no hay flujo que coordinar.
¿Apache Airflow procesa datos directamente?
No. Esta es una de las confusiones más comunes entre quienes empiezan. Airflow es un orquestador: coordina qué herramientas procesan los datos, cuándo lo hacen y en qué orden, pero no transforma ni mueve datos por sí mismo. Si necesitas transformar datos, usarás una herramienta como Spark, dbt o Pandas dentro de las tareas que Airflow coordina. Airflow es el director; las herramientas de procesamiento son las que realmente trabajan con los datos.
¿Qué empresas usan Apache Airflow?
Airflow surgió en Airbnb y desde entonces lo han adoptado equipos de datos de empresas de muy distintos sectores y tamaños. Entre las compañías que lo usan públicamente se encuentran LinkedIn, Twitter, Lyft, PayPal, Adobe y Spotify, entre muchas otras. Proveedores cloud como Amazon Web Services, Google Cloud y Microsoft Azure ofrecen versiones gestionadas del servicio, lo que indica que se considera un componente central del ecosistema de datos moderno.
¿Qué es el Scheduler de Airflow y qué hace exactamente?
El Scheduler es el componente de Airflow que funciona de forma continua en segundo plano. Su trabajo es leer todos los archivos de DAGs disponibles, determinar cuáles deben ejecutarse según su configuración de horario, verificar que sus dependencias estén satisfechas y enviar las tareas listas al Executor. También actualiza constantemente el estado de las tareas en el Metastore, de modo que el Webserver pueda mostrar en todo momento una vista actualizada de lo que está ocurriendo.
¿Se puede usar Apache Airflow en la nube?
Sí, y es una de las formas más habituales de desplegarlo en producción. Amazon Web Services ofrece Amazon MWAA (Managed Workflows for Apache Airflow), Google Cloud tiene Cloud Composer y Microsoft Azure dispone de Azure Managed Airflow Job. Estas versiones gestionadas se encargan de la infraestructura: instalación, escalado, actualizaciones y alta disponibilidad. Tú solo te ocupas de escribir y mantener tus DAGs, sin preocuparte por la operación del clúster subyacente.
¿Qué es un Hook en Apache Airflow?
Un Hook es una interfaz de comunicación que Airflow proporciona para conectarse con sistemas externos de forma estandarizada. Gestiona la autenticación, la conexión y la comunicación con servicios como bases de datos, APIs o plataformas de almacenamiento en la nube. La diferencia con un operador es que el Hook no define una tarea: es una pieza reutilizable que varios operadores pueden compartir para acceder al mismo sistema externo sin duplicar la lógica de conexión en cada tarea.
¿Cuál es la diferencia entre Apache Airflow y Apache Spark?
Son herramientas que actúan en capas distintas y, de hecho, se complementan muy bien. Apache Spark es un motor de procesamiento distribuido que transforma grandes volúmenes de datos con alta velocidad; Apache Airflow es un orquestador que decide cuándo y cómo lanzar ese Spark (u otras herramientas). En un pipeline típico, Airflow programa y lanza los trabajos de Spark, espera a que terminen, verifica el resultado y, si todo fue bien, continúa con la siguiente etapa del flujo de datos.
Conclusión
Apache Airflow es la plataforma de orquestación que transforma una colección de scripts desconectados en un pipeline de datos controlado, monitorizable y reproducible. Su modelo basado en DAGs escritos en Python te da la flexibilidad de representar cualquier flujo de trabajo complejo con código limpio y versionable, mientras que su arquitectura modular —Scheduler, Webserver, Executor, Workers y Metastore— te ofrece visibilidad total sobre cada tarea que se ejecuta en tu sistema.
Lo más valioso que puedes llevarte de este recorrido es la distinción entre orquestación y procesamiento: Airflow no mueve datos, coordina quién los mueve y cuándo. Eso cambia completamente cómo lo piensas cuando diseñas un pipeline. Puedes empezar con un DAG sencillo de tres tareas, verlo correr en la interfaz web y, desde ahí, ir añadiendo complejidad a medida que entiendas cómo funciona cada componente en la práctica.
Si este tema despertó tu interés por la gestión y coordinación de datos a escala, en este sitio web encontrarás más contenidos sobre ingeniería de datos que te ayudarán a construir una visión completa del campo, desde los fundamentos hasta las herramientas más avanzadas que usan los equipos de datos profesionales hoy en día.
Sigue aprendiendo:
Pipeline de datos: El mecanismo que nadie te explica bien
Herramientas ETL: Elige la correcta y ahorra horas de trabajo
Apache Spark: El motor de datos que no conocías
ETL con Python: Extrae, transforma y carga datos
Diferencia entre data lake y data warehouse
Azure Data Factory (ADF): El servicio que mueve tus datos en la nube ☁️
Lakehouse: La arquitectura que unifica todo
Ingeniería en Análisis / Ciencia de Datos
