
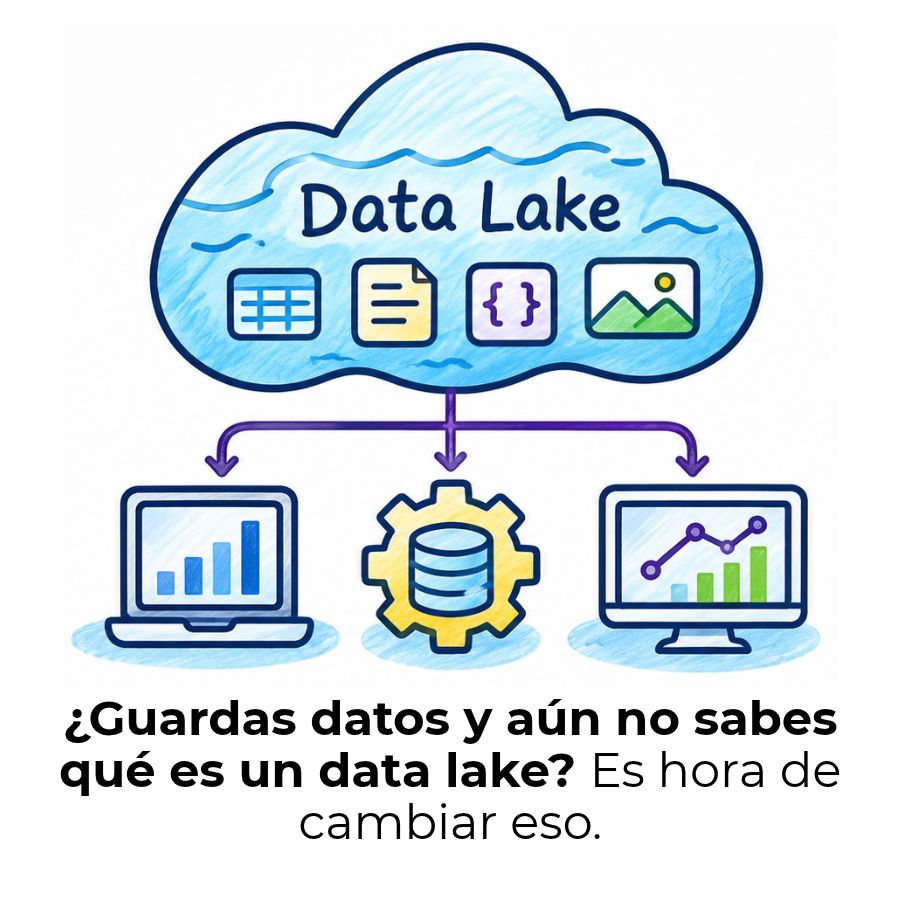
Un data lake es un repositorio centralizado que guarda grandes volúmenes de datos en su formato original, sin importar si son estructurados o no. No los procesa antes de almacenarlos: los guarda tal como llegan y los estructura solo cuando alguien los necesita.
¿Qué es un data lake?
Un data lake, o lago de datos, es un repositorio centralizado que almacena grandes volúmenes de datos en su formato original, sin importar si son estructurados, semiestructurados o no estructurados. A diferencia de otros sistemas, no impone ninguna organización previa: los datos entran tal como son y solo se estructuran cuando alguien los necesita para un análisis o proceso concreto.
La lógica detrás de este enfoque es simple pero poderosa: guardar primero, estructurar después. Eso permite conservar información que, en ese momento, puede no tener un uso claro, pero que más adelante podría ser valiosa para entrenar modelos de inteligencia artificial, detectar patrones o generar informes que hoy nadie anticipa.
El origen del término lago de datos
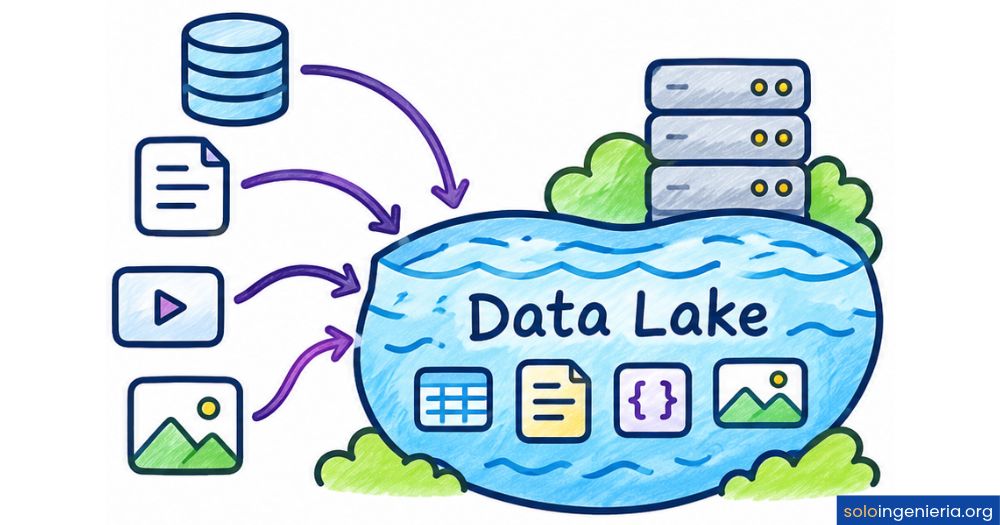
El término fue acuñado por James Dixon, director tecnológico de Pentaho, como metáfora de una gran masa de agua alimentada por múltiples ríos, donde cada río representa una fuente distinta de información. La imagen captura bien la idea: datos de orígenes muy diferentes confluyen en un mismo lugar sin que nadie los filtre ni los transforme antes de que lleguen.
El concepto surgió a finales de la primera década de los 2000 y principios de la siguiente, como respuesta a la incapacidad de los sistemas tradicionales para absorber el volumen y la variedad de datos que las organizaciones empezaban a generar. Desde entonces, la arquitectura ha evolucionado, pero la idea central se mantiene intacta.
¿Cómo se almacenan los datos en un data lake?
Cada elemento que entra en un data lake recibe un identificador único y un conjunto de etiquetas de metadatos que describen su origen, fecha, tipo y otras propiedades relevantes. No existe una tabla ni un esquema que organice los datos de antemano: el catálogo de metadatos es lo que permite encontrarlos más tarde sin que el sistema los haya reorganizado.
El almacenamiento físico suele ser plano, es decir, sin jerarquías de carpetas rígidas. Esto contrasta con los sistemas clásicos, donde los datos solo pueden entrar si encajan en una estructura predefinida. En un data lake, si el dato existe, tiene cabida.
Tipos de datos que admite un data lake
Una de las características más relevantes de un data lake es su capacidad para aceptar prácticamente cualquier tipo de dato, sin importar su formato ni su procedencia. Esto lo convierte en una solución especialmente adecuada cuando las fuentes de información son muy heterogéneas.
📊 Datos estructurados
Organizados en filas y columnas. Provienen de bases de datos relacionales, hojas de cálculo o sistemas ERP. Son los más fáciles de consultar una vez dentro del lake.
🔀 Datos semiestructurados
Tienen cierta organización interna, pero no encajan en tablas. Los archivos JSON, XML y los registros de logs son ejemplos habituales en entornos de desarrollo y producción.
🖼️ Datos no estructurados
Sin formato predefinido. Incluyen imágenes, vídeos, grabaciones de audio, correos electrónicos y publicaciones en redes sociales. Representan la mayor parte del volumen de datos generado hoy.
Esta flexibilidad es lo que distingue al data lake de soluciones más rígidas. No rechaza datos por no encajar en un molde previo: los acepta y deja que el equipo de datos decida, en el momento adecuado, qué hacer con ellos.
¿Cómo funciona un data lake por dentro?
Entender cómo opera un data lake requiere conocer el principio que rige su relación con los datos desde el primer momento en que estos entran al sistema. No se trata de un simple disco duro grande: tiene una lógica de funcionamiento específica que lo hace útil para casos de uso que otros sistemas no pueden atender.
El principio schema-on-read
Los sistemas de almacenamiento tradicionales trabajan con un esquema fijo antes de guardar cualquier dato. En un data lake ocurre lo contrario: el esquema se aplica en el momento de la lectura, no al escribir. Esto se conoce como schema-on-read y es el fundamento de toda su arquitectura.
La ventaja práctica es clara: puedes ingestar datos de cualquier origen sin preparación previa y decidir cómo interpretarlos más adelante. Si hoy no sabes exactamente para qué necesitarás ciertos registros, los guardas de todas formas. Cuando llegue el momento de usarlos, defines la estructura sobre la marcha.
Capas de un data lake moderno
Un data lake contemporáneo no es un bloque monolítico de almacenamiento. Se organiza en capas que cumplen funciones distintas y que, en conjunto, transforman datos brutos en información lista para consumir. Esta arquitectura por capas permite mantener el orden sin sacrificar la flexibilidad.
Data lake vs. data warehouse: diferencias clave
Cuando alguien se acerca por primera vez a la ingeniería de datos, es habitual confundir el data lake con el data warehouse, ya que ambos almacenan datos y sirven para el análisis. Sin embargo, parten de filosofías distintas y se adaptan mejor a situaciones diferentes.
La diferencia más profunda no está en el tamaño ni en el costo: está en cuándo se define la estructura de los datos. El data warehouse exige que los datos encajen en un esquema antes de entrar; el data lake los acepta tal como son y aplica la estructura solo cuando alguien los lee.
| Criterio | Data lake | Data warehouse |
|---|---|---|
| Tipos de datos | Estructurados, semiestructurados y no estructurados | Principalmente estructurados |
| Esquema | Schema-on-read (al leer) | Schema-on-write (al escribir) |
| Costo de almacenamiento | Bajo (almacenamiento en objetos) | Mayor |
| Usuarios típicos | Data engineers, científicos de datos | Analistas de negocio, BI |
| Procesamiento | Flexible, bajo demanda | Optimizado para consultas definidas |
| Flexibilidad | Alta: admite cualquier formato | Baja: depende del modelo previo |
| Riesgo principal | Data swamp si no se gestiona bien | Rigidez ante nuevas fuentes |
Ninguno es superior de forma absoluta. La elección depende del tipo de datos que manejas, de quién los va a consumir y de si ya sabes cómo los usarás antes de almacenarlos.
¿Para qué sirve un data lake en la práctica?
Más allá de la teoría, un data lake cobra sentido cuando lo ves funcionando en situaciones reales. Su capacidad para absorber datos de fuentes muy distintas sin preparación previa lo convierte en una pieza central para proyectos que combinan grandes volúmenes, variedad de formatos y necesidades analíticas cambiantes.
Entre los casos de uso más habituales se encuentran el entrenamiento de modelos de machine learning, el análisis de datos de sensores IoT, la detección de fraude en tiempo real, el almacenamiento histórico de logs de aplicaciones y la generación de informes de inteligencia empresarial sobre datos muy heterogéneos.
Casos de uso reales por sector
🛒 Comercio minorista
Empresas del sector integran datos de ventas, logística y comportamiento de compra para predecir demanda, optimizar inventarios y personalizar ofertas para cada cliente.
🏥 Salud
Los hospitales almacenan historiales clínicos, imágenes diagnósticas y datos de dispositivos médicos en un mismo repositorio para facilitar la investigación y mejorar los diagnósticos.
🏦 Sector financiero
Los bancos y fintechs cruzan millones de transacciones para detectar patrones de fraude, evaluar riesgos y ofrecer productos personalizados en tiempo casi real.
🏭 Industria y manufactura
Los datos de sensores en líneas de producción se almacenan en el lake para combinarlos con registros de mantenimiento y anticipar fallos antes de que ocurran.
Ventajas y limitaciones de un data lake
Como cualquier herramienta de ingeniería de datos, un data lake tiene puntos fuertes muy claros, pero también limitaciones que conviene conocer antes de decidir si es la solución adecuada para un proyecto concreto. Ignorar sus riesgos suele ser la causa de los fracasos más comunes en su implementación.
✅ Ventajas
- Escalabilidad: crece con el volumen de datos sin reestructurar el sistema.
- Flexibilidad de formato: admite cualquier tipo de dato sin preparación previa.
- Bajo costo de almacenamiento: especialmente en entornos cloud con almacenamiento de objetos.
- Preservación del dato original: los datos en bruto siempre están disponibles para reanalizarlos.
- Soporte para IA y ML: proporciona los volúmenes y la variedad que estos modelos necesitan.
⚠️ Limitaciones
- Riesgo de data swamp: sin gobernanza, el lake se convierte en un pantano de datos inutilizables.
- Curva de aprendizaje: requiere perfiles técnicos especializados para leer y transformar los datos.
- Latencia en consultas: no es óptimo para consultas muy rápidas y predecibles.
- Gestión de calidad: la ausencia de esquema previo puede derivar en datos inconsistentes si no se controla.
Herramientas y plataformas para data lakes
El ecosistema de herramientas que rodea a un data lake es amplio y está en constante evolución. Conocer las opciones más consolidadas te ayuda a entender qué tecnologías aparecen mencionadas en proyectos reales y qué rol cumple cada una dentro de la arquitectura.
- Amazon S3 (AWS): uno de los sistemas de almacenamiento de objetos más usados como capa base de un data lake en la nube, por su escala y bajo costo.
- Azure Data Lake Storage: la solución de Microsoft, especialmente integrada con el ecosistema de análisis y machine learning de Azure.
- Google Cloud Storage: la opción de Google, muy utilizada en combinación con BigQuery y Vertex AI para proyectos de analítica avanzada.
- Apache Hadoop (HDFS): el sistema de almacenamiento distribuido que fue la base de los primeros data lakes. Hoy convive con soluciones cloud más modernas.
- Databricks: plataforma que combina almacenamiento de lago con capacidades de procesamiento y gobernanza, muy adoptada en entornos de ingeniería de datos y ciencia de datos.
- Delta Lake: formato de almacenamiento de código abierto que añade transacciones ACID a los data lakes, mejorando su fiabilidad y consistencia.
El motor de procesamiento más habitual dentro de estas plataformas es Apache Spark, que permite transformar y analizar grandes volúmenes de datos distribuidos de forma eficiente, tanto en modo por lotes como en streaming.
¿Qué es un data lakehouse?
El data lakehouse es una arquitectura más reciente que surge para resolver las limitaciones tanto del data lake como del data warehouse cuando se usan por separado. Su propuesta es combinar lo mejor de ambos mundos en un único sistema que no obliga a elegir entre flexibilidad y rendimiento.
«Un data lakehouse combina el almacenamiento económico y flexible del data lake con la estructura, el gobierno y el rendimiento de consulta del data warehouse.»
En la práctica, un lakehouse almacena los datos en formatos abiertos como Delta Lake o Apache Iceberg, que permiten realizar transacciones con garantías de integridad (ACID) directamente sobre el almacenamiento de objetos. Esto significa que puedes actualizar, eliminar y versionar datos con la misma fiabilidad que en una base de datos relacional, pero sin pagar el costo de un data warehouse tradicional.
Preguntas frecuentes
¿Qué diferencia hay entre un data lake y una base de datos?
Una base de datos está diseñada para almacenar datos organizados en un esquema fijo y responder consultas concretas con rapidez. Un data lake, en cambio, no impone ningún esquema previo y acepta datos de cualquier tipo y formato. Mientras que la base de datos optimiza el acceso estructurado, el data lake prioriza la capacidad de conservar grandes volúmenes de información heterogénea para su uso futuro, muchas veces en proyectos de analítica avanzada o inteligencia artificial.
¿Un data lake requiere que los datos estén limpios para ingresarlos?
No. Esta es una de las diferencias fundamentales respecto a otros sistemas. Los datos entran en su estado original, sin pasar por ningún proceso de limpieza, transformación o validación previa. Esa tarea queda reservada para cuando alguien necesita usar esos datos, momento en el que se aplica el esquema y las transformaciones pertinentes. Esto hace que la ingesta sea más rápida y que no se descarte información por no encajar en un modelo fijo.
¿Qué lenguajes o herramientas se usan para consultar un data lake?
El lenguaje más habitual es SQL, utilizado mediante motores como Apache Hive, Presto, Amazon Athena o Google BigQuery, que permiten lanzar consultas directamente sobre el almacenamiento de objetos. Para transformaciones más complejas y procesamiento distribuido, Python con PySpark (la interfaz de Python para Apache Spark) es la opción más extendida entre los equipos de ingeniería de datos y ciencia de datos.
¿Cuándo conviene elegir un data lake en lugar de un data warehouse?
El data lake es la opción más adecuada cuando trabajas con grandes volúmenes de datos heterogéneos cuyo uso futuro aún no está completamente definido, cuando necesitas alimentar proyectos de machine learning o inteligencia artificial, o cuando tus datos incluyen formatos no estructurados como imágenes, audio o logs. Si, por el contrario, ya tienes muy claro qué preguntas quieres responder y tus datos son principalmente estructurados, el data warehouse puede ser más eficiente.
¿Qué es el schema-on-read en un data lake?
El schema-on-read es el principio por el que la estructura de los datos se define en el momento de leerlos, no cuando se almacenan. Esto significa que el data lake guarda los datos tal como llegan, sin exigir que encajen en ningún modelo previo. Cuando un analista o un proceso necesita esos datos, es entonces cuando se aplica el esquema que convierte esa información bruta en algo interpretable y útil.
¿Qué riesgos tiene un data lake mal gestionado?
El riesgo más conocido es el llamado data swamp o pantano de datos: un repositorio donde los datos entran sin catalogación, sin metadatos y sin ningún criterio de organización, hasta el punto de que nadie sabe qué hay dentro ni cómo encontrarlo. Para evitarlo, es indispensable implementar desde el inicio un catálogo de datos, políticas de gobernanza claras y procesos de calidad que aseguren que la información almacenada sigue siendo accesible y útil.
¿Qué rol tiene un data engineer en un data lake?
El data engineer es el profesional responsable de diseñar y mantener la arquitectura del data lake. Su trabajo incluye construir los pipelines que mueven los datos desde las fuentes hasta el repositorio, definir los estándares de catalogación, garantizar la calidad y la seguridad de los datos, y preparar las capas de procesamiento para que los científicos de datos y los analistas puedan trabajar con la información sin fricciones. Es, en la práctica, quien convierte el data lake en una herramienta funcional y no en un pantano.
Conclusión
Un data lake es mucho más que un gran almacén de datos. Es una arquitectura que cambia la relación entre los datos y los equipos que los usan: en lugar de obligarte a saber de antemano cómo los usarás, te permite conservarlos en su estado original y tomar esa decisión cuando realmente importa. Esa flexibilidad es su mayor fortaleza y, bien gestionada, su mayor ventaja competitiva.
A lo largo de este artículo has visto qué tipos de datos admite, cómo se organiza por capas, en qué se diferencia de un data warehouse y cuándo conviene elegir uno u otro. Con esos conceptos claros, puedes interpretar mejor cualquier arquitectura de datos que encuentres en un proyecto real y entender qué papel ocupa cada componente dentro del sistema.
Si este tema te ha abierto el apetito por seguir aprendiendo, en este sitio web encontrarás más contenido sobre ingeniería de datos, arquitecturas modernas y las herramientas que están transformando la forma en que trabajamos con la información. Hay mucho más por explorar.
Sigue aprendiendo:
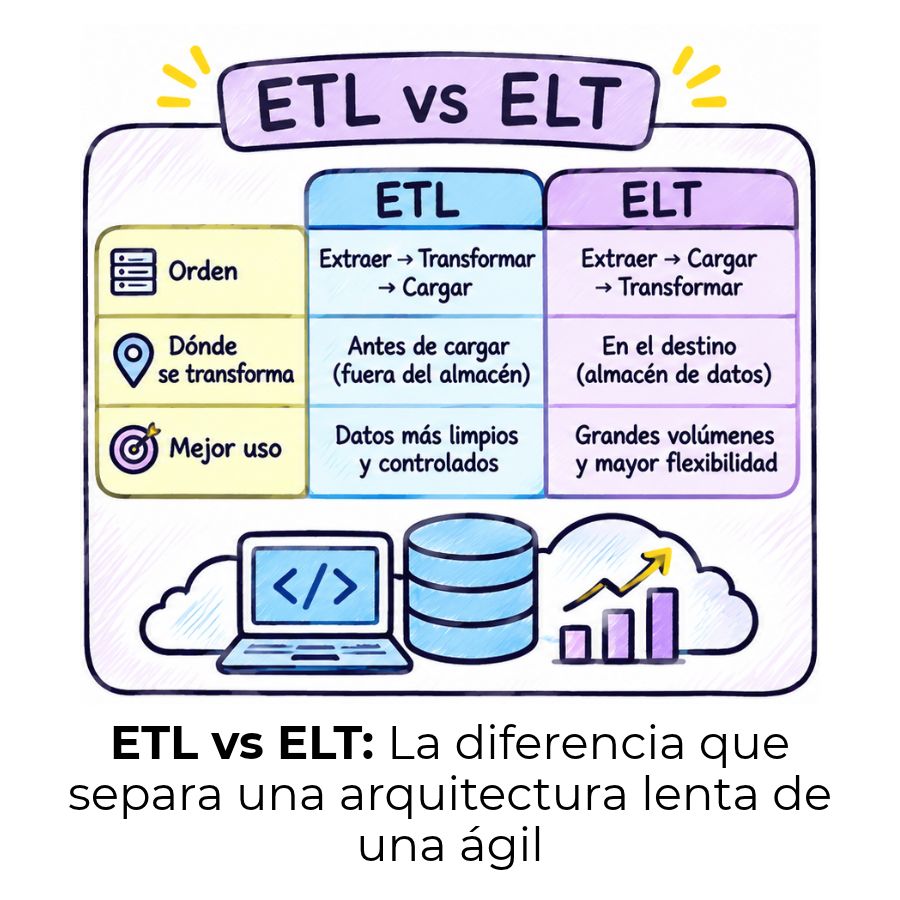
ETL vs. ELT: Transforma tus datos con la estrategia correcta
Modelado dimensional: Organiza datos para tomar mejores decisiones
¿Qué hace un ingeniero de datos?
Apache Airflow: Automatiza y controla tus flujos de datos con Python
¿Qué es un data warehouse y para qué sirve?
Data Mesh: La arquitectura que descentraliza datos
Azure Data Factory (ADF): El servicio que mueve tus datos en la nube ☁️
¿Qué es PySpark y para qué sirve?
