
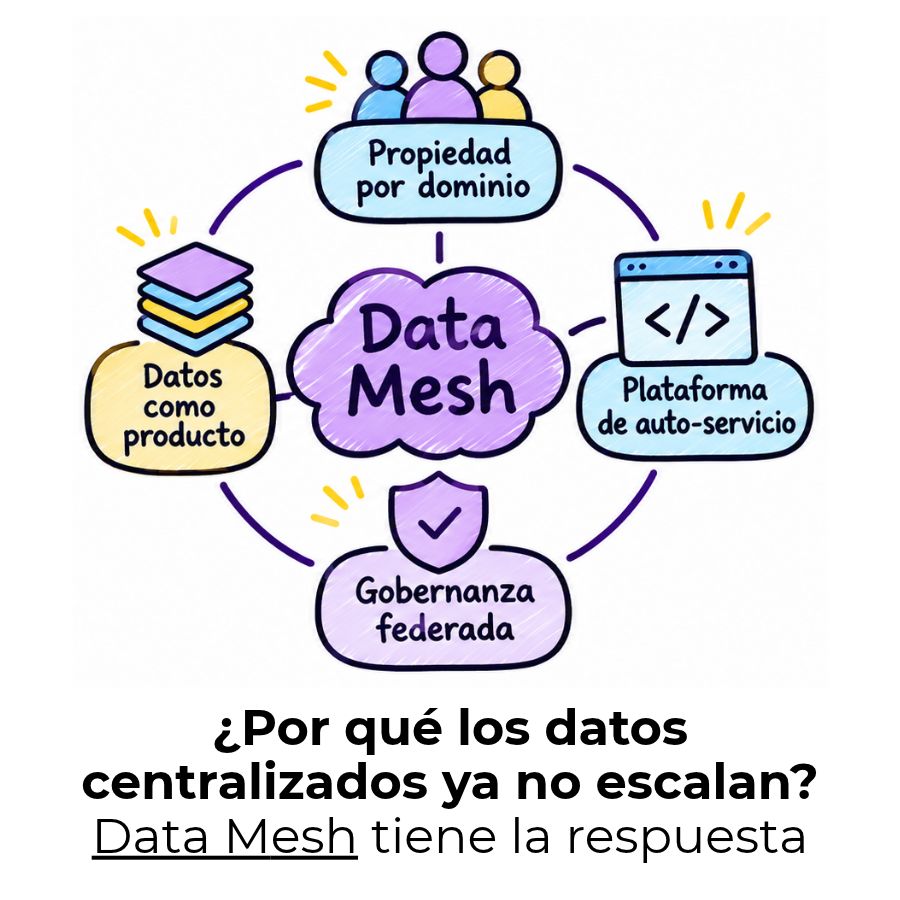
Imagina que cada área de tu empresa necesita datos para trabajar, pero todos dependen de un único equipo para obtenerlos. Ese equipo nunca da abasto. Data Mesh nació precisamente para romper ese modelo: reparte la responsabilidad, agiliza el acceso y convierte los datos en productos que cada dominio gestiona de forma autónoma.
¿Qué es Data Mesh y cómo funciona?
Data Mesh es un enfoque arquitectónico y organizativo que distribuye la responsabilidad sobre los datos entre los distintos dominios de negocio de una organización, en lugar de concentrarla en un único equipo central. Cada área, como ventas, finanzas o marketing, gestiona sus propios datos como si fueran un producto diseñado para ser consumido por otros equipos.
El término fue acuñado en 2019 por Zhamak Dehghani, ingeniera y arquitecta de software, en su artículo «Cómo pasar de un data lake monolítico a una malla de datos distribuida». Desde entonces, el concepto ha ganado tracción en organizaciones que enfrentan el reto de escalar su gestión de datos sin crear nuevos cuellos de botella.
Lo que distingue a Data Mesh de otros enfoques es que no se trata de una tecnología concreta que se instala, sino de un cambio en la forma en que una organización piensa, diseña y distribuye la responsabilidad sobre sus datos. Es, en esencia, un cambio cultural y estructural.
El problema que Data Mesh viene a resolver
Cuando una organización crece, sus datos también lo hacen, y el equipo central de datos empieza a recibir más peticiones de las que puede atender. Este cuello de botella retrasa decisiones, genera dependencias y frena la capacidad de cada área para trabajar con sus propios datos de forma ágil y autónoma.
El modelo centralizado funcionó bien durante años, pero no fue diseñado para el volumen, la velocidad ni la variedad de datos que generan las organizaciones modernas. Data Mesh surge precisamente como respuesta a esa limitación estructural, redistribuyendo tanto los datos como la responsabilidad de gestionarlos.
Definición clara de Data Mesh
Data Mesh es una arquitectura organizacional y técnica para escalar el valor del dato mediante la descentralización intencional de su propiedad, producción y consumo, donde cada dominio de negocio asume la responsabilidad de sus propios datos como productos.
Traducido a términos prácticos: en lugar de que un solo equipo gestione todos los datos de la empresa, cada área es responsable de producir, mantener y ofrecer sus datos de forma que otros puedan usarlos fácilmente. Es un cambio de paradigma que afecta tanto a la tecnología como a la cultura organizacional.
Los 4 principios del Data Mesh
Data Mesh no es un capricho técnico; su coherencia descansa en cuatro principios que definen cómo deben funcionar los datos dentro de una organización descentralizada. Estos principios no son opcionales: si se aplica solo uno de ellos, el resultado no es Data Mesh, sino una versión incompleta que no resuelve los problemas de raíz.
Propiedad de datos por dominio
El primer principio establece que cada dominio del negocio es responsable de sus propios datos durante todo su ciclo de vida: desde su generación hasta su consumo. El equipo de ventas gestiona los datos de ventas; el de recursos humanos, los de personal. Nadie depende de un intermediario para acceder a lo que ya conoce.
Esta distribución de responsabilidades no significa descontrol. Significa que quienes mejor entienden un conjunto de datos, porque trabajan con él a diario, son precisamente quienes lo gestionan. Eso reduce errores, mejora la calidad y acelera los tiempos de respuesta frente a cualquier necesidad analítica.
Datos tratados como productos
El segundo principio cambia profundamente la forma en que se conciben los datos. En lugar de ser un subproducto de los sistemas operativos, los datos se diseñan deliberadamente para ser consumidos por otros equipos. Eso implica documentación clara, calidad garantizada, formatos estables y acceso sencillo.
Un dato tratado como producto tiene un dueño que responde por él, se actualiza de forma fiable y cuenta con metadatos que permiten entender qué representa, cómo se generó y cómo usarlo. Este enfoque, tomado del diseño de productos de software, traslada el rigor del desarrollo a la gestión de datos.
Plataforma de autoservicio
Para que cada dominio pueda gestionar sus datos de forma autónoma, necesita herramientas que no requieran conocimientos altamente especializados. La plataforma de autoservicio proporciona la infraestructura compartida que permite a cualquier equipo almacenar, procesar y publicar sus datos sin depender de un equipo central de ingeniería.
Esto no significa que la plataforma sea simple, sino que abstrae la complejidad técnica. Los equipos de dominio se concentran en la lógica de sus datos, no en la infraestructura que los sustenta. La organización, por su parte, garantiza que esa infraestructura esté disponible, actualizada y sea fácil de usar.
Gobernanza federada
La descentralización sin reglas comunes genera caos. La gobernanza federada resuelve esa tensión: cada dominio tiene autonomía para gestionar sus datos, pero todos comparten un conjunto de estándares globales sobre seguridad, calidad, nomenclatura e interoperabilidad.
Este equilibrio entre autonomía local y coherencia global es lo que hace que Data Mesh sea viable a gran escala. Sin gobernanza federada, los datos de distintos dominios serían incompatibles entre sí, lo que destruiría la posibilidad de cruzarlos o combinarlos cuando el negocio lo requiera.
Arquitectura de Data Mesh: así se estructura
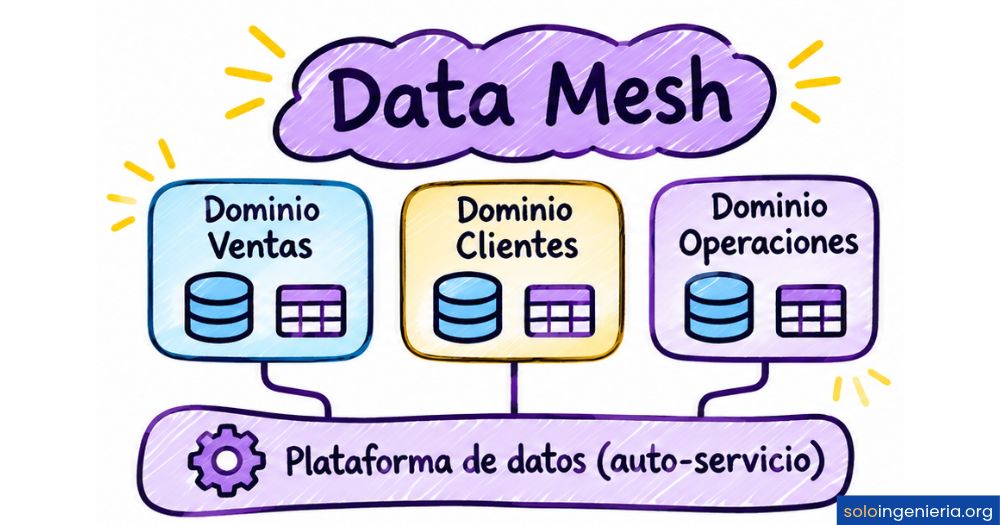
La arquitectura de Data Mesh es, en esencia, una red de dominios de datos interconectados que operan de forma autónoma pero bajo reglas comunes. No existe un repositorio único donde todo converja; en cambio, cada dominio aloja, procesa y expone sus propios datos a través de interfaces bien definidas, como APIs o catálogos de datos.
El conjunto de dominios forma una malla, de ahí el nombre. Cada nodo de esa malla es un dominio de negocio que actúa tanto como productor como consumidor de datos. Los datos fluyen entre dominios sin pasar por un punto central, lo que elimina el cuello de botella que caracteriza a los modelos tradicionales.
Componentes clave de una arquitectura Data Mesh
Dominios de datos
Áreas de negocio autónomas que producen y gestionan sus propios datos como productos.
Productos de datos
Datos diseñados para ser consumidos por otros equipos, con documentación y calidad garantizadas.
Plataforma compartida
Infraestructura de autoservicio que todos los dominios usan sin necesidad de construirla de cero.
Catálogo de datos
Inventario centralizado que facilita descubrir qué productos de datos existen y cómo acceder a ellos.
Estándares federados
Políticas globales de seguridad, calidad y nomenclatura que todos los dominios deben respetar.
APIs y contratos
Interfaces que permiten que un dominio consuma datos de otro de forma controlada e interoperable.
Un aspecto que suele generar confusión es que Data Mesh no elimina los sistemas de almacenamiento existentes. Un dominio puede seguir usando un data warehouse o un data lake internamente; lo que cambia es quién tiene la responsabilidad sobre esos datos y cómo se exponen al resto de la organización.
La ingeniería de datos juega un papel central en la construcción y el mantenimiento de esta arquitectura. Los ingenieros de cada dominio deben ser capaces de diseñar pipelines, garantizar la calidad de los datos y publicarlos de forma que otros equipos puedan consumirlos sin fricciones.
¿En qué se diferencia Data Mesh de Data Lake y Data Warehouse?
Una de las primeras dudas al acercarse a Data Mesh es entender cómo se relaciona con otros conceptos que ya existen en el ecosistema de datos. La distinción más importante no es tecnológica, sino filosófica: el modelo de responsabilidad y la forma en que los datos fluyen dentro de la organización.
| Aspecto | Data Warehouse | Data Lake | Data Mesh |
|---|---|---|---|
| Modelo de gestión | Centralizado | Centralizado | Descentralizado por dominios |
| Responsabilidad de los datos | Equipo central de datos | Equipo central de datos | Equipo de cada dominio |
| Formato de datos | Estructurados | Cualquier formato | Definido por cada dominio |
| Escalabilidad organizativa | Limitada | Media | Alta |
| Riesgo principal | Rigidez y lentitud | Pantano de datos | Fragmentación sin gobernanza |
| Concepto de dato | Recurso técnico | Recurso técnico | Producto de negocio |
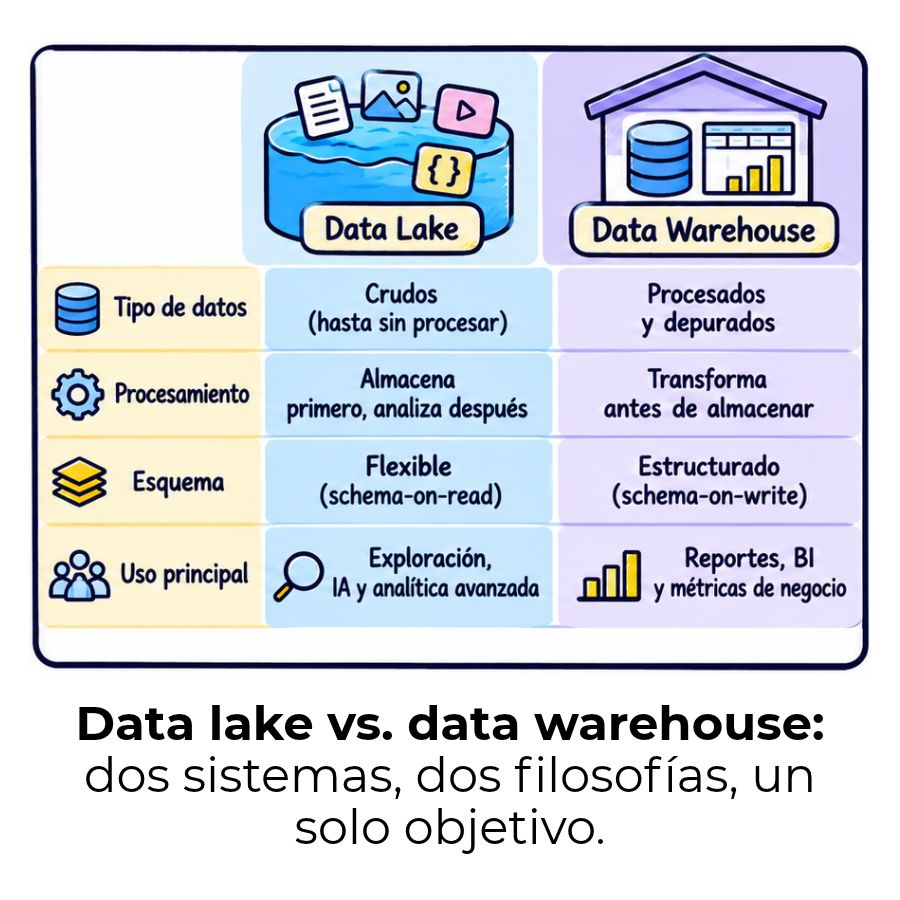
El Data Warehouse organiza datos estructurados en un repositorio único y centralizado, ideal para reporting, pero poco flexible cuando el negocio evoluciona rápido. El Data Lake amplía esa capacidad al admitir cualquier formato de dato; aunque, sin cuidado, puede convertirse en un «pantano de datos» difícil de explotar. Data Mesh no compite directamente con ninguno de ellos: redefine quién tiene la responsabilidad sobre los datos, independientemente del sistema de almacenamiento que se use.
¿Cuándo tiene sentido implementar Data Mesh?
Data Mesh no es la solución adecuada para todas las organizaciones. Implementarlo en un entorno equivocado puede añadir complejidad sin ningún beneficio real. Conviene plantearlo cuando la organización ya ha alcanzado un nivel de madurez suficiente en la gestión de sus datos y los modelos centralizados empiezan a mostrar sus límites.
¿Tu organización está lista para Data Mesh?
✅ Señales de que sí tiene sentido
- Múltiples equipos compiten por la atención del equipo central de datos
- Los datos están distribuidos en distintos sistemas y ubicaciones
- Existen equipos con capacidades técnicas propias en cada área
- La organización cuenta con dominios de negocio bien definidos
- La escalabilidad del modelo actual está alcanzando su techo
❌ Señales de que aún no es el momento
- La organización es pequeña o tiene pocos dominios diferenciados
- No existe cultura de responsabilidad sobre los datos
- Los equipos de negocio carecen de capacidades técnicas básicas
- La estructura es muy centralizada y sin voluntad de cambio
- No hay infraestructura de autoservicio disponible o planificada
Un error habitual es adoptar Data Mesh en empresas con pocos dominios o estructuras muy centralizadas, donde la descentralización no aporta valor y solo agrega complejidad. El punto de partida adecuado es identificar dos o tres dominios piloto con equipos motivados y datos bien acotados, antes de intentar una transformación total de la organización.
Conviene también destacar que Data Mesh requiere un cambio cultural profundo. Las herramientas pueden estar listas en semanas; lograr que los equipos asuman la responsabilidad plena sobre sus datos, en cambio, puede llevar meses o años. Sin esa disposición organizacional, la arquitectura técnica no produce los resultados esperados.
Ventajas y limitaciones del Data Mesh
Como cualquier enfoque arquitectónico, Data Mesh tiene beneficios concretos que lo hacen atractivo y también limitaciones que conviene conocer antes de decidir si es el camino adecuado. Entender ambos lados es la única forma de tomar una decisión informada.
Entre sus ventajas más destacadas está la capacidad de escalar la gestión de datos sin crear nuevos cuellos de botella. Además, como los dominios más cercanos al negocio gestionan sus propios datos, la calidad tiende a mejorar porque quienes los producen también son responsables de ellos. También facilita la colaboración, ya que los productos de datos están diseñados para ser accesibles por otros equipos a través de interfaces claras. Puedes aplicar principios similares de transformación y procesamiento distribuido cuando trabajas con ETL con Python, donde cada pipeline puede actuar como un micro-dominio responsable de su propia capa de datos.
Ventajas y limitaciones del Data Mesh
Ventajas
- Escalabilidad organizativa: Crece con la empresa sin necesitar un equipo central más grande.
- Mayor calidad de datos: Los expertos del dominio son quienes los gestionan.
- Acceso más ágil: Cada equipo obtiene los datos que necesita sin esperar aprobaciones.
- Autonomía real: Los dominios toman decisiones sin depender de terceros.
- Interoperabilidad: Los productos de datos son accesibles y reutilizables por otros dominios.
Limitaciones
- Alta inversión inicial: Requiere infraestructura, formación y cambio cultural.
- Riesgo de fragmentación: Sin gobernanza sólida, los datos pueden volverse inconsistentes.
- Complejidad de coordinación: Gestionar múltiples dominios exige esfuerzo organizativo.
- Madurez técnica necesaria: Los equipos de dominio deben tener capacidades de ingeniería.
- No apto para todos: En organizaciones pequeñas puede añadir complejidad sin beneficio.
La limitación más subestimada suele ser la coordinación entre dominios. Mantener la interoperabilidad cuando cada equipo toma sus propias decisiones técnicas requiere una gobernanza clara y automatizada. Sin políticas federadas bien definidas sobre seguridad, nomenclatura y metadatos, la descentralización puede producir el efecto contrario al deseado: datos incompatibles y duplicados en toda la organización.
Preguntas frecuentes
¿Qué es Data Mesh en términos simples?
Data Mesh es una forma de organizar los datos de una empresa en la que cada área de negocio, como ventas, marketing o finanzas, se hace responsable de sus propios datos en lugar de depender de un único equipo central. Los datos se tratan como productos que se diseñan, mantienen y ponen a disposición de otros equipos de forma organizada y accesible. Es un cambio de modelo, no una tecnología específica que se instala.
¿Quién creó el concepto de Data Mesh?
El concepto fue introducido en 2019 por Zhamak Dehghani, ingeniera, arquitecta de software y especialista en datos, a través de su artículo «Cómo pasar de un data lake monolítico a una malla de datos distribuida». Dehghani desarrolló el concepto como respuesta a los problemas de escalabilidad que enfrentan las organizaciones con arquitecturas de datos centralizadas, y posteriormente lo amplió en su libro Data Mesh: Delivering Data-Driven Value at Scale.
¿Cuáles son los 4 principios del Data Mesh?
Los cuatro principios son: propiedad de datos por dominio, donde cada área de negocio gestiona sus propios datos; datos como producto, donde la información se diseña para ser usada por otros equipos; plataforma de autoservicio, que permite a cada dominio trabajar de forma autónoma sin necesitar soporte técnico constante; y gobernanza federada, que combina autonomía local con estándares globales para garantizar interoperabilidad y calidad entre todos los dominios.
¿Qué diferencia hay entre Data Mesh y Data Lake?
La diferencia principal está en el modelo de responsabilidad. Un Data Lake es un repositorio centralizado donde todos los datos de la organización se almacenan en un único lugar gestionado por un equipo central, que puede volverse difícil de gobernar con el tiempo. Data Mesh, en cambio, distribuye esa responsabilidad entre los dominios de negocio, de modo que cada área gestiona y ofrece sus propios datos como productos. No son excluyentes: un dominio puede usar un data lake internamente.
¿Qué diferencia hay entre Data Mesh y Data Fabric?
Data Fabric es un enfoque que crea una capa virtual unificada sobre múltiples fuentes de datos, gestionada de forma centralizada y orientada a facilitar el acceso mediante integración técnica. Data Mesh, en cambio, descentraliza la responsabilidad y la distribuye entre los dominios de negocio, poniendo el foco en la autonomía y en tratar los datos como productos. Data Fabric se apoya más en la tecnología; Data Mesh, en la organización y la cultura de equipos.
¿Qué son los dominios en un Data Mesh?
Los dominios son las áreas de negocio que actúan como unidades autónomas dentro de la arquitectura Data Mesh. Cada dominio es responsable de producir, mantener y ofrecer sus propios datos como productos al resto de la organización. Ejemplos habituales de dominios son ventas, finanzas, marketing, recursos humanos o logística. La definición clara de los dominios es uno de los primeros pasos antes de implementar Data Mesh, y su correcta delimitación determina en gran medida el éxito del enfoque.
¿Es Data Mesh una tecnología o una metodología?
Data Mesh no es una tecnología específica que se instala ni un software que se compra. Es un enfoque organizativo y arquitectónico que combina principios de diseño orientado al dominio, gestión de producto y gobernanza federada. Se puede implementar con distintas herramientas tecnológicas, pero su éxito depende mucho más de los cambios organizativos y culturales que de las plataformas elegidas. Las herramientas habilitan el modelo; la organización lo sostiene.
¿Qué empresas utilizan Data Mesh?
Organizaciones de distintos sectores han adoptado o están explorando el modelo Data Mesh, especialmente aquellas con múltiples líneas de negocio y grandes volúmenes de datos distribuidos. Empresas como Netflix, Zalando o JPMorgan Chase han aplicado principios de Data Mesh en sus arquitecturas de datos. Sin embargo, cada organización lo adapta a su contexto, por lo que no existe una implementación única ni estandarizada del concepto.
Conclusión
Data Mesh representa un cambio de fondo en la forma de pensar sobre los datos dentro de una organización. No es una herramienta que se instala, sino un modelo que redistribuye la responsabilidad hacia quienes mejor conocen cada área del negocio. Sus cuatro principios, dominio, producto, autoservicio y gobernanza federada, forman un sistema coherente que solo funciona si se aplica de forma completa y acompañada de un verdadero compromiso organizativo.
Si te encuentras ante una organización con múltiples equipos, datos dispersos y un equipo central que ya no puede con todo, los conceptos que has aprendido aquí te dan una base sólida para evaluar si Data Mesh es el camino. Puedes comenzar identificando dos o tres dominios piloto, definir quién es responsable de cada conjunto de datos y establecer los primeros estándares compartidos de gobernanza.
El campo de la arquitectura de datos avanza rápido y hay mucho más por descubrir. En este sitio web encontrarás más contenidos sobre ingeniería de datos, arquitecturas modernas y herramientas que te ayudarán a seguir construyendo tu conocimiento con solidez y sin rodeos.
Sigue aprendiendo:
Ingeniería en Análisis / Ciencia de Datos
Diferencia entre Databricks y Snowflake
¿En qué consiste la ingeniería de base de datos?
Modelado dimensional: Organiza datos para tomar mejores decisiones
Arquitectura de datos: El secreto que mueve los datos de tu empresa
Apache Spark: El motor de datos que no conocías
Diferencia entre data lake y data warehouse
Herramientas ETL: Elige la correcta y ahorra horas de trabajo
