
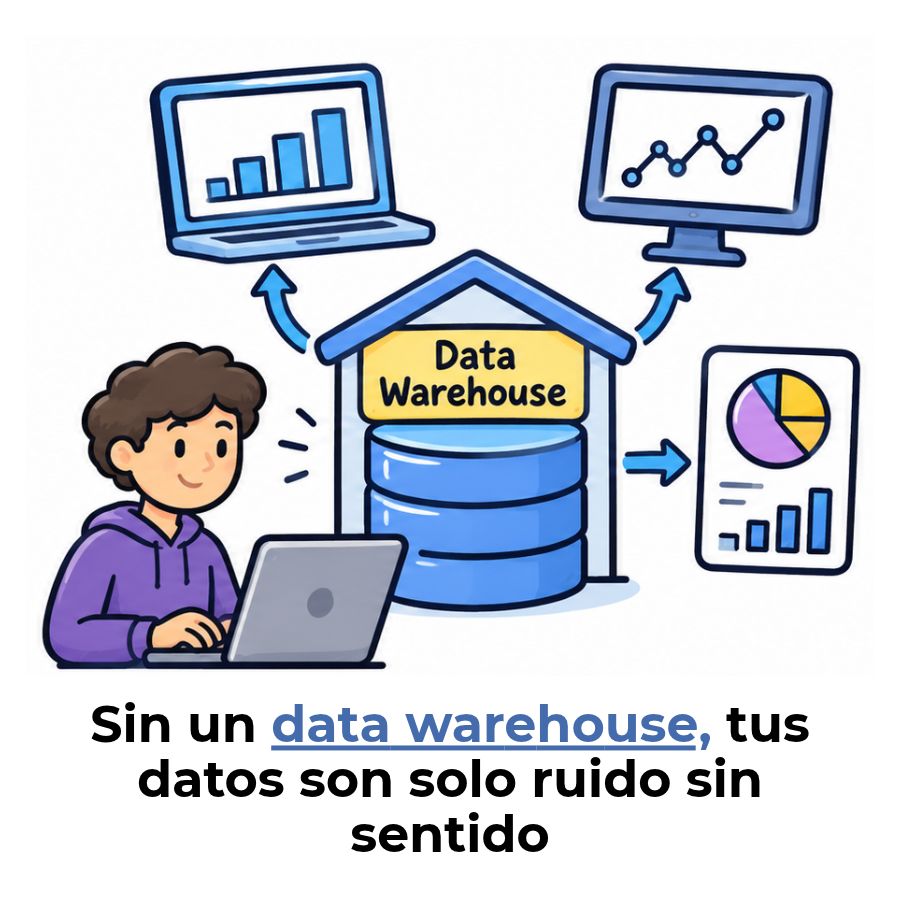
Un data warehouse es un sistema centralizado que recoge datos de múltiples fuentes, los transforma y los organiza para facilitar el análisis y la toma de decisiones. No es una base de datos operacional: su función es guardar el historial completo de la información de una organización y ponerla a disposición de quienes necesitan entenderla.
¿Qué es un data warehouse?
Un data warehouse es un sistema de almacenamiento centralizado diseñado para recopilar, integrar y organizar grandes volúmenes de datos provenientes de múltiples fuentes, con el objetivo de facilitar el análisis profundo y la toma de decisiones estratégicas dentro de una organización. No está pensado para gestionar transacciones del día a día, sino para conservar el historial completo de la información y responder preguntas complejas sobre el negocio.
Cuando trabajas con ingeniería de datos, el data warehouse es uno de los conceptos más importantes que vas a encontrar. Es la pieza que permite a analistas, científicos de datos y directivos consultar años de información consolidada sin necesidad de ir a buscarla fuente por fuente, con todo limpio, estructurado y listo para ser analizado.
Origen y significado del término
El término proviene del inglés: data significa «datos» y warehouse significa «almacén». La combinación describe exactamente lo que es: un almacén donde se guardan datos de forma organizada para que puedan ser consultados cuando se necesiten. El concepto fue formalizado por Bill Inmon en los años noventa, quien lo definió como un conjunto de datos orientado a temas, integrado, variable en el tiempo y no volátil, orientado a apoyar la toma de decisiones directivas.
Desde entonces, el data warehouse evolucionó junto con las tecnologías de almacenamiento y análisis. Lo que antes ocupaba servidores físicos en centros de datos ahora puede ejecutarse completamente en la nube, con plataformas como Amazon Redshift, Google BigQuery o Snowflake. Sin embargo, su propósito original sigue siendo el mismo: reunir datos dispersos y ponerlos a disposición del análisis de forma confiable y eficiente.
Diferencia entre dato operacional y dato analítico
Para entender bien qué es un data warehouse, primero necesitas distinguir dos tipos de datos que coexisten en cualquier organización. Los datos operacionales son los que se generan en tiempo real durante las operaciones del negocio: una venta registrada, una orden de compra enviada, un cliente actualizado en el sistema. Están pensados para el uso inmediato y cambian constantemente.
Los datos analíticos, en cambio, son ese mismo historial capturado, limpiado y organizado para ser consultado con perspectiva. No importa si un registro tiene tres años: en el contexto analítico, ese dato es valioso porque permite identificar tendencias, comparar períodos y anticipar comportamientos. El data warehouse trabaja exclusivamente con este segundo tipo de datos.
¿Cómo funciona un data warehouse?
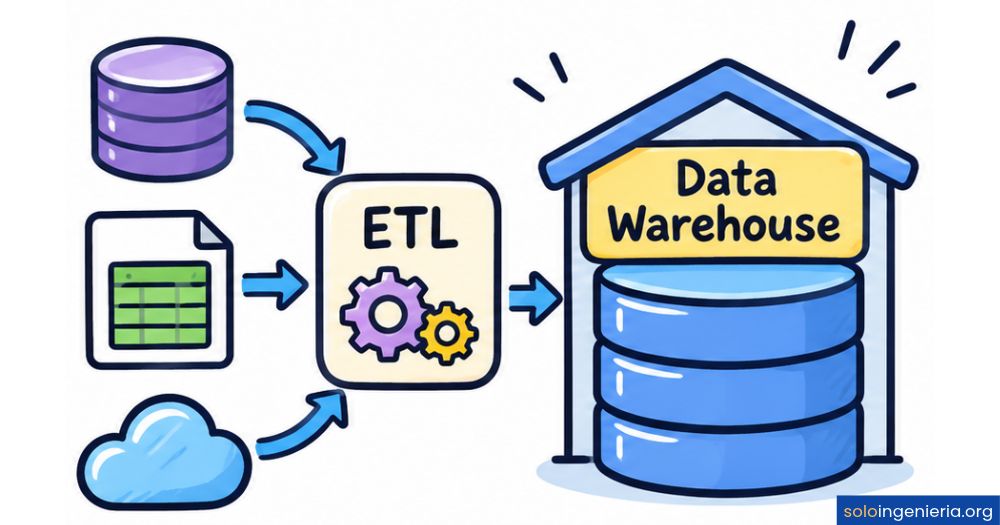
El data warehouse no recibe datos de forma directa ni instantánea. Los datos pasan por un flujo estructurado de tres etapas antes de quedar disponibles para el análisis: se extraen de los sistemas de origen, se transforman para que sean consistentes y útiles, y finalmente se cargan en el almacén central. Este proceso garantiza que la información almacenada sea confiable y esté lista para responder consultas complejas.
El proceso ETL dentro del data warehouse
El motor que alimenta un data warehouse se llama ETL, siglas en inglés de Extract, Transform, Load. Este proceso se encarga de extraer datos de los sistemas de origen, transformarlos para que tengan un formato coherente y útil, y cargarlos finalmente en el almacén central. Si ya tienes alguna noción sobre este tema, puedes profundizar en qué es ETL para entender cada etapa con mayor detalle.
La etapa más delicada del proceso es la transformación. Ahí es donde se resuelven los problemas más comunes: datos duplicados, formatos distintos entre sistemas, campos vacíos o valores inconsistentes. Sin esta limpieza, el data warehouse recibiría información contradictoria y los análisis posteriores serían poco confiables. La calidad del análisis depende directamente de la calidad de esta etapa.
Capas que forman el flujo de datos
Antes de que un dato llegue al almacén principal, pasa por una zona de staging, que es un área temporal donde se deposita la información extraída de los sistemas de origen. Funciona como una sala de espera: los datos llegan sin procesar, se inspeccionan y se preparan antes de continuar hacia el data warehouse definitivo. Esta zona ayuda a detectar errores sin afectar el entorno de producción.
Una vez dentro del data warehouse, los datos se organizan en capas según su nivel de procesamiento. Las capas más cercanas al dato original conservan el detalle completo, mientras que las capas orientadas al negocio presentan la información agrupada por temas como ventas, clientes, productos o finanzas, lista para ser consumida por herramientas de análisis o visualización.
Componentes de un data warehouse
Un data warehouse no es un solo sistema monolítico, sino un conjunto de componentes interconectados que trabajan juntos para que los datos fluyan desde su origen hasta las herramientas de análisis. Conocer cada pieza te ayuda a entender por qué el sistema es tan robusto y por qué falla cuando alguno de esos elementos no está bien configurado.
Son todas las fuentes que alimentan el data warehouse: bases de datos transaccionales, sistemas ERP, plataformas CRM, archivos CSV y conexiones a APIs externas. Pueden ser internas o externas a la organización.
La capa que extrae, transforma y carga los datos. Es el puente entre los sistemas de origen y el almacén central. Sin él, los datos llegan sucios, contradictorios e inutilizables para el análisis.
El repositorio principal donde residen todos los datos integrados, históricos y estructurados. Está optimizado para responder consultas analíticas complejas de forma eficiente, no para registrar transacciones en tiempo real.
Subconjuntos temáticos del data warehouse orientados a un área de negocio específica: ventas, finanzas, marketing. Permiten que cada equipo acceda únicamente a los datos que le son relevantes, con mejor rendimiento.
Datos sobre los datos: describen el origen, formato, significado y ubicación de cada elemento dentro del almacén. Son el índice del data warehouse y resultan clave para mantener la calidad y el gobierno del dato.
La capa de acceso final: dashboards, reportes, herramientas de visualización y motores de consulta SQL. Son la interfaz a través de la cual los usuarios interactúan con los datos almacenados en el data warehouse.
Sistemas de origen y zona de staging
Los sistemas de origen son los puntos de partida: cada base de datos transaccional, cada plataforma de gestión o cada archivo que genera datos en la organización es un candidato a ser fuente del data warehouse. El reto está en que estos sistemas utilizan formatos, estructuras y convenciones distintas, lo que hace necesaria una etapa intermedia antes de integrarlos.
La zona de staging actúa como ese espacio de tránsito. Los datos llegan aquí en crudo, sin modificar, y se inspeccionan antes de continuar. Si se detecta un problema en esta etapa, puede corregirse sin que el error llegue al almacén principal. Es una capa de protección que preserva la integridad del data warehouse frente a datos defectuosos o incompletos procedentes de los sistemas de origen.
Data marts: los almacenes temáticos
Un data mart es, en esencia, un data warehouse de alcance reducido orientado a un área de negocio concreta. Mientras el data warehouse central contiene toda la información de la organización, un data mart de ventas, por ejemplo, solo tiene los datos relevantes para el equipo comercial. Esto reduce la complejidad de las consultas y mejora el rendimiento cuando se trabaja con un dominio específico.
Los data marts pueden construirse a partir del data warehouse central, lo que los hace dependientes y consistentes entre sí, o pueden existir de forma independiente, con sus propios procesos de integración. La arquitectura más recomendada es la primera, ya que garantiza que todos los equipos partan de una única versión de la verdad, sin contradicciones entre los datos de distintos departamentos.
Metadatos: el índice del almacén
Los metadatos son frecuentemente el componente menos visible, pero uno de los más importantes. Describen cada elemento del data warehouse: de dónde viene un dato, qué formato tiene, qué significa, cuándo fue cargado y cómo se relaciona con otros campos. Sin metadatos bien gestionados, el almacén se convierte en un espacio opaco donde nadie sabe con certeza qué representa cada columna ni cuándo fue actualizada.
En la práctica, los metadatos son la base del gobierno del dato: permiten auditar el origen de la información, garantizar su calidad y detectar inconsistencias antes de que lleguen al análisis. Plataformas modernas de data warehouse incorporan catálogos de datos que automatizan la gestión de metadatos y facilitan el trabajo de los equipos de ingeniería y análisis.
Tipos de arquitectura de un data warehouse
No existe una única forma de construir un data warehouse. La arquitectura que elige una organización depende de su volumen de datos, de su presupuesto y de la complejidad de sus necesidades analíticas. Conocer los modelos más comunes te permite entender por qué algunos sistemas son más rápidos, más escalables o más costosos que otros.
| Tipo de arquitectura | Descripción | Ideal para |
|---|---|---|
| Un solo nivel | El almacén central actúa como único repositorio sin capas adicionales. Simple, pero con limitaciones de escalabilidad. | Organizaciones pequeñas con pocos sistemas de origen. |
| Dos niveles | Separa los sistemas de origen del data warehouse central. Introduce la zona de staging para preparar los datos. | Empresas medianas que necesitan aislar el entorno analítico. |
| Tres niveles | El modelo más extendido. Incluye capa de origen, zona de staging, almacén central y data marts por área de negocio. | Organizaciones grandes con múltiples equipos y departamentos. |
| Nube (cloud) | El almacén se aloja completamente en la nube. Plataformas como BigQuery, Redshift o Snowflake gestionan la infraestructura. | Empresas que buscan escalabilidad sin infraestructura propia. |
| Híbrida | Combina infraestructura local y servicios en la nube. Permite mayor control sobre datos sensibles y flexibilidad de escala. | Sectores regulados como banca, salud o administración pública. |
La arquitectura de tres niveles es la referencia en la industria porque separa claramente las responsabilidades de cada capa: los sistemas de origen generan datos, la zona de staging los prepara, el almacén central los integra y los data marts los sirven al usuario final. Esta separación facilita el mantenimiento, mejora el rendimiento y permite escalar cada capa de forma independiente.
¿Para qué sirve un data warehouse en una organización?
El data warehouse resuelve uno de los problemas más persistentes en las organizaciones: los datos existen, pero están fragmentados. Cada sistema guarda su propia versión de la información, con formatos distintos y sin conexión entre ellos. El data warehouse centraliza todo eso y lo convierte en una fuente única y confiable desde la que los equipos pueden tomar decisiones con base en evidencia real.
Uno de los beneficios más valorados en la práctica es la velocidad de respuesta. Las consultas que en un sistema operacional podrían tardar horas —porque están compitiendo con las transacciones del negocio— en un data warehouse se resuelven en segundos o minutos, ya que el almacén está diseñado y optimizado exclusivamente para ese tipo de carga analítica. Esa diferencia de rendimiento cambia por completo la experiencia del analista.
Data warehouse vs. base de datos tradicional
Esta es una de las confusiones más frecuentes cuando alguien se acerca al tema por primera vez. Tanto una base de datos como un data warehouse almacenan datos, pero están diseñados para propósitos completamente distintos y optimizados de formas diferentes. Mezclarlos o intentar usar uno en lugar del otro genera problemas de rendimiento y de calidad de la información.
| Característica | Base de datos tradicional | Data warehouse |
|---|---|---|
| Propósito | Gestionar transacciones del día a día | Facilitar el análisis histórico y estratégico |
| Tipo de datos | Datos actuales en constante cambio | Datos históricos y no volátiles |
| Consultas | Muchas consultas simples y rápidas | Pocas consultas complejas sobre grandes volúmenes |
| Fuentes | Una sola fuente o sistema | Múltiples sistemas integrados |
| Usuarios | Personal operativo (cajeros, vendedores, agentes) | Analistas, científicos de datos, directivos |
| Actualización | En tiempo real, transacción por transacción | Por lotes periódicos (diarios, semanales) |
La clave para entender la diferencia está en el tipo de pregunta que responde cada sistema. Una base de datos responde preguntas como «¿cuál es el stock actual de este producto?». Un data warehouse responde preguntas como «¿Cómo ha evolucionado el stock de esta categoría de productos en los últimos tres años y qué factores estacionales lo afectan?». Son preguntas distintas que requieren sistemas distintos.
Data warehouse vs. data lake
Si el data warehouse es el sistema de análisis por excelencia, ¿por qué existen los data lakes? La respuesta está en el tipo de dato que cada uno gestiona. Un data warehouse trabaja con datos estructurados: tablas, filas y columnas con un esquema definido. Un data lake, en cambio, puede almacenar cualquier tipo de dato sin importar su formato: imágenes, audio, texto libre, registros de sensores o datos semiestructurados como JSON o XML.
- Datos estructurados (tablas)
- Esquema definido antes de cargar
- Alta calidad y limpieza garantizada
- Consultas SQL de alto rendimiento
- Ideal para BI y reportes
- Costo mayor por almacenamiento
- Datos de cualquier tipo y formato
- Esquema definido al momento de leer
- Flexibilidad máxima en la ingesta
- Requiere procesamiento antes del análisis
- Ideal para machine learning y data science
- Costo menor por almacenamiento
Las arquitecturas modernas tienden al Data Lakehouse, que combina lo mejor de ambos enfoques.
Las arquitecturas más modernas han dado un paso adelante con el concepto de Data Lakehouse, que combina la flexibilidad de almacenamiento del data lake con las capacidades de modelado, gobierno y rendimiento analítico del data warehouse. Plataformas como Databricks o Delta Lake son ejemplos de este enfoque híbrido, que cada vez gana más adopción en organizaciones con necesidades analíticas diversas.
En la práctica, muchas organizaciones no eligen entre uno u otro, sino que usan ambos en capas complementarias: el data lake recibe y almacena datos en bruto de forma económica, y el data warehouse toma solo los datos que ya han sido procesados y estructurados para servir al análisis de negocio. Entender esta relación es fundamental para diseñar arquitecturas de datos eficientes.
Preguntas frecuentes
¿Cuál es la diferencia entre un data warehouse y un data mart?
Un data warehouse es el repositorio central que integra datos de toda la organización, mientras que un data mart es un subconjunto temático orientado a un área específica, como ventas, finanzas o marketing. El data mart extrae su información del data warehouse principal, lo que garantiza consistencia entre departamentos. La diferencia clave está en el alcance: el data warehouse abarca toda la organización y el data mart se enfoca en un dominio concreto para servir mejor a un equipo particular.
¿Qué es el proceso ETL en un data warehouse?
ETL son las siglas de Extract, Transform, Load: extraer, transformar y cargar. Es el proceso que mueve los datos desde los sistemas de origen hasta el data warehouse. La extracción recoge los datos en crudo, la transformación los limpia, unifica formatos y corrige errores, y la carga los deposita en el almacén central listos para el análisis. Si quieres profundizar en cada etapa, puedes consultar el artículo sobre qué es ETL y cómo se aplica dentro de los sistemas de ingeniería de datos.
¿Un data warehouse almacena datos en tiempo real?
En su concepción original, el data warehouse se actualiza mediante cargas periódicas en lotes: diariamente, semanalmente o con la frecuencia que defina cada organización. No está diseñado para reflejar el estado exacto del negocio en el instante presente. Sin embargo, las plataformas modernas en la nube han incorporado capacidades de ingesta en tiempo real o casi real, reduciendo la latencia de los datos disponibles para el análisis sin sacrificar la estabilidad del almacén.
¿Qué lenguaje se usa para consultar un data warehouse?
El lenguaje estándar para consultar un data warehouse es SQL (Structured Query Language). Aunque cada plataforma puede tener sus propias extensiones y funciones específicas, el SQL estándar es compatible con prácticamente todos los motores modernos de data warehouse, incluyendo BigQuery, Redshift, Snowflake y Azure Synapse. Saber escribir consultas SQL es, por tanto, una habilidad indispensable para cualquier persona que trabaje con este tipo de sistemas.
¿Cuáles son los data warehouses más usados en la industria?
Entre las plataformas más adoptadas en la industria se encuentran Google BigQuery, Amazon Redshift, Snowflake, Microsoft Azure Synapse Analytics y Databricks. Cada una tiene características, modelos de precios y casos de uso diferenciados. Snowflake destaca por su arquitectura separada de cómputo y almacenamiento; BigQuery por su modelo serverless; y Redshift por su integración profunda con el ecosistema de AWS. La elección depende del ecosistema tecnológico existente y de los volúmenes de datos que se manejen.
¿Qué es un data lakehouse y cómo se relaciona con el data warehouse?
El data lakehouse es una arquitectura moderna que combina la flexibilidad y el bajo costo de almacenamiento de un data lake con las capacidades de modelado, gobierno y rendimiento analítico de un data warehouse. Surgió para resolver las limitaciones de ambos sistemas por separado: el data lake era flexible pero difícil de gobernar, y el data warehouse era robusto pero costoso y rígido. Plataformas como Databricks con Delta Lake o Apache Iceberg son ejemplos representativos de este enfoque.
¿Qué perfil profesional trabaja con un data warehouse?
Los perfiles más directamente vinculados al data warehouse son el ingeniero de datos, responsable de diseñar y mantener los pipelines ETL y la arquitectura del almacén, y el ingeniero de data warehouse, especializado en el modelado dimensional y el rendimiento de las consultas. También trabajan con él los analistas de datos, que lo consultan para generar reportes, y los ingenieros de analytics, que construyen los modelos y dashboards sobre él. Cada rol interactúa con el sistema desde una perspectiva distinta.
Conclusión
Un data warehouse no es simplemente un lugar donde guardar datos: es el sistema que permite transformar información dispersa en conocimiento útil para tomar decisiones. Integra múltiples fuentes, garantiza la calidad de los datos a través del proceso ETL y los organiza de forma que puedan ser analizados de manera eficiente por quienes los necesitan, sin interferir con las operaciones del día a día.
A lo largo de este artículo viste qué es un data warehouse, cómo funciona internamente, cuáles son sus componentes principales, qué arquitecturas existen y en qué se diferencia de una base de datos tradicional o de un data lake. Con estos conceptos claros, puedes comenzar a identificar por qué las organizaciones que trabajan seriamente con datos construyen este tipo de infraestructuras como base de su estrategia analítica.
Si quieres seguir construyendo tu comprensión sobre este campo, en este sitio web encontrarás más contenido sobre ingeniería de datos, arquitecturas modernas y las herramientas que utilizan los profesionales que trabajan con datos a escala. Cada concepto que aprendes aquí te acerca un poco más a entender cómo funciona realmente el mundo de los datos.
Sigue aprendiendo:
Pipeline de datos: El mecanismo que nadie te explica bien
ETL con Python: Extrae, transforma y carga datos
¿Qué hace un ingeniero de datos?
¿En qué consiste la ingeniería de base de datos?
¿Qué es un data lake y cómo funciona?
Lakehouse: La arquitectura que unifica todo
Cómo ser ingeniero de datos desde cero
Ingeniero de datos vs. Científico de datos
