
Las buenas prácticas de ingeniería de datos son los principios y métodos que permiten construir pipelines confiables, escalables y fáciles de mantener. Desde la calidad de los datos hasta el control de acceso, cada decisión técnica que tomas influye directamente en si tus datos son útiles o solo aparentan serlo.
¿Qué son las buenas prácticas de ingeniería de datos?
Las buenas prácticas de ingeniería de datos son un conjunto de principios, métodos y decisiones técnicas que guían cómo se diseñan, construyen y mantienen los sistemas que mueven y procesan datos. No son reglas arbitrarias: cada una existe porque los proyectos que las ignoran terminan con pipelines frágiles, datos poco confiables y equipos que invierten más tiempo apagando incendios que construyendo soluciones.
El objetivo central de estas prácticas es garantizar que los datos lleguen al destino correcto, en el formato esperado, en el momento adecuado y con la calidad suficiente para tomar decisiones. Cuando eso se cumple, el sistema de datos deja de ser un problema y se convierte en una ventaja real para cualquier organización o proyecto personal.
¿Por qué aplicarlas marca la diferencia en tus proyectos?
Cuando trabajas sin un marco de buenas prácticas, los errores no aparecen de inmediato. Durante las primeras semanas todo parece funcionar. El problema llega después, cuando el volumen de datos crece, el equipo cambia o alguien necesita modificar una parte del sistema y no encuentra documentación alguna. En ese momento, lo que parecía eficiente se convierte en un bloqueo.
Adoptar estas prácticas desde el inicio no ralentiza el desarrollo: lo hace más predecible. Un pipeline bien diseñado, documentado y monitoreado falla menos, se corrige más rápido y escala sin reescribirse desde cero. Eso se traduce directamente en menos tiempo invertido en resolver problemas que se pudieron evitar.
Calidad de datos: la base de todo pipeline confiable
La calidad de los datos no es un paso de limpieza que se hace antes de analizar. Es una responsabilidad continua que debe estar presente en cada etapa del pipeline. Cuando los datos llegan con valores nulos donde no deberían, con duplicados o fuera del rango esperado, las consecuencias no siempre son visibles de inmediato, pero terminan afectando cada decisión que se tome a partir de ellos.
El principio es claro: los datos corruptos que avanzan sin control se propagan y contaminan las capas siguientes del sistema. Detectar un problema en la capa de ingesta cuesta mucho menos que encontrarlo semanas después en un reporte de negocio o en un modelo de aprendizaje automático ya entrenado con información incorrecta.
Controles de calidad en cada capa del pipeline
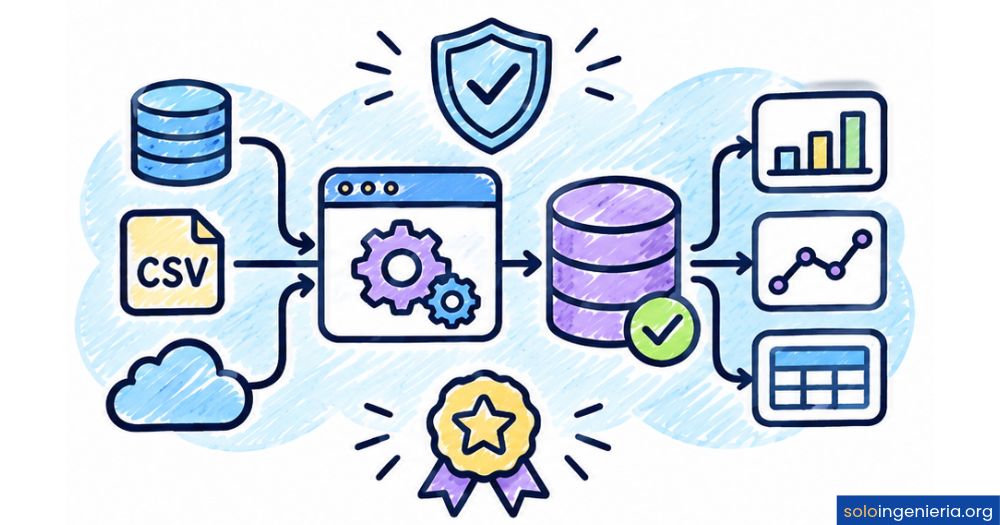
Un error habitual es colocar todos los controles de calidad en un único punto del pipeline. Lo correcto es distribuirlos a lo largo del flujo, en la capa de datos crudos (staging), después de las transformaciones y antes de publicar en la capa de consumo o data mart. Cada capa tiene sus propias reglas y lo que parece válido en una puede ser inválido en la siguiente.
¿Cómo detectar y manejar datos corruptos?
Cuando un control de calidad falla, el pipeline no debería seguir silenciosamente. La práctica correcta es detener el flujo o desviar los registros problemáticos a una cola de errores para su revisión, en vez de dejar que datos inválidos avancen hacia las capas de consumo. Esta decisión de diseño evita que un problema pequeño en la fuente se convierta en un error grave al final del proceso.
Además, los sistemas modernos permiten definir contratos de datos: acuerdos formales sobre el esquema esperado, los rangos permitidos y los umbrales de calidad entre etapas del pipeline. Cuando una fuente rompe ese contrato, el sistema lo detecta antes de que el daño se propague. Esta práctica reduce considerablemente los errores difíciles de rastrear en producción.
Diseño y arquitectura de pipelines eficientes
Antes de escribir código, las decisiones de arquitectura ya determinan si tu pipeline podrá escalar, tolerará fallos y será fácil de modificar más adelante. Elegir mal en esta etapa significa reescribir todo cuando el volumen de datos crece o cuando los requisitos cambian, algo que ocurre con más frecuencia de lo esperado en proyectos reales.
Una buena arquitectura separa claramente las responsabilidades: ingestión, transformación, almacenamiento y consumo son capas distintas. Cuando cada capa tiene un propósito único, el sistema es más fácil de probar, escalar y depurar de forma independiente. Mezclar responsabilidades en un mismo componente es una de las causas más comunes de pipelines imposibles de mantener.
Procesamiento por lotes vs. procesamiento en tiempo real
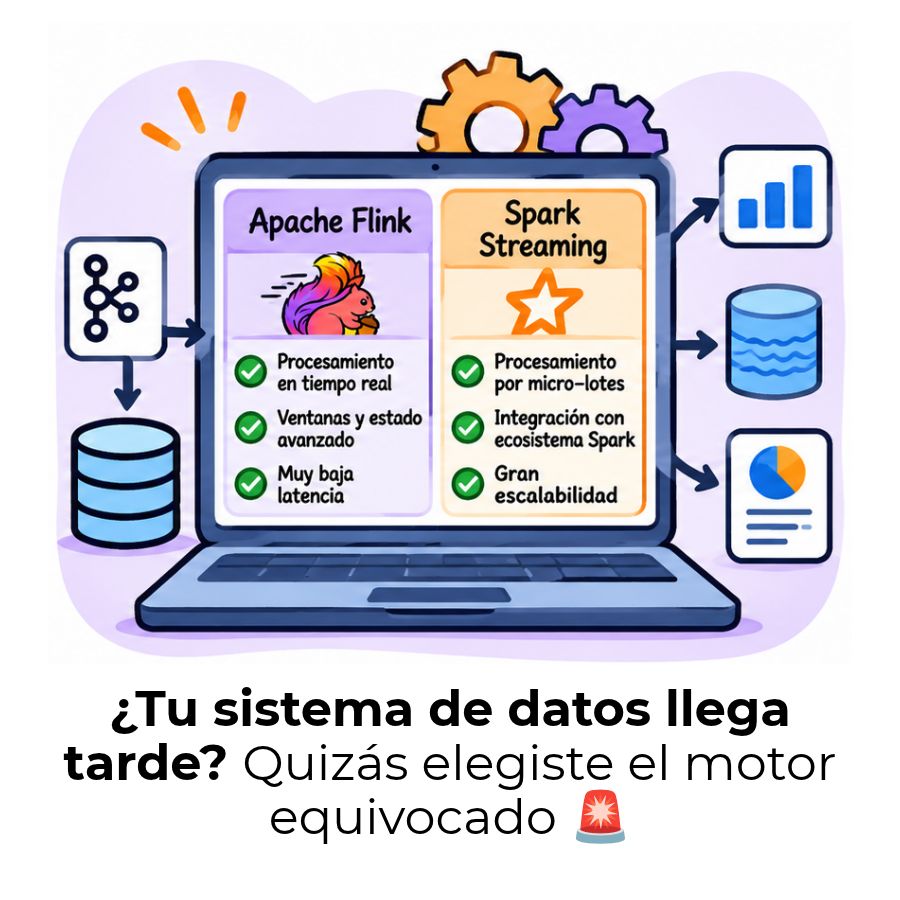
El procesamiento por lotes agrupa los datos y los procesa en intervalos programados. Es más sencillo de implementar y adecuado cuando la latencia no es crítica, como en reportes diarios o cargas nocturnas. El procesamiento en tiempo real, en cambio, maneja los datos a medida que llegan, lo que es necesario cuando se necesitan respuestas inmediatas, como en detección de fraude o alertas operativas.
Idempotencia: qué es y por qué debes aplicarla siempre
La idempotencia es la garantía de que ejecutar un pipeline varias veces con los mismos datos produce siempre el mismo resultado, sin generar duplicados ni inconsistencias. Es uno de los principios más importantes en el diseño de sistemas de datos y, al mismo tiempo, uno de los más ignorados por quienes empiezan en este campo.
Un pipeline idempotente puede fallarse y reiniciarse sin miedo: si algo sale mal en producción y necesitas volver a correr el proceso, el resultado final será el mismo que si hubiera funcionado la primera vez.
Para lograr idempotencia en la práctica, se combinan patrones de escritura que reemplazan registros en lugar de añadirlos, junto con políticas de reintento que esperan antes de volver a ejecutar tras un fallo temporal. Estas políticas reducen el impacto de interrupciones de red o caídas momentáneas de servicios externos sin que el operador tenga que intervenir manualmente.
¿Cómo documentar y versionar correctamente tus datos?
La documentación de un pipeline no es el paso final que se hace cuando todo ya funciona: es parte del proceso de construcción. Un pipeline sin documentación es un sistema que nadie puede mantener ni mejorar en el futuro, ni siquiera quien lo construyó. Cuando un compañero o tú mismo retomas el proyecto meses después, la documentación determina cuánto tiempo tardas en entender lo que hay.
Cada pipeline debería tener registrado al menos su propósito general, las fuentes de entrada, las salidas que produce, los supuestos que asume sobre los datos y sus dependencias con otros sistemas. Esto no requiere herramientas complejas; a veces un archivo en el repositorio es suficiente para evitar horas de investigación innecesaria más adelante. Si quieres profundizar en este campo, revisar los lenguajes para ser ingeniero de datos te ayudará a entender qué herramientas usar en cada contexto.
El versionado aplica tanto al código como a los propios datos. Registrar qué versión del pipeline generó qué conjunto de datos permite reproducir resultados, auditar cambios y revertir transformaciones cuando algo sale mal. Tratar los datos como si no cambiaran nunca es uno de los errores más costosos en proyectos de larga duración, y una práctica muy relacionada con el concepto de dimensiones de cambio lento, que describe cómo gestionar correctamente los cambios históricos en atributos de datos a lo largo del tiempo.
Gobernanza, seguridad y control de acceso
La gobernanza de datos define quién puede hacer qué con los datos de una organización. No es un tema exclusivo de grandes empresas: cualquier proyecto que maneje información sensible, ya sea de clientes, transacciones o métricas internas, necesita reglas claras sobre acceso, uso y modificación. Sin esas reglas, los errores humanos y las brechas de seguridad son solo cuestión de tiempo.
Una gobernanza bien implementada reduce el riesgo de accesos no autorizados, facilita el cumplimiento de regulaciones como el RGPD y deja un rastro claro de quién accedió a qué y cuándo. Los equipos que implementan gobernanza desde el inicio del proyecto tienen menos incidentes de seguridad y más capacidad de respuesta cuando algo sale mal.
Linaje de datos y trazabilidad
El linaje de datos es el registro del origen, recorrido y transformaciones que ha experimentado un dato desde que entró al sistema hasta su estado actual. Cuando un reporte muestra un valor inesperado, el linaje permite rastrear exactamente de dónde vino ese número y qué transformaciones lo modificaron, sin tener que revisar cada componente del pipeline a mano.
Contar con trazabilidad completa también es necesario para cumplir con auditorías y regulaciones que exigen demostrar el origen de la información. El linaje convierte preguntas difíciles como «¿por qué este dato es diferente al de ayer?» en investigaciones resolubles en minutos, no en días. Herramientas como OpenLineage ofrecen estándares abiertos para registrar este tipo de trazabilidad de forma interoperable.
Control de acceso basado en roles
El control de acceso basado en roles (RBAC, por sus siglas en inglés) asigna permisos según la función de cada persona en el equipo, no según su identidad individual. Un analista puede leer datos de producción, pero no modificarlos. Un ingeniero puede ejecutar transformaciones, pero no acceder a tablas que contienen información personal sin autorización explícita.
- Principio de mínimo privilegio: Cada persona o sistema accede únicamente a lo que necesita para su tarea concreta.
- Separación de entornos: Desarrollo, pruebas y producción tienen accesos separados para evitar modificaciones accidentales.
- Auditoría de accesos: Registrar quién accedió a qué datos y cuándo permite detectar comportamientos anómalos.
Monitoreo y observabilidad en pipelines de producción
Un pipeline en producción que no se monitorea es un sistema del que no sabes si está funcionando bien o no. El monitoreo te avisa cuando algo falla; la observabilidad te permite entender por qué falló. Ambos conceptos trabajan juntos: el primero alerta, el segundo explica. Sin los dos, operar un sistema de datos en producción es como conducir con los ojos cerrados.
La observabilidad en ingeniería de datos implica instrumentar el pipeline para que emita información útil sobre su propio comportamiento: cuántos registros procesó, cuánto tardó cada etapa, qué errores encontró y si los datos cumplieron las expectativas de calidad. Esa información se recoge en sistemas de monitoreo que pueden alertar al equipo antes de que un problema llegue al usuario final.
¿Qué métricas debes vigilar de forma continua?
Cuando el conteo de registros procesados cae de forma inesperada, puede indicar un problema en la fuente de datos. Cuando la latencia de una etapa sube sin motivo aparente, puede señalar un cuello de botella en el sistema de almacenamiento o en la red. Establecer umbrales de alerta para cada métrica permite actuar antes de que el problema impacte al usuario final.
Testing y automatización en ingeniería de datos
Probar el código es una práctica habitual en desarrollo de software, pero en ingeniería de datos se tiende a saltar este paso con más frecuencia. El argumento suele ser que «los datos son dinámicos y no se pueden probar como el código». Esa idea es incorrecta y costosa: los pipelines sin pruebas son los que más fallan en producción y los más difíciles de depurar cuando algo sale mal.
Probar mientras construyes, en lugar de hacerlo todo al final, reduce considerablemente el tiempo de depuración. Es más sencillo encontrar y corregir un error en un componente aislado que rastrearlo a través de un pipeline completo que ya está en producción. Esta práctica, combinada con un proceso de integración continua (CI), permite detectar regresiones cada vez que se modifica el código.
Tipos de pruebas que todo ingeniero debe conocer
- Pruebas unitarias: Verifican que un componente aislado del pipeline (una función de transformación, por ejemplo) produce el resultado esperado con entradas conocidas.
- Pruebas de integración: Comprueban que varios componentes funcionan correctamente cuando se combinan, como la conexión entre la capa de ingestión y la de transformación.
- Pruebas de calidad de datos: Validan que los datos cumplen las reglas de negocio esperadas: completitud, rangos válidos, unicidad y consistencia entre tablas.
- Pruebas de regresión: Confirman que un cambio en el pipeline no ha roto el comportamiento que ya funcionaba correctamente antes de la modificación.
- Pruebas de rendimiento: Evalúan si el pipeline mantiene tiempos de ejecución aceptables cuando el volumen de datos aumenta significativamente.
La automatización de estas pruebas dentro de un flujo de CI/CD garantiza que se ejecuten de forma automática cada vez que alguien introduce un cambio en el código. Para profundizar más en el campo de la ingeniería de datos y entender cómo encajan estas prácticas en el ecosistema completo, es útil partir desde los fundamentos del área.
Preguntas frecuentes
¿Qué es un pipeline en ingeniería de datos?
Un pipeline en ingeniería de datos es un conjunto de etapas conectadas en serie que mueven y transforman datos desde una o varias fuentes hasta un destino donde pueden ser analizados o utilizados. Cada etapa recibe los datos de la anterior, aplica una operación (filtrado, limpieza, transformación, carga) y pasa el resultado a la siguiente. La salida de una etapa es siempre la entrada de la siguiente, lo que hace que el diseño de cada componente influya directamente en la calidad y velocidad de todo el sistema.
¿Cuál es la diferencia entre ETL y ELT?
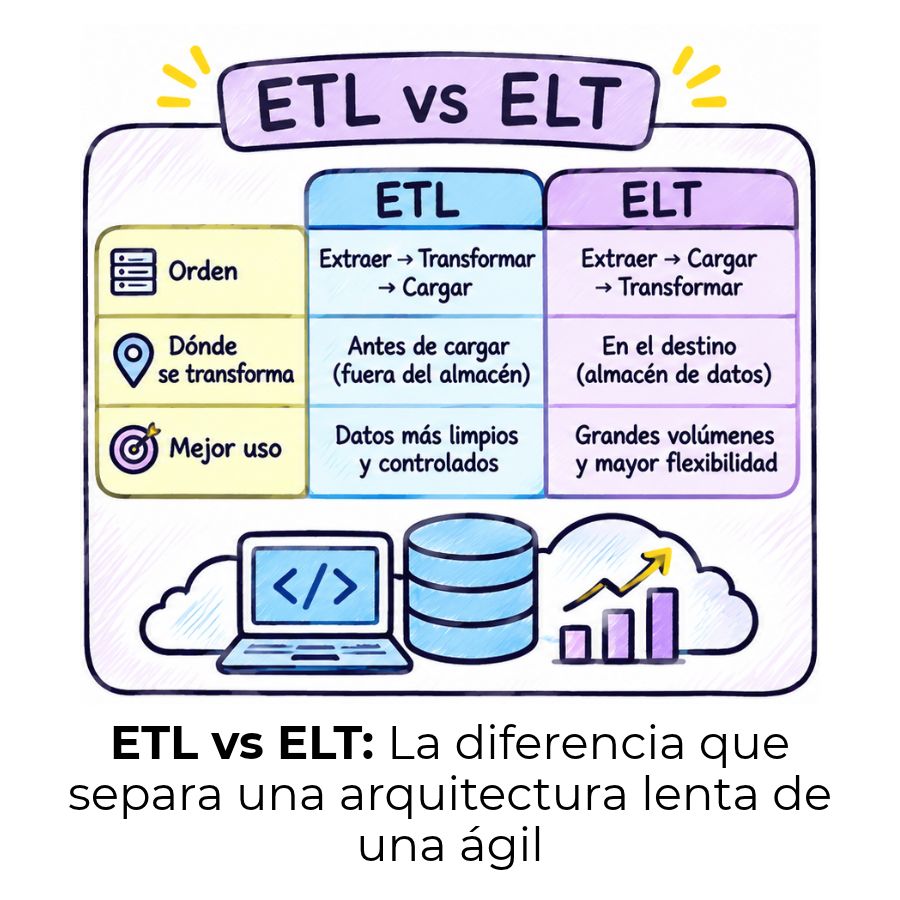
ETL (Extract, Transform, Load) extrae los datos, los transforma en un sistema intermedio y luego los carga en el destino ya limpios. ELT (Extract, Load, Transform) los carga primero en el destino, generalmente un data warehouse moderno, y realiza las transformaciones allí aprovechando su capacidad de cómputo. La diferencia práctica es el momento y el lugar donde ocurre la transformación. ELT se ha vuelto más común con plataformas en la nube que tienen suficiente potencia para transformar grandes volúmenes directamente en el almacén.
¿Cómo se garantiza la calidad de los datos en un pipeline?
La calidad de los datos se garantiza aplicando controles automáticos en múltiples puntos del pipeline: en la capa de staging, después de las transformaciones y antes de publicar en la capa de consumo. Estos controles verifican completitud, unicidad, rangos válidos, integridad referencial y frescura. Cuando un dato no pasa una validación, el pipeline debería detener el flujo o derivar el registro a una cola de errores, en lugar de permitir que información incorrecta avance y contamine el resto del sistema.
¿Qué lenguajes se usan en ingeniería de datos?
Python y SQL son los lenguajes más utilizados en ingeniería de datos. Python se usa para construir pipelines, automatizar tareas y trabajar con librerías de procesamiento de datos. SQL es el estándar para consultar y transformar datos dentro de bases de datos relacionales y data warehouses. Scala también tiene presencia en entornos que usan Apache Spark de forma intensiva. La combinación correcta depende del ecosistema de herramientas del proyecto y del tipo de datos que se manejan.
¿Qué es la idempotencia en un pipeline de datos?
La idempotencia es la propiedad de un pipeline que garantiza que ejecutarlo varias veces con los mismos datos produce siempre el mismo resultado, sin generar duplicados ni inconsistencias. Es especialmente importante cuando el pipeline falla a mitad de una ejecución y necesita reiniciarse: gracias a la idempotencia, puedes volver a correrlo con la misma entrada sin preocuparte por datos duplicados o estados intermedios corruptos en el destino final.
¿Qué es el linaje de datos y para qué sirve?
El linaje de datos es el registro detallado del origen, recorrido y todas las transformaciones que ha experimentado un dato desde que entró al sistema. Sirve para rastrear la procedencia de cualquier valor en un reporte o modelo, auditar el sistema ante regulaciones que exigen demostrar el origen de la información y depurar errores con mayor rapidez. Sin linaje, encontrar la causa de un valor inesperado puede consumir horas o días de investigación manual en un sistema de datos complejo.
¿Qué herramientas usan los ingenieros de datos hoy?
El ecosistema de herramientas para ingeniería de datos es amplio. Para orquestación de pipelines, Apache Airflow y Prefect son opciones muy usadas. Para transformación de datos, dbt (data build tool) se ha convertido en un estándar en entornos modernos. Para procesamiento a gran escala, Apache Spark sigue siendo referencia. En almacenamiento, plataformas como BigQuery, Snowflake y Databricks dominan el mercado cloud. La elección depende del volumen de datos, el presupuesto y las capacidades del equipo.
Conclusión
Las buenas prácticas de ingeniería de datos no son un lujo reservado para equipos grandes: son la diferencia entre un sistema que falla sin aviso y uno que puedes operar, mantener y mejorar con confianza. Calidad de datos, diseño cuidadoso, documentación, gobernanza, monitoreo y testing son pilares que se apoyan entre sí y que, juntos, determinan la solidez de cualquier proyecto de datos.
Puedes comenzar por los aspectos que más impacto tienen en tu proyecto actual: si tus pipelines fallan con frecuencia, prioriza el monitoreo y las pruebas. Si nadie sabe cómo funciona el sistema, empieza por documentar. Si los datos llegan con errores, implementa controles de calidad en la capa de ingestión. No es necesario aplicarlo todo a la vez; lo importante es ir construyendo sobre una base sólida.
Cada práctica que incorporas mejora no solo el sistema, sino también tu forma de pensar los problemas de datos. Este sitio web tiene más contenido sobre ingeniería de datos que puede ayudarte a seguir avanzando en este campo con claridad y sin atajos que luego cuesten caro.
Sigue aprendiendo:
Apache Flink vs. Spark Streaming
ETL vs. ELT: Transforma tus datos con la estrategia correcta
¿Qué es PySpark y para qué sirve?
¿Qué hace un ingeniero de datos?
Microsoft Fabric y Azure Synapse Analytics
Dimensiones de cambio lento: Conserva tu historial sin perder datos
¿Cómo crear tu primer DAG en Apache Airflow?
Apache Iceberg vs. Delta Lake: ¿Cuál elegir?
