
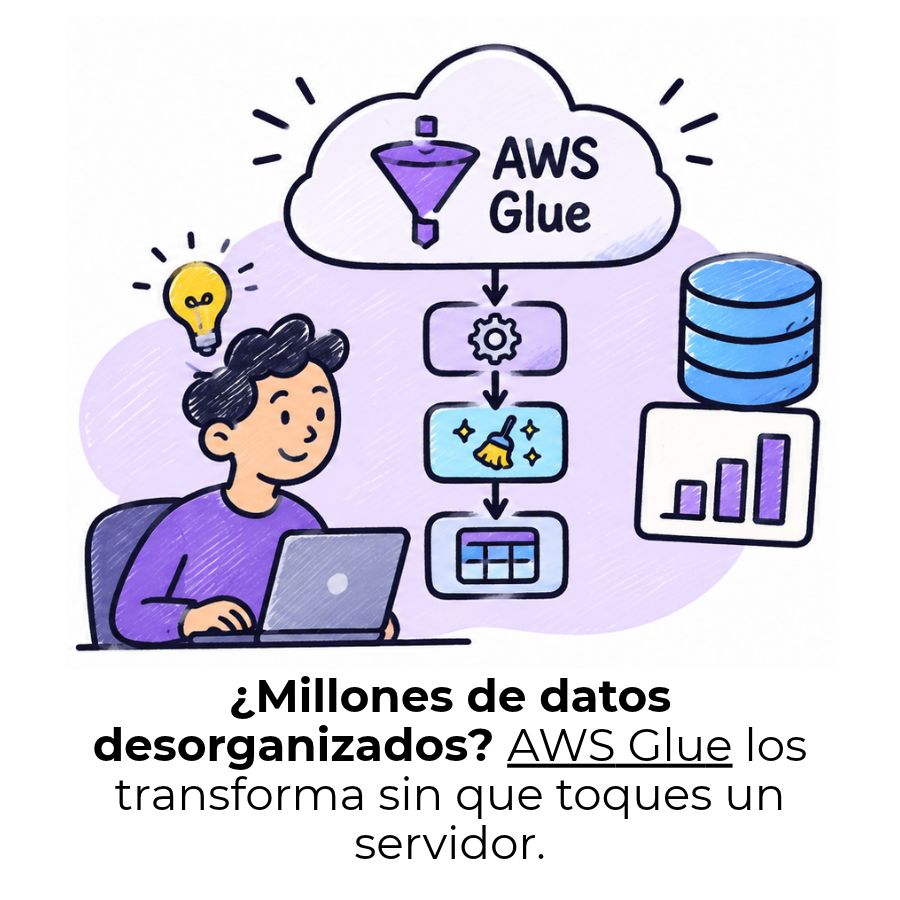
Antes de poder analizar datos, alguien tiene que limpiarlos, moverlos y darles forma. Ese trabajo invisible consume horas en cualquier proyecto. AWS Glue existe para automatizar exactamente esa parte: conecta tus fuentes de datos, las transforma y las deja listas para que tú puedas concentrarte en lo que realmente importa.
¿Qué es AWS Glue y para qué sirve?
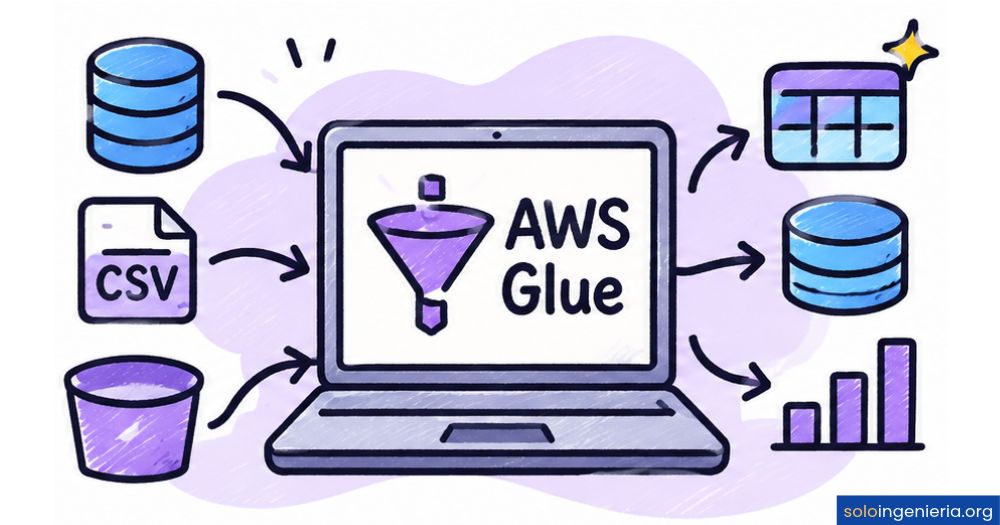
AWS Glue es un servicio administrado de integración de datos que automatiza los procesos de extracción, transformación y carga, lo que en el sector se conoce como ETL (Extract, Transform, Load). Amazon lo ofrece dentro de su nube como una solución completamente serverless, lo que significa que no necesitas aprovisionar ni mantener ningún servidor para usarlo.
Su función principal es conectar fuentes de datos heterogéneas, organizar su estructura y prepararlas para que puedan analizarse sin fricción. Puedes pensar en él como un intermediario inteligente que sabe dónde están tus datos, cómo están formados y cómo llevarlos al destino correcto en el formato adecuado.
El problema que resuelve en la integración de datos
En cualquier organización que trabaja con datos, la información raramente llega en un solo formato ni desde una sola fuente. Tienes bases de datos relacionales, archivos en almacenamiento en la nube, registros de aplicaciones y flujos en tiempo real, todos con estructuras distintas. El reto no es tener los datos, sino poder usarlos juntos de forma coherente y sin duplicar esfuerzo manual.
AWS Glue resuelve ese problema al actuar como capa de integración entre tus fuentes y tus herramientas de análisis. Detecta automáticamente qué hay en cada fuente, construye un mapa centralizado de toda esa información y ejecuta las transformaciones que definas, sin que tengas que levantar ni mantener ninguna infraestructura por tu cuenta.
Su relación con el proceso ETL
ETL son las siglas de Extract, Transform, Load: extraer, transformar y cargar. Es el proceso estándar por el que los datos pasan desde su origen hasta un destino donde pueden analizarse. Primero se extraen de las fuentes originales, luego se limpian o reformatean según las reglas del negocio, y finalmente se cargan en un data warehouse o data lake.
AWS Glue implementa ese proceso de principio a fin. Su valor diferencial frente a soluciones tradicionales es que no requiere que tú gestiones los servidores donde corren esas tareas: AWS asigna los recursos computacionales cuando los necesitas y los libera al terminar. Solo pagas por el tiempo que tus trabajos están en ejecución.
Componentes principales de AWS Glue
AWS Glue no es una sola herramienta, sino un ecosistema de piezas que trabajan juntas. Cada componente cumple una función específica dentro del ciclo de vida de un pipeline de datos. Entender qué hace cada uno es clave para saber cómo encajan en un proyecto real.
Data Catalog: el repositorio central de metadatos
El Data Catalog es el corazón de AWS Glue. Funciona como un índice centralizado donde se almacenan los metadatos de todos tus conjuntos de datos: su estructura, su ubicación, el tipo de datos que contienen y cómo están particionados. Puedes pensar en él como una biblioteca que sabe exactamente qué libro tienes, en qué estante está y qué contiene cada capítulo, sin que tengas que abrir ningún libro manualmente.
Uno de sus aspectos más útiles es que otros servicios de AWS, como Amazon Athena, Amazon Redshift Spectrum y Amazon EMR, pueden consultarlo directamente. Eso hace que todos esos servicios compartan la misma visión de tus datos, sin necesidad de duplicar definiciones ni mantener catálogos separados por cada herramienta.
Crawlers: descubrimiento automático de esquemas
Los Crawlers son los agentes que alimentan el Data Catalog. Se conectan a tus fuentes de datos, las recorren y detectan automáticamente la estructura de la información que contienen, incluyendo los tipos de columnas, los formatos de archivo y las particiones. Una vez que terminan su trabajo, registran esa estructura en el catálogo para que esté disponible de inmediato.
Lo que los hace especialmente prácticos es que pueden programarse para ejecutarse de forma periódica. Si tus datos cambian con el tiempo, el Crawler detecta esos cambios y actualiza el catálogo sin que tengas que intervenir. Compatible con formatos como CSV, JSON, Parquet, Avro, XML y la mayoría de bases de datos relacionales.
Jobs ETL: el motor de transformación
Un Job es la pieza donde ocurre la transformación real de los datos. Contiene la lógica de negocio que define cómo deben modificarse los datos antes de llegar a su destino: filtros, conversiones de tipo, uniones entre tablas, limpiezas de valores nulos o reformateos completos. AWS Glue genera automáticamente un script base en Python o Scala que puedes personalizar según tus necesidades.
Internamente, los Jobs corren sobre un entorno de Apache Spark, lo que les permite procesar grandes volúmenes de datos de forma distribuida. No tienes que configurar ese entorno: AWS lo gestiona por ti. También puedes usar AWS Glue Studio para construir el Job de forma visual, sin escribir una sola línea de código si no lo necesitas.
Triggers y Workflows: orquestación de pipelines
Los Triggers son los mecanismos que deciden cuándo se ejecuta un Job. Pueden activarse de tres formas: en un horario predefinido (tipo cron), cuando ocurre un evento determinado o bajo demanda manual. Eso te da control total sobre la frecuencia y las condiciones en que tus transformaciones se ejecutan.
Los Workflows van un paso más allá: permiten encadenar múltiples Crawlers, Jobs y Triggers en una secuencia lógica que AWS Glue trata como una sola entidad. Así puedes construir pipelines complejos de varios pasos, con dependencias entre ellos, sin tener que orquestarlos de forma manual desde fuera del servicio.
¿Cómo funciona AWS Glue?
El flujo de trabajo de AWS Glue sigue una secuencia clara y ordenada. Desde que defines una fuente de datos hasta que los datos llegan transformados a su destino, el servicio gestiona cada etapa de forma automatizada. Entender ese flujo te ayuda a ver cómo encajan todas las piezas en un proyecto real.
Conexión a la fuente de datos
Defines desde dónde quieres extraer los datos: un bucket de Amazon S3, una base de datos en RDS, una tabla en DynamoDB o un flujo de Kinesis. AWS Glue se conecta a través de los objetos de conexión del Data Catalog.
Ejecución del Crawler
El Crawler recorre la fuente, infiere el esquema de los datos y registra esa información como tablas de metadatos en el Data Catalog. Este paso es el que convierte datos «desconocidos» en datos con estructura definida y consultable.
Creación y ejecución del Job ETL
Defines el Job con la lógica de transformación. AWS Glue puede generarte un script automático como punto de partida. Al ejecutarse, Glue aprovisiona los recursos de cómputo (DPUs), corre la transformación sobre Spark y los libera al terminar.
Carga en el destino
Los datos transformados se escriben en el destino que hayas configurado: un data warehouse como Amazon Redshift, un data lake en S3 o cualquier otro servicio compatible. El Data Catalog refleja también la estructura del destino.
Monitoreo y reintentos automáticos
AWS Glue registra el estado de cada ejecución, gestiona errores y puede reintentar Jobs fallidos de forma automática. Puedes integrar los registros con Amazon CloudWatch para ver métricas y logs en tiempo real.
AWS Glue Studio: la interfaz visual sin código
AWS Glue Studio es el entorno gráfico de AWS Glue que te permite construir, ejecutar y monitorizar Jobs ETL de forma visual. En lugar de escribir código desde cero, arrastras bloques que representan fuentes, transformaciones y destinos, y los conectas entre sí para definir el flujo de tus datos. El propio servicio genera el script subyacente de forma automática.
Esta interfaz es especialmente útil cuando estás aprendiendo a usar el servicio o cuando necesitas construir un pipeline sencillo sin invertir tiempo en programación. Para casos más complejos, siempre puedes combinar la interfaz visual con la edición directa del código generado, lo que te da lo mejor de los dos enfoques.
¿Qué puedes hacer desde AWS Glue Studio?
🖱️ Editor visual de pipelines
Construye el flujo ETL arrastrando y conectando nodos sin escribir código.
📊 Monitoreo en tiempo real
Revisa el estado de cada Job directamente desde la consola, con métricas de ejecución.
🛠️ Edición del código generado
Si necesitas más control, puedes modificar directamente el script Python o Scala generado.
🔁 Reintentos y dependencias
Configura condiciones de reintento y dependencias entre Jobs directamente desde la interfaz.
¿Cuándo conviene usar AWS Glue?
AWS Glue no es la solución adecuada para todos los escenarios, y saber cuándo encaja bien marca la diferencia entre un pipeline eficiente y uno costoso o mal dimensionado. El servicio brilla especialmente en contextos donde los datos son voluminosos, provienen de múltiples fuentes y el equipo no quiere gestionar infraestructura propia.
Casos de uso más frecuentes
- Construcción de data lakes en Amazon S3: Ingestas datos de distintas fuentes, los transformas y los almacenas en S3 en un formato optimizado para análisis, como Parquet o ORC.
- Carga de datos en Amazon Redshift: Preparas y limpias datos antes de enviarlos a un data warehouse, garantizando que llegan con la calidad y el esquema que espera Redshift.
- Catalogación automática de datos: Cuando tienes grandes volúmenes de archivos sin estructura conocida y necesitas un inventario centralizado y consultable de lo que tienes.
- Pipelines de datos para machine learning: AWS Glue sirve como capa de preparación de datos antes de entrenar modelos en Amazon SageMaker, garantizando que los datos lleguen limpios y bien estructurados.
- ETL en streaming con Kinesis o Kafka: Puedes procesar flujos de datos en tiempo real aplicando transformaciones sobre los eventos a medida que llegan, sin necesidad de un sistema de batch separado.
Situaciones donde otras herramientas encajan mejor
Si tu caso implica transformaciones muy complejas que requieren un control fino sobre la configuración de Spark, puede que Amazon EMR, que te da acceso directo al clúster, sea una opción más adecuada. AWS Glue abstrae mucha de esa configuración, lo cual es una ventaja en la mayoría de los casos, pero puede ser una limitación si necesitas ajustes muy específicos del motor de procesamiento.
Para tareas de integración de datos más simples o de menor volumen, servicios como AWS Lambda o Amazon EventBridge pueden ser más económicos y menos complejos de mantener. La elección siempre depende del volumen de datos, la frecuencia de ejecución y la complejidad de las transformaciones que necesitas aplicar.
Ventajas y limitaciones de AWS Glue
Como cualquier herramienta, AWS Glue tiene puntos fuertes claros y aspectos que debes conocer antes de adoptarlo en un proyecto. Evaluar ambos lados te ayuda a tomar decisiones más informadas sobre cuándo usarlo y cuándo complementarlo con otras soluciones.
| Ventajas | Limitaciones |
|---|---|
| Serverless: sin servidores que administrar ni infraestructura que aprovisionar. | La curva de aprendizaje inicial puede ser alta para quien no tiene experiencia con Spark. |
| Escalabilidad automática desde gigabytes hasta petabytes sin configuración manual. | El tiempo de arranque de los Jobs puede ser de varios minutos, lo que lo hace menos idóneo para tareas que requieren latencia muy baja. |
| Integración nativa con más de 70 fuentes y destinos dentro del ecosistema de AWS. | El modelo de precios por DPU puede resultar costoso si los Jobs son frecuentes y de larga duración sin optimización. |
| Generación automática de código ETL en Python o Scala como punto de partida. | El control sobre la configuración del entorno Spark es más limitado que en Amazon EMR. |
| Interfaz visual en Glue Studio que permite construir pipelines sin escribir código. | Para transformaciones muy simples o de bajo volumen, puede ser una solución sobredimensionada. |
| Catálogo de datos compartido por múltiples servicios de AWS sin duplicación. | El soporte para datos en streaming, aunque disponible, es más robusto en Kinesis Data Firehose para casos sencillos. |
Integración de AWS Glue con otros servicios de AWS
Una de las razones por las que AWS Glue tiene tanto peso en proyectos de ingeniería de datos es su capacidad para conectarse de forma nativa con el resto del ecosistema de Amazon Web Services. No funciona como una isla: cada pipeline que construyes en Glue puede alimentar o consumir datos de docenas de servicios sin necesidad de conectores externos ni configuraciones complejas.
Si quieres entender qué rol ocupa AWS Glue dentro del trabajo diario de un profesional del dato, puedes profundizar en qué hace un ingeniero de datos y cómo herramientas como esta forman parte de su stack habitual.
Integraciones clave de AWS Glue con otros servicios
Amazon S3
Principal fuente y destino. Glue lee y escribe en S3 en formatos como Parquet, ORC, JSON o CSV. Es la base de la mayoría de los data lakes construidos sobre AWS.
Amazon Athena
Usa el Data Catalog de Glue para lanzar consultas SQL directamente sobre los datos en S3, sin mover ni copiar nada. Comparten el mismo inventario de tablas.
Amazon Redshift
Glue prepara y carga datos directamente en Redshift. Es el flujo clásico de un pipeline analítico: datos crudos en S3, transformación en Glue y datos limpios en Redshift.
Amazon SageMaker
Glue prepara los datos de entrenamiento antes de que lleguen a SageMaker. También puede manejar los datos de inferencia, cerrando el ciclo de los flujos de machine learning.
Amazon Kinesis y Apache Kafka
Glue Streaming ETL se conecta a Kinesis Data Streams, Kafka y Amazon MSK para aplicar transformaciones sobre datos en tiempo real sin salir del ecosistema serverless.
AWS Lake Formation
Se integra con Glue para aplicar políticas de acceso y gobernanza sobre los datos registrados en el catálogo, con permisos granulares a nivel de tabla y columna.
El campo de la ingeniería de datos se apoya cada vez más en servicios administrados como AWS Glue precisamente porque reducen la carga operativa y permiten al equipo centrarse en la lógica de negocio, no en mantener servidores. Conocer cómo encajan estas integraciones es una habilidad muy valorada en el mercado actual.
Preguntas frecuentes
¿Qué significa que AWS Glue sea serverless?
Significa que tú no tienes que aprovisionar, configurar ni mantener ningún servidor para ejecutar tus tareas ETL. Cuando lanzas un Job, AWS asigna automáticamente los recursos de cómputo necesarios, los usa durante la ejecución y los libera al terminar. Solo pagas por el tiempo que tus trabajos están corriendo, medido en unidades llamadas DPUs (Data Processing Units). Esto elimina la carga operativa de gestionar infraestructura y hace que el servicio escale de forma automática según el volumen de datos.
¿Qué lenguajes de programación usa AWS Glue?
AWS Glue genera y ejecuta scripts en Python y Scala. Cuando creas un Job, el servicio puede proponerte un script base en cualquiera de los dos lenguajes según el tipo de tarea. Python es el más usado en la comunidad de datos, especialmente a través de PySpark, que es la variante de Apache Spark para Python. Si prefieres no escribir código, AWS Glue Studio te permite construir el pipeline de forma visual y genera el código por ti de forma automática.
¿Qué es el Data Catalog de AWS Glue?
Es el repositorio centralizado donde AWS Glue almacena los metadatos de todos tus conjuntos de datos: su nombre, estructura, ubicación, tipo de datos y particiones. Funciona como un índice único que otros servicios de AWS pueden consultar directamente, incluyendo Athena, Redshift Spectrum y EMR. Hay un solo Data Catalog por cuenta de AWS en cada región, lo que garantiza una visión consistente de todos tus datos sin duplicar definiciones entre herramientas.
¿AWS Glue puede procesar datos en tiempo real?
Sí. AWS Glue ofrece Streaming ETL, que te permite aplicar transformaciones sobre datos en movimiento provenientes de Amazon Kinesis Data Streams, Apache Kafka y Amazon MSK. Funciona sobre la misma plataforma serverless que los Jobs de procesamiento por lotes, así que puedes reutilizar la lógica de transformación sin duplicar infraestructura. Para casos de streaming muy sencillos sin transformaciones complejas, Amazon Kinesis Data Firehose puede ser una alternativa más directa.
¿Cuál es la diferencia entre AWS Glue y Amazon EMR?
Ambos servicios usan Apache Spark para procesar datos, pero su enfoque es distinto. AWS Glue es serverless y administrado: no gestionas el clúster, el servicio escala solo y pagas por ejecución. Amazon EMR, en cambio, te da acceso directo al clúster de Spark, lo que permite configuraciones más avanzadas y control total sobre el entorno, pero requiere que aprovisiones y administres los nodos. Glue es la opción más cómoda para la mayoría de los pipelines ETL estándar; EMR encaja mejor cuando necesitas un ajuste muy específico del motor de procesamiento.
¿Qué es un DPU en AWS Glue?
DPU son las siglas de Data Processing Unit, la unidad de medida que usa AWS Glue para cuantificar los recursos de cómputo asignados a cada Job. Cada DPU equivale a 4 vCPUs y 16 GB de memoria RAM. Por defecto, cada Job arranca con 10 DPUs asignados, aunque puedes ajustar ese número según el volumen de datos y la velocidad que necesites. La facturación se calcula en función del número de DPUs utilizadas y el tiempo de ejecución, medido por segundo.
¿AWS Glue es gratuito o de pago?
AWS Glue es un servicio de pago por uso. No hay tarifa fija mensual: pagas únicamente por los recursos que consumes durante las ejecuciones, medidos en DPU-hora. Los Crawlers también se cobran por DPU-hora. El Data Catalog tiene una capa gratuita que cubre hasta un millón de objetos almacenados y un millón de solicitudes al mes. Para conocer los precios exactos y actualizados según tu región, puedes consultar la página oficial de precios de AWS Glue.
Conclusión
AWS Glue es la respuesta de Amazon a uno de los desafíos más comunes en proyectos de datos: mover, limpiar y transformar información de múltiples fuentes sin tener que gestionar la infraestructura que lo hace posible. Su arquitectura serverless, su catálogo centralizado de metadatos y su motor de transformación basado en Apache Spark lo convierten en una pieza fundamental dentro del ecosistema de datos en la nube de AWS.
Si aplicas lo que has aprendido aquí, puedes empezar por entender cómo se relacionan sus componentes: el Data Catalog como mapa de tus datos, los Crawlers como exploradores automáticos, los Jobs como motores de transformación y los Workflows como el hilo que lo conecta todo. Esa visión de conjunto te permitirá tomar mejores decisiones sobre cuándo y cómo usar el servicio en un proyecto real.
El mundo del dato en la nube tiene muchas más capas que explorar, y AWS Glue es solo el punto de partida. En este sitio web encontrarás más contenido sobre ingeniería de datos, herramientas de AWS y todo lo que necesitas para seguir construyendo tu conocimiento desde una base sólida.
Sigue aprendiendo:
Pipeline de datos: El mecanismo que nadie te explica bien
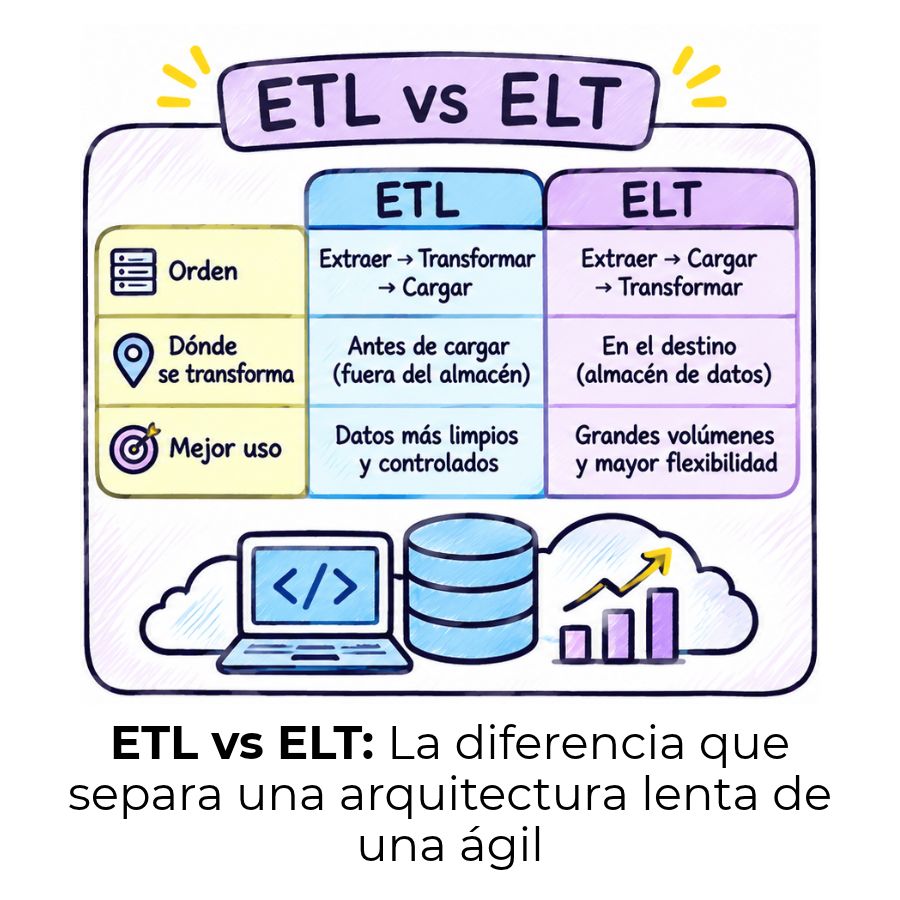
ETL vs. ELT: Transforma tus datos con la estrategia correcta
ETL con Python: Extrae, transforma y carga datos
Herramientas ETL: Elige la correcta y ahorra horas de trabajo
¿Qué es un data warehouse y para qué sirve?
¿Qué es un data lake y cómo funciona?
Data Mesh: La arquitectura que descentraliza datos
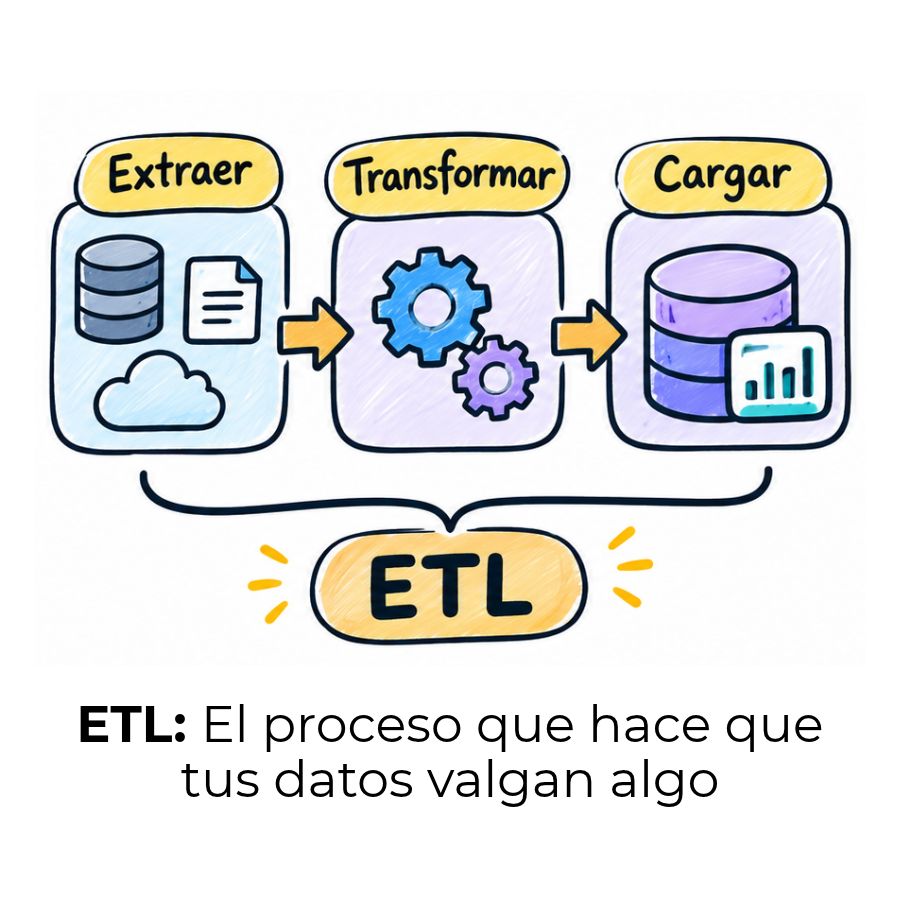
¿Qué es ETL? – Extracción, Transformación y Carga
