
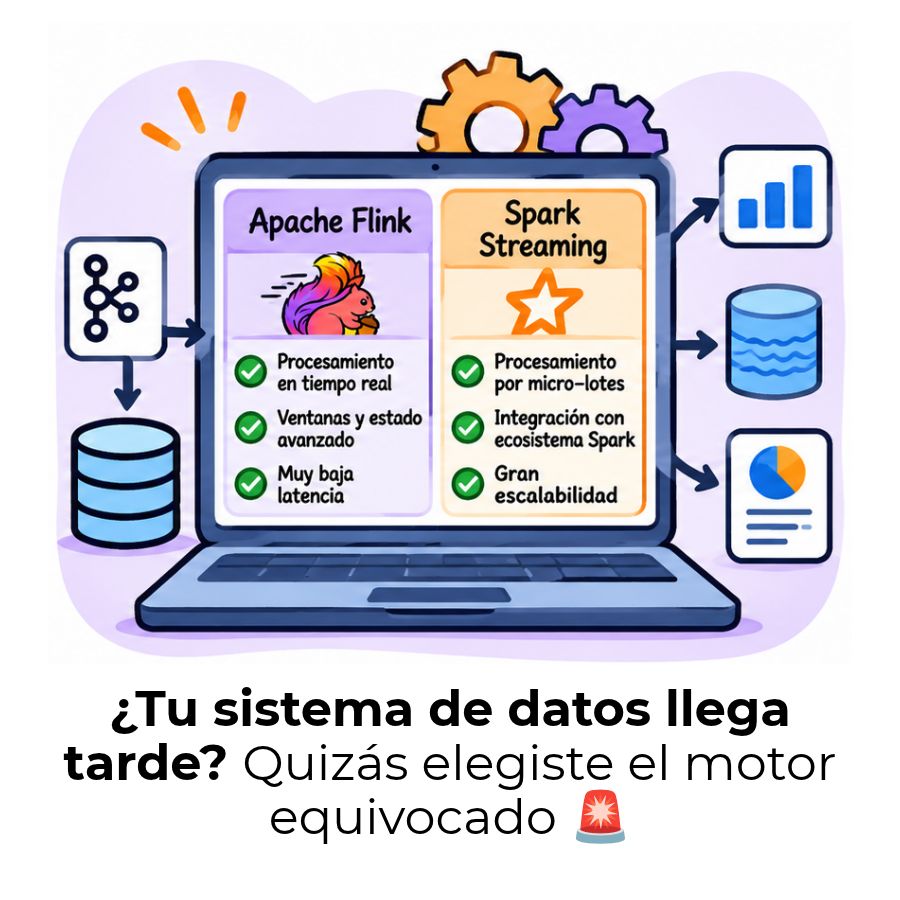
Si alguna vez has oído que Flink y Spark Streaming hacen «lo mismo», te han contado solo la mitad de la historia. Ambos procesan datos en movimiento, sí, pero la forma en que lo hacen marca una diferencia que puede definir si tu sistema responde en milisegundos o en segundos. Y ese detalle, en producción, lo cambia todo.
¿Qué son Apache Flink y Spark Streaming?
Antes de comparar, conviene tener claro qué hace cada uno. Apache Flink y Spark Streaming son motores distribuidos diseñados para procesar grandes volúmenes de datos que llegan de forma continua, como transacciones bancarias, registros de sensores IoT o eventos de usuarios en una aplicación. Los dos resuelven un problema similar, pero con filosofías de diseño muy distintas que afectan directamente al rendimiento de tu sistema.
¿Qué es Apache Flink?
Apache Flink es un motor de procesamiento de datos de código abierto que nació con el streaming como prioridad absoluta. Flink procesa cada evento en el momento exacto en que llega, sin esperar a acumular más datos. Esta arquitectura, conocida como streaming nativo o event-at-a-time, le permite alcanzar latencias muy bajas, lo que lo convierte en una opción natural para aplicaciones donde los milisegundos importan.
¿Qué es Spark Streaming?
Apache Spark es una plataforma de procesamiento distribuido que originalmente se diseñó para el análisis batch. Spark Streaming, y su evolución moderna Spark Structured Streaming, procesan los datos en pequeñas ventanas de tiempo llamadas micro-lotes. El sistema acumula eventos durante unos segundos, los agrupa y los procesa todos juntos. Es una aproximación eficaz para muchos casos, aunque introduce una latencia inherente que Flink evita por diseño.
Diferencia fundamental: streaming nativo vs. micro-batches
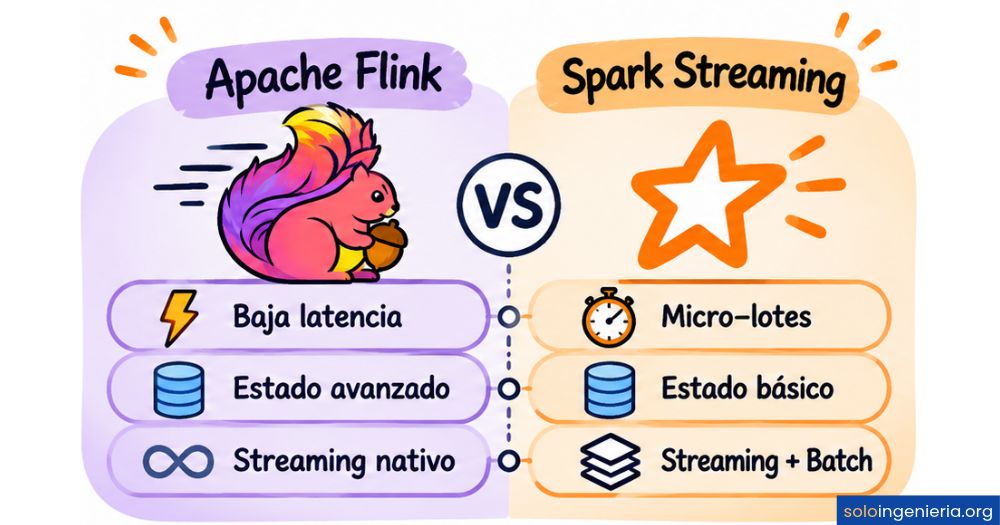
La distinción más importante entre estos dos motores no está en sus APIs ni en sus ecosistemas, sino en cómo conciben el flujo de datos desde su base. Spark Streaming parte de una idea heredada del procesamiento batch: acumula eventos durante una ventana de tiempo fija y los procesa todos juntos, como si fueran un pequeño fichero. Flink, en cambio, fue diseñado desde cero para tratar los datos como lo que son: un río continuo de eventos individuales.
Esta diferencia arquitectónica tiene consecuencias prácticas inmediatas. Con Spark, el tiempo mínimo que transcurre entre que un evento llega y que el sistema lo procesa depende del tamaño de la ventana de micro-lote, que suele rondar los 500 milisegundos como mínimo. Flink no espera: en cuanto un evento entra al sistema, el motor lo analiza, lo transforma y lo envía al destino.
- Procesa cada evento en el instante en que llega
- No existe ventana de acumulación
- La latencia depende únicamente del tiempo de cómputo
- Ideal para sistemas donde cada milisegundo cuenta
- Acumula eventos en ventanas de tiempo configurables
- Procesa el lote completo al cerrar la ventana
- Latencia mínima marcada por el tamaño del lote
- Ideal para cargas donde segundos de retraso son aceptables
Una analogía útil: imagina una cinta transportadora de fábrica. Flink inspecciona cada pieza en el momento en que pasa por el sensor, sin detener la cinta. Spark detiene la cinta cada pocos segundos, revisa todas las piezas acumuladas y las procesa juntas. El resultado final puede ser similar, pero el tiempo de reacción es radicalmente distinto.
¿Cuál tiene menor latencia, Flink o Spark Streaming?
La latencia es el tiempo que tarda un evento en ser procesado desde que entra al sistema. En la mayoría de comparativas técnicas publicadas, Flink supera a Spark Streaming de forma consistente en escenarios de baja latencia. La diferencia no es marginal: en entornos de producción reales, Flink puede alcanzar latencias por debajo de los 100 milisegundos, mientras que Spark Streaming se mueve habitualmente en un rango de entre 500 milisegundos y varios segundos.
«En procesamiento de datos en tiempo real, la latencia no es un detalle técnico menor: es el factor que decide si un sistema puede detectar fraude antes de que se complete una transacción o solo después.»
Los benchmarks más recientes muestran cifras concretas. En pruebas con Flink 1.19 y Spark 3.5 procesando volúmenes equivalentes de datos, Flink entregó latencias p99 por debajo de los 100 ms, mientras que Spark Structured Streaming operó en el rango de 2 a 5 segundos. En un benchmark con escrituras a Delta Lake, Flink 1.16 registró una latencia media de 0,81 segundos frente a más de 6 segundos en Spark 3.5. Esa brecha tiene origen directo en la arquitectura de micro-batches: Spark introduce un retraso mínimo estructural que no puede eliminarse sin cambiar el modelo de procesamiento.
Dicho esto, la latencia de Spark puede ser perfectamente aceptable en muchos contextos reales. Si tu pipeline procesa informes de ventas con actualización cada diez segundos, la diferencia entre 1 segundo y 5 segundos no tiene impacto operativo. La clave está en conocer exactamente qué exige tu caso de uso antes de elegir.
Gestión de estado: una ventaja clara de Flink
El procesamiento con estado es la capacidad de un motor para recordar información entre eventos. Por ejemplo, detectar que un usuario ha realizado cinco transacciones en diez minutos requiere mantener un contador asociado a ese usuario a lo largo del tiempo. Flink ofrece una gestión de estado nativa, robusta y muy eficiente, diseñada desde su arquitectura central. El estado se guarda en memoria con respaldo en almacenamiento persistente, y el sistema garantiza su coherencia incluso ante fallos.
Spark Structured Streaming también permite el procesamiento con estado, pero con limitaciones importantes. Las funciones de estado arbitrario en Spark aún se consideran experimentales en muchas versiones, lo que restringe los casos de uso que se pueden implementar de forma nativa sin recurrir a soluciones ad hoc o microservicios auxiliares. Para escenarios que requieren un estado grande y complejo, Flink es la opción más madura y confiable hoy.
- Nativo e integrado en el core
- Backends configurables: memoria, RocksDB
- Estado tolerante a fallos automáticamente
- Escala a terabytes de estado
- Disponible vía mapGroupsWithState
- Funciones arbitrarias en fase experimental
- Más limitado para casos de uso complejos
- Requiere configuración adicional
Un caso práctico para entender la diferencia: en la detección de fraude financiero en tiempo real, necesitas mantener el historial reciente de cada cuenta, cruzarlo con patrones de comportamiento y tomar decisiones en milisegundos. Flink permite construir este pipeline de forma directa con sus primitivas de estado integradas. Con Spark, el mismo escenario requiere más esfuerzo de implementación y, en muchos casos, arquitecturas más complejas.
Tolerancia a fallos y garantías de procesamiento
En sistemas de producción que procesan datos críticos, la tolerancia a fallos no es opcional. Un nodo que cae, una conexión de red interrumpida o un pico de carga inesperado no pueden traducirse en pérdida o duplicación de datos. Ambos motores implementan mecanismos de recuperación ante fallos, pero con enfoques y resultados distintos en cuanto a complejidad de configuración y garantías ofrecidas.
Exactly-once processing en Flink
Flink ofrece garantías de exactly-once processing de forma nativa: cada evento se procesa exactamente una vez, sin importar cuántos fallos ocurran durante la ejecución. El mecanismo detrás es el sistema de checkpointing distribuido, que toma instantáneas consistentes del estado del pipeline a intervalos regulares. Si algo falla, Flink restaura el último checkpoint y retoma el procesamiento desde ese punto, garantizando que ningún dato se pierda ni se duplique.
Exactly-once processing en Spark Streaming
Spark Structured Streaming también puede alcanzar garantías de exactly-once, pero el proceso requiere configuración adicional y depende en mayor medida de los conectores y fuentes de datos utilizados. El mecanismo de Spark se basa en el reprocesamiento de los datos ante un fallo, lo que puede introducir latencia adicional en el momento de la recuperación. Para la mayoría de los casos de uso, esto funciona bien; para sistemas donde cada milisegundo de recuperación cuenta, es una limitación a tener presente.
Ecosistema, lenguajes y curva de aprendizaje
El ecosistema que rodea a cada herramienta influye tanto en la decisión de adoptarla como en la velocidad con la que tu equipo puede empezar a ser productivo. Apache Spark cuenta con uno de los ecosistemas más maduros y completos del ámbito del Big Data. Su integración con herramientas de machine learning a través de MLlib, su soporte para SQL mediante Spark SQL y su presencia en plataformas cloud gestionadas como Databricks lo convierten en una opción con un ciclo de adopción muy corto para equipos que ya trabajan con datos.
Flink también ofrece soporte para SQL a través de Flink SQL, así como APIs en Java, Python y Scala. Sin embargo, la curva de aprendizaje de Flink es más pronunciada, especialmente cuando se trabaja con conceptos avanzados como la gestión de estado, ventanas temporales complejas o el procesamiento de eventos tardíos. Para ingenieros con experiencia en streaming, esto no representa un problema; para equipos que se acercan por primera vez al procesamiento de datos en tiempo real, Spark puede ser un punto de entrada más amable.
En cuanto a la integración con el ecosistema de ingeniería de datos moderno, ambas herramientas se conectan con Apache Kafka, sistemas de almacenamiento en la nube y bases de datos distribuidas. Flink destaca por su integración profunda con Kafka y su capacidad para actuar como consumidor de alta frecuencia sin pérdida de eventos, mientras que Spark brilla por su compatibilidad con prácticamente todo el ecosistema Hadoop y su presencia nativa en entornos cloud.
Comparativa completa: Flink vs. Spark Streaming
A continuación encontrarás un resumen estructurado de las diferencias más relevantes entre los dos motores para que puedas identificar de un vistazo cuál se adapta mejor a tu contexto. Ninguno de los dos es universalmente superior al otro: cada uno brilla en un conjunto distinto de escenarios.
| Dimensión | Apache Flink | Spark Streaming |
|---|---|---|
| Modelo de procesamiento | Streaming nativo (evento a evento) | Micro-batches (lotes por ventana) |
| Latencia típica | < 100 ms (p99) | 500 ms – 5 s (p99) |
| Gestión de estado | Nativa, robusta, escalable | Limitada, parcialmente experimental |
| Exactly-once | Nativo y por defecto | Posible con configuración adicional |
| Procesamiento batch | Soportado, menos optimizado | Excelente, origen del framework |
| Machine learning | Limitado (creciendo) | Maduro (MLlib, integración nativa) |
| Lenguajes soportados | Java, Python, SQL, Scala | Java, Python, SQL, Scala, R |
| Curva de aprendizaje | Alta (conceptos de streaming avanzado) | Media (ecosistema familiar) |
| Consumo de memoria | Menor en streaming | Mayor en streaming |
| Integración cloud | Buena (nativo en Kubernetes) | Excelente (Databricks, EMR, etc.) |
¿Cuándo elegir Apache Flink y cuándo Spark Streaming?
La decisión entre Flink y Spark Streaming no debería basarse en cuál tiene mejor reputación general, sino en qué necesita exactamente tu sistema. Tres preguntas clave pueden orientar la elección: ¿qué latencia puede tolerar tu aplicación?, ¿qué tan complejo es el estado que necesitas mantener? y ¿qué infraestructura y conocimientos tiene ya tu equipo?
Casos donde Flink es la mejor opción
Flink es la herramienta indicada cuando el tiempo de respuesta de tu sistema es un requisito crítico, no una preferencia. Si necesitas reaccionar a un evento en menos de 100 milisegundos, Flink es la opción más adecuada en el mercado actual. También destaca cuando el pipeline requiere mantener un estado complejo y persistente a lo largo del tiempo, o cuando trabajas con patrones de eventos sofisticados que necesitan análisis en tiempo real.
- Detección de fraude en tiempo real: Analiza transacciones bancarias en el momento en que ocurren, sin esperar la acumulación de un lote.
- Monitorización de infraestructuras IoT: Responde a alertas de sensores en milisegundos antes de que un fallo se propague.
- Pipelines con estado complejo: Mantiene y actualiza el contexto de cada entidad a lo largo del tiempo sin infraestructuras auxiliares.
- Procesamiento de eventos con patrones (CEP): Detecta secuencias de eventos con sus relaciones temporales con precisión nativa.
Casos donde Spark Streaming tiene ventaja
Spark Streaming, y especialmente Spark Structured Streaming, es una opción sólida cuando tu sistema ya vive dentro del ecosistema Spark. Si tu equipo ya tiene pipelines batch en Spark, integrar el procesamiento de streams en el mismo clúster reduce la complejidad operativa de forma significativa. También es preferible cuando el análisis de datos implica machine learning, exploración SQL compleja o integración con herramientas de BI.
- Cargas mixtas batch y streaming: Un solo clúster Spark gestiona los trabajos de análisis histórico y los de datos en movimiento.
- Pipelines con SQL complejo: Spark SQL es uno de los motores SQL más maduros del ecosistema distribuido.
- Machine learning sobre streams: La integración nativa con MLlib permite aplicar modelos entrenados sobre datos en movimiento.
- Equipos con experiencia previa en Spark: La curva de aprendizaje es menor y la incorporación al ecosistema existente, más rápida.
Entender este tipo de decisiones arquitectónicas se vuelve más claro cuando conoces los fundamentos de los modelos de procesamiento. Si te interesa profundizar en cómo se combinan las capas de datos en tiempo real con los datos históricos, la comparativa de la diferencia entre arquitectura Lambda y Kappa te dará una perspectiva complementaria muy valiosa para entender dónde encajan Flink y Spark dentro de un sistema de datos más amplio.
Preguntas frecuentes
¿Qué es el procesamiento de micro-batches en Spark?
El procesamiento de micro-batches es la técnica que utiliza Spark Streaming para simular el análisis de datos en tiempo real. En lugar de procesar cada evento en el momento en que llega, el sistema acumula los eventos durante una ventana de tiempo configurada, que puede ir desde fracciones de segundo hasta varios segundos, y los procesa todos juntos como si fueran un pequeño batch. Este enfoque simplifica la implementación y aprovecha las optimizaciones que Spark tiene para el procesamiento batch, pero introduce una latencia mínima estructural que no puede eliminarse, ya que el sistema debe esperar a que la ventana se cierre antes de actuar sobre los datos.
¿Por qué Flink tiene menor latencia que Spark Streaming?
Flink tiene menor latencia porque su arquitectura fue diseñada desde el principio para el streaming nativo. Cuando un evento entra al sistema, Flink lo procesa de inmediato, sin esperar a que se acumulen más eventos ni a que se cierre ninguna ventana de tiempo. El motor mantiene operadores siempre activos que reaccionan en cuanto reciben datos. Spark, al depender del modelo de micro-batches, introduce un tiempo de espera mínimo en cada ciclo de procesamiento que, por diseño, no puede reducirse a cero. Esta diferencia arquitectónica fundamental es la razón por la que Flink alcanza latencias por debajo de los 100 milisegundos en escenarios donde Spark opera en el rango de los segundos.
¿Qué es el exactly-once processing y para qué sirve?
El exactly-once processing es una garantía de procesamiento que asegura que cada evento del flujo de datos se procesa exactamente una vez, ni más ni menos, aunque ocurran fallos durante la ejecución. Sin esta garantía, un sistema puede procesar el mismo evento dos veces (at-least-once) o no procesarlo en absoluto (at-most-once), lo que genera resultados incorrectos en aplicaciones críticas. Por ejemplo, en un sistema de pagos, procesar una transacción dos veces podría significar cobrar al cliente por duplicado. Flink ofrece esta garantía de forma nativa mediante su mecanismo de checkpointing distribuido, que toma instantáneas consistentes del estado del pipeline a intervalos regulares y permite recuperarse de fallos sin pérdida ni duplicación de datos.
¿Flink es más difícil de aprender que Spark Streaming?
En términos generales, sí. Flink requiere que el profesional entienda conceptos propios del streaming avanzado que no tienen equivalente directo en el mundo batch, como la gestión de estado distribuida, el tiempo de evento frente al tiempo de procesamiento, las ventanas deslizantes o el manejo de eventos tardíos. Spark, al partir de un modelo más cercano al batch, resulta más familiar para ingenieros que ya trabajan con datos y tienen experiencia en SQL o en procesamiento distribuido convencional. Dicho esto, Flink SQL ha simplificado significativamente la adopción para casos de uso que pueden expresarse de forma declarativa, reduciendo la brecha de accesibilidad en muchos proyectos reales.
¿Pueden usarse Apache Flink y Spark al mismo tiempo?
Sí, y de hecho es una arquitectura que algunos equipos adoptan de forma deliberada. Una estrategia habitual es usar Flink para los pipelines que requieren baja latencia y estado complejo, y Spark para los trabajos de análisis batch, entrenamiento de modelos de machine learning o consultas SQL ad hoc sobre datos históricos. Ambas herramientas pueden compartir el mismo almacenamiento de datos (por ejemplo, un data lake en S3 o HDFS) y conectarse al mismo broker de mensajes como Apache Kafka. La combinación tiene sentido cuando el equipo tiene la madurez técnica para operar dos plataformas y cuando los casos de uso realmente justifican las fortalezas específicas de cada una.
¿Qué lenguajes de programación soportan Flink y Spark?
Ambas plataformas ofrecen soporte para los lenguajes más comunes en el ecosistema de datos. Apache Flink soporta Java, Python, SQL y Scala; su API de Python, conocida como PyFlink, ha madurado significativamente en las versiones recientes y cubre la mayor parte de los casos de uso habituales. Apache Spark, por su parte, soporta Java, Python, Scala, SQL y también R, lo que amplía su alcance a perfiles más orientados al análisis estadístico. En ambos casos, Flink SQL y Spark SQL permiten trabajar con streams de datos utilizando una sintaxis familiar para cualquier profesional con conocimientos básicos de bases de datos relacionales.
¿Cuál consume menos memoria, Flink o Spark Streaming?
En escenarios de procesamiento de streams, Flink tiende a ser más eficiente en el uso de memoria. El modelo de streaming nativo de Flink no necesita acumular datos en memoria para formar lotes antes de procesarlos, lo que reduce la huella de memoria en comparación con Spark, que sí requiere ese almacenamiento intermedio para su modelo de micro-batches. En estudios comparativos con cargas equivalentes, Flink mostró un consumo de memoria notablemente inferior al de Spark para el mismo volumen de datos procesados en streaming. Para cargas batch, en cambio, Spark es el motor más optimizado y eficiente, ya que ese es su dominio natural de diseño.
Conclusión
Apache Flink y Spark Streaming son dos motores poderosos para el procesamiento de datos en movimiento, pero con filosofías de diseño distintas que los hacen adecuados para contextos diferentes. La elección entre uno y otro depende de lo que tu sistema realmente necesita: Flink sobresale cuando la latencia es un requisito crítico y el estado del pipeline es complejo; Spark es la opción natural cuando necesitas uniformidad en un ecosistema batch-streaming y una curva de adopción más suave.
Con lo que has leído, ya puedes evaluar tu propio caso de uso con criterios concretos. Si tu aplicación necesita reaccionar en milisegundos, Flink es tu punto de partida. Si trabajas con cargas mixtas o ya tienes infraestructura Spark, integrar Structured Streaming puede ser la decisión más pragmática. No existe una respuesta universal: existe la respuesta correcta para tu arquitectura específica, y ahora tienes las herramientas conceptuales para encontrarla.
El campo de la ingeniería de datos evoluciona rápido y estas herramientas no son la excepción. Seguir aprendiendo sobre los fundamentos que las sostienen —cómo se diseñan las arquitecturas de datos, qué trade-offs implica cada decisión— te permitirá adaptarte a cualquier tecnología que llegue después. En este sitio web encontrarás más contenido sobre estos temas para seguir construyendo tu base técnica paso a paso.
Sigue aprendiendo:
AWS Glue: El secreto detrás de los grandes pipelines de datos
Procesamiento de datos en tiempo real
100 preguntas de entrevista para ingeniero de datos
Sueldo de un ingeniero de datos: ¿Cuánto gana?
¿Qué es un data warehouse y para qué sirve?
Ingeniero de datos vs. Científico de datos
Certificaciones para ingeniero de datos
DataOps: El enfoque que rompe los silos entre datos y equipos
