
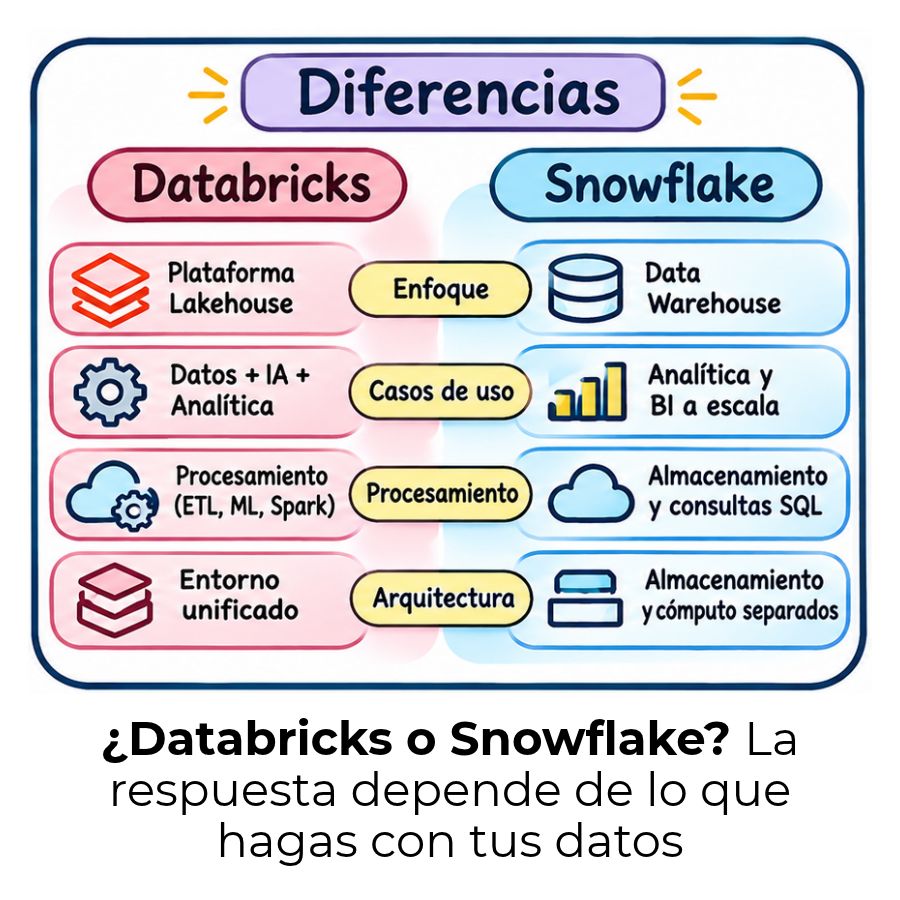
Databricks y Snowflake son dos plataformas de datos en la nube que, aunque parecen similares, tienen propósitos distintos. Databricks está orientado al procesamiento masivo de datos y al machine learning; Snowflake, al almacenamiento estructurado y las consultas analíticas. Saber cuándo usar cada una marca una diferencia real en tu trabajo.
¿Qué son Databricks y Snowflake?
Antes de comparar, conviene entender qué hace cada plataforma por separado. Databricks y Snowflake son soluciones de datos en la nube, pero nacieron con objetivos distintos y sirven a perfiles técnicos diferentes. Conocer su punto de partida es la mejor forma de entender por qué sus diferencias importan tanto en la práctica.
¿Qué es Databricks y en qué se basa su arquitectura?
Databricks es una plataforma de datos y de inteligencia artificial fundada en 2013 por los creadores de Apache Spark, el motor de procesamiento distribuido de código abierto más usado en ingeniería de datos a gran escala. Su propósito original fue hacer que Spark fuera más accesible y manejable para equipos técnicos que necesitaban procesar enormes volúmenes de datos.
Con el tiempo, Databricks evolucionó hacia lo que hoy llama una plataforma lakehouse unificada: un entorno que combina la flexibilidad de un data lake con la capacidad analítica de un data warehouse. Desde esa arquitectura, puedes ejecutar pipelines de datos, construir modelos de machine learning y hacer análisis, todo dentro del mismo sistema.
¿Qué es Snowflake y cómo almacena los datos?
Snowflake es una plataforma de datos en la nube fundada en 2012, diseñada desde el principio como un data warehouse cloud-native. Su objetivo fue resolver un problema concreto: separar el almacenamiento del cómputo para que las organizaciones pudieran escalar cada capa de forma independiente sin pagar por recursos que no usan.
A diferencia de los sistemas tradicionales, Snowflake gestiona toda la infraestructura por ti. No necesitas configurar servidores ni optimizar clústeres; simplemente conectas tus datos, escribes SQL y la plataforma se encarga del resto. Eso la convierte en una opción muy popular entre analistas de datos y equipos de Business Intelligence.
¿Cuál es la diferencia principal entre Databricks y Snowflake?
La diferencia fundamental está en la filosofía de diseño. Databricks nació para procesar datos a escala industrial y construir modelos de inteligencia artificial, mientras que Snowflake nació para almacenar y consultar datos estructurados de forma rápida y sin fricción. No son plataformas equivalentes que hacen lo mismo de manera distinta: resuelven problemas diferentes en el ciclo de vida del dato.
En términos prácticos, Databricks trabaja mejor cuando tus datos son complejos, variados o requieren transformaciones profundas antes de ser útiles. Snowflake brilla cuando los datos ya están limpios y organizados, y lo que necesitas es consultarlos con rapidez para tomar decisiones de negocio. Esa distinción guía casi todas las decisiones técnicas que se derivan de elegir entre una plataforma u otra.
| Dimensión | Databricks | Snowflake |
|---|---|---|
| Propósito original | Procesamiento masivo, ML e IA | Data warehouse y analítica SQL |
| Arquitectura | Lakehouse (formato abierto) | Data warehouse cloud-native |
| Motor de procesamiento | Apache Spark + motor Photon | Virtual warehouses propios |
| Tipos de dato | Estructurados, semiestructurados y no estructurados | Estructurados y semiestructurados |
| Lenguajes soportados | Python, SQL, Scala, R | SQL principalmente (Snowpark para Python) |
| Gobernanza | Unity Catalog | Snowflake Horizon |
| Facilidad de uso | Curva de aprendizaje más pronunciada | Muy accesible para perfiles SQL |
| Caso ideal | Ingeniería avanzada, pipelines, ML | BI, reportes, analítica estructurada |
Arquitectura: lakehouse vs. data warehouse
La arquitectura es el punto donde las dos plataformas divergen de forma más profunda. No se trata solo de cómo almacenan los datos, sino de qué tipo de operaciones pueden hacer con ellos y a qué velocidad. Entender esta diferencia te permite anticipar qué plataforma encajará mejor con el tipo de trabajo que realizas.
¿Cómo funciona la arquitectura lakehouse de Databricks?
El concepto lakehouse combina lo mejor de un data lake —que puede almacenar cualquier tipo de dato sin imponer un esquema previo— con las capacidades de consulta y gobernanza de un data warehouse. Databricks implementa este modelo sobre Delta Lake, un formato de almacenamiento de código abierto que añade transaccionalidad y control de versiones sobre archivos almacenados en servicios como AWS S3, Azure Data Lake o Google Cloud Storage.
Gracias a Apache Spark como motor subyacente, Databricks puede distribuir el procesamiento entre cientos de nodos de cómputo al mismo tiempo. Eso lo hace especialmente potente para pipelines que mueven datos a escala de petabytes, para entrenar modelos de machine learning o para procesar flujos de datos en tiempo real mediante Structured Streaming.
¿Cómo funciona la arquitectura cloud-native de Snowflake?
Snowflake separa de forma estricta sus tres capas: almacenamiento, cómputo y servicios en la nube. El almacenamiento guarda los datos en formato columnar comprimido; el cómputo se organiza en virtual warehouses que puedes activar, pausar y escalar de forma independiente; y los servicios en la nube gestionan la autenticación, la optimización de consultas y los metadatos. Esa separación es lo que permite que varios equipos trabajen sobre los mismos datos sin que sus cargas de trabajo se pisen entre sí.
Snowflake no requiere que configures clústeres ni que decidas cuánta memoria necesita cada proceso. La plataforma lo gestiona de forma automática, lo que reduce considerablemente el trabajo de operaciones. Para equipos con perfil analítico que no quieren administrar infraestructura, esa característica representa una ventaja muy concreta en el día a día.
Comparativa por casos de uso
Elegir entre Databricks y Snowflake no es una cuestión de cuál es «mejor» en términos absolutos, sino de cuál se ajusta al tipo de trabajo que tu equipo realiza. El perfil del equipo, el tipo de datos y el objetivo final del análisis son los tres factores que más pesan en esa decisión. A continuación encontrarás los escenarios más comunes y la plataforma que mejor los resuelve.
- Tus datos llegan sin estructura definida (JSON, imágenes, logs)
- Necesitas entrenar o ajustar modelos de machine learning
- Trabajas con pipelines complejos de transformación de datos
- Procesas datos en tiempo real (streaming)
- Tu equipo domina Python, Scala o Spark
- Manejas volúmenes a escala de petabytes
- Tus datos ya están limpios y bien estructurados
- El objetivo principal es hacer reportes y dashboards
- Tu equipo trabaja principalmente con SQL
- Quieres cero gestión de infraestructura
- Varios equipos necesitan consultar los mismos datos a la vez
- La prioridad es la velocidad en consultas analíticas
Un patrón habitual en organizaciones con equipos de datos maduros es usar ambas plataformas de forma complementaria: Databricks para preparar, transformar y enriquecer los datos en las etapas iniciales del pipeline, y Snowflake para exponer esos datos ya procesados a los equipos de análisis y negocio. Ese esquema aprovecha lo mejor de cada arquitectura sin forzar ninguna de las dos a hacer algo para lo que no fue diseñada. Si quieres entender cómo encajan estos flujos en la práctica, el concepto de ETL vs. ELT te dará mucho contexto.
¿Cuál rinde mejor según el tipo de trabajo?
El rendimiento de estas plataformas depende tanto del tipo de carga de trabajo como de cómo están configuradas. No existe una respuesta única porque cada plataforma fue optimizada para escenarios distintos. Lo que sí puedes hacer es entender en qué contexto cada una saca ventaja para elegir con criterio.
Rendimiento en cargas de machine learning e IA
En todo lo relacionado con inteligencia artificial y machine learning, Databricks lleva una ventaja estructural porque fue diseñado exactamente para eso. Integra MLflow para el seguimiento de experimentos, permite acceder a clústeres con GPU para entrenar modelos grandes y ofrece herramientas nativas para todo el ciclo de vida de un modelo, desde la preparación de datos hasta el despliegue en producción.
Snowflake ha avanzado en este terreno con Cortex AI, una capa de funciones de inteligencia artificial integradas directamente en SQL. Con ella puedes ejecutar inferencias y aplicar modelos preentrenados sin salir de la plataforma. Sin embargo, no permite entrenar modelos personalizados ni ajustar modelos de lenguaje a gran escala, lo que limita su alcance para equipos de ciencia de datos avanzada.
Rendimiento en consultas SQL y Business Intelligence
Para consultas SQL sobre datos estructurados, ambas plataformas son competitivas. Snowflake tiene una arquitectura muy optimizada para este tipo de carga y su gestión automática de los virtual warehouses hace que escalar ante picos de demanda sea prácticamente transparente para el usuario. Para equipos que solo necesitan consultas analíticas, Snowflake ofrece la experiencia más fluida y con menor fricción operativa.
Databricks ha cerrado parte de esa brecha con Databricks SQL y el motor Photon, que ejecuta consultas SQL de forma vectorizada para acelerar los tiempos de respuesta. En pipelines ETL intensivos, los benchmarks publicados por la propia plataforma en 2025 muestran ventajas de velocidad para Databricks, aunque los resultados varían según el tipo de consulta, el volumen de datos y la configuración específica de cada entorno.
Modelo de precios: cómo cobra cada plataforma
Ambas plataformas funcionan con un modelo de pago por uso, pero la forma en que calculan ese uso es diferente. Databricks cobra en Databricks Units (DBUs), una unidad que combina el uso del motor de procesamiento con el tiempo de ejecución del clúster. A ese coste se suma el precio de la infraestructura en la nube que uses por debajo, ya sea AWS, Azure o Google Cloud, lo que puede hacer que la factura total sea más variable.
Snowflake cobra en créditos, que se consumen según el tamaño y el tiempo de actividad de los virtual warehouses, más el almacenamiento utilizado de forma separada. Esa estructura es más transparente para equipos que trabajan principalmente con SQL, aunque puede resultar cara cuando hay muchos usuarios ejecutando consultas simultáneamente durante períodos prolongados. La clave en ambos casos es configurar bien los recursos para evitar consumos innecesarios.
- Unidad: Databricks Units (DBUs)
- Coste adicional por infraestructura cloud
- Mayor flexibilidad para optimizar cargas
- Puede ser más económico en cargas ETL a escala
- Clústeres mal configurados encarecen el coste
- Unidad: Créditos de Snowflake
- Almacenamiento cobrado por separado
- Estructura más predecible para equipos SQL
- Puede ser costoso con alta concurrencia
- Pausa automática de warehouses evita gastos
¿Se pueden usar Databricks y Snowflake juntos?
Sí, y de hecho es una combinación habitual en equipos de ingeniería de datos con cierta madurez. El esquema más común es usar Databricks en las etapas de ingesta, transformación y modelado de datos, y Snowflake como capa de consumo donde los analistas y herramientas de BI acceden a los datos ya procesados mediante SQL. Cada plataforma hace lo que mejor sabe hacer, sin que ninguna tenga que esforzarse fuera de su zona de confort.
Esta arquitectura en dos capas tiene un coste más alto que usar una sola plataforma, por lo que solo tiene sentido cuando el equipo es suficientemente grande o cuando los casos de uso son realmente distintos entre sí. Para proyectos más pequeños o equipos con un único perfil técnico, elegir una sola plataforma y dominarla bien suele ser la decisión más práctica y más económica.
¿Cuál deberías aprender primero?
La respuesta depende del rol al que te diriges. Si tu objetivo es trabajar como analista de datos o en un equipo de Business Intelligence, Snowflake es el punto de partida más natural: solo necesitas saber SQL para sacarle partido y la curva de aprendizaje es notablemente más corta. Puedes estar operativo en poco tiempo y el mercado laboral valora mucho ese conocimiento en perfiles analíticos.
Si tu meta es la ingeniería de datos o la ciencia de datos, Databricks es una habilidad más estratégica. Requiere familiarizarse con Apache Spark, Python y la lógica de procesamiento distribuido, lo que implica más tiempo de estudio, pero también abre puertas a roles mejor remunerados y más técnicos dentro del ecosistema de datos. No es que uno sea mejor que el otro: cada uno encaja con un perfil profesional distinto.
- Vienes del mundo SQL o Excel
- Tu rol es analista de datos o BI
- Buscas resultados rápidos y sin gestión técnica
- Trabajas en un entorno orientado a reportes
- Ya programas en Python o quieres aprenderlo
- Tu meta es la ingeniería o ciencia de datos
- Quieres trabajar con machine learning
- Te atrae el procesamiento a gran escala
Preguntas frecuentes
¿Qué diferencia hay entre Databricks y Snowflake en términos de arquitectura?
Databricks utiliza una arquitectura lakehouse basada en Delta Lake y Apache Spark, que permite almacenar datos de cualquier tipo —estructurados, semiestructurados y no estructurados— sobre almacenamiento en la nube de formato abierto como AWS S3 o Azure Data Lake. Snowflake, en cambio, emplea una arquitectura de data warehouse cloud-native con tres capas separadas: almacenamiento columnar propietario, cómputo mediante virtual warehouses y una capa de servicios en la nube que gestiona la infraestructura automáticamente. La diferencia principal está en que Databricks requiere más gestión técnica, pero ofrece mayor flexibilidad, mientras que Snowflake prioriza la simplicidad operativa para cargas SQL.
¿Cuál es mejor para machine learning, Databricks o Snowflake?
Databricks tiene una ventaja clara y estructural en machine learning: integra MLflow para el seguimiento de experimentos, permite acceder a clústeres con GPU para entrenar modelos a gran escala y cuenta con un entorno nativo para todo el ciclo de vida de un modelo de IA. Snowflake ha incorporado capacidades de ML a través de Cortex AI, que permite aplicar inferencias y modelos preentrenados directamente desde SQL, pero no admite el entrenamiento de modelos personalizados ni el ajuste de modelos de lenguaje de gran tamaño. Para proyectos de ML avanzado, Databricks es la opción más completa.
¿Es Databricks más caro que Snowflake?
No de forma generalizada; depende del tipo de carga de trabajo. Databricks cobra en Databricks Units más el coste de la infraestructura cloud subyacente, lo que da más margen para optimizar cargas ETL a escala, pero también puede disparar el coste si los clústeres están mal configurados. Snowflake cobra por créditos y almacenamiento por separado, con una estructura más predecible para equipos SQL, aunque puede resultar caro cuando hay alta concurrencia de usuarios durante períodos largos. En benchmarks independientes, el resultado varía según el tipo de consulta y el volumen de datos, por lo que lo más útil es estimar el coste según tu caso de uso concreto.
¿Qué lenguajes de programación soportan Databricks y Snowflake?
Databricks soporta de forma nativa Python, SQL, Scala y R, lo que lo convierte en una plataforma muy versátil para equipos con distintos perfiles técnicos. Los notebooks interactivos permiten combinar varios lenguajes en un mismo entorno de trabajo. Snowflake está principalmente orientado a SQL, que es el lenguaje con el que se hacen prácticamente todas las operaciones de consulta y transformación. Para quienes necesitan programar en Python dentro de Snowflake, la plataforma ofrece Snowpark, una API que permite ejecutar código Python sobre los datos sin salir del sistema.
¿Pueden Databricks y Snowflake trabajar juntos en el mismo proyecto?
Sí, y es una combinación habitual en organizaciones con equipos de datos consolidados. El esquema más frecuente es usar Databricks para las etapas de ingesta, transformación y modelado —donde sus capacidades de procesamiento distribuido marcan la diferencia— y Snowflake como capa de consumo, donde los analistas y herramientas de Business Intelligence acceden a los datos ya procesados mediante SQL. Esa división del trabajo aprovecha los puntos fuertes de cada plataforma sin que ninguna tenga que operar fuera de su diseño original. El coste combinado es mayor, así que tiene más sentido en proyectos con requisitos claramente diferenciados entre la ingeniería de datos y el análisis.
¿Cuál es más fácil de aprender, Databricks o Snowflake?
Snowflake tiene una curva de aprendizaje considerablemente más corta. Si ya sabes SQL, puedes empezar a trabajar con Snowflake en poco tiempo porque la plataforma gestiona toda la infraestructura por ti y no requiere conocimientos de programación avanzada. Databricks, en cambio, implica familiarizarse con Apache Spark, el modelo de procesamiento distribuido y herramientas como Python o Scala, lo que requiere más tiempo de estudio antes de poder trabajar con soltura. Para alguien que empieza desde cero en el mundo de los datos, Snowflake es el camino con menos fricción inicial.
¿Qué es Delta Lake y qué tiene que ver con Databricks?
Delta Lake es una capa de almacenamiento de código abierto que añade transaccionalidad, control de versiones y capacidades de gestión avanzada sobre archivos almacenados en servicios cloud como AWS S3 o Azure Data Lake Storage. Databricks lo desarrolló y lo convirtió en el núcleo de su arquitectura lakehouse, lo que permite que los datos almacenados en formato abierto tengan las garantías de consistencia que antes solo ofrecían los data warehouses tradicionales. Gracias a Delta Lake, Databricks puede combinar la flexibilidad de un data lake con la fiabilidad de un almacén de datos estructurado.
¿Qué es Apache Spark y por qué importa en Databricks?
Apache Spark es un motor de procesamiento distribuido de código abierto que divide las tareas de cómputo entre múltiples nodos para procesar grandes volúmenes de datos de forma paralela y eficiente. Databricks fue creado por los propios fundadores de Apache Spark con el objetivo de hacer que ese motor fuera más accesible, más fácil de gestionar y más potente para casos de uso empresariales. Spark es, en esencia, el motor que da a Databricks su capacidad de procesar petabytes de datos, ejecutar pipelines complejos y entrenar modelos de machine learning a escala, lo que lo convierte en la pieza técnica central de toda la plataforma.
Conclusión
Databricks y Snowflake no son rivales que compiten por el mismo espacio: son plataformas con filosofías distintas que responden a necesidades diferentes dentro del ecosistema de datos. Databricks destaca cuando necesitas procesar datos a gran escala, construir pipelines complejos o trabajar con machine learning; Snowflake brilla cuando los datos ya están estructurados y el objetivo es consultarlos con rapidez para tomar decisiones de negocio.
Ahora que conoces sus diferencias en arquitectura, rendimiento, precios y casos de uso, puedes aplicar ese conocimiento de forma concreta: si estás definiendo qué herramienta estudiar, elige según el rol al que te diriges; si estás evaluando una solución para tu equipo, parte del tipo de trabajo que realmente realizas y no de lo que suena más moderno. Esa distinción evita decisiones costosas y te ahorra mucho tiempo de ajuste posterior.
El mundo de los datos avanza rápido, y tanto Databricks como Snowflake siguen sumando capacidades que los acercan entre sí. Seguir aprendiendo sobre estas plataformas te da una ventaja real en el mercado. En este sitio web encontrarás más contenido sobre ingeniería de datos, arquitecturas modernas y las herramientas que están transformando la forma en que trabajamos con los datos.
Sigue aprendiendo:
DBT: La herramienta que cambió cómo se trabajan los datos
AWS Glue: El secreto detrás de los grandes pipelines de datos
¿Qué hace un ingeniero de datos?
ETL con Python: Extrae, transforma y carga datos
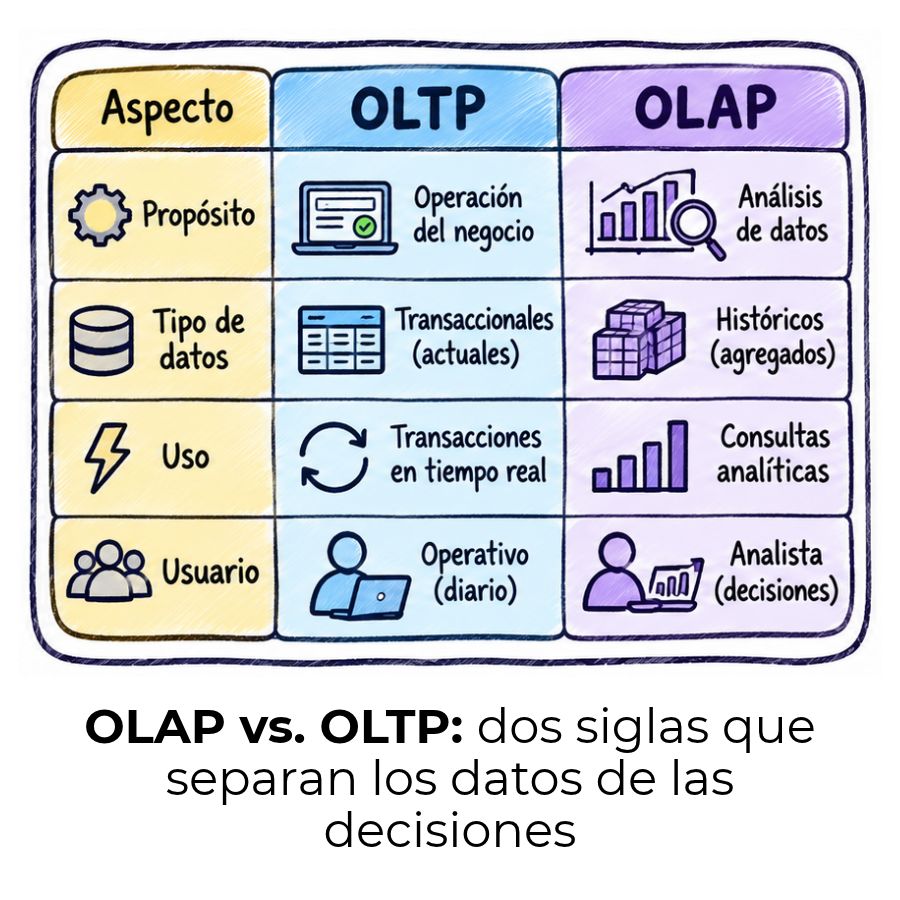
OLAP vs. OLTP: Diferencias clave que debes conocer
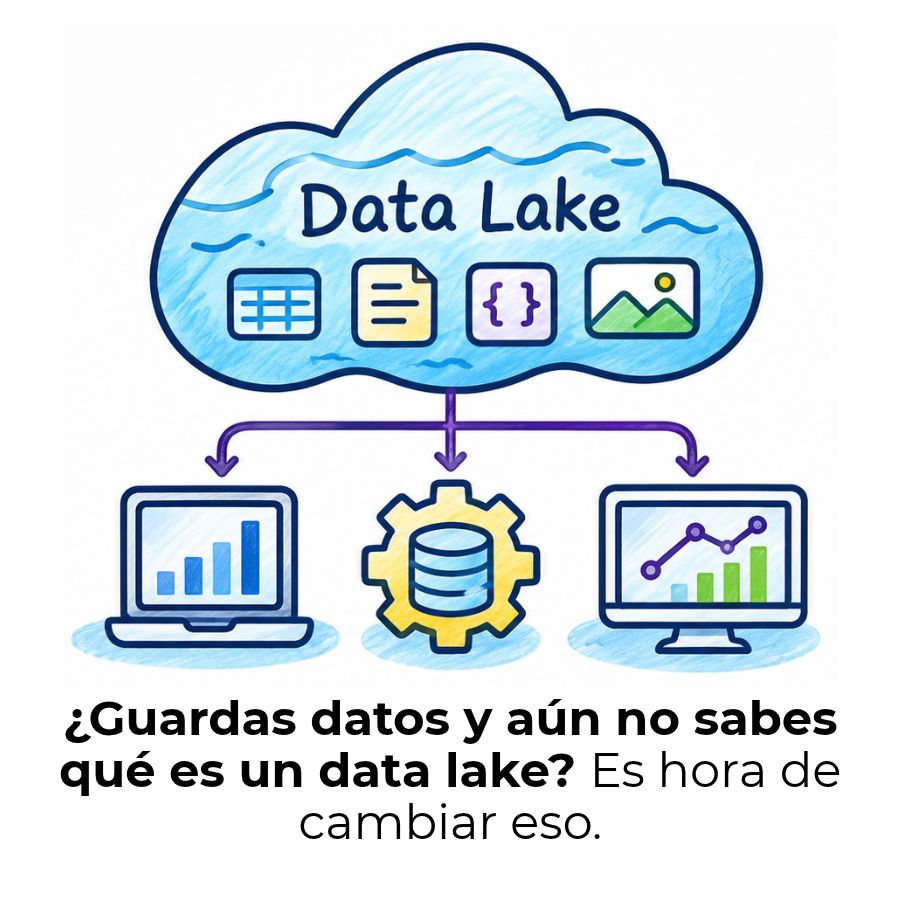
¿Qué es un data lake y cómo funciona?
¿Qué es ETL? – Extracción, Transformación y Carga
Data Mesh: La arquitectura que descentraliza datos
