
DBT, que significa Data Build Tool, es una herramienta de código abierto que te permite transformar datos dentro de tu data warehouse usando SQL. Con ella puedes organizar tus transformaciones en modelos reutilizables, añadirles pruebas automáticas y generar documentación sin trabajo adicional, todo dentro del mismo entorno donde viven tus datos.
¿Qué es DBT (Data Build Tool)?
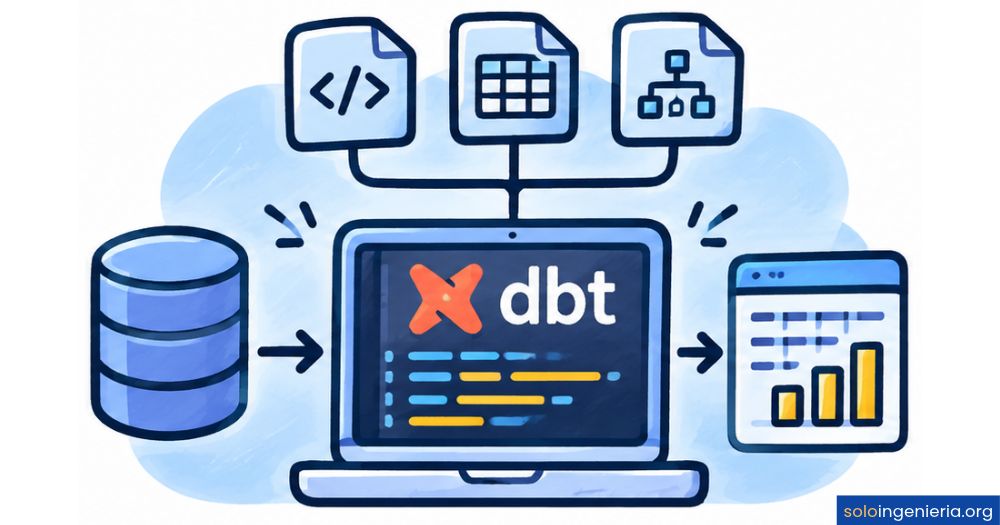
DBT (Data Build Tool) es una herramienta de código abierto que te permite transformar datos directamente dentro de tu data warehouse usando SQL. Desarrollada por dbt Labs, se convirtió en el estándar de la industria para aplicar buenas prácticas de ingeniería de software al trabajo con datos: control de versiones, pruebas automáticas y documentación integrada, todo sin salir del entorno donde ya viven tus datos.
A diferencia de otras soluciones, DBT no extrae ni carga datos. Su único trabajo es la transformación, y lo hace de una forma que cualquier persona con conocimientos de SQL puede adoptar sin necesidad de aprender un lenguaje de programación complejo. Eso lo convierte en una herramienta accesible tanto para analistas como para ingenieros de datos.
El problema que DBT vino a resolver
Antes de DBT, trabajar con transformaciones de datos era una tarea desordenada: scripts SQL dispersos en carpetas sin estructura, sin historial de cambios, sin pruebas automáticas y sin que nadie supiera con certeza qué modelos dependían de cuáles. El resultado era frágil: cambiar una tabla podía romper reportes en cascada sin que nadie lo detectara hasta que un directivo veía números incorrectos en su dashboard.
DBT tomó las buenas prácticas que ya existían en el desarrollo de software —versionado con Git, pruebas, modularidad y documentación— y las trasladó al mundo de las transformaciones de datos. Así, lo que antes era un conjunto de archivos difíciles de rastrear se convirtió en un proyecto estructurado, colaborativo y mantenible.
DBT dentro del flujo ELT
DBT no trabaja solo: forma parte de un flujo más amplio conocido como ELT (Extract, Load, Transform). En este enfoque, los datos se extraen de las fuentes y se cargan primero en el data warehouse en bruto; DBT entra después como la capa de transformación que da forma, limpia y estructura esos datos dentro del propio warehouse. No extrae ni carga: únicamente transforma.
Esto contrasta con el modelo ETL tradicional, donde la transformación ocurría fuera del destino final, en servidores intermedios. Con el enfoque ELT que adopta DBT, toda la lógica vive en el mismo lugar donde residen los datos, lo que simplifica el mantenimiento y aprovecha la potencia de cómputo del warehouse.
¿Cómo funciona DBT?
El funcionamiento de DBT se basa en un principio simple: cada transformación se escribe como una consulta SQL de tipo SELECT, y DBT se encarga de compilarla, ejecutarla en el warehouse, testearla y documentarla de forma automática. No hay lógica oculta ni configuraciones complicadas; todo vive en archivos de texto que puedes versionar en Git como si fuera código de software.
Ciclo de trabajo en DBT
1. Escribes
Un archivo .sql con un SELECT que transforma tus datos
2. DBT compila
Resuelve dependencias y genera el SQL final optimizado
3. Ejecuta
Corre las transformaciones directamente en el warehouse
4. Testea
Valida la integridad y calidad de cada modelo generado
5. Documenta
Genera documentación navegable del linaje de datos
Modelos: la unidad básica de transformación
En DBT, todo gira en torno al concepto de modelo. Un modelo es simplemente un archivo .sql que contiene una sola consulta SELECT; no más, no menos. Cuando ejecutas DBT, esa consulta se convierte automáticamente en una tabla o una vista dentro de tu data warehouse, según la configuración que hayas elegido. Este enfoque hace que cada transformación sea atómica, legible y fácil de probar.
Los modelos pueden referenciarse entre sí mediante la función ref(). Si el modelo B necesita datos del modelo A, simplemente escribe ref('modelo_a') en su consulta y DBT se encarga del resto: sabe que debe ejecutar A antes que B y actualiza esa cadena automáticamente si algo cambia en el modelo superior.
El grafo de dependencias (DAG)
Cuando DBT lee todos los modelos de un proyecto y sus referencias mutuas, construye internamente un grafo acíclico dirigido, conocido como DAG (Directed Acyclic Graph). Este grafo representa el orden exacto en que deben ejecutarse las transformaciones: qué modelos son raíz, cuáles dependen de otros y cuáles pueden correr en paralelo.
El DAG no es solo un detalle técnico: es la herramienta que te permite entender el linaje completo de tus datos, es decir, rastrear desde qué fuente original proviene cada columna en un modelo final. Si cambias un modelo intermedio, DBT sabe exactamente qué otros modelos descendientes necesitan volver a ejecutarse.
Materialización de los modelos
DBT ofrece distintas formas de materializar un modelo, es decir, de decidir cómo se almacena el resultado de tu transformación en el warehouse. Las cuatro materializaciones principales son: vista (view), tabla (table), tabla incremental (incremental) y efímero (ephemeral). Cada una tiene un propósito diferente según el volumen de datos, la frecuencia de actualización y el coste de procesamiento.
| Materialización | Qué genera | Cuándo usarla |
|---|---|---|
| View | Una vista en el warehouse | Transformaciones ligeras sin necesidad de almacenamiento físico |
| Table | Una tabla física completa | Modelos que se consultan frecuentemente y requieren velocidad |
| Incremental | Tabla que se actualiza solo con datos nuevos | Volúmenes grandes donde re-procesar todo sería costoso |
| Ephemeral | CTE temporal, sin tabla ni vista | Lógica intermedia que solo se usa dentro de otro modelo |
Componentes principales de DBT
DBT no se limita a ejecutar archivos SQL. Viene con un conjunto de piezas que, trabajando juntas, forman un proyecto de datos estructurado y mantenible. Conocer cada componente te ayuda a entender qué puedes hacer con la herramienta desde el primer día.
Tests y validación de datos
Los tests en DBT son comprobaciones automáticas que se ejecutan sobre los modelos para garantizar la calidad de los datos. DBT incluye cuatro tipos de test predefinidos: unicidad, no nulo, valores aceptados y relaciones entre tablas. Estos se declaran en archivos YAML y se ejecutan con un solo comando, antes de que los datos lleguen a un dashboard o informe de negocio.
La ventaja de este enfoque es que los errores se detectan en la capa de transformación, no cuando un usuario final ya los ha visto. Si un modelo produce valores nulos donde no debería, el test falla y el pipeline se detiene. Esto elimina una fuente enorme de desconfianza en los datos.
Macros y plantillas Jinja
DBT utiliza Jinja, un motor de plantillas de Python, para añadir lógica dinámica a los archivos SQL. Con Jinja puedes crear macros: funciones reutilizables que encapsulan lógica repetitiva y que pueden llamarse desde cualquier modelo del proyecto. Por ejemplo, puedes crear una macro que estandarice la forma en que calculas semanas fiscales y usarla en todos los modelos que la necesiten.
Esto significa que, aunque DBT es SQL-first, no estás limitado a SQL plano. Las macros te permiten generar código dinámico, iterar sobre listas de columnas o adaptar el comportamiento de un modelo según el entorno donde se ejecute, sin duplicar lógica en cada archivo.
Seeds y snapshots
Los seeds son archivos CSV que DBT carga directamente en el warehouse como tablas de referencia. Son útiles para datos estáticos o que cambian muy poco, como códigos de país, categorías de productos o tablas de mapeo. Con un solo comando, DBT lee el CSV y crea la tabla correspondiente en el warehouse.
Los snapshots, por su parte, sirven para capturar el estado histórico de una tabla que cambia con el tiempo. Si una tabla de clientes actualiza el estado de un registro, el snapshot guarda una copia de cómo era antes del cambio. Esto permite análisis temporales y auditorías sin necesidad de sistemas externos de seguimiento de cambios.
DBT Core y DBT Cloud: ¿cuál es la diferencia?
DBT existe en dos versiones con características distintas. DBT Core es la versión de código abierto, gratuita y ejecutable desde la línea de comandos en tu propio entorno. Funciona en Windows, macOS y Linux, y es suficiente para la mayoría de los proyectos cuando el equipo ya tiene infraestructura de orquestación propia.
| Característica | DBT Core | DBT Cloud |
|---|---|---|
| Coste | Gratuito (open source) | De pago (con plan gratuito limitado) |
| Interfaz | Línea de comandos | IDE web y panel de control |
| Orquestación | Externa (Airflow, Prefect, etc.) | Integrada con scheduler propio |
| Documentación | Local o autohospedada | Alojada y navegable en la nube |
| Alertas y monitoreo | No incluidas | Incluidas en el panel |
| Ideal para | Equipos con infraestructura propia | Equipos que prefieren todo en un solo lugar |
DBT Cloud añade una capa de productividad sobre DBT Core: un entorno de desarrollo web, un scheduler integrado para ejecutar modelos en horarios programados, alertas automáticas y una interfaz visual para explorar el linaje de datos. No cambia la forma en que se escriben los modelos, pero sí elimina la necesidad de configurar herramientas externas de orquestación.
¿Con qué plataformas es compatible DBT?
Una de las razones por las que DBT se extendió tan rápido es su compatibilidad con los principales data warehouses y plataformas de datos del mercado. DBT se conecta a cada plataforma mediante adaptadores, que son paquetes específicos que traducen los comandos de DBT al dialecto SQL de cada sistema.
BigQuery
Google Cloud
Snowflake
Cloud Data Platform
Redshift
Amazon Web Services
Databricks
Lakehouse Platform
PostgreSQL
Base de datos relacional
Presto / Trino
Query engine distribuido
La comunidad de DBT mantiene adaptadores adicionales para otras plataformas.
La lógica de los adaptadores significa que el código de tus modelos no cambia entre plataformas: escribes el mismo SQL y DBT se ocupa de las diferencias de sintaxis. Esto facilita migrar de un warehouse a otro sin reescribir todas tus transformaciones desde cero.
Cuando trabajas con pipeline de datos que alimentan distintos sistemas, la compatibilidad de DBT con múltiples plataformas te permite mantener una capa de transformación coherente aunque el origen o el destino de los datos cambie con el tiempo.
Ventajas y limitaciones de usar DBT
Adoptar DBT tiene beneficios claros, pero también implica asumir algunas restricciones que conviene conocer antes de integrarlo en un proyecto. Evaluar ambas caras es lo que permite tomar una decisión informada sobre si tiene sentido incorporarlo en un stack de datos específico.
Ventajas principales:
- SQL como lenguaje único: No necesitas aprender Python, Scala ni ningún otro lenguaje para escribir transformaciones. Con SQL y algo de Jinja cubres la inmensa mayoría de casos de uso.
- Control de versiones nativo: Como los modelos son archivos de texto, puedes gestionarlos en Git con el mismo flujo de trabajo que usa cualquier equipo de desarrollo de software.
- Tests automáticos integrados: La validación de calidad deja de ser un paso manual y se convierte en parte del proceso, lo que reduce el riesgo de que datos incorrectos lleguen a producción.
- Documentación sin esfuerzo adicional: DBT genera automáticamente un sitio de documentación navegable con el linaje completo de los datos, sin que tengas que escribirla por separado.
- Modularidad y reutilización: Los modelos y las macros se reutilizan entre proyectos, lo que evita duplicar lógica y reduce el tiempo de desarrollo en proyectos nuevos.
Limitaciones que debes tener en cuenta:
- Solo cubre la transformación: DBT no extrae ni carga datos. Necesitas otras herramientas (Fivetran, Airbyte, Stitch) para la parte de extracción y carga del flujo ELT.
- Coste de configuración inicial: Configurar un proyecto DBT, conectarlo al warehouse y establecer las convenciones del equipo lleva tiempo, especialmente si es la primera vez.
- Dependencia del warehouse: Todo el procesamiento ocurre dentro del data warehouse, lo que significa que el rendimiento y el coste de las transformaciones dependen directamente de la plataforma que uses.
- ELT no siempre es la mejor opción: En algunos escenarios con datos sensibles o restricciones estrictas de acceso, transformar dentro del warehouse puede ser problemático desde un punto de vista de seguridad o gobernanza.
¿Cómo encaja DBT en el stack moderno de datos?
El stack de datos moderno es un conjunto de herramientas especializadas que cubren etapas distintas del ciclo de vida de los datos. DBT ocupa una posición central y bien definida dentro de ese ecosistema: es la capa de transformación que actúa después de que los datos han sido extraídos de las fuentes y cargados en el warehouse.
En la práctica, DBT trabaja junto a herramientas de ingesta como Fivetran o Airbyte, que llevan los datos al warehouse, y a herramientas de visualización como Tableau, Looker o Power BI, que los consumen después de la transformación. Dentro de este ecosistema, DBT también se integra de forma natural con un data lake cuando se utiliza una arquitectura de lakehouse, donde los datos viven en almacenamiento en formato abierto antes de ser consultados.
La orquestación de los modelos —es decir, cuándo y en qué orden se ejecutan en producción— suele delegarse a herramientas como Apache Airflow, Prefect o la propia plataforma de DBT Cloud. Esto convierte a DBT en una pieza bien definida dentro de un stack mayor, sin que intente resolver todo por sí solo.
Si quieres entender mejor el contexto completo en el que opera DBT, profundizar en los fundamentos de ingeniería de datos te dará una visión más clara de cómo encajan todas estas herramientas entre sí.
Preguntas frecuentes
¿Qué lenguaje se usa en DBT?
DBT es SQL-first: el lenguaje principal para escribir modelos y transformaciones es SQL estándar. Además, incorpora Jinja, un motor de plantillas escrito en Python, que permite añadir lógica dinámica como bucles, condicionales y funciones reutilizables dentro de los archivos SQL. Para la configuración del proyecto se utilizan archivos YAML. No necesitas conocimientos de Python para empezar, aunque saber usarlo abre la puerta a macros más avanzadas y al desarrollo de adaptadores personalizados.
¿DBT reemplaza al data warehouse?
No. DBT no almacena datos ni reemplaza al data warehouse; trabaja sobre él. Su función es ejecutar transformaciones dentro del mismo entorno donde los datos ya residen, aprovechando la capacidad de cómputo y la escalabilidad del warehouse. BigQuery, Snowflake, Redshift o Databricks siguen siendo el lugar donde viven los datos: DBT simplemente les da forma a través de modelos SQL.
¿Necesito saber programar para usar DBT?
No necesitas ser programador para empezar. Con un nivel sólido de SQL puedes escribir modelos, configurar tests y ejecutar transformaciones desde el primer día. Lo que sí resulta útil es familiarizarse con conceptos básicos de ingeniería de software como el control de versiones con Git, ya que DBT está diseñado para integrarse con él. A medida que el proyecto crece, conocer algo de Python y Jinja te permitirá crear macros más potentes y reutilizables.
¿Cuál es la diferencia entre ETL y ELT en DBT?
En ETL (Extract, Transform, Load), los datos se transforman antes de llegar al destino final, en servidores intermedios externos al warehouse. En ELT (Extract, Load, Transform), los datos se cargan primero en el warehouse en bruto y la transformación ocurre después, dentro del propio destino. DBT implementa la T del ELT: asume que los datos ya están en el warehouse y se encarga exclusivamente de transformarlos allí, aprovechando la potencia de procesamiento del sistema de almacenamiento.
¿DBT es solo para grandes empresas?
No. DBT Core es gratuito y funciona perfectamente en proyectos pequeños o para un único analista que quiera ordenar sus transformaciones SQL. Los beneficios del control de versiones, los tests automáticos y la documentación son igual de valiosos en proyectos de cualquier tamaño. De hecho, adoptar DBT desde el inicio de un proyecto es más sencillo que intentar incorporarlo cuando el caos de scripts ya es grande.
¿Qué es un modelo en DBT?
Un modelo en DBT es un archivo con extensión .sql que contiene una sola consulta SELECT. Cuando ejecutas DBT, esa consulta se transforma automáticamente en una tabla o una vista dentro del data warehouse, dependiendo de la materialización configurada. Los modelos pueden referenciarse entre sí mediante la función ref(), lo que permite construir cadenas de transformación ordenadas y trazables sin gestionar manualmente el orden de ejecución.
¿Qué son los snapshots en DBT?
Los snapshots son un mecanismo de DBT para registrar el historial de cambios en tablas que se actualizan con el tiempo. Si un registro de cliente cambia de estado, el snapshot guarda tanto el valor anterior como el nuevo, con marcas de tiempo que indican cuándo ocurrió cada cambio. Esto permite realizar análisis históricos y auditorías sin depender de sistemas externos, usando únicamente la infraestructura del data warehouse donde ya trabaja DBT.
¿Cómo genera DBT la documentación automáticamente?
DBT genera documentación a partir de la información que ya existe en el proyecto: los nombres de los modelos, las descripciones que defines en los archivos YAML y las relaciones entre modelos que se establecen mediante la función ref(). Con el comando dbt docs generate, DBT crea un sitio web navegable que muestra el catálogo completo del proyecto, incluyendo el linaje de datos en forma de grafo visual. No tienes que escribir la documentación por separado: se construye a partir del trabajo que ya has hecho.
Conclusión
DBT transformó la forma en que los equipos de datos trabajan con transformaciones SQL. Al tratar los modelos como código —con control de versiones, pruebas automáticas y documentación integrada—, convirtió un proceso históricamente caótico en algo estructurado, colaborativo y mantenible. Su posición en el flujo ELT es clara: actúa después de que los datos llegan al warehouse y los prepara para que sean útiles en análisis y reportes.
Lo que has visto aquí —modelos, materialización, DAG, tests, macros, seeds y snapshots— son las piezas que puedes empezar a usar en cuanto tengas un warehouse y conocimientos básicos de SQL. No necesitas dominarlo todo de golpe: puedes comenzar con modelos simples, añadir tests progresivamente y activar la documentación cuando el proyecto crezca. Cada paso mejora la calidad y la confiabilidad de tus datos.
Si esta introducción a DBT te abrió el apetito por aprender más sobre cómo se construyen y gestionan los datos a escala, en este sitio web encontrarás más contenido sobre herramientas, conceptos y arquitecturas del mundo de los datos que te ayudarán a seguir avanzando.
Sigue aprendiendo:
Azure Data Factory (ADF): El servicio que mueve tus datos en la nube ☁️
¿Qué es PySpark y para qué sirve?
Gobierno de datos: Controla tu información y toma mejores decisiones 📊
Data Mesh: La arquitectura que descentraliza datos
¿En qué consiste la ingeniería de base de datos?
¿Qué hace un ingeniero de datos?
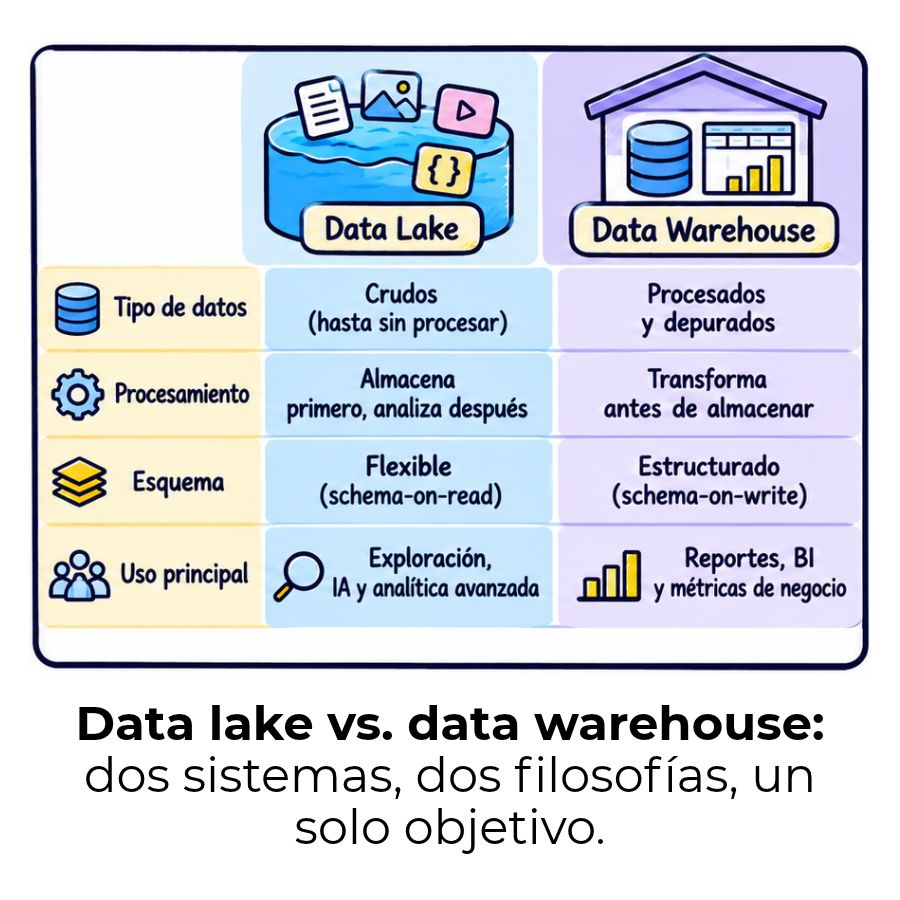
Diferencia entre data lake y data warehouse
Catálogo de datos: El mapa que nadie te enseñó a leer
