
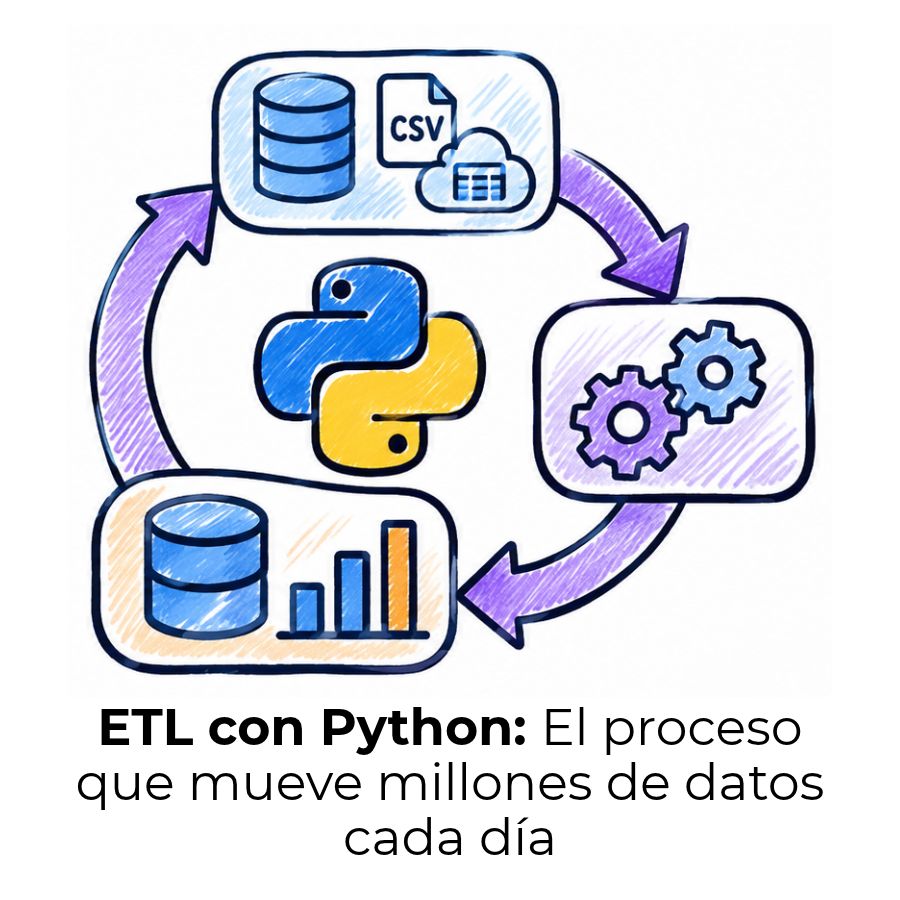
Cada vez que abres un dashboard o ejecutas un análisis, hay un proceso invisible que hizo posible ese resultado. Alguien tuvo que extraer los datos de su origen, limpiarlos y dejarlos listos. Con Python, tú puedes ser esa persona, y hacerlo de forma automatizada, eficiente y sin depender de herramientas costosas.
¿Qué es ETL y por qué Python es la herramienta ideal?
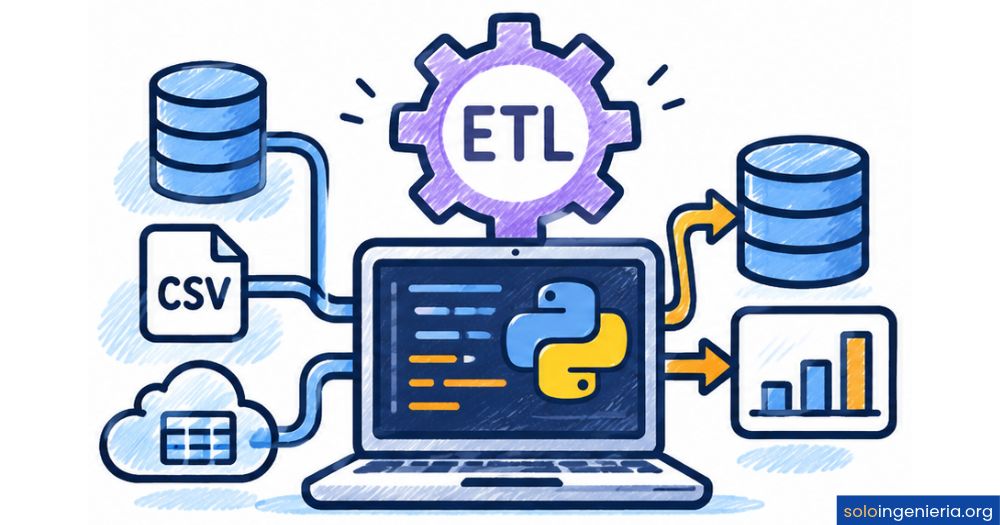
ETL son las siglas de Extract, Transform, Load (Extracción, Transformación y Carga), y representa el proceso mediante el cual los datos viajan desde su origen hasta un destino donde pueden analizarse. Es la base de cualquier proyecto de ingeniería de datos, desde un reporte semanal hasta un sistema de machine learning en producción.
Python se ha consolidado como el lenguaje preferido para construir estos procesos porque combina una sintaxis clara con un ecosistema de librerías muy completo. No necesitas herramientas de pago ni configuraciones complejas: con unas pocas líneas de código puedes poner en marcha un pipeline funcional que conecte fuentes diversas, limpie los datos y los deposite donde los necesitas.
Las tres fases del proceso ETL explicadas
El ETL se divide en tres etapas bien diferenciadas que siempre ocurren en el mismo orden. La extracción consiste en obtener los datos desde su fuente original, ya sea una base de datos, un archivo o un servicio externo. La transformación limpia, normaliza y estructura esa información para que sea coherente y útil. La carga, finalmente, deposita los datos procesados en el sistema de destino donde serán consultados o analizados.
Estas tres fases no son independientes: cada una depende de la anterior. Si la extracción falla o trae datos corruptos, la transformación no puede hacer su trabajo correctamente. Por eso, construir un pipeline ETL sólido implica prestar atención a cada etapa, no solo a la parte técnica de programación, sino también a la calidad de los datos que entran al proceso.
Ventajas de usar Python frente a otras herramientas
Existen herramientas visuales de ETL como Talend o Pentaho que no requieren escribir código. Sin embargo, Python ofrece un nivel de flexibilidad y control que las herramientas visuales no pueden igualar: puedes adaptar cada línea del proceso, integrar lógica personalizada y conectar fuentes que esas plataformas no soportan de forma nativa. Además, Python es gratuito y de código abierto.
Otra ventaja concreta es la automatización. Con Python puedes programar tu pipeline para que se ejecute en momentos específicos, responda a eventos o se adapte dinámicamente a cambios en la estructura de los datos. Esto lo convierte en una opción muy potente tanto para proyectos personales como para entornos empresariales que manejan grandes volúmenes de información.
Librerías de Python esenciales para un proceso ETL
Una de las razones por las que Python destaca en ETL es su ecosistema de librerías. No tienes que construir todo desde cero: existen herramientas muy maduras que cubren cada fase del proceso. Conocerlas te ahorra tiempo y te permite escribir código más limpio, más fácil de mantener y menos propenso a errores en producción.
Pandas, la columna vertebral de la transformación
Cuando los datos llegan al pipeline, casi siempre contienen problemas: valores nulos, columnas con tipos incorrectos, registros duplicados o formatos inconsistentes. Pandas resuelve todos estos problemas con funciones específicas como dropna() para eliminar filas vacías, astype() para convertir tipos de datos y drop_duplicates() para limpiar repeticiones. Es la librería más usada en la fase de transformación por su claridad y potencia.
Además de limpiar datos, pandas permite crear nuevas columnas calculadas a partir de las existentes, agrupar registros para calcular totales o promedios, combinar tablas de distintas fuentes mediante operaciones similares a las de SQL y filtrar subconjuntos específicos. Todo esto con una sintaxis relativamente sencilla que se aprende de forma progresiva.
SQLAlchemy para conectar Python con bases de datos
En la mayoría de los proyectos ETL reales, los datos terminan en una base de datos relacional. SQLAlchemy es la librería que hace esa conexión posible desde Python. Su función más práctica en un pipeline ETL es el método to_sql() de pandas, que permite cargar un DataFrame completo en una tabla de base de datos con una sola línea de código, especificando si se quiere reemplazar los datos existentes o añadir nuevos registros.
SQLAlchemy es compatible con los sistemas de bases de datos más usados en entornos profesionales: PostgreSQL, MySQL, SQLite y Oracle, entre otros. Esta compatibilidad hace que el mismo código Python pueda funcionar en distintos proyectos con solo cambiar la cadena de conexión, sin modificar la lógica del pipeline.
Otras librerías clave: requests, PySpark y Airflow
Para proyectos que consumen datos desde APIs, requests es la librería estándar para hacer peticiones HTTP en Python. Permite autenticarse con tokens, enviar parámetros y recibir respuestas JSON de forma muy sencilla. Se combina habitualmente con pandas para convertir esas respuestas en DataFrames listos para transformar.
Cuando el volumen de datos crece significativamente, PySpark entra en escena. Es la API de Python para Apache Spark, un motor de procesamiento distribuido que puede manejar terabytes de datos repartidos en varios servidores. Para la orquestación y el agendamiento de pipelines completos, Apache Airflow permite definir flujos de tareas, establecer dependencias entre ellas y monitorear su ejecución desde una interfaz visual.
¿Cómo construir un pipeline ETL con Python?
Construir tu primer pipeline ETL en Python es más directo de lo que parece. El proceso siempre sigue el mismo esquema: primero defines de dónde vienen los datos, luego qué transformaciones necesitan y, finalmente, dónde deben terminar. A continuación encontrarás cada fase desglosada con su lógica y un ejemplo de código real.
Paso 1 — Extracción de datos desde distintas fuentes
La extracción es el punto de partida. En esta fase, Python se conecta a la fuente de datos y los lleva a memoria para poder trabajar con ellos. Pandas es la herramienta más directa para leer archivos locales: con pd.read_csv('archivo.csv') o pd.read_excel('archivo.xlsx') tienes los datos disponibles en un DataFrame en segundos. Para fuentes remotas como APIs, se usa requests combinado con pandas.
import pandas as pd
import requests

# Desde CSV local
df_csv = pd.read_csv('datos_ventas.csv')

# Desde una API REST
response = requests.get('https://api.ejemplo.com/datos')
df_api = pd.DataFrame(response.json())
Paso 2 — Transformación y limpieza de los datos
Una vez que los datos están en memoria, comienza la fase más crítica del pipeline. Aquí se corrigen los problemas que impiden el análisis: valores nulos, tipos de datos incorrectos, registros duplicados y columnas con formatos inconsistentes. La transformación determina la calidad del resultado final, por lo que conviene ser metódico: primero explora los datos con df.info() y df.describe() antes de aplicar cualquier cambio.
# Eliminar duplicados
df_csv.drop_duplicates(inplace=True)

# Rellenar valores nulos con la mediana
df_csv['precio'].fillna(df_csv['precio'].median(), inplace=True)

# Convertir columna de fecha al tipo correcto
df_csv['fecha'] = pd.to_datetime(df_csv['fecha'])

# Crear columna nueva calculada
df_csv['total'] = df_csv['cantidad'] * df_csv['precio']
Paso 3 — Carga de datos en el destino final
Con los datos limpios y transformados, el último paso es depositarlos en el sistema de destino. El método to_sql() de pandas, combinado con SQLAlchemy, es la forma más directa de cargar un DataFrame en una base de datos relacional. El parámetro if_exists controla si se reemplaza la tabla completa ('replace') o si se añaden solo los registros nuevos ('append'), lo que resulta clave en cargas incrementales.
from sqlalchemy import create_engine

# Crear la conexión a la base de datos
engine = create_engine(
    'postgresql://usuario:contraseña@localhost:5432/mi_base'
)

# Cargar el DataFrame en la tabla 'ventas'
df_csv.to_sql(
    'ventas',
    con=engine,
    if_exists='replace',
    index=False
)
Fuentes de datos que puedes conectar con Python
Una de las fortalezas del ETL con Python es la variedad de fuentes a las que puedes conectarte. No estás limitado a un tipo de archivo o sistema: Python puede extraer datos de prácticamente cualquier origen con la librería adecuada. Esto lo hace especialmente útil en entornos empresariales donde los datos están distribuidos en múltiples sistemas.
- Archivos planos (CSV, Excel, JSON): Son la fuente más común en proyectos iniciales. Pandas los lee directamente con funciones como
read_csv(),read_excel()oread_json()sin instalaciones adicionales. - Bases de datos relacionales: Con SQLAlchemy puedes conectarte a PostgreSQL, MySQL, SQLite o SQL Server. La consulta se realiza con SQL estándar y el resultado llega directamente a un DataFrame.
- APIs REST: La librería requests permite consumir servicios web que devuelven datos en formato JSON. Es la forma habitual de obtener datos de plataformas como redes sociales, servicios meteorológicos o sistemas de comercio electrónico.
- Web scraping: Con BeautifulSoup o Scrapy puedes extraer datos de páginas web cuando no existe una API disponible. Esta técnica debe usarse respetando los términos de uso de cada sitio.
- Almacenamiento en la nube: Librerías como
boto3para AWS S3 o el cliente de Google Cloud permiten leer archivos directamente desde servicios de almacenamiento en la nube sin descargarlos primero al disco local. - Bases de datos NoSQL: Sistemas como MongoDB tienen sus propias librerías de Python (PyMongo) que permiten extraer documentos JSON y convertirlos en DataFrames de pandas para su procesamiento.
Errores comunes al hacer ETL con Python y cómo evitarlos
Construir un pipeline ETL que funcione en local no garantiza que funcione bien en producción. Hay errores recurrentes que aparecen casi siempre en los primeros proyectos y que, si no se detectan a tiempo, pueden comprometer la integridad de los datos o hacer que el pipeline se rompa sin aviso. Conocerlos por adelantado marca una diferencia real en la calidad del trabajo.
- No validar los datos antes de transformarlos: Asumir que los datos de origen siempre tienen el formato esperado es el error más frecuente. Un campo que normalmente contiene números puede llegar vacío o con texto, y eso rompe cualquier operación matemática posterior. Usa
df.info()ydf.dtypesal inicio de la transformación. - Ignorar los valores nulos: Pandas no elimina los nulos automáticamente. Si no los tratas con
fillna()odropna(), pueden propagarse silenciosamente a cálculos y resultados sin que lo notes hasta que ya es tarde. - Reemplazar la tabla completa en cada carga: Usar
if_exists='replace'en la carga borra todos los datos anteriores en cada ejecución. Para pipelines que se ejecutan con frecuencia, es preferible usar'append'con lógica de deduplicación o implementar cargas incrementales que solo procesen registros nuevos. - No gestionar errores de conexión: Las conexiones a bases de datos y APIs pueden fallar por razones externas: red inestable, credenciales expiradas o límites de tasa. Sin bloques
try/except, el pipeline se detiene sin registrar qué salió mal. - No usar logging: En un pipeline sin logs, si algo falla en producción, no sabes en qué punto ocurrió el error. La librería
loggingde Python permite registrar el estado de cada fase y facilita enormemente la depuración posterior. - Cargar todos los datos en memoria: Cuando los archivos son grandes, leer todo el CSV de una vez puede colapsar la memoria disponible. Pandas ofrece el parámetro
chunksizeenread_csv()para procesar el archivo en bloques más pequeños.
ETL con Python vs. herramientas ETL tradicionales
Elegir entre Python y una herramienta ETL tradicional depende del contexto del proyecto. Ambas opciones tienen fortalezas reales y ninguna es universalmente superior. Lo útil es entender qué ofrece cada una para tomar una decisión informada según las necesidades del equipo y el volumen de datos que se va a manejar.
| Criterio | Python | Herramientas visuales (Talend, Pentaho) |
|---|---|---|
| Curva de aprendizaje | Requiere conocimientos de programación | Interfaz visual, más accesible sin código |
| Flexibilidad | Total: puedes implementar cualquier lógica | Limitada por las funciones predefinidas |
| Costo | Gratuito y de código abierto | Muchas tienen versiones de pago |
| Integración con ML | Nativa con scikit-learn, TensorFlow, etc. | Limitada o requiere plugins adicionales |
| Escalabilidad | Alta con PySpark o Dask | Depende de la herramienta y la licencia |
| Comunidad y soporte | Enorme comunidad activa en todo el mundo | Comunidad más pequeña y específica |
| Velocidad de desarrollo inicial | Más lenta si no hay experiencia previa | Más rápida para flujos estándar |
En proyectos donde el equipo ya usa Python para análisis o machine learning, construir el pipeline ETL en el mismo lenguaje reduce la fricción y unifica las herramientas. También facilita la integración con servicios en la nube como AWS Glue, que permite orquestar pipelines de datos directamente sobre infraestructura de Amazon con scripts Python compatibles con PySpark.
¿Cuándo conviene automatizar tu pipeline ETL con Python?
Ejecutar un pipeline a mano cada vez que necesitas datos actualizados es viable al principio, pero se vuelve insostenible cuando el proceso debe correr varias veces al día o cuando participan múltiples fuentes de datos. La automatización tiene sentido en cuanto el pipeline se ejecuta con frecuencia o cuando el error humano en su ejecución manual tiene consecuencias reales.
Para automatizar pipelines en Python, la opción más directa es Apache Airflow. Con Airflow defines cada tarea del pipeline como un nodo en un grafo dirigido (DAG), estableces las dependencias entre tareas y configuras la frecuencia de ejecución. Si una tarea falla, el sistema lo notifica y permite reiniciarla de forma independiente sin repetir todo el proceso desde el principio.
Además de Airflow, existen alternativas más ligeras para proyectos de menor escala. Luigi, creado por Spotify, permite definir pipelines con dependencias entre tareas usando Python puro. Para proyectos muy sencillos, incluso el planificador de tareas del sistema operativo (cron en Linux/macOS o el Programador de tareas en Windows) puede bastar para ejecutar un script Python a intervalos regulares. La elección depende de la complejidad del flujo y de los recursos disponibles.
En el ecosistema de la ingeniería de datos, la automatización no es un lujo: es lo que separa un experimento puntual de una solución que funciona de forma confiable todos los días. Automatizar bien significa también incluir alertas cuando algo falla, registros de cada ejecución y la posibilidad de reiniciar tareas sin repetir todo el pipeline.
Preguntas frecuentes
¿Qué es ETL en Python?
ETL en Python es el proceso de Extracción, Transformación y Carga de datos implementado con el lenguaje de programación Python. Consiste en conectarse a una o varias fuentes de datos, procesar y limpiar la información usando librerías como pandas, y depositarla en un sistema de destino como una base de datos o un data warehouse. Python lo hace posible con pocas líneas de código gracias a su ecosistema de librerías especializadas en manejo de datos.
¿Qué librería de Python se usa para ETL?
Las librerías más usadas para ETL en Python son pandas para la transformación y limpieza de datos, SQLAlchemy para la conexión con bases de datos relacionales y requests para consumir APIs. Para flujos más complejos o con grandes volúmenes de datos, se emplean PySpark, Apache Airflow (orquestación) y Luigi. La combinación más habitual en proyectos de tamaño medio es pandas junto con SQLAlchemy para la carga en base de datos.
¿Cuál es la diferencia entre ETL y ELT en Python?
En el ETL tradicional, los datos se transforman antes de cargarse en el destino. En el ELT (Extract, Load, Transform), los datos se cargan primero en bruto en el destino y la transformación ocurre directamente allí, aprovechando la potencia del sistema de almacenamiento como un data warehouse en la nube. Con Python puedes implementar ambos enfoques: el ETL clásico usando pandas antes de la carga y el ELT cargando con to_sql() y transformando después mediante SQL o dbt.
¿Puedo hacer ETL con Python sin saber bases de datos?
Sí, es posible construir pipelines ETL con Python sin conocimientos avanzados de bases de datos. Puedes extraer datos desde archivos CSV o Excel y cargar los resultados en un archivo nuevo del mismo tipo, todo usando solo pandas. No obstante, conocer los fundamentos de SQL amplía considerablemente tus posibilidades, ya que la mayoría de los proyectos reales utilizan bases de datos relacionales como destino de la carga y como fuente de los datos originales.
¿Qué es un pipeline ETL y cómo funciona con Python?
Un pipeline ETL es el conjunto de pasos automatizados que mueven los datos desde su origen hasta su destino de forma ordenada y reproducible. Con Python, se implementa como un script o conjunto de funciones donde cada función representa una fase: una extrae, otra transforma y la última carga. Estos pasos se encadenan en secuencia y, con herramientas como Apache Airflow, pueden programarse para ejecutarse automáticamente en intervalos de tiempo definidos.
¿Cómo automatizar un proceso ETL con Python?
La forma más robusta de automatizar un ETL con Python es usando Apache Airflow, que permite definir el pipeline como un DAG (grafo acíclico dirigido), donde cada tarea tiene sus dependencias y su frecuencia de ejecución. Para proyectos más sencillos, Luigi ofrece una alternativa más ligera. Si el pipeline no tiene dependencias complejas, basta con programar la ejecución del script Python usando cron en sistemas Linux o el Programador de tareas en Windows.
¿Es Python mejor que herramientas ETL como Talend o Pentaho?
Depende del contexto. Python ofrece mayor flexibilidad, control total sobre la lógica del pipeline e integración nativa con librerías de análisis y machine learning. Talend y Pentaho, por otro lado, tienen interfaces visuales que permiten construir flujos sin escribir código, lo que las hace más accesibles para equipos sin experiencia en programación. Para proyectos donde el equipo ya trabaja con Python o donde se necesita lógica personalizada compleja, Python suele ser la opción más eficiente a largo plazo.
Conclusión
El ETL con Python es uno de los pilares de la ingeniería de datos moderna. Con librerías como pandas, SQLAlchemy y requests tienes todo lo necesario para mover, limpiar y depositar datos de forma controlada, independientemente de su origen o destino. Dominar este proceso te da la capacidad de transformar datos crudos en información lista para analizar, que es exactamente lo que separa un proyecto de datos funcional de uno que nunca llega a producción.
Los puntos clave que puedes aplicar desde hoy son concretos: empieza con pandas para la extracción y transformación, usa SQLAlchemy para la carga en base de datos, valida siempre los datos antes de transformarlos y añade logging desde el primer día. Cuando el pipeline madure, Airflow o Luigi te permitirán automatizarlo sin complicaciones. Cada uno de estos pasos mejora la solidez del flujo y reduce el tiempo que dedicas a corregir errores en producción.
Si llegaste hasta aquí, ya tienes una base sólida para empezar a construir tus propios pipelines. En este sitio web encontrarás más contenido sobre ingeniería de datos, herramientas de procesamiento y buenas prácticas para seguir avanzando en este campo a tu propio ritmo.
Sigue aprendiendo:
Calidad de datos: El secreto que separa buenos de malos análisis
Gobierno de datos: Controla tu información y toma mejores decisiones 📊
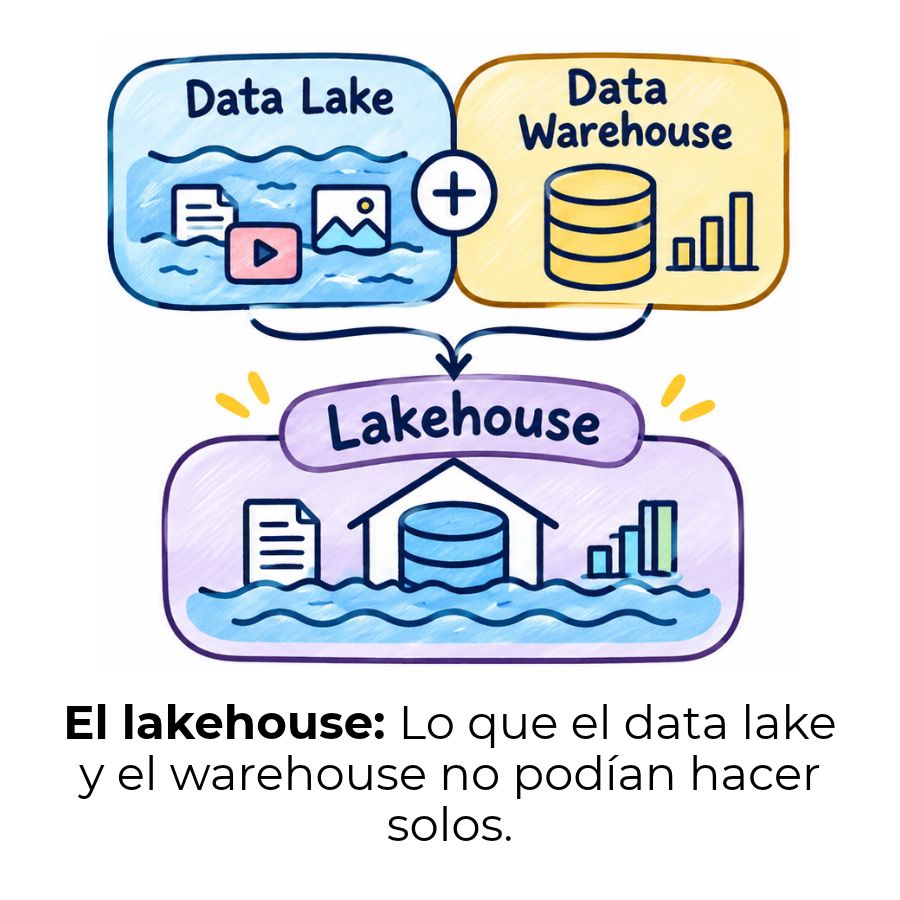
Lakehouse: La arquitectura que unifica todo
Sueldo de un ingeniero de datos: ¿Cuánto gana?
Apache Spark: El motor de datos que no conocías
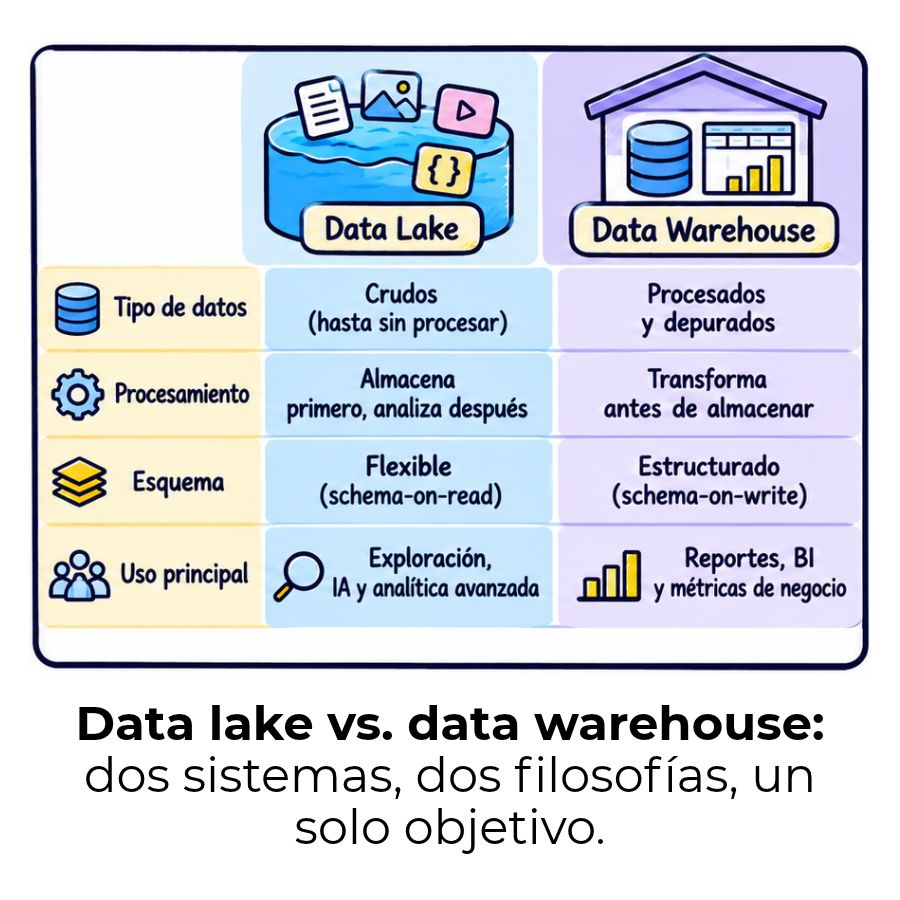
Diferencia entre data lake y data warehouse
AWS Glue: El secreto detrás de los grandes pipelines de datos
¿Qué es un data warehouse y para qué sirve?
