
Imagina que tienes que analizar millones de registros antes del mediodía y tu computadora simplemente no da abasto. Ese es el problema que Apache Spark resuelve cada día en las empresas más grandes del mundo. Si nunca habías oído hablar de él, estás a punto de entender una de las tecnologías más usadas en ingeniería de datos.
¿Qué es Apache Spark?
Apache Spark es un motor de procesamiento de datos distribuido de código abierto diseñado para analizar grandes volúmenes de información de forma rápida y flexible. En lugar de trabajar sobre una sola máquina, distribuye las tareas entre un conjunto de computadoras conectadas —llamado clúster— y las ejecuta de forma paralela, lo que reduce drásticamente el tiempo necesario para procesar volúmenes de datos que serían inmanejables de otra forma.
Lo que distingue a Spark de otras soluciones es su capacidad para procesar datos tanto en lote (batch) como en tiempo real (streaming) usando el mismo motor. Esto lo convierte en una herramienta versátil que se adapta a una gran variedad de proyectos dentro de la ingeniería de datos, desde transformaciones simples hasta modelos de machine learning a escala.
Su origen y quién lo desarrolla
Apache Spark nació en la Universidad de California, Berkeley, como un proyecto de investigación orientado a superar las limitaciones del procesamiento por lotes que ofrecía Hadoop. Desde que fue adoptado por la Apache Software Foundation, se convirtió en un proyecto de código abierto con una comunidad activa de colaboradores de todo el mundo, lo que garantiza actualizaciones continuas y una amplia documentación disponible de forma gratuita.
¿Qué problema resuelve Apache Spark?
Antes de Spark, procesar grandes volúmenes de datos implicaba escribir los resultados intermedios en disco en cada paso del cálculo, lo que ralentizaba todo el proceso. Spark resuelve esto procesando los datos directamente en memoria, eliminando los accesos innecesarios al disco y reduciendo los tiempos de ejecución de forma significativa. Es la diferencia entre esperar horas y obtener resultados en minutos.
¿Cómo funciona Apache Spark por dentro?
Entender cómo funciona Spark internamente te ayuda a saber cuándo tiene sentido usarlo y qué esperar de él. Su lógica de funcionamiento se apoya en tres pilares: un modelo de distribución de tareas, el procesamiento en memoria y una abstracción de datos propia que hace posible el procesamiento paralelo.
El modelo maestro-trabajador
Spark organiza su trabajo mediante un modelo en el que un nodo driver actúa como coordinador central y un conjunto de nodos executor (también llamados workers) ejecutan las tareas reales. El driver recibe el programa, lo analiza, lo convierte en un plan de ejecución y reparte las instrucciones entre los executors. Cada executor trabaja de forma independiente con la porción de datos que le corresponde.
El gestor de clúster —que puede ser YARN, Kubernetes o el modo independiente de Spark— se encarga de asignar los recursos físicos (CPU y memoria) a cada executor según la disponibilidad del sistema. Esta separación de responsabilidades hace que Spark sea escalable: si necesitas más capacidad, simplemente añades más nodos al clúster.
Procesamiento en memoria: la clave de su velocidad
La diferencia de rendimiento más notable entre Spark y sus predecesores está en dónde se guardan los datos durante el procesamiento. Las herramientas tradicionales como Hadoop MapReduce escriben los resultados intermedios en el disco duro después de cada operación. Spark, en cambio, mantiene esos datos en la memoria RAM de las máquinas del clúster mientras sea posible, lo que elimina la latencia asociada a los accesos al disco y acelera enormemente los cálculos iterativos.
Este enfoque es especialmente valioso en algoritmos de machine learning, donde el mismo conjunto de datos se recorre muchas veces durante el entrenamiento de un modelo. Al no tener que leer y escribir en disco en cada iteración, Spark completa esos ciclos mucho más rápido que cualquier alternativa basada en almacenamiento persistente.
RDD, DataFrames y Datasets
Spark maneja los datos mediante tres abstracciones que han evolucionado con el tiempo. Los RDD (Resilient Distributed Datasets) son la estructura original: colecciones de datos inmutables y distribuidas entre los nodos del clúster, tolerantes a fallos por diseño. Los DataFrames introdujeron una API más intuitiva con estructura de tabla, similar a trabajar con SQL. Los Datasets combinan lo mejor de ambos mundos: tipado estático y optimización automática del motor.
| Abstracción | Desde | Tipado | Uso recomendado |
|---|---|---|---|
| RDD | Spark 1.x | Sin tipo | Control de bajo nivel |
| DataFrame | Spark 1.3 | Columnas tipadas | Análisis con SQL y Python |
| Dataset | Spark 1.6 | Tipado estático | Scala y Java con seguridad de tipos |
Componentes principales de Apache Spark
Spark no es solo un motor de procesamiento genérico: viene con un ecosistema de módulos especializados que amplían sus capacidades hacia distintos tipos de problemas. Cada componente se integra con el motor central y comparte la misma infraestructura de clúster, lo que evita tener que aprender herramientas completamente distintas para cada caso de uso.
Spark Core
Spark Core es el motor sobre el que se construye todo lo demás. Gestiona la planificación de tareas, la distribución de trabajo entre los nodos del clúster, la recuperación ante fallos y la comunicación con los sistemas de almacenamiento externos. Sin Spark Core, ningún otro componente del ecosistema podría funcionar, ya que todos dependen de él para ejecutar sus operaciones de forma distribuida.
Spark SQL
Spark SQL permite trabajar con datos estructurados usando sintaxis SQL estándar o mediante la API de DataFrames. Es el punto de entrada más natural para quienes vienen de bases de datos relacionales, porque puedes ejecutar consultas SQL directamente sobre grandes conjuntos de datos distribuidos sin necesidad de aprender una sintaxis completamente nueva. También es compatible con el lenguaje de consulta de Apache Hive.
Spark Streaming
Spark Streaming —y su versión más moderna, Structured Streaming— permite procesar flujos de datos continuos en tiempo real. En lugar de esperar a tener todos los datos disponibles, divide el flujo entrante en pequeños lotes y los procesa de forma casi instantánea. Esto lo hace ideal para casos como la detección de fraude bancario, el análisis de logs de servidores en vivo o el procesamiento de eventos provenientes de dispositivos IoT.
MLlib
MLlib es la biblioteca de machine learning de Spark. Incluye algoritmos de clasificación, regresión, clustering y sistemas de recomendación, todos diseñados para ejecutarse de forma distribuida. Su ventaja principal es que entrena modelos directamente sobre los datos en el clúster, sin necesidad de moverlos a otro sistema, lo que hace viable el entrenamiento con volúmenes que no cabrían en la memoria de una sola máquina.
GraphX
GraphX es el componente de Spark para el procesamiento de grafos, es decir, estructuras de datos formadas por nodos y conexiones entre ellos. Sus aplicaciones más comunes incluyen el análisis de redes sociales, la detección de fraude basada en relaciones entre entidades y los motores de recomendación que necesitan entender cómo se conectan los usuarios entre sí o con los productos que consumen.
¿Para qué sirve Apache Spark en la práctica?
Conocer los componentes de Spark es útil, pero lo que realmente aclara su valor es ver en qué situaciones concretas se aplica. A continuación se describen los tres casos de uso más habituales dentro de los entornos productivos de empresas que trabajan con datos a escala.
Pipelines ETL a gran escala
El caso de uso más extendido de Spark es la construcción de pipelines de ETL (extracción, transformación y carga) que mueven y transforman grandes volúmenes de datos desde múltiples fuentes hacia un destino centralizado. Spark puede leer datos de sistemas muy distintos —bases de datos relacionales, sistemas de archivos distribuidos, servicios en la nube o colas de mensajes como Kafka— y transformarlos aplicando filtros, agregaciones y limpiezas antes de cargarlos al destino.
Este tipo de flujo es el corazón de cualquier arquitectura de datos moderna. Sin un pipeline ETL bien construido, los datos llegan al destino con errores, duplicados o en un formato que no se puede consultar directamente. Spark permite ejecutar esos procesos sobre volúmenes que serían impracticables con herramientas convencionales como pandas o SQL sobre una sola instancia de base de datos.
Análisis en tiempo real
Cuando los datos no pueden esperar a ser procesados al día siguiente, Spark Streaming entra en juego. Un ejemplo claro es el de las plataformas financieras que necesitan evaluar cada transacción en el momento en que ocurre para determinar si es fraudulenta. Spark puede procesar miles de eventos por segundo y ejecutar reglas o modelos sobre cada uno de ellos antes de que el tiempo de respuesta sea crítico para el negocio.
Machine learning distribuido
Entrenar un modelo de machine learning sobre decenas de millones de registros es inviable en una sola máquina. Con MLlib, el proceso de entrenamiento se distribuye entre todos los nodos del clúster, lo que hace posible trabajar con conjuntos de datos que no cabrían ni siquiera en la memoria RAM de los servidores más potentes. Esto abre la puerta a modelos de recomendación, clasificación y predicción que operan a una escala real de producción.
Apache Spark vs. Apache Hadoop: diferencias clave
Hadoop y Spark se mencionan juntos con frecuencia, y eso genera confusión. No son competidores directos: tienen propósitos distintos y en muchos entornos coexisten. Hadoop aporta el sistema de almacenamiento distribuido (HDFS) y el modelo de procesamiento MapReduce, mientras que Spark es un motor de procesamiento que puede usar HDFS como fuente de datos sin depender de MapReduce.
| Criterio | Apache Spark | Apache Hadoop (MapReduce) |
|---|---|---|
| Almacenamiento de datos | No almacena datos (solo los procesa) | Incluye HDFS para almacenamiento |
| Procesamiento | En memoria (RAM) | En disco (lectura/escritura en cada paso) |
| Velocidad | Muy alta en cargas iterativas | Más lento en procesos iterativos |
| Tiempo real | Sí, con Spark Streaming | No de forma nativa |
| Machine learning | Sí, con MLlib integrado | Requiere integración externa |
| Curva de aprendizaje | Media (Python, Scala, SQL) | Alta (Java, configuración de clúster) |
La elección entre uno y otro depende del caso de uso. Para almacenamiento de datos históricos de bajo coste, HDFS (parte del ecosistema Hadoop) sigue siendo una opción válida. Para el procesamiento, Spark ha reemplazado a MapReduce en la mayoría de los proyectos modernos porque ofrece mayor velocidad, más versatilidad y una API mucho más amigable para el desarrollador.
¿Qué lenguajes de programación soporta Apache Spark?
Una de las razones por las que Spark se ha adoptado tan ampliamente es que no obliga a aprender un lenguaje específico. Ofrece APIs oficiales para cuatro lenguajes: Python, Scala, Java y R. Cada una permite acceder a las mismas funcionalidades del motor, aunque con distintos niveles de madurez y rendimiento según el caso.
Python, a través de PySpark, es la opción más popular porque combina la sencillez del lenguaje con toda la potencia del motor. Scala es el lenguaje nativo de Spark —fue el que se usó para escribirlo— y ofrece el mejor rendimiento posible, aunque su curva de aprendizaje es más pronunciada. Java está orientado a quienes ya trabajan en entornos empresariales con ese ecosistema, y R es la elección habitual de estadísticos y científicos de datos que prefieren su sintaxis para el análisis exploratorio.
«Apache Spark es un motor de análisis unificado para el procesamiento de datos a gran escala, con módulos integrados para SQL, streaming, machine learning y procesamiento de grafos.» — Google Cloud, definición oficial de Apache Spark
Preguntas frecuentes
¿Apache Spark es gratuito?
Sí. Apache Spark es un proyecto de código abierto bajo la licencia Apache 2.0, lo que significa que puedes descargarlo, usarlo y modificarlo sin coste. Otra cosa distinta es el coste de la infraestructura necesaria para ejecutarlo: si usas un clúster en la nube, pagarás por los recursos computacionales del proveedor (AWS, Google Cloud, Azure, etc.), pero el software de Spark en sí mismo es completamente gratuito y no tiene licencias de pago.
¿Qué es PySpark y cómo se relaciona con Apache Spark?
PySpark es la API oficial de Apache Spark para el lenguaje Python. No es un producto diferente, sino una capa que permite escribir aplicaciones Spark usando la sintaxis y las librerías de Python. Cuando ejecutas código PySpark, en realidad estás lanzando tareas sobre el motor de Spark, igual que lo harías con Scala o Java. Es el punto de entrada más habitual para quienes ya conocen Python y quieren trabajar con datos a escala sin cambiar de lenguaje.
¿Cuándo conviene usar Apache Spark y cuándo no?
Spark tiene más sentido cuando el volumen de datos supera lo que una sola máquina puede manejar con comodidad, cuando necesitas procesar datos en tiempo real o cuando el flujo de trabajo combina ETL, consultas SQL y machine learning. No es la herramienta adecuada para conjuntos de datos pequeños, ya que el tiempo de arranque del clúster y la sobrecarga de coordinación pueden hacer que sea más lento que pandas o SQL sobre una base de datos convencional.
¿Qué es un clúster en Apache Spark?
Un clúster es un conjunto de máquinas —físicas o virtuales— que trabajan juntas como si fueran una sola. En el contexto de Spark, el clúster está compuesto por un nodo driver, que coordina la ejecución, y varios nodos executor, que realizan el procesamiento real de los datos. El tamaño del clúster determina cuánta capacidad de cómputo tienes disponible y puede ampliarse o reducirse según las necesidades del proyecto.
¿Qué diferencia hay entre un RDD y un DataFrame en Spark?
Un RDD es la abstracción de datos original de Spark: una colección distribuida e inmutable de elementos sin esquema definido, que da al desarrollador control total sobre cómo se procesan los datos. Un DataFrame, en cambio, organiza los datos en columnas con nombre y tipo, como una tabla de base de datos, y permite que el optimizador interno de Spark (Catalyst) mejore automáticamente el plan de ejecución. Para la mayoría de los casos de uso actuales, los DataFrames son la opción recomendada porque son más eficientes y fáciles de usar.
¿Qué empresas usan Apache Spark?
Apache Spark es ampliamente adoptado por empresas que manejan grandes volúmenes de datos en su operación diaria. Entre las organizaciones que lo usan de forma destacada se encuentran plataformas de entretenimiento que procesan el comportamiento de millones de usuarios, compañías financieras que analizan transacciones en tiempo real para detectar fraudes, agencias espaciales que procesan datos de telemetría y gigantes tecnológicos que lo integran en sus plataformas de datos internas. Su adopción está extendida en prácticamente todos los sectores donde el volumen de datos es significativo.
¿Necesito saber Hadoop para aprender Apache Spark?
No. Aunque Spark puede integrarse con el ecosistema Hadoop y leer datos de HDFS, no necesitas conocer Hadoop para empezar a usar Spark. Puedes ejecutarlo en modo local en tu propia computadora durante el aprendizaje, conectarlo a servicios de almacenamiento en la nube como Amazon S3 o Google Cloud Storage, o usarlo en plataformas gestionadas que ya configuran la infraestructura por ti. Lo que sí conviene tener como base es conocimiento de Python o SQL y nociones básicas de cómo funcionan los datos estructurados.
Conclusión
Apache Spark es un motor de procesamiento distribuido que resuelve uno de los problemas más comunes en el trabajo con datos a gran escala: la velocidad. Al procesar la información directamente en memoria y distribuir el trabajo entre múltiples máquinas, hace viable lo que sería imposible en una sola computadora. Su ecosistema de componentes —SQL, streaming, machine learning y grafos— lo convierte en una herramienta completa para casi cualquier flujo de trabajo de datos moderno.
Si ya manejas Python o SQL, tienes una base más que suficiente para empezar a explorar Spark con PySpark. Los conceptos que has visto aquí —clúster, driver, executors, DataFrames, batch y streaming— son el punto de partida que te permite leer documentación, entender arquitecturas y tomar decisiones informadas sobre cuándo y cómo aplicar esta tecnología en tus proyectos.
El campo de la ingeniería de datos tiene mucho más por descubrir, y cada concepto que dominas abre la puerta al siguiente. Este sitio web tiene más contenido sobre las tecnologías y fundamentos que forman parte de este ecosistema, así que si te quedaste con curiosidad, el mejor momento para seguir aprendiendo es ahora.
Sigue aprendiendo:
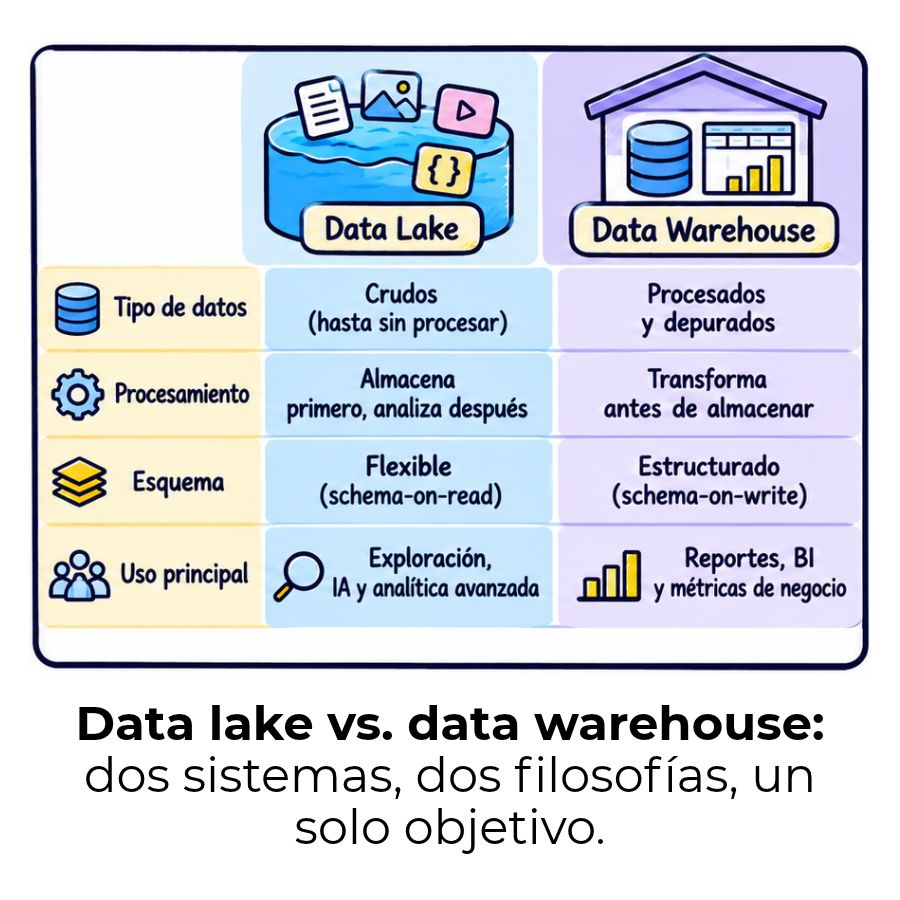
Diferencia entre data lake y data warehouse
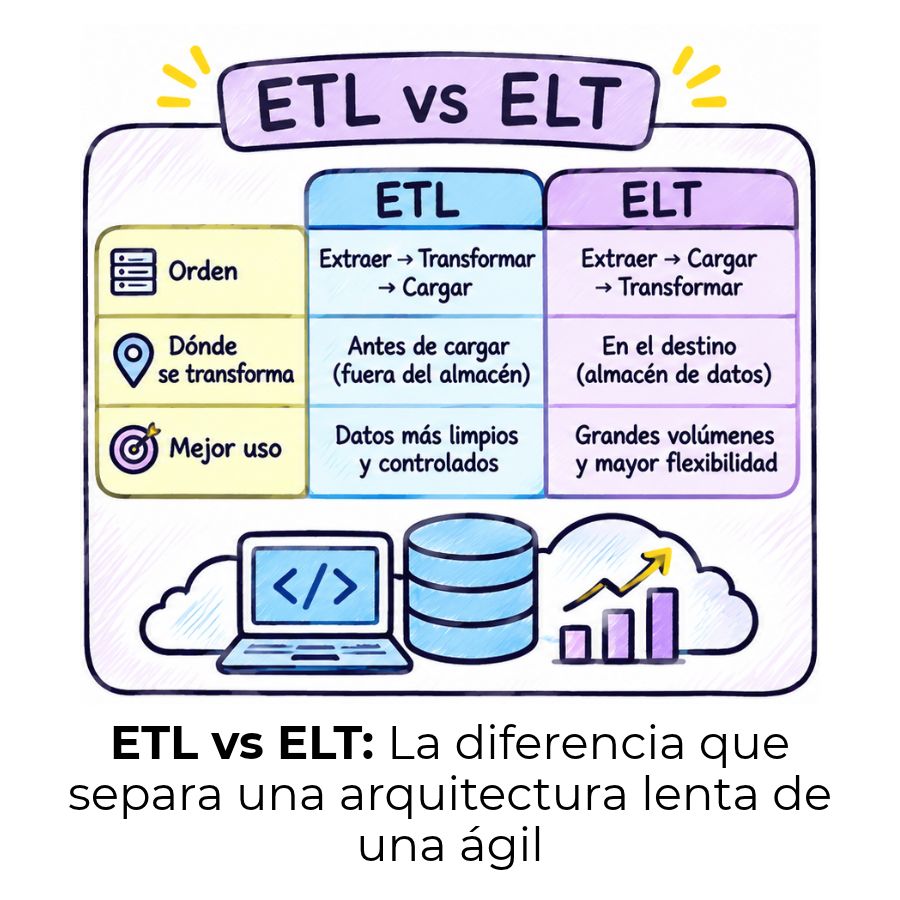
ETL vs. ELT: Transforma tus datos con la estrategia correcta
Apache Airflow: Automatiza y controla tus flujos de datos con Python
Ingesta de datos: Transforma fuentes caóticas en valor real
Calidad de datos: El secreto que separa buenos de malos análisis
¿Qué hace un ingeniero de datos?
DBT: La herramienta que cambió cómo se trabajan los datos
Cómo ser ingeniero de datos desde cero
