
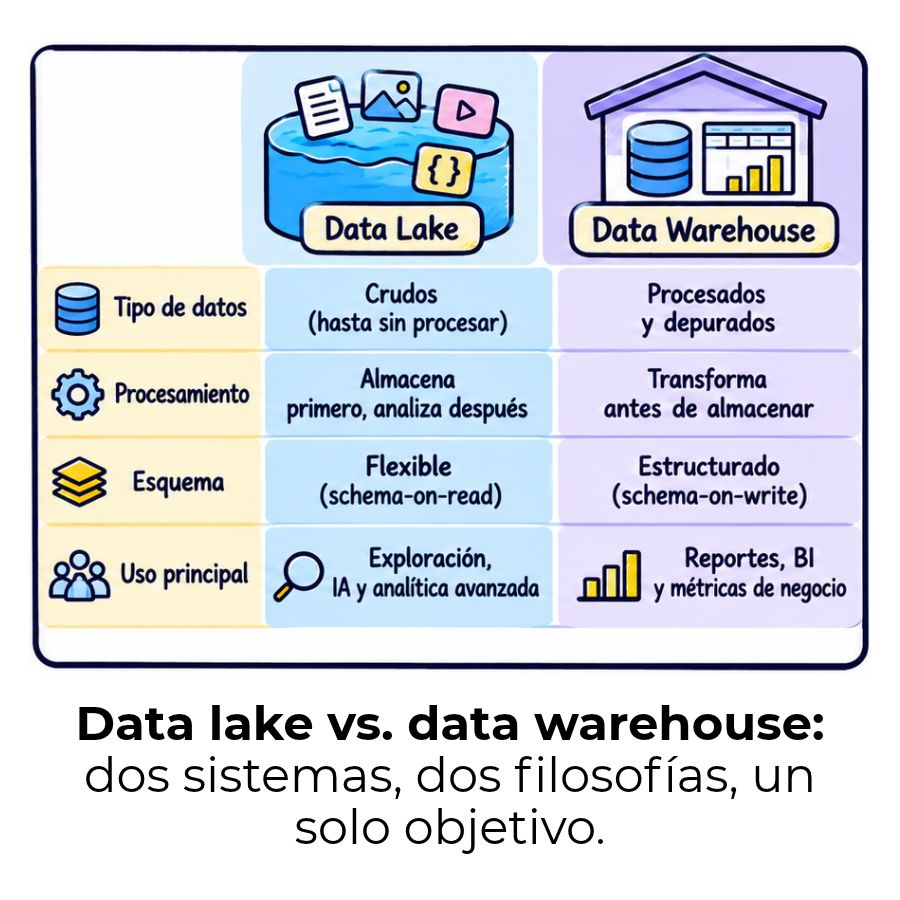
Cuando escuchas hablar de data lake y data warehouse en el mismo párrafo, es fácil asumir que son variantes del mismo sistema. No lo son. Uno almacena todo sin condiciones; el otro solo acepta lo que ya está limpio y organizado. Esa diferencia, aunque parece técnica, cambia por completo cómo una empresa trabaja con sus datos.
¿Qué es un data lake y cómo almacena los datos?
Un data lake es un repositorio centralizado que almacena datos en su formato original, sin ningún tipo de transformación previa. Acepta cualquier tipo de dato: estructurado, semiestructurado y no estructurado, desde registros de transacciones hasta imágenes, audio, vídeos o datos de sensores IoT. Todo entra tal como llega desde la fuente.
La lógica detrás de este enfoque es sencilla: primero almacenas, después decides qué hacer con cada dato. Esto significa que el sistema no impone ningún esquema en el momento de la carga, lo que lo hace especialmente útil cuando el volumen de información es enorme o cuando aún no sabes exactamente cómo vas a analizarla.
Características principales de un data lake
El data lake se diferencia de otros sistemas por una serie de propiedades que lo hacen muy atractivo para equipos técnicos que trabajan con grandes volúmenes de información heterogénea. Su capacidad para ingerir cualquier tipo de dato sin procesar es su ventaja más distintiva, ya que elimina la necesidad de definir una estructura antes de comenzar a almacenar.
- Almacenamiento multiformato: Admite datos estructurados como tablas SQL, semiestructurados como archivos JSON o XML, y no estructurados como imágenes, vídeos y registros de texto libre.
- Coste de almacenamiento bajo: Se construye sobre soluciones de almacenamiento de objetos de bajo coste, como AWS S3 o Azure Data Lake Storage, lo que permite guardar petabytes de información a un precio reducido.
- Alta escalabilidad: El cómputo y el almacenamiento se separan de forma independiente; así puedes aumentar la capacidad sin rediseñar toda la arquitectura.
- Flexibilidad en el análisis: Los datos se conservan en su formato original hasta que un científico de datos o ingeniero decide cómo procesarlos, lo que preserva toda la información sin descartar nada.
- Orientado a exploración: Es el sistema preferido cuando todavía no sabes exactamente qué preguntas harás a los datos, o cuando los proyectos de análisis cambian con frecuencia.
¿Cómo funciona el schema-on-read?
El concepto de schema-on-read es uno de los pilares del data lake. Significa que el esquema de los datos —su estructura, tipos de columnas y relaciones— solo se aplica en el momento de leerlos, no cuando se almacenan. Esto contrasta directamente con el enfoque del data warehouse, que exige definir la estructura antes de cargar cualquier dato.
En la práctica, esto permite a los ingenieros de datos ingerir información de múltiples fuentes sin necesidad de transformarla de antemano. Cuando un científico de datos quiere analizarla, aplica el esquema que necesita sobre la marcha. Es un enfoque más ágil, aunque requiere mayor conocimiento técnico para extraer valor de los datos almacenados.
¿Qué es un data warehouse y para qué sirve?
Un data warehouse es un sistema de almacenamiento diseñado para guardar datos ya procesados, limpios y organizados bajo un esquema predefinido. Su propósito principal es facilitar el análisis estructurado y la generación de informes de negocio de forma rápida y consistente, con un alto rendimiento en consultas SQL sobre grandes volúmenes de datos históricos.
A diferencia del data lake, el data warehouse no admite datos en bruto. Antes de que cualquier dato llegue a él, debe pasar por un proceso de limpieza, transformación y validación. Esto garantiza que todo lo que hay dentro sea coherente, fiable y esté listo para usarse directamente en dashboards o análisis ejecutivos.
Características principales de un data warehouse
El data warehouse está diseñado para ofrecer velocidad y consistencia en el análisis. Su valor reside en la calidad y fiabilidad de los datos que contiene, no en la cantidad de formatos que puede aceptar. Todo lo que entra ya ha sido validado, lo que garantiza que cualquier consulta devuelva resultados precisos y coherentes.
- Datos estructurados y limpios: Solo almacena información procesada que cumple un esquema predefinido, lo que garantiza alta calidad y consistencia en los resultados.
- Alto rendimiento en consultas: Está optimizado para ejecutar consultas SQL complejas sobre grandes volúmenes de datos históricos de forma rápida y eficiente.
- Gobernanza y seguridad: Al ser más compacto y estructurado, resulta más sencillo aplicar controles de acceso, políticas de retención y auditorías de calidad de datos.
- Orientado al negocio: Su diseño parte de preguntas concretas que el negocio necesita responder, como ventas por región o tendencias financieras trimestrales.
- Acceso para analistas no técnicos: Los analistas de negocio pueden trabajar directamente con los datos sin necesidad de conocer herramientas de procesamiento avanzado.
¿Cómo funciona el proceso ETL en un data warehouse?
ETL son las siglas de Extract, Transform, Load: extraer, transformar y cargar. Es el proceso que siguen los datos antes de llegar al data warehouse. Primero se extraen de las fuentes originales —sistemas ERP, CRM, bases de datos transaccionales—, luego se limpian y transforman para cumplir el esquema del warehouse, y finalmente se cargan de forma organizada.
Este proceso garantiza que todos los datos que entran en el warehouse sean coherentes entre sí, incluso si provienen de sistemas muy distintos. El coste está en el tiempo y recursos que requiere diseñar y mantener estos pipelines de transformación, especialmente cuando las fuentes de datos cambian con frecuencia.
¿Cuál es la diferencia entre un data lake y un data warehouse?
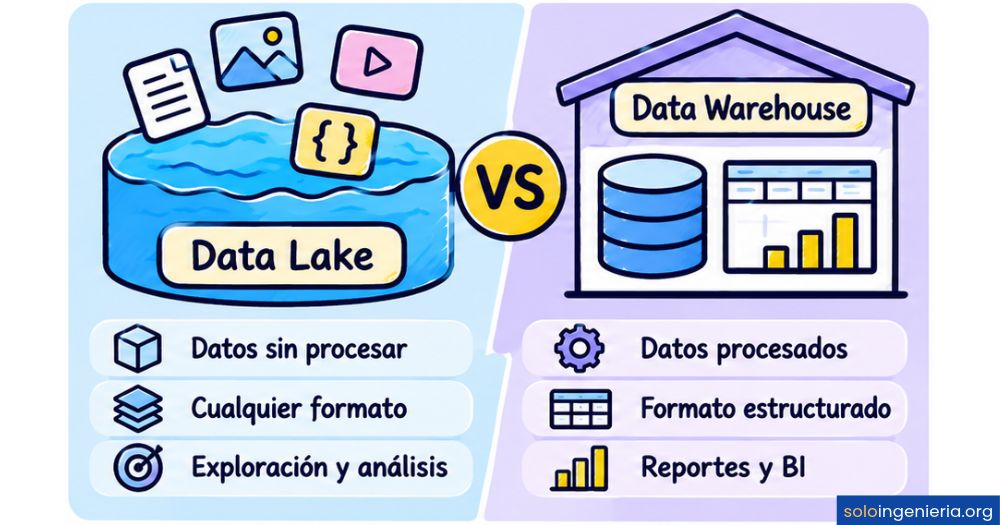
La diferencia fundamental entre ambos sistemas no es solo técnica: refleja dos filosofías distintas sobre cómo gestionar y preparar los datos para el análisis. El data lake prioriza la flexibilidad y la conservación íntegra de la información. El data warehouse prioriza la precisión, la velocidad y la accesibilidad para el negocio. Conocer esta distinción es el punto de partida de cualquier arquitectura de datos bien diseñada.
| Característica | Data lake | Data warehouse |
|---|---|---|
| Tipo de datos | Estructurados, semiestructurados y no estructurados | Solo datos estructurados |
| Esquema | Schema-on-read (al leer) | Schema-on-write (al cargar) |
| Estado de los datos | Brutos, sin procesar | Procesados y limpios |
| Flexibilidad | Alta | Baja |
| Rendimiento en consultas | Menor (sin preparación previa) | Alto (optimizado para SQL y BI) |
| Coste de almacenamiento | Bajo | Más elevado |
| Usuarios principales | Científicos e ingenieros de datos | Analistas de negocio y ejecutivos |
| Casos de uso | Machine learning, IA, big data, análisis exploratorio | BI, reporting, análisis histórico, dashboards |
Tipo de datos que almacena cada sistema
El data lake no discrimina: acepta tablas relacionales, archivos de registro de servidores, publicaciones de redes sociales, imágenes médicas o señales de sensores industriales. Todo convive en el mismo repositorio sin necesidad de transformarse previamente. Esta apertura total es lo que lo convierte en el punto de entrada ideal para cualquier proyecto de datos a gran escala.
El data warehouse, en cambio, solo trabaja con datos estructurados: información con columnas y tipos definidos que encajan en tablas relacionales. Antes de llegar ahí, cualquier dato no estructurado debe transformarse para adoptar ese formato. Esto restringe los tipos de fuentes que puede absorber, pero garantiza que todo lo que contiene sea inmediatamente utilizable para el análisis.
Flexibilidad frente a rendimiento en consultas
El data lake ofrece una flexibilidad que el warehouse no puede igualar: puedes añadir nuevas fuentes de datos sin rediseñar ningún esquema. Sin embargo, esa libertad tiene un precio: las consultas son más lentas porque los datos no están optimizados para la recuperación rápida. Cada vez que un analista quiere explorar algo, el sistema debe aplicar el esquema en el momento de la lectura.
El data warehouse sacrifica flexibilidad para ganar en velocidad. Sus datos están modelados, indexados y organizados de forma que las consultas SQL complejas se ejecutan en segundos. Para los equipos de negocio que necesitan respuestas rápidas y predecibles, este rendimiento es innegociable. Cambiar la estructura una vez que el warehouse está en producción, sin embargo, puede ser costoso.
Coste de almacenamiento y escalabilidad
Uno de los factores más decisivos al elegir entre ambos sistemas es el coste. El data lake se apoya en almacenamiento de objetos de bajo coste, lo que permite guardar volúmenes masivos de información —incluso petabytes— sin que el gasto se dispare. Es el motivo por el que muchas organizaciones lo usan como repositorio principal de datos históricos sin procesar.
El data warehouse requiere una infraestructura más especializada y, en muchos casos, licencias de software para optimizar las consultas. Esto eleva el coste tanto de implantación como de mantenimiento. Dicho esto, para volúmenes de datos más acotados y consultas repetidas y predecibles, el warehouse puede ser más rentable que un lake mal gestionado que acumula datos sin valor.
Usuarios y perfiles profesionales de cada sistema
El data lake es el territorio de los científicos de datos y los ingenieros de datos. Trabajar con él requiere conocimientos de procesamiento avanzado, lenguajes como Python o Spark, y la capacidad de diseñar pipelines que extraigan valor de datos sin estructura definida. No es un sistema pensado para usuarios no técnicos.
El data warehouse está pensado para ser accesible a analistas de negocio y perfiles ejecutivos que necesitan consultar métricas, generar informes o explorar dashboards. Pueden hacerlo con SQL estándar o mediante herramientas de BI como Tableau o Power BI, sin necesidad de conocer la infraestructura subyacente del sistema.
Casos de uso: ¿cuándo usar cada uno?
Elegir entre un data lake y un data warehouse no depende de cuál sea mejor en términos absolutos, sino de qué necesitas hacer con tus datos y quién va a trabajar con ellos. La decisión correcta parte siempre de la estrategia de datos de tu organización, no de modas tecnológicas. Estos son los escenarios donde cada sistema brilla de forma natural.
Escenarios ideales para un data lake
Escenarios ideales para un data warehouse
¿Puede un data lake reemplazar a un data warehouse?
Esta es una de las preguntas más frecuentes al adentrarse en la ingeniería de datos. La respuesta corta es: no de forma directa ni en todos los casos. Aunque el data lake es mucho más flexible y económico para almacenar grandes volúmenes de información, no ofrece por sí solo el rendimiento ni la consistencia que los equipos de negocio necesitan para trabajar con dashboards y reportes en tiempo real.
El data lake sin gobernanza es un riesgo real. Sin propietarios claros, sin catálogo de datos y sin políticas de calidad, puede convertirse en lo que los profesionales del sector llaman un data swamp o pantano de datos: un repositorio enorme lleno de información que nadie sabe cómo usar ni en qué estado se encuentra. La gestión activa es tan importante como la tecnología elegida.
«Un lago sin gobernanza se convierte en un pantano: muchos datos, poco valor y ninguna dirección clara.»
En la práctica, la mayoría de las organizaciones maduras no eligen entre uno u otro: los combinan. El data lake actúa como repositorio de entrada para datos brutos de múltiples fuentes; el data warehouse recibe los datos ya transformados y estructurados para servir directamente a los equipos de análisis. Cada sistema cumple su función sin intentar sustituir al otro.
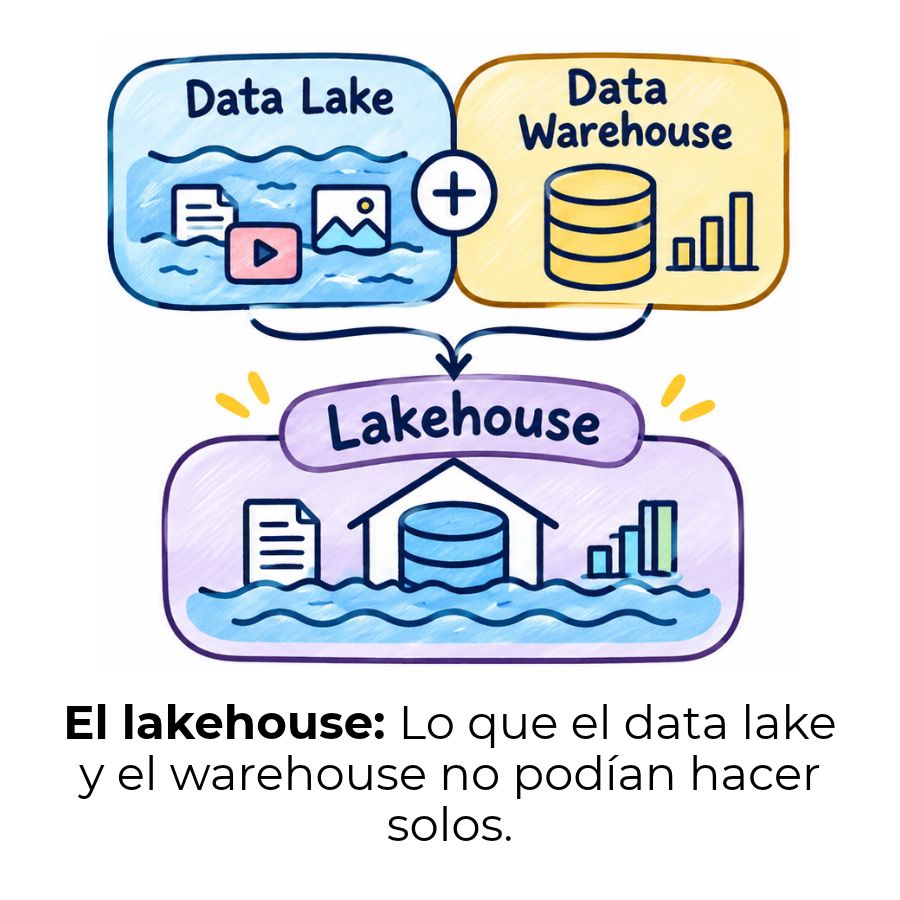
Data lakehouse: la arquitectura que combina ambos enfoques
El data lakehouse es una arquitectura moderna que nace precisamente de la limitación de tener que mantener dos sistemas separados. Combina la flexibilidad y el bajo coste del data lake con el rendimiento y la gobernanza del data warehouse, todo sobre una sola plataforma de almacenamiento en la nube con formatos abiertos.
La propuesta del lakehouse resuelve uno de los problemas prácticos más frecuentes: mantener dos copias del mismo dato —una en el lake, otra en el warehouse— para satisfacer necesidades distintas. Al unificar ambos sistemas, el lakehouse reduce costes operativos y elimina los problemas de sincronización que surgen cuando los datos evolucionan en paralelo en dos plataformas diferentes.
Plataformas como Databricks con Delta Lake o Apache Iceberg son ejemplos reales de esta arquitectura. Permiten ejecutar consultas de alto rendimiento sobre almacenamiento de bajo coste y en formatos abiertos, con soporte simultáneo para cargas de trabajo de machine learning y para dashboards de negocio, sin necesidad de mover datos entre sistemas.
Preguntas frecuentes
¿Cuál es la diferencia principal entre un data lake y un data warehouse?
La diferencia más importante radica en el estado de los datos y en el momento en que se aplica la estructura. Un data lake almacena datos en bruto, en cualquier formato, sin transformación previa, aplicando el esquema solo cuando los datos se leen. Un data warehouse, en cambio, exige que los datos lleguen ya procesados y estructurados, y aplica el esquema en el momento de la carga. Esta diferencia determina qué perfiles pueden usarlos y para qué tipo de análisis son adecuados.
¿Qué tipo de datos almacena un data lake?
Un data lake puede almacenar cualquier tipo de dato sin restricciones de formato. Esto incluye datos estructurados como tablas de bases de datos relacionales, datos semiestructurados como archivos JSON, XML o logs de servidor, y datos no estructurados como imágenes, vídeos, grabaciones de audio o texto libre. Esta capacidad multiformato es la principal ventaja del data lake frente al data warehouse, que solo trabaja con datos ya organizados en columnas y filas.
¿Qué es el schema-on-read y el schema-on-write?
Son dos enfoques opuestos para definir la estructura de los datos. El schema-on-write, propio del data warehouse, obliga a definir el esquema antes de cargar los datos: columnas, tipos de datos y relaciones deben estar definidos con antelación. El schema-on-read, propio del data lake, hace lo contrario: los datos se almacenan sin estructura fija y el esquema se aplica en el momento de leerlos, lo que otorga mucha más libertad, pero requiere mayor conocimiento técnico para extraer valor de ellos.
¿Qué perfil profesional trabaja con cada sistema?
Los perfiles técnicos como científicos de datos e ingenieros de datos son los principales usuarios del data lake, ya que requiere conocimientos de herramientas de procesamiento como Spark, Python o lenguajes de consulta sobre datos no estructurados. El data warehouse está orientado a analistas de negocio, controllers financieros y perfiles directivos que necesitan acceder a informes y dashboards sin necesidad de programar. La accesibilidad del warehouse para usuarios no técnicos es una de sus mayores fortalezas.
¿Cuándo conviene usar un data lake en lugar de un data warehouse?
El data lake es la mejor opción cuando trabajas con grandes volúmenes de datos heterogéneos, cuando tus proyectos incluyen machine learning o inteligencia artificial, o cuando aún no sabes exactamente qué preguntas harás a los datos. También es preferible cuando el coste de almacenamiento es una variable crítica, ya que las soluciones de object storage que soportan los data lakes son significativamente más económicas. Si tu equipo incluye científicos de datos y tus necesidades de análisis son exploratorias, el data lake encaja mejor.
¿Qué es un data lakehouse y en qué se diferencia de los otros dos?
El data lakehouse es una arquitectura híbrida que combina las ventajas del data lake y del data warehouse en una sola plataforma. Ofrece la flexibilidad y el bajo coste de almacenamiento del lake, junto con el rendimiento en consultas y la gobernanza del warehouse. La clave es que permite ejecutar tanto cargas de trabajo de machine learning como consultas de BI sobre el mismo repositorio de datos, eliminando la necesidad de mantener dos sistemas separados y los problemas de sincronización que eso conlleva.
¿Es más económico un data lake que un data warehouse?
En términos de coste por gigabyte almacenado, sí: el data lake es considerablemente más económico porque se apoya en almacenamiento de objetos de bajo coste como AWS S3 o Azure Data Lake Storage. Sin embargo, el coste total de propiedad depende de más factores. Un data lake mal gestionado puede volverse muy costoso en términos de tiempo de ingeniería para diseñar pipelines y mantener la calidad de los datos. El data warehouse tiene un coste inicial mayor, pero ofrece un rendimiento predecible que reduce el esfuerzo de análisis a largo plazo.
Conclusión
La diferencia entre un data lake y un data warehouse no se reduce a una cuestión técnica: es una decisión estratégica sobre cómo tu organización quiere gestionar, almacenar y aprovechar sus datos. El data lake te da libertad total para ingerir cualquier tipo de información sin procesar; el data warehouse te ofrece estructura, consistencia y velocidad para el análisis de negocio. Ninguno es universalmente superior: cada uno responde a necesidades distintas.
Lo más valioso que puedes llevarte de este recorrido es saber qué preguntas hacerte antes de elegir un sistema: ¿qué tipo de datos vas a manejar?, ¿quién los va a consultar?, ¿qué tipo de análisis necesitas? Con esas respuestas claras, puedes decidir si te conviene un lake, un warehouse o incluso una arquitectura lakehouse que combine lo mejor de ambos. Ese razonamiento es el punto de partida de cualquier estrategia de datos sólida.
Si este tema te ha resultado útil, en este sitio web encontrarás mucho más contenido sobre ingeniería de datos, arquitecturas modernas y herramientas que te ayudarán a seguir construyendo tu conocimiento en este campo. Cada concepto que dominas hoy es una base más firme para los proyectos que vendrán.
Sigue aprendiendo:
¿Qué es un data lake y cómo funciona?
Gobierno de datos: Controla tu información y toma mejores decisiones 📊
Calidad de datos: El secreto que separa buenos de malos análisis
AWS Glue: El secreto detrás de los grandes pipelines de datos
Herramientas ETL: Elige la correcta y ahorra horas de trabajo
DBT: La herramienta que cambió cómo se trabajan los datos
Lakehouse: La arquitectura que unifica todo
Cómo ser ingeniero de datos desde cero
