
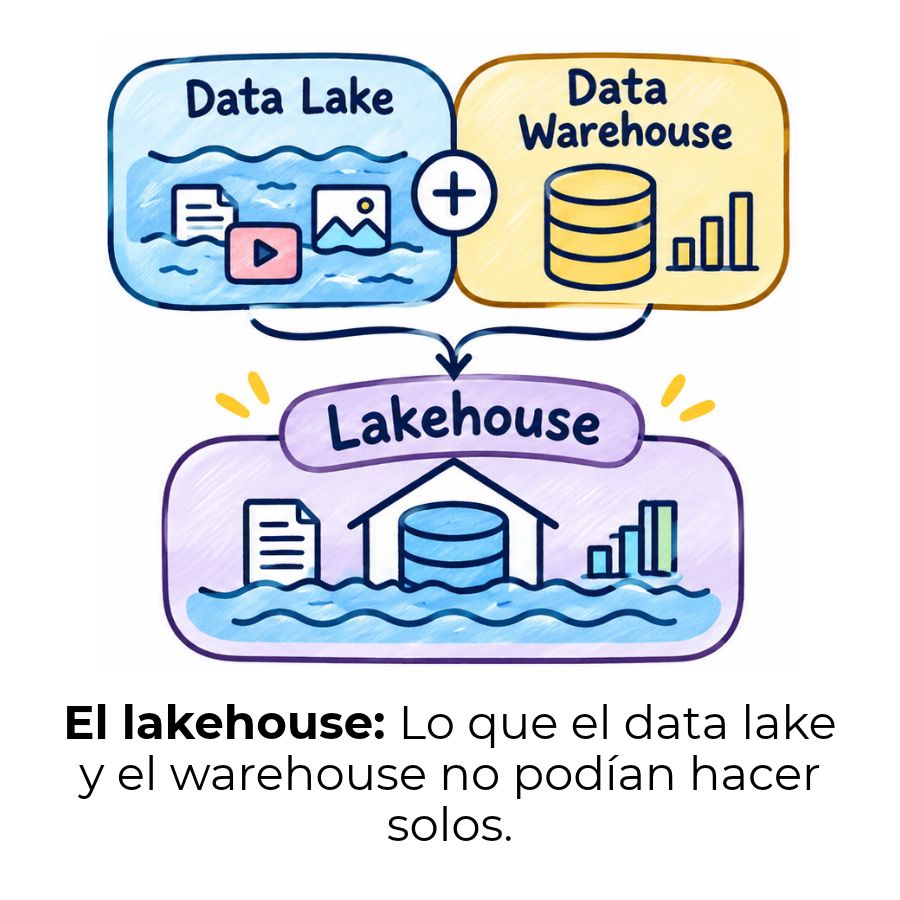
Un lakehouse es una arquitectura de datos que combina la flexibilidad de almacenamiento de un data lake con la estructura y el rendimiento de un data warehouse. Si alguna vez te has preguntado cómo las empresas gestionan datos crudos y estructurados en un mismo sistema sin duplicar infraestructura, aquí encontrarás la respuesta clara y paso a paso.
¿Qué es un lakehouse y por qué existe?
Un lakehouse es una arquitectura de datos moderna que combina la capacidad de almacenamiento flexible de un data lake con la estructura, la gobernanza y el rendimiento de un data warehouse, todo dentro de una sola plataforma unificada. No es simplemente la suma de dos sistemas: es un enfoque diseñado para eliminar los problemas que surgen cuando ambos coexisten de forma separada en una organización.
Antes de que existiera el lakehouse, las empresas solían mantener dos infraestructuras paralelas. Por un lado, un data lake para almacenar datos en bruto de cualquier tipo; por otro, un data warehouse para consultar datos estructurados con rapidez. Mantener ambos sincronizados generaba costos operativos altos, datos desactualizados y una carga de ingeniería constante que frenaba la toma de decisiones.
El problema que el lakehouse viene a resolver
Durante años, los equipos de datos tuvieron que elegir entre flexibilidad y rendimiento. El data lake ofrecía la primera, pero sin la capacidad de hacer consultas rápidas ni garantizar la consistencia de los datos. El data warehouse daba lo segundo, pero solo con datos previamente transformados y estructurados. El resultado habitual era una arquitectura de dos capas con alta complejidad de mantenimiento y datos que a veces llegaban desactualizados al equipo de negocio.
¿De dónde surge el término lakehouse?
El concepto fue formalizado por investigadores de Databricks alrededor de 2020, aunque la idea de combinar ambas arquitecturas ya se venía desarrollando en la industria. La palabra es una fusión directa de data lake y data warehouse, y resume exactamente la propuesta: un sistema único que hereda lo mejor de cada uno. Plataformas como Delta Lake, creada por Databricks, hicieron posible llevar esa idea a producción a escala empresarial.
¿Cómo funciona un lakehouse por dentro?
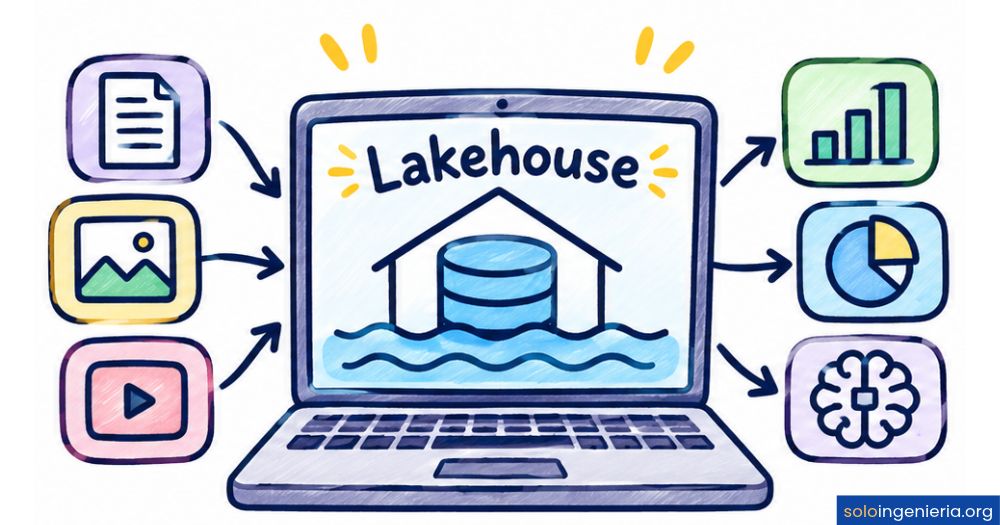
El lakehouse no es una caja negra. Se estructura en capas bien definidas que trabajan juntas para ofrecer la flexibilidad de un data lake con el rendimiento de un data warehouse. Entender esas capas te ayuda a comprender por qué esta arquitectura puede servir a tantos equipos distintos dentro de una misma organización.
① Capa de ingesta
Los datos llegan desde múltiples fuentes: bases de datos operacionales, APIs, dispositivos IoT, archivos de registro. El lakehouse los acepta en cualquier formato (estructurado, semiestructurado o no estructurado) y los almacena en almacenamiento de objetos en la nube, como Amazon S3, Azure Data Lake Storage o Google Cloud Storage, a bajo costo.
② Capa de metadatos y transacciones
Aquí reside la clave del lakehouse. Esta capa añade una capa de metadatos sobre el almacenamiento crudo que habilita transacciones ACID, control de versiones, seguimiento del linaje de datos y evolución del esquema. Formatos como Delta Lake o Apache Iceberg gestionan esta capa y son los que convierten un data lake ordinario en un lakehouse real.
③ Capa de procesamiento y consulta
Distintos motores pueden leer los mismos datos en paralelo sin copiarlos: un motor SQL para los analistas de negocio, Apache Spark para los ingenieros de datos y frameworks de machine learning para los científicos de datos. Que varios equipos compartan los mismos datos en tiempo real, sin moverlos, es uno de los mayores aportes del lakehouse.
Características principales de un lakehouse
El lakehouse no se define solo por combinar dos arquitecturas. Lo que lo distingue es un conjunto de capacidades técnicas que lo hacen confiable para entornos de producción real. Estas son las más relevantes que debes conocer:
- Transacciones ACID: Garantizan que las operaciones sobre los datos (insertar, actualizar, eliminar) se completan de forma íntegra o no se ejecutan en absoluto, evitando estados inconsistentes en los datos.
- Almacenamiento en formatos abiertos: Los datos se guardan en formatos como Parquet con capas de metadatos abiertas (Delta Lake, Apache Iceberg, Apache Hudi), lo que evita la dependencia de un único proveedor y permite que múltiples motores los lean.
- Separación de procesamiento y almacenamiento: El cómputo y el almacenamiento escalan de forma independiente, lo que permite ajustar los recursos según la demanda sin pagar por capacidad que no se usa.
- Soporte para todos los tipos de datos: Datos estructurados, semiestructurados (JSON, XML) y no estructurados (imágenes, vídeos, texto libre) conviven en el mismo sistema sin necesidad de transformaciones previas.
- Gobernanza y linaje de datos: El lakehouse registra de dónde vienen los datos, qué transformaciones han sufrido y quién puede acceder a ellos, algo crítico para cumplir con regulaciones y mantener la calidad.
- Soporte nativo para machine learning e inteligencia artificial: Los científicos de datos pueden entrenar modelos directamente sobre los datos del lakehouse sin necesidad de exportarlos a otro sistema.
- Ingestión en tiempo real: El lakehouse puede recibir flujos de datos continuos y ponerlos a disposición de los usuarios casi de inmediato, sin esperar a que terminen procesos por lotes.
Lakehouse vs. data lake vs. data warehouse: ¿cuál es la diferencia?
Comprender la diferencia entre las tres arquitecturas es fundamental para saber cuál se adapta mejor a cada situación. La tabla siguiente resume los aspectos más importantes de cada una para que puedas compararlas de un vistazo:
| Aspecto | Data Warehouse | Data Lake | Lakehouse |
|---|---|---|---|
| Tipos de datos | Solo estructurados | Estructurados, semiestructurados y no estructurados | Estructurados, semiestructurados y no estructurados |
| Esquema | Schema on write (estricto) | Schema on read (flexible) | Schema on write en formato abierto |
| Costo de almacenamiento | Alto (formato propietario) | Bajo (almacenamiento de objetos) | Bajo (almacenamiento de objetos) |
| Rendimiento en consultas SQL | Muy alto | Variable, depende del motor | Alto, comparable al warehouse |
| Transacciones ACID | Sí | No (nativo) | Sí |
| Gobernanza | Sólida | Limitada sin herramientas adicionales | Sólida |
| Machine learning | Difícil con datos crudos | Sí, pero sin estructura | Sí, con estructura y gobernanza |
| Usuarios principales | Analistas BI | Científicos de datos, ingenieros | Analistas, científicos e ingenieros |
Si quieres profundizar en las diferencias entre las dos arquitecturas que el lakehouse fusiona, puedes leer más sobre la diferencia entre data lake y data warehouse, donde encontrarás cada concepto explicado por separado y con más detalle.
¿Cuándo tiene sentido usar un lakehouse?
El lakehouse no es siempre la respuesta correcta para cualquier equipo. Es una arquitectura especialmente útil cuando hay varios perfiles de usuarios que necesitan trabajar sobre los mismos datos con propósitos distintos, o cuando el volumen y la variedad de datos hacen que mantener dos sistemas separados sea demasiado costoso.
¿Tu situación encaja con el lakehouse?
✔ Tienes datos de múltiples tipos
Tu organización genera datos estructurados (ventas, registros), semiestructurados (logs, JSON) y no estructurados (documentos, imágenes) que necesitan estar en un solo lugar.
✔ Varios equipos comparten los mismos datos
Analistas de negocio, ingenieros de datos y científicos de datos necesitan acceder a las mismas fuentes sin que unos interfieran con los procesos de los otros.
✔ Tienes proyectos de machine learning activos
Entrenar modelos requiere datos en bruto y en volumen. El lakehouse permite acceder a ellos directamente sin copiarlos a un entorno separado, ahorrando tiempo y almacenamiento.
✔ El costo de mantener dos sistemas es alto
Si ya tienes un data lake y un data warehouse y la sincronización entre ellos consume tiempo y recursos, el lakehouse puede consolidar ambos en una sola capa de almacenamiento de bajo costo.
✔ Necesitas datos actualizados en tiempo real
Si los procesos de negocio dependen de información reciente y los procesos por lotes introducen retrasos que se notan, la ingestión en tiempo real del lakehouse puede cerrar esa brecha.
✘ No siempre es la mejor opción
Si tu equipo es pequeño, solo trabaja con datos SQL bien estructurados y no tiene proyectos de ciencia de datos, un data warehouse tradicional puede ser más simple y suficiente.
Formatos de tabla abiertos que hacen posible el lakehouse
El lakehouse no podría existir sin los formatos de tabla abiertos, que son la pieza técnica que añade transacciones, control de versiones y gobernanza directamente sobre el almacenamiento de objetos. Los tres principales son Delta Lake, Apache Iceberg y Apache Hudi, y aunque comparten objetivos similares, cada uno tiene un origen y un punto fuerte diferente.
Delta Lake
Delta Lake nació en Databricks y es el formato con integración más profunda con Apache Spark. Añade una capa transaccional sobre archivos Parquet, lo que habilita transacciones ACID, viaje en el tiempo (acceso a versiones anteriores de los datos), evolución de esquemas y operaciones de merge eficientes. Databricks lo impulsa como estándar abierto y todas las tablas de su plataforma usan Delta Lake por defecto.
Apache Iceberg
Apache Iceberg fue creado originalmente en Netflix para resolver problemas de escala con tablas muy grandes. Su diseño separa los metadatos del almacenamiento físico, lo que permite una evolución eficiente del esquema y de las particiones sin reescribir los datos. Es el formato preferido cuando se quiere una arquitectura multi-motor sin depender de un único proveedor, ya que Spark, Flink, Trino, Dremio y BigQuery pueden leerlo de forma nativa.
Apache Hudi
Apache Hudi fue desarrollado en Uber para gestionar flujos de datos con alta frecuencia de actualizaciones e inserciones. Su diferencial está en el soporte eficiente de operaciones como upserts (insertar o actualizar según exista el registro) y en su capacidad para capturar cambios incrementales en los datos (CDC), lo que lo hace especialmente adecuado para pipelines de datos en tiempo real con datos mutables.
Plataformas lakehouse más usadas hoy
El ecosistema del lakehouse ha madurado rápidamente. Hoy existen plataformas consolidadas tanto en entornos de nube como en proyectos de código abierto, cada una con sus propias fortalezas. Conocerlas te ayuda a entender qué opciones tiene un equipo de ingeniería de datos al momento de diseñar su arquitectura.
- Databricks Lakehouse Platform: La plataforma que popularizó el concepto. Se basa en Apache Spark y Delta Lake, y ofrece un entorno unificado para ingeniería de datos, ciencia de datos y análisis con SQL. Es la opción más adoptada en equipos con cargas de trabajo intensivas en ML.
- Apache Iceberg + motores abiertos: Muchas organizaciones construyen su propio lakehouse combinando Apache Iceberg con motores como Trino, Flink o Dremio sobre almacenamiento de objetos en la nube. Esta vía ofrece máxima flexibilidad y evita la dependencia de un único proveedor.
- Microsoft Fabric: La respuesta de Microsoft al paradigma del lakehouse. Integra análisis, ingeniería de datos, ciencia de datos y almacenamiento en un entorno unificado dentro del ecosistema Azure, con soporte para formatos abiertos como Delta Lake.
- Google BigLake: La propuesta de Google Cloud que permite aplicar las capacidades de gobernanza y control de acceso de BigQuery directamente sobre datos almacenados en Cloud Storage, con soporte para Apache Iceberg.
- Amazon S3 + AWS Glue + Apache Iceberg: AWS ofrece su propio enfoque de lakehouse combinando el almacenamiento de objetos de S3 con el catálogo de datos de Glue y el soporte nativo de Iceberg en motores como Athena y EMR.
Ventajas y limitaciones del lakehouse
Como cualquier arquitectura técnica, el lakehouse tiene puntos a favor muy sólidos y también aspectos que conviene conocer antes de adoptarlo. Verlos juntos te da una imagen honesta de lo que puedes esperar.
Ventajas reales del lakehouse
- Plataforma unificada para todos los equipos: Analistas, ingenieros y científicos de datos trabajan sobre los mismos datos sin duplicarlos ni moverlos entre sistemas, lo que reduce la fricción y los errores de sincronización.
- Reducción de costos de infraestructura: Al eliminar la necesidad de mantener un data warehouse caro junto a un data lake, el lakehouse consolida el gasto en almacenamiento de objetos de bajo costo en la nube.
- Datos siempre consistentes gracias a ACID: Las transacciones ACID garantizan que las operaciones sobre los datos se ejecutan de forma íntegra, eliminando los problemas de datos corruptos o a medio actualizar que eran comunes en los data lakes.
- Flexibilidad sin sacrificar estructura: Puedes ingerir datos en bruto de cualquier tipo y aplicar estructura solo cuando es necesario, sin forzar transformaciones previas que ralenticen la llegada de nueva información.
- Preparado para inteligencia artificial: El acceso directo a datos crudos y estructurados en el mismo sistema hace que el lakehouse sea la arquitectura más adecuada para proyectos de machine learning e IA generativa a escala.
Limitaciones que debes tener en cuenta
- Curva de aprendizaje técnica: Implementar y operar un lakehouse requiere conocimientos de formatos de tabla abiertos, motores de procesamiento distribuido y gobernanza de datos, lo que puede ser exigente para equipos pequeños o sin experiencia previa.
- Rendimiento en consultas SQL simples: Aunque el lakehouse se acerca mucho al rendimiento de un data warehouse en consultas analíticas, los data warehouses tradicionales aún pueden superar al lakehouse en ciertos escenarios de consultas muy repetitivas y predecibles con datos muy estructurados.
- Riesgo de «pantano de datos»: Si no se aplican prácticas sólidas de gobernanza desde el principio, el lakehouse puede convertirse en un repositorio desorganizado difícil de mantener, especialmente cuando el volumen de datos crece rápidamente.
- Dependencia de herramientas adicionales: Para aprovechar todo el potencial del lakehouse (catálogos de datos, orquestación, calidad de datos), es habitual necesitar herramientas complementarias que añaden complejidad al ecosistema.
Preguntas frecuentes
¿Qué diferencia hay entre un lakehouse y un data lake?
Un data lake almacena datos en bruto de cualquier tipo y formato sin aplicarles estructura ni reglas de gobernanza por defecto. Esto lo hace flexible y barato, pero dificulta hacer consultas rápidas y garantizar la calidad de los datos. El lakehouse añade sobre ese almacenamiento una capa de metadatos, transacciones ACID y control de acceso, lo que lo convierte en un sistema capaz de hacer análisis con el rendimiento de un data warehouse sin perder la flexibilidad del data lake. En la práctica, un lakehouse es un data lake con capacidades de gestión avanzadas incorporadas en su arquitectura.
¿Un lakehouse reemplaza al data warehouse?
No necesariamente, aunque en muchos casos puede hacerlo. El lakehouse está diseñado para cubrir los mismos casos de uso que un data warehouse (consultas SQL, informes de negocio, dashboards), pero también los de un data lake (datos crudos, machine learning, análisis exploratorio). Sin embargo, si tu organización solo necesita consultas SQL rápidas sobre datos muy estructurados y no tienes planes de trabajar con machine learning o datos heterogéneos, un data warehouse tradicional puede seguir siendo la opción más simple y eficiente para tu caso concreto.
¿Qué es Delta Lake y qué tiene que ver con el lakehouse?
Delta Lake es un formato de tabla abierto que se instala como una capa sobre el almacenamiento de objetos (como Amazon S3 o Azure Blob Storage) y añade capacidades de transacciones ACID, control de versiones y evolución de esquemas a los datos guardados en archivos Parquet. Es una de las tecnologías que hace posible construir un lakehouse, ya que transforma un repositorio de archivos ordinario en un sistema con las garantías de un motor de base de datos. Fue creado por Databricks y es el formato nativo de su plataforma, aunque también puede usarse fuera de ella.
¿Qué tipos de datos puede manejar un lakehouse?
El lakehouse está diseñado para trabajar con los tres tipos principales de datos que existen en una organización moderna. Los datos estructurados son tablas con esquemas definidos, como registros de ventas o transacciones financieras. Los datos semiestructurados tienen cierta organización, pero sin un esquema fijo, como archivos JSON, logs de aplicaciones o datos XML. Y los datos no estructurados son imágenes, vídeos, documentos de texto o grabaciones de audio. Los tres conviven en el mismo sistema sin necesidad de transformar ni separar nada antes de ingresarlos.
¿El lakehouse es adecuado para machine learning?
Sí, y de hecho es una de sus principales fortalezas. Los modelos de machine learning necesitan acceder a grandes volúmenes de datos en bruto, muchas veces heterogéneos, sin que esos datos hayan sido transformados en un formato rígido previamente. El lakehouse permite que los científicos de datos entrenen sus modelos directamente sobre los datos almacenados, sin exportarlos a un entorno separado. Plataformas como Databricks integran herramientas de ML (como MLflow) directamente en el mismo entorno donde viven los datos, lo que reduce considerablemente los tiempos de preparación y los errores por inconsistencias entre entornos.
¿Qué significa ACID en el contexto del lakehouse?
ACID es el acrónimo de cuatro propiedades que garantizan la integridad de las operaciones sobre los datos. Atomicidad significa que una operación se completa del todo o no se ejecuta. Consistencia garantiza que los datos pasan de un estado válido a otro. Aislamiento asegura que las operaciones concurrentes no se interfieran entre sí. Y Durabilidad garantiza que los cambios confirmados no se pierden aunque el sistema falle. En un data lake tradicional estas propiedades no existían de forma nativa, lo que podía generar datos corruptos o incompletos. El lakehouse las incorpora a través de formatos como Delta Lake o Apache Iceberg.
¿Cuáles son las plataformas lakehouse más conocidas?
Las plataformas lakehouse más adoptadas en la industria son Databricks, que fue la pionera del concepto y sigue siendo la más completa para casos con machine learning intensivo; Microsoft Fabric, integrada en el ecosistema Azure con soporte para Delta Lake; y las arquitecturas basadas en Apache Iceberg sobre servicios de nube como Amazon Web Services o Google Cloud, que ofrecen mayor flexibilidad y evitan la dependencia de un proveedor único. También existe Google BigLake, que extiende las capacidades de BigQuery hacia datos almacenados en Cloud Storage con soporte para Iceberg.
Conclusión
El lakehouse es una arquitectura de datos que resuelve un problema real: la necesidad de que distintos equipos trabajen sobre los mismos datos con distintos propósitos, sin duplicar infraestructura ni perder ni consistencia ni rendimiento. Combina lo mejor del data lake y el data warehouse en una plataforma unificada, respaldada por formatos abiertos como Delta Lake o Apache Iceberg.
Ahora que conoces cómo funciona por dentro, cuándo tiene sentido adoptarlo y cuáles son sus ventajas y limitaciones reales, puedes evaluar si esta arquitectura encaja con tu contexto. Si ya manejas datos de múltiples tipos, tienes proyectos de machine learning o buscas reducir la complejidad de tu stack de datos, el lakehouse merece estar en tu radar como opción concreta.
Este sitio web tiene más contenido sobre ingeniería de datos para que sigas construyendo una base sólida, desde conceptos fundamentales hasta arquitecturas avanzadas. Cada artículo está pensado para que entiendas los temas desde cero y puedas aplicarlos con confianza.
Sigue aprendiendo:
ETL con Python: Extrae, transforma y carga datos
Apache Spark: El motor de datos que no conocías
Herramientas ETL: Elige la correcta y ahorra horas de trabajo
Ingesta de datos: Transforma fuentes caóticas en valor real
¿En qué consiste la ingeniería de base de datos?
¿Qué es ETL? – Extracción, Transformación y Carga
¿Qué hace un ingeniero de datos?
Apache Airflow: Automatiza y controla tus flujos de datos con Python
