
Imagina tomar una decisión importante basándote en datos que, sin que lo supieras, estaban incompletos o eran incorrectos. Eso pasa más de lo que parece. La calidad de datos determina si lo que ves en tus análisis refleja la realidad o solo una versión distorsionada de ella. Entender este concepto cambia la forma en que trabajas con información.
¿Qué es la calidad de datos?
La calidad de datos es el grado en que un conjunto de datos cumple con los requisitos necesarios para ser preciso, completo y confiable dentro de un sistema de información. Un dato de calidad es aquel que refleja fielmente la realidad que representa y que puede usarse para tomar decisiones, construir modelos o automatizar procesos sin generar errores en cadena.
Desde la perspectiva de la ingeniería de datos, la calidad no es un estado fijo que se alcanza una vez. Es una propiedad que debe medirse, vigilarse y mantenerse a lo largo de todo el ciclo de vida del dato: desde su origen hasta el momento en que alimenta un reporte o modelo.
Una definición técnica ampliamente aceptada en la industria proviene de DAMA International, la organización global de gestión de datos, que describe la calidad de datos como el grado en que las dimensiones de los datos cumplen con los requisitos establecidos. Este enfoque dimensional es el estándar que usan tanto equipos técnicos como áreas de negocio para evaluar sus activos de información.
«La calidad de datos es el grado en que las dimensiones de los datos cumplen los requisitos.» — DAMA International, referencia estándar en gestión de datos.
Dimensiones de la calidad de datos
Las dimensiones de la calidad de datos son los criterios concretos que permiten evaluar si un conjunto de datos es adecuado para su uso. Cada dimensión mide un aspecto diferente, falla por razones distintas y se corrige en un punto diferente del flujo de datos. Comprenderlas te da un lenguaje común para detectar problemas y comunicarlos tanto al equipo técnico como al área de negocio.
Precisión
La precisión mide si el valor de un dato corresponde a la realidad que pretende representar. Un dato impreciso no es necesariamente un dato vacío: puede estar presente, pero ser incorrecto. Por ejemplo, si el número de teléfono de un cliente está registrado con un dígito equivocado, el campo aparece completo, pero el dato es inútil o, peor aún, perjudicial si se usa para contactar a otra persona.
Completitud
La completitud evalúa qué porcentaje de los campos requeridos tiene un valor real, no nulo. Un campo vacío en una columna crítica puede bloquear un análisis completo o sesgar los resultados de forma que no se detecta a simple vista. Esta dimensión es una de las más fáciles de medir automáticamente, pero también una de las más ignoradas en los programas de calidad de datos porque se percibe como un problema menor.
Consistencia
La consistencia verifica que un mismo dato tenga el mismo valor y significado en todos los sistemas donde aparece. Cuando el mismo indicador de negocio arroja resultados distintos según de qué fuente se extraiga, el problema casi siempre es de consistencia. Este tipo de fallo es particularmente dañino porque genera desconfianza en los datos y hace que los equipos empiecen a cuestionar cualquier reporte, incluso los correctos.
Oportunidad
La oportunidad mide si el dato está disponible en el momento en que se necesita. No basta con que un dato sea preciso y completo si llega tarde. En contextos donde las decisiones dependen de información en tiempo real, la latencia de los datos es una dimensión de calidad tan relevante como la exactitud. Un reporte de ventas del día anterior que se procesa con 48 horas de retraso puede llevar a decisiones desalineadas con la situación actual.
Unicidad
La unicidad garantiza que cada entidad del mundo real esté representada una sola vez en el sistema. Los registros duplicados son uno de los problemas más frecuentes y más costosos en bases de datos de clientes, productos o transacciones. Un cliente duplicado con ligeras variaciones en el nombre puede inflar métricas, generar comunicaciones redundantes y distorsionar análisis de comportamiento.
Validez
La validez comprueba que el dato cumple con el formato, el tipo y el rango de valores esperados según las reglas del negocio o del sistema. Un valor técnicamente presente pero fuera de formato equivale a un dato ausente en términos de procesamiento. Ejemplos típicos: una fecha almacenada como texto libre, un código postal con letras o un campo de edad con valores negativos. Las reglas de validación en el pipeline son la herramienta principal para controlar esta dimensión.
¿Por qué importa la calidad de datos en ingeniería de datos?
En ingeniería de datos, la calidad no es un objetivo estético, sino una condición funcional. Cada componente del ecosistema de datos —desde la ingesta hasta el modelo de machine learning— depende de que los datos que lo alimentan sean confiables. Un error en la capa más básica se propaga hacia arriba y llega amplificado al nivel donde alguien toma una decisión o entrena un modelo.
El proceso de ingesta de datos es uno de los puntos más críticos para garantizar la calidad desde el inicio. Si los datos llegan mal desde el origen —con formatos inconsistentes, valores nulos no controlados o duplicados— el esfuerzo de limpieza posterior se multiplica. Detectar y corregir un problema de calidad en la ingesta cuesta una fracción de lo que cuesta corregirlo después de que ya contaminó el data warehouse o el data lake.
Desde el ángulo del negocio, los datos de baja calidad generan decisiones equivocadas, procesos ineficientes y pérdida de confianza en los sistemas de información. Los equipos dejan de creer en los reportes, empiezan a mantener hojas de cálculo paralelas y el valor de la infraestructura de datos se diluye. La calidad de datos no es un tema técnico aislado: tiene consecuencias directas en la operación y la estrategia de cualquier organización.
¿Por qué la calidad de datos importa en cada capa del ecosistema?
Ingesta
Primer filtro. Los errores que no se detectan aquí se propagan a todas las capas siguientes.
Transformación
Aquí se aplican reglas de limpieza, validación y enriquecimiento para elevar la calidad del dato.
Almacenamiento
Los datos deben cumplir los estándares del modelo antes de persistirse. Las restricciones del esquema ayudan.
Consumo
Reportes, dashboards y modelos ML. Si llegan datos incorrectos, las decisiones y predicciones serán erróneas.
Problemas comunes de baja calidad de datos
Los problemas de calidad de datos rara vez son espectaculares. La mayoría se acumulan de forma silenciosa hasta que un análisis arroja un resultado que nadie puede explicar. Conocer los síntomas más frecuentes te permite identificarlos antes de que contaminen capas superiores del sistema.
- Valores nulos no controlados: Campos vacíos en columnas que el sistema asume como completas. Generan errores en cálculos, agregaciones y filtros que no se detectan de inmediato.
- Registros duplicados: La misma entidad aparece más de una vez con variaciones mínimas (mayúsculas, espacios, abreviaciones). Inflan métricas y distorsionan análisis de comportamiento.
- Formatos inconsistentes: Fechas con distintos formatos (DD/MM/AAAA vs MM-DD-AAAA) o monedas sin unidad explícita combinadas en el mismo campo. Rompen los procesos de transformación.
- Datos desactualizados: Registros que alguna vez fueron correctos, pero ya no reflejan la realidad. Direcciones antiguas, precios caducados o categorías que ya no existen en el catálogo activo.
- Valores fuera de rango: Edades negativas, porcentajes mayores a 100 o coordenadas geográficas imposibles. Suelen ser errores de captura que las reglas de validación deberían interceptar en la entrada.
- Inconsistencias entre sistemas: El mismo KPI con resultados distintos según la fuente consultada. Es una señal de que no existe una capa semántica única o que los datos maestros no están centralizados.
¿Cómo medir la calidad de datos?
Medir la calidad de datos requiere traducir cada dimensión en una métrica concreta y cuantificable. Sin métricas, la calidad de datos es una opinión; con métricas, se convierte en un indicador gestionable. El primer paso es siempre el perfilado de datos: un análisis sistemático que revela el estado real de un conjunto de datos antes de procesarlo.
El perfilado de datos es el punto de partida de cualquier medición seria. Consiste en analizar estadísticamente las columnas de un conjunto de datos para detectar nulos, distribuciones inesperadas, valores atípicos y patrones de formato. Las herramientas modernas de perfilado hacen este análisis de forma automática y te entregan un diagnóstico antes de que empieces a construir cualquier transformación.
Cómo mejorar la calidad de datos paso a paso
Mejorar la calidad de datos no ocurre en un solo sprint ni con una sola herramienta. Es un proceso iterativo que combina decisiones técnicas y culturales. El punto de partida siempre es la auditoría: no puedes mejorar lo que no has medido. A continuación se describen los pasos que forman un ciclo de mejora sostenible.
Audita el estado actual de tus datos
Realiza un perfilado completo de tus conjuntos de datos principales. Identifica qué dimensiones están fallando y en qué fuentes. Esta es la única forma de priorizar dónde actuar primero.
Define estándares y reglas de negocio
Establece qué significa «dato de calidad» para tu organización. Define formatos aceptados, rangos válidos, campos obligatorios y reglas de consistencia entre sistemas. Sin estos acuerdos, cada equipo tiene su propia definición de calidad.
Implementa validaciones en el pipeline
Añade controles automáticos en los procesos ETL o ELT para interceptar datos que no cumplen las reglas antes de que persistan en el almacenamiento. Detectar errores en la entrada es siempre más barato que corregirlos después.
Limpia y enriquece los datos existentes
Corrige los problemas detectados en la auditoría. Elimina duplicados, completa campos vacíos donde sea posible, estandariza formatos y recategoriza valores fuera de rango. Este paso es necesario para sanear los datos históricos.
Monitoriza de forma continua
Configura alertas automáticas que notifiquen cuando una métrica de calidad cae por debajo del umbral aceptado. Los dashboards de observabilidad de datos permiten ver el estado de la calidad en tiempo real sin revisar manualmente cada pipeline.
Construye una cultura de datos en el equipo
La tecnología resuelve parte del problema, pero los errores más persistentes vienen de malos hábitos humanos en la captura y el uso de datos. Capacitar a quienes generan y consumen datos es la inversión con mayor retorno a largo plazo.
Herramientas para gestionar la calidad de datos
El mercado ofrece herramientas para cada etapa del ciclo de calidad: perfilado, validación, limpieza, deduplicación y monitorización. La elección de la herramienta adecuada depende del tamaño del equipo, el volumen de datos y el nivel de madurez del ecosistema de datos. Algunas son soluciones de código abierto ideales para equipos técnicos; otras son plataformas empresariales con interfaces visuales y gobernanza integrada.
- Great Expectations: Herramienta open source para definir y ejecutar pruebas de calidad sobre conjuntos de datos. Permite crear expectativas (reglas) y validarlas automáticamente dentro de un pipeline. Es el estándar de facto para equipos de ingeniería de datos que trabajan con Python.
- dbt (Data Build Tool): Aunque su función principal es la transformación de datos, incluye pruebas de calidad integradas que validan integridad referencial, unicidad y nulos directamente en las consultas SQL. Es ampliamente adoptado en equipos de analytics engineering.
- Monte Carlo: Plataforma de observabilidad de datos que usa aprendizaje automático para detectar anomalías en tus pipelines sin necesidad de definir reglas manualmente. Genera alertas cuando el comportamiento de los datos se desvía del patrón habitual.
- Talend: Suite empresarial que integra perfilado, limpieza, deduplicación y gobernanza de datos en un solo entorno. Incluye conectores para múltiples fuentes y es una opción consolidada para organizaciones con grandes volúmenes de datos.
- OpenRefine: Herramienta open source orientada a la exploración y limpieza manual de datos. Es especialmente útil para analistas que necesitan entender y limpiar conjuntos de datos medianos sin escribir código.
- Informatica Data Quality: Solución empresarial con capacidades avanzadas de perfilado, validación y enriquecimiento de datos. Tiene integración nativa con múltiples plataformas de datos en la nube y es común en grandes organizaciones con requisitos de cumplimiento.
Si estás empezando en la ingeniería de datos o quieres profundizar en este campo, conocer estas herramientas de forma práctica es un paso natural. Puedes encontrar un punto de entrada claro en el recorrido sobre cómo ser Ingeniero de Datos desde cero, donde se explican las habilidades y tecnologías que forman la base del perfil.
Preguntas frecuentes
¿Qué diferencia hay entre calidad de datos y gobernanza de datos?
La calidad de datos describe el estado de los datos en un momento dado: qué tan precisos, completos, consistentes y oportunos son. La gobernanza de datos, en cambio, es el conjunto de políticas, roles y procesos que definen quién tiene autoridad sobre los datos, cómo se gestionan y qué estándares deben cumplir. La gobernanza es el marco que hace posible mantener la calidad de forma sostenida en el tiempo. Sin gobernanza, la calidad de datos mejora puntualmente pero tiende a degradarse; sin calidad, la gobernanza es un conjunto de reglas sin impacto medible.
¿Cuántas dimensiones tiene la calidad de datos?
No existe un número universalmente fijo. El estándar más extendido en la industria, respaldado por DAMA International, trabaja con seis dimensiones principales: precisión, completitud, consistencia, oportunidad, unicidad y validez. Algunos marcos amplían esta lista hasta nueve o más dimensiones, añadiendo conceptos como trazabilidad, disponibilidad o claridad. La mayoría de los equipos de ingeniería de datos trabajan con las seis dimensiones esenciales como punto de partida y amplían según las necesidades específicas de su organización.
¿Cómo afecta la mala calidad de datos a una empresa?
Los efectos van desde lo operativo hasta lo estratégico. A nivel operativo, los datos incorrectos generan errores en procesos automatizados, envíos fallidos, facturación incorrecta y atención al cliente deficiente. A nivel estratégico, las decisiones tomadas sobre datos de baja calidad llevan a inversiones equivocadas, oportunidades de mercado perdidas y modelos predictivos poco confiables. Uno de los impactos más difíciles de revertir es la pérdida de confianza interna: cuando los equipos dejan de creer en sus propios datos, el valor de toda la infraestructura de información se desvanece.
¿Qué es la validación de datos en un pipeline ETL?
La validación de datos en un pipeline ETL es el conjunto de comprobaciones automáticas que se ejecutan sobre los datos durante su proceso de extracción, transformación y carga. Estas comprobaciones verifican que los datos cumplen con los formatos, rangos y reglas de negocio definidos antes de que persistan en el sistema destino. Cuando un dato no supera una validación, el pipeline puede rechazarlo, enrutarlo a una cola de revisión o generar una alerta. Implementar validaciones en esta capa es la estrategia más eficiente para evitar que los problemas de calidad se propaguen hacia el almacenamiento y el consumo.
¿Qué herramientas open source existen para medir la calidad de datos?
Las más adoptadas en equipos de ingeniería de datos son Great Expectations, que permite definir y ejecutar pruebas de calidad en Python directamente sobre los pipelines; dbt Tests, que integra validaciones de calidad en las transformaciones SQL; y OpenRefine, útil para exploración y limpieza interactiva de conjuntos de datos medianos. Great Expectations se ha convertido en el estándar de facto para equipos técnicos que buscan automatizar las pruebas de calidad sin depender de plataformas comerciales. Puedes consultar su documentación oficial en greatexpectations.io.
¿Qué es el perfilado de datos y para qué sirve?
El perfilado de datos es el análisis estadístico y estructural de un conjunto de datos para entender su contenido real antes de procesarlo. Revela información como el porcentaje de valores nulos por columna, la distribución de los valores, los rangos mínimo y máximo, los formatos presentes y la cantidad de duplicados. El perfilado es el primer paso de cualquier programa serio de calidad de datos porque convierte la percepción de que «los datos están mal» en un diagnóstico objetivo y medible sobre qué está mal, cuánto y en qué fuentes.
¿Cuál es la relación entre calidad de datos y machine learning?
Los modelos de machine learning aprenden de los datos con los que se entrenan. Si esos datos son imprecisos, están incompletos o tienen sesgos no detectados, el modelo aprenderá patrones incorrectos y producirá predicciones poco confiables, aunque su arquitectura sea técnicamente correcta. En el campo del ML, la expresión «basura entra, basura sale» resume perfectamente esta dependencia. La calidad de los datos de entrenamiento es uno de los factores que más influye en el rendimiento real de un modelo en producción, por encima incluso de la elección del algoritmo o la complejidad de la arquitectura.
Conclusión
La calidad de datos no es un lujo técnico ni una preocupación exclusiva de los grandes equipos de ingeniería. Es la base sobre la que se construyen análisis confiables, procesos eficientes y decisiones acertadas. Cuando tus datos son precisos, completos, consistentes, oportunos, únicos y válidos, todo lo que construyes sobre ellos tiene una base sólida.
Las seis dimensiones que exploraste en este artículo —precisión, completitud, consistencia, oportunidad, unicidad y validez— son tu punto de partida para evaluar cualquier conjunto de datos. Puedes aplicarlas hoy mismo: elige un dataset que uses con frecuencia, perfílalo y mide cuántos registros pasan cada dimensión. Ese diagnóstico, por sencillo que sea, ya es un acto de ingeniería de datos real.
Si este tema te generó más preguntas que respuestas, eso es una buena señal: significa que estás pensando con profundidad sobre cómo funciona la información. En este sitio web encontrarás más contenidos sobre ingeniería de datos, herramientas y conceptos que te ayudarán a seguir construyendo ese conocimiento de forma práctica y progresiva.
Sigue aprendiendo:
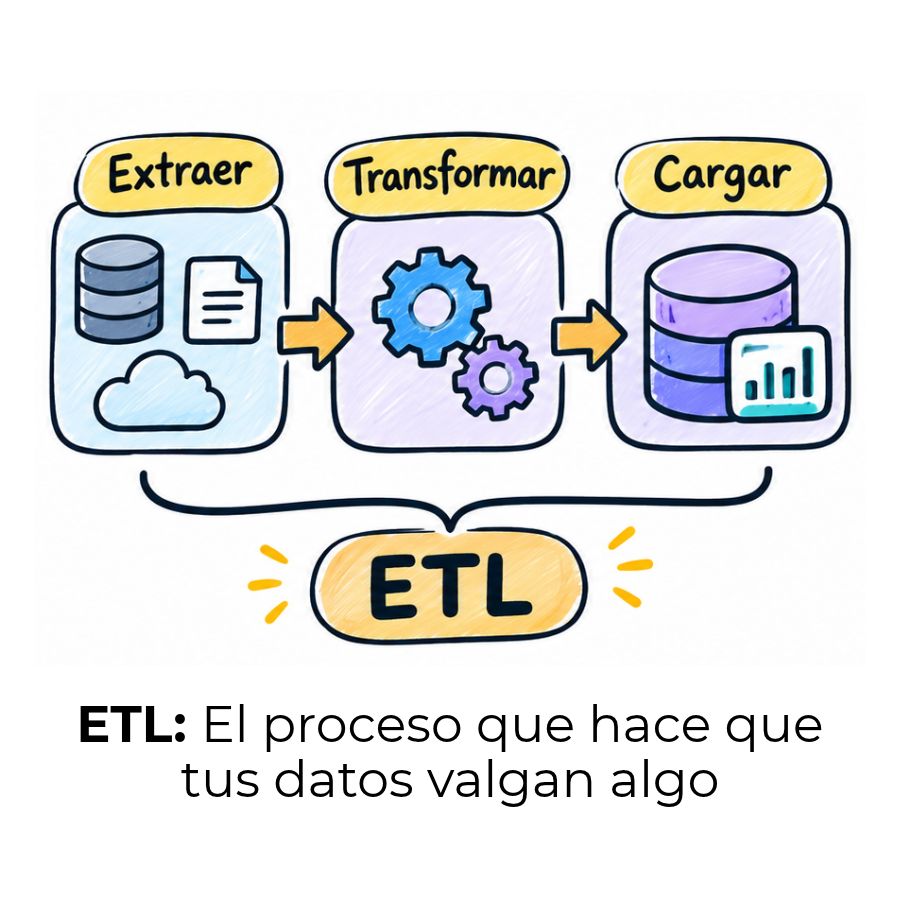
¿Qué es ETL? – Extracción, Transformación y Carga
¿En qué consiste la ingeniería de base de datos?
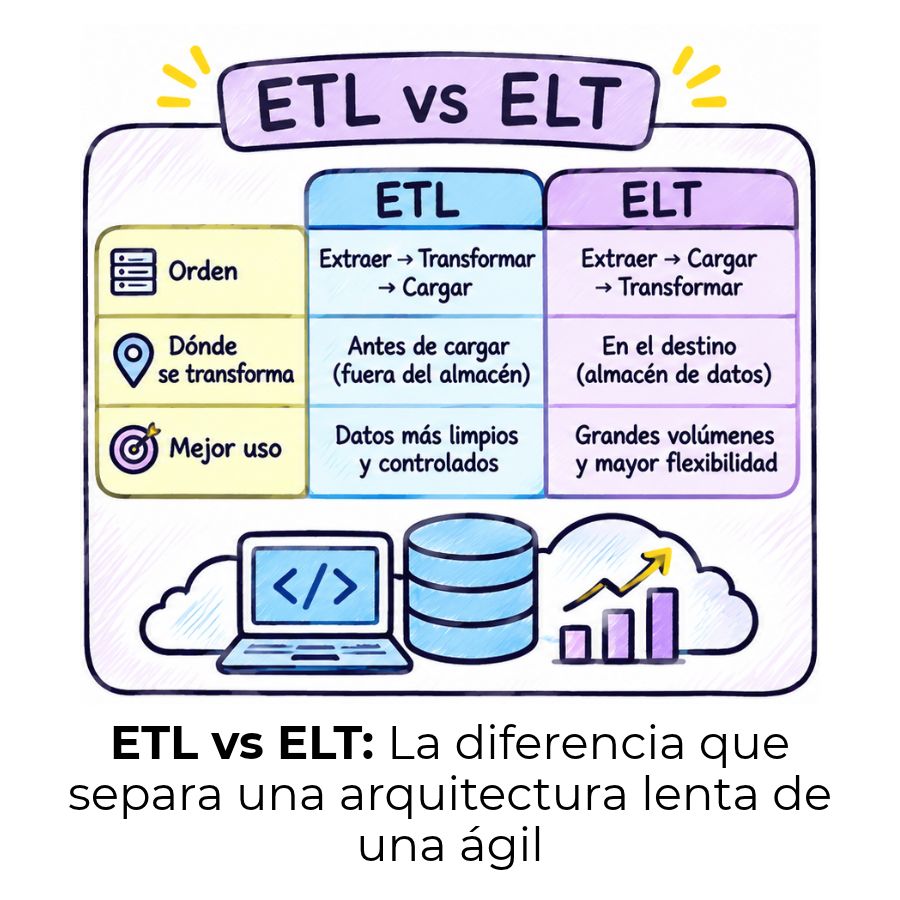
ETL vs. ELT: Transforma tus datos con la estrategia correcta
Catálogo de datos: El mapa que nadie te enseñó a leer
¿Qué es un data lake y cómo funciona?
Gobierno de datos: Controla tu información y toma mejores decisiones 📊
Arquitectura de datos: El secreto que mueve los datos de tu empresa
Apache Spark: El motor de datos que no conocías
