
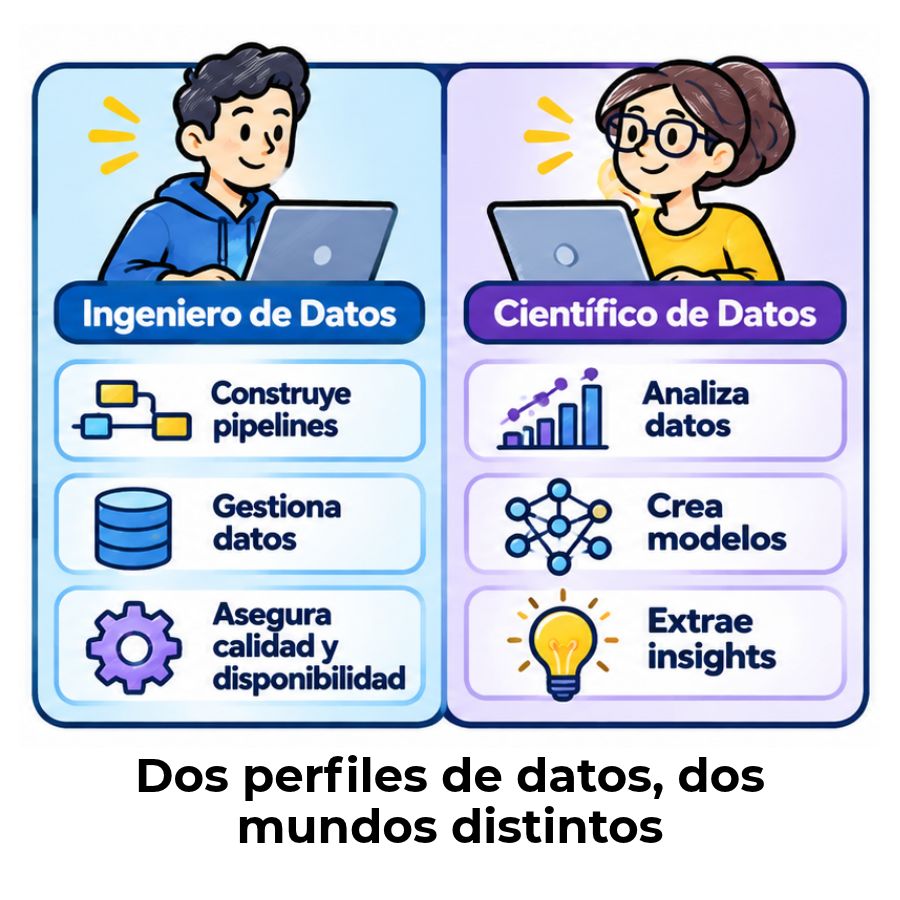
El ingeniero de datos y el científico de datos no son lo mismo, aunque trabajen codo a codo. El primero construye los sistemas que mueven y organizan la información; el segundo la analiza para extraer conclusiones útiles. Si quieres saber cuál de los dos se ajusta mejor a tu perfil o a tu equipo, lo que sigue te lo deja claro.
¿Qué es un ingeniero de datos y qué es un científico de datos?
Antes de comparar ambos perfiles, conviene tener claro qué hace cada uno de forma independiente. Aunque los dos trabajan con datos y comparten algunas herramientas, sus objetivos, su formación y su lugar dentro de un equipo técnico son diferentes. El ingeniero de datos se ocupa de la infraestructura; el científico de datos, del análisis y la predicción.
El ingeniero de datos: el arquitecto de la infraestructura
El ingeniero de datos diseña, construye y mantiene los sistemas que permiten que la información llegue limpia, organizada y disponible a quien la necesita. Su trabajo ocurre en un plano técnico profundo: bases de datos, flujos automatizados de datos —llamados pipelines—, almacenes en la nube y procesos de integración entre sistemas. Sin este trabajo previo, ningún análisis posterior sería posible.
Puedes explorar con más detalle qué hace un ingeniero de datos en su trabajo cotidiano, desde la gestión de bases de datos hasta la orquestación de flujos de información a gran escala.
El científico de datos: el analista del conocimiento
El científico de datos toma la información que el ingeniero ha organizado y la examina para encontrar patrones, construir modelos estadísticos y generar conclusiones que apoyen decisiones estratégicas. Su base está en las matemáticas, la estadística y el aprendizaje automático. Su misión principal es transformar datos en conocimiento accionable para la organización.
¿Cuál es la diferencia entre ingeniero y científico de datos?
La diferencia principal radica en en qué momento del ciclo de vida del dato actúa cada perfil y con qué propósito. El ingeniero de datos trabaja en la capa de infraestructura: su trabajo es que los datos existan, fluyan y estén disponibles. El científico de datos trabaja en la capa analítica: su trabajo es que esos datos expliquen algo útil a la organización.
El científico de datos descubre y prototipa nuevas formas de extraer valor de los datos; el ingeniero de datos convierte ese conocimiento en soluciones robustas y escalables.
Una forma sencilla de visualizarlo: el ingeniero construye la carretera y el científico decide qué destino tomar. Sin carretera, no hay viaje posible. Sin destino, la carretera no sirve de nada. Los dos son necesarios y complementarios dentro de cualquier equipo de datos maduro.
Funciones y responsabilidades de cada perfil
Más allá de la definición general, cada rol tiene un conjunto de tareas concretas que lo distinguen. Conocerlas te ayuda a entender qué espera una empresa de cada perfil cuando publica una oferta de trabajo, y qué deberías saber si quieres optar a alguno de los dos puestos.
¿Qué hace un ingeniero de datos en su día a día?
El trabajo del ingeniero de datos es, en gran parte, invisible para el resto del equipo, pero fundamental para que todo funcione. Su responsabilidad central es que los datos estén disponibles, sean fiables y lleguen en el formato correcto. Para lograrlo, se ocupa de tareas técnicas muy específicas que combinan programación, arquitectura de sistemas y operaciones en la nube.
- Construcción de pipelines: Diseña y mantiene los flujos automáticos que mueven datos desde distintas fuentes —aplicaciones, sensores, APIs— hasta los sistemas de almacenamiento.
- Gestión de bases de datos: Administra bases de datos relacionales y no relacionales, asegurando su rendimiento, disponibilidad y seguridad.
- Procesos ETL: Extrae datos de múltiples orígenes, los transforma para que sean consistentes y los carga en los destinos adecuados.
- Infraestructura en la nube: Despliega y gestiona soluciones en plataformas como AWS, Google Cloud o Azure para almacenar y procesar volúmenes masivos de información.
- Calidad y fiabilidad de los datos: Detecta errores, duplicados y anomalías en los datos antes de que lleguen a otras manos.
¿Qué hace un científico de datos en su día a día?
El científico de datos opera en la capa analítica y de decisión. Una vez que el ingeniero ha puesto los datos a su disposición, su trabajo es interpretar esa información para responder preguntas de negocio o anticipar comportamientos futuros. Su día a día mezcla análisis estadístico, programación y comunicación de resultados.
- Exploración y análisis de datos: Examina los conjuntos de datos disponibles para identificar tendencias, correlaciones y patrones relevantes.
- Construcción de modelos predictivos: Entrena algoritmos de aprendizaje automático para anticipar resultados, como la probabilidad de abandono de un cliente o la demanda futura de un producto.
- Visualización de resultados: Transforma conclusiones complejas en gráficos y paneles comprensibles para equipos no técnicos.
- Experimentación estadística: Diseña pruebas y experimentos para validar hipótesis con rigor matemático antes de tomar decisiones.
- Comunicación de hallazgos: Presenta los resultados de su análisis a directivos y equipos de negocio con claridad y argumentos sólidos.
Herramientas y tecnologías que usa cada uno
El conjunto de herramientas de cada perfil refleja bien sus diferencias. Aunque comparten algunos lenguajes base, como Python y SQL, los stacks tecnológicos divergen en cuanto el trabajo se vuelve más específico. El ingeniero trabaja con herramientas de orquestación, integración y almacenamiento a escala; el científico, con librerías de análisis, modelado y visualización.
| Categoría | Ingeniero de datos | Científico de datos |
|---|---|---|
| Lenguajes principales | Python, SQL, Scala, Java | Python, R, SQL |
| Procesamiento de datos | Apache Spark, Apache Kafka | Pandas, NumPy |
| Orquestación y ETL | Apache Airflow, dbt | No es su foco principal |
| Almacenamiento | Snowflake, BigQuery, Redshift, bases NoSQL | Accede a estos sistemas; no los gestiona |
| Nube | AWS, Google Cloud, Azure, Databricks | AWS SageMaker, Google Colab |
| Machine learning | Infraestructura para ML (MLOps) | scikit-learn, TensorFlow, PyTorch |
| Visualización | Grafana, Kibana (monitoreo de sistemas) | Tableau, Power BI, Matplotlib, Seaborn |
| Entorno de trabajo | IDEs, terminales, pipelines en producción | Jupyter Notebooks, entornos experimentales |
Esta diferencia en el stack no es anecdótica: refleja que el ingeniero piensa en escala, disponibilidad y rendimiento, mientras que el científico piensa en precisión, interpretabilidad y valor analítico. Ambas lógicas son necesarias y se complementan.
¿Qué perfil tiene más demanda laboral?
Ambos perfiles están entre los más solicitados del mercado tecnológico, aunque con tendencias distintas. Los científicos de datos llevan más tiempo posicionados como referencia del sector y acumulan una base de oferta laboral mayor, pero la ingeniería de datos ha crecido con fuerza en los últimos años a medida que las organizaciones maduran su capacidad de gestión de la información.
Empresas de todos los sectores —banca, salud, minorista, tecnología, logística— contratan ambos perfiles de forma habitual. La tendencia reciente muestra que la demanda de ingenieros de datos crece a un ritmo acelerado, impulsada por la necesidad de gestionar volúmenes de información cada vez mayores en entornos de nube y arquitecturas distribuidas. Puedes profundizar más sobre las perspectivas del sector en el área de ingeniería de datos.
📌 Factores que impulsan la demanda de cada perfil
🔧 Ingeniero de datos
- Crecimiento del volumen de datos en las organizaciones
- Adopción masiva de servicios en la nube
- Necesidad de pipelines en tiempo real
- Expansión del ecosistema de inteligencia artificial
📊 Científico de datos
- Demanda de modelos predictivos en todos los sectores
- Cultura de toma de decisiones basada en datos
- Crecimiento del aprendizaje automático aplicado
- Necesidad de personalización a escala
¿Cómo trabajan juntos el ingeniero y el científico de datos?
En la práctica, estos dos perfiles forman una cadena de trabajo donde el resultado de uno habilita el trabajo del otro. No son roles paralelos e independientes: el científico de datos depende directamente de la infraestructura que el ingeniero construye y mantiene. Sin esa base, los modelos y análisis no serían posibles ni reproducibles a escala.
Un ejemplo concreto: una empresa de comercio digital quiere predecir qué productos comprarán sus clientes la próxima semana. El ingeniero de datos construye el pipeline que recoge las transacciones en tiempo real, las limpia y las centraliza en un almacén de datos. El científico de datos toma esa información organizada y entrena un modelo de recomendación. Cuando el modelo detecta un patrón nuevo, el científico lo comunica al ingeniero, que ajusta el flujo de datos para incorporar nuevas señales. La colaboración es continua, no puntual.
¿Cuál de los dos se adapta mejor a tu perfil?
Esta pregunta no tiene una respuesta universal: depende de tus fortalezas, de lo que disfrutas hacer y de la dirección en la que quieres crecer profesionalmente. Ambas carreras son sólidas, bien remuneradas y con proyección a largo plazo. Lo que cambia es el tipo de problemas que resolverás cada día.
¿Cuál encaja contigo? Responde estas preguntas
🔧 Elige ingeniería de datos si…
- Disfrutas construir sistemas robustos y escalables
- Te atrae la arquitectura de software y la nube
- Prefieres que tu trabajo ocurra entre bastidores
- Te gusta automatizar procesos repetitivos
- Tienes afinidad con bases de datos y programación
📊 Elige ciencia de datos si…
- Las matemáticas y la estadística son tu punto fuerte
- Te motiva extraer conclusiones de conjuntos complejos
- Disfrutas comunicar hallazgos a equipos no técnicos
- Te interesa el aprendizaje automático y la predicción
- Quieres impactar directamente en decisiones de negocio
Si quieres comparar no solo las funciones, sino también las compensaciones económicas de cada perfil, puedes consultar información detallada sobre el sueldo de un ingeniero de datos y qué factores influyen en su evolución a lo largo de la carrera.
Preguntas frecuentes
¿Puede un ingeniero de datos convertirse en científico de datos?
Sí, aunque el camino requiere adquirir nuevas competencias. Un ingeniero de datos ya tiene una base sólida en programación y sistemas, que es un punto de partida ventajoso. Para moverse hacia la ciencia de datos, necesita reforzar estadística inferencial, álgebra lineal aplicada y el uso práctico de librerías de aprendizaje automático como scikit-learn o TensorFlow. La transición es posible y más común de lo que parece, sobre todo en perfiles que llevan tiempo trabajando cerca de equipos de análisis y ya entienden qué necesita el científico de los datos de lo que él entrega.
¿Qué carrera estudiar para ser ingeniero de datos?
No existe una única vía. Los ingenieros de datos suelen provenir de titulaciones en Informática, Ingeniería de Sistemas, Telecomunicaciones o Matemáticas Aplicadas. También hay profesionales que llegan desde bootcamps o formaciones especializadas en ingeniería de datos con un componente fuerte en SQL, Python, arquitectura de datos y plataformas cloud. Lo que más valoran las empresas es la experiencia práctica con herramientas reales, más que el título concreto. Un portafolio con proyectos de pipelines reales o contribuciones en plataformas como GitHub puede marcar la diferencia en un proceso de selección.
¿Qué carrera estudiar para ser científico de datos?
Los perfiles más habituales provienen de Matemáticas, Estadística, Física, Ingeniería o Economía. La formación matemática sólida es un requisito real, no decorativo: sin entender estadística inferencial, probabilidad y álgebra lineal, resulta difícil construir modelos que funcionen de verdad. Los másteres especializados en ciencia de datos y los programas de formación en machine learning han ganado mucho peso como vía de entrada al sector para quienes ya tienen una base cuantitativa, pero necesitan complementarla con programación y herramientas específicas del campo.
¿Cuál gana más: el ingeniero o el científico de datos?
En términos generales, los salarios de ambos perfiles son muy competitivos y similares entre sí, con ligeras variaciones según el sector, el tamaño de la empresa y el país. En mercados como el español, los rangos salariales de ambos roles se sitúan en bandas cercanas, aunque el ingeniero de datos tiende a tener una demanda más estable a medida que las empresas escalan su infraestructura. El factor que más influye en el salario no es el rol en sí, sino la especialización, los años de experiencia y el dominio de tecnologías específicas de alta demanda.
¿Es lo mismo un científico de datos que un analista de datos?
No son el mismo perfil, aunque hay solapamiento. El analista de datos se centra en examinar datos históricos para responder preguntas concretas del negocio, generalmente con herramientas como SQL, Excel o Tableau. El científico de datos va un paso más allá: usa estadística avanzada y aprendizaje automático para construir modelos que predicen o automatizan decisiones. La diferencia clave está en la complejidad de los métodos y en si el objetivo es describir lo que pasó o anticipar lo que pasará. Un analista describe; un científico predice y prescribe.
¿Qué lenguajes de programación necesita cada perfil?
Ambos perfiles comparten Python y SQL como base, pero a partir de ahí sus caminos divergen. El ingeniero de datos suele trabajar también con Scala o Java para entornos de procesamiento distribuido como Apache Spark, y necesita dominar herramientas de orquestación. El científico de datos profundiza en R para análisis estadístico y en las librerías del ecosistema Python orientadas a machine learning. Python es el lenguaje común indispensable para los dos perfiles; quien no lo domine con fluidez tendrá dificultades en cualquiera de las dos carreras.
¿Pueden trabajar de forma independiente sin el otro perfil?
En organizaciones pequeñas, es habitual que una misma persona asuma tareas de los dos perfiles, aunque eso implica sacrificar profundidad en alguno de ellos. En empresas medianas y grandes, los dos roles son distintos y necesarios. Un científico de datos sin un ingeniero pierde tiempo valioso construyendo infraestructura en lugar de analizar. Un ingeniero sin un científico construye sistemas sin saber bien qué preguntas responderán esos datos. La colaboración entre ambos es lo que convierte los datos en decisiones reales con impacto en el negocio.
Conclusión
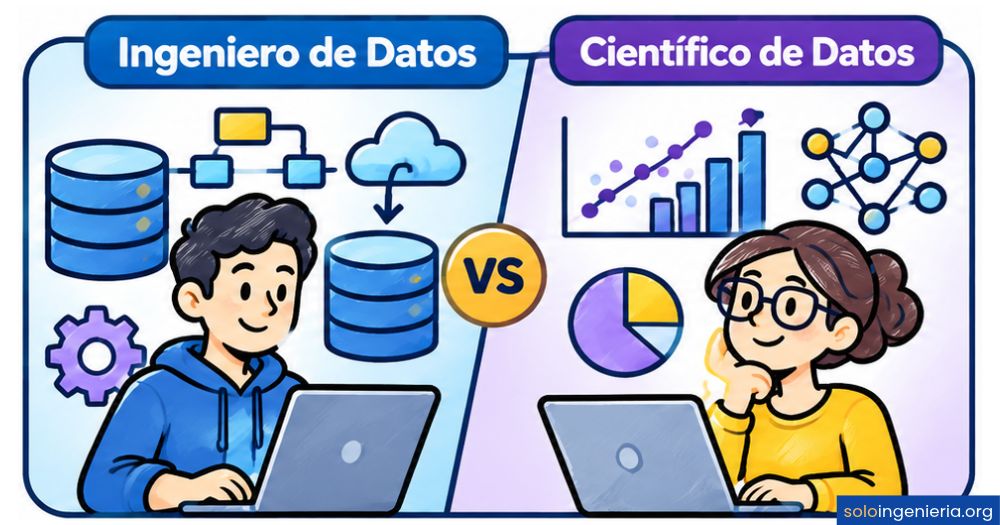
El ingeniero de datos y el científico de datos son dos perfiles complementarios que actúan en momentos distintos del ciclo del dato. Uno construye la infraestructura que hace posible el análisis; el otro convierte esa información en conocimiento accionable. Confundirlos o ignorar sus diferencias puede llevarte a elegir una formación que no encaja con lo que realmente quieres hacer.
Si te atraen los sistemas, la arquitectura de datos y la ingeniería de software, el rol de ingeniero de datos tiene mucho que ofrecerte. Si tu fortaleza está en las matemáticas, la estadística y la comunicación de hallazgos, la ciencia de datos encaja mejor con ese perfil. En cualquiera de los dos casos, Python y SQL son el punto de partida, y la práctica con proyectos reales es lo que finalmente abre las puertas del sector.
Ambas carreras tienen una proyección sólida y una demanda real en el mercado. Si este tema te genera curiosidad, en este sitio web encontrarás más contenido sobre ingeniería de datos, tecnología y carreras profesionales que te ayudará a seguir construyendo tu camino con claridad.
Sigue aprendiendo:
Azure Data Factory (ADF): El servicio que mueve tus datos en la nube ☁️
Apache Spark: El motor de datos que no conocías
¿Qué es un data lake y cómo funciona?
¿Qué es un data warehouse y para qué sirve?
Apache Airflow: Automatiza y controla tus flujos de datos con Python
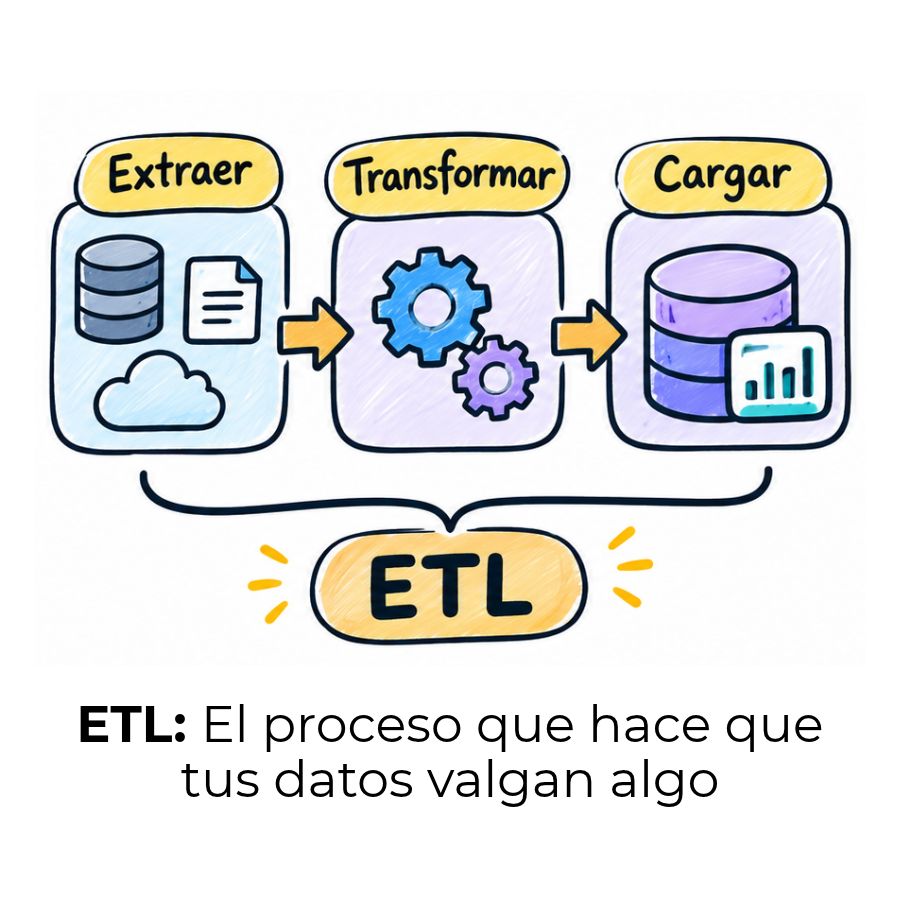
¿Qué es ETL? – Extracción, Transformación y Carga
¿Qué hace un ingeniero de datos?
Pipeline de datos: El mecanismo que nadie te explica bien
