
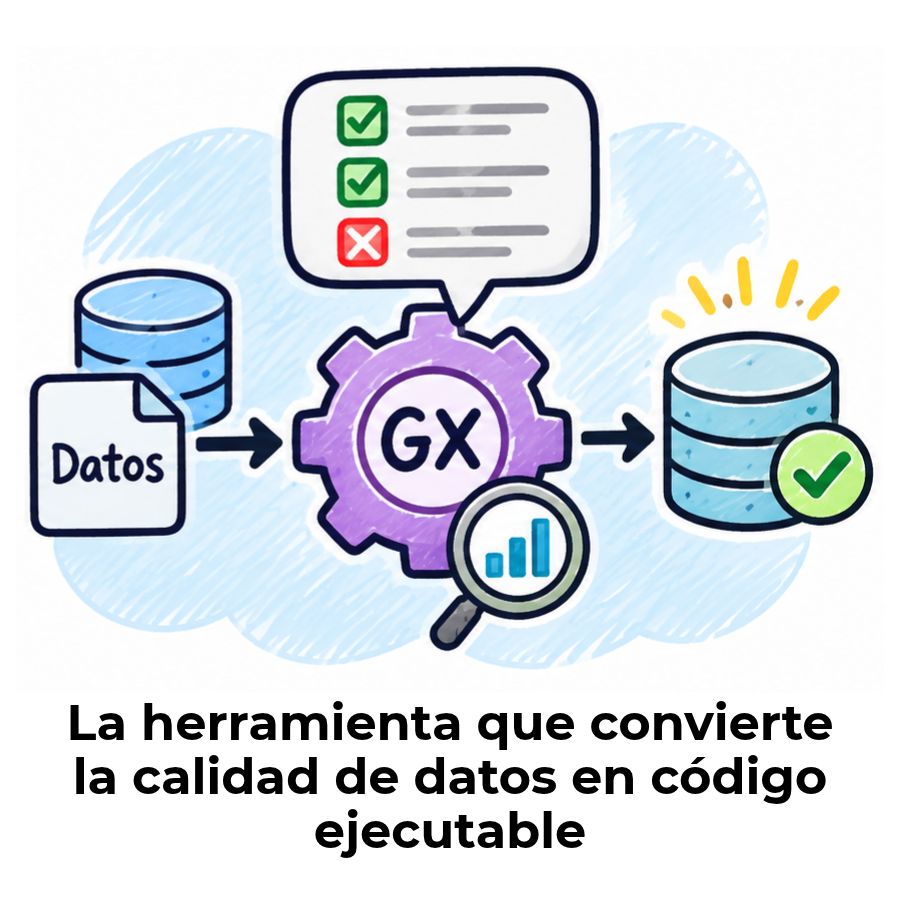
Great Expectations, conocido como GX, es un framework de código abierto escrito en Python que te permite definir reglas de calidad sobre tus datos, validarlas automáticamente dentro de tu pipeline y documentar los resultados de forma clara. Si trabajas en ingeniería de datos y quieres controlar lo que entra y sale de tus flujos, esta herramienta está hecha para ti.
¿Qué es Great Expectations (GX)?
Great Expectations (GX) es un framework de código abierto escrito en Python que permite a los equipos de datos definir, ejecutar y documentar validaciones automáticas sobre sus datos. En lugar de escribir verificaciones dispersas a lo largo de un pipeline, GX te da una forma estructurada de declarar exactamente qué esperas de tus datos y comprobarlo en cada ejecución.
El nombre no es casual: en GX, cada regla de calidad se llama literalmente una «expectativa» (Expectation). Puedes declarar que una columna no debe tener valores nulos, que los valores de un campo deben estar entre dos números o que cierta columna debe contener solo valores únicos. GX toma esas declaraciones y las convierte en pruebas ejecutables contra tus datos reales.
El resultado de cada validación queda registrado de forma clara: pasó o falló, con detalle de qué filas o valores no cumplieron la regla. Eso convierte a GX en algo más que un validador: es una capa de control de calidad que vive dentro de tu pipeline y actúa de forma proactiva antes de que los datos lleguen a producción.
El problema que GX viene a resolver
En la mayoría de los equipos de datos, las reglas de calidad existen, pero viven en documentos, correos o en la cabeza de las personas. Nadie las verifica de forma sistemática. El problema no son los datos corruptos, sino las expectativas que nunca se escribieron como código. Cuando un campo llega vacío, con el tipo incorrecto o fuera de rango, el pipeline sigue corriendo como si nada hubiera pasado.
GX propone un cambio de mentalidad: que las reglas de calidad sean parte del código, no de la documentación. Así, cada vez que corre el pipeline, esas reglas se ejecutan automáticamente y producen un resultado verificable. Si algo falla, el error se detecta en el momento justo, antes de que los datos lleguen a un dashboard o alimenten un modelo de machine learning.
GX como «prueba unitaria para datos»
Una forma de entender GX rápidamente es compararlo con las pruebas unitarias en desarrollo de software. Cuando un desarrollador escribe código, crea tests para verificar que ese código funciona como se espera. GX aplica exactamente esa misma lógica a los datos: en lugar de probar el comportamiento del código, pruebas el comportamiento de los datos.
GX es el pytest de la calidad de datos: hace que probar tus datos se sienta tan natural como probar tu código.
Esto significa que puedes integrar las validaciones de GX en tu flujo de trabajo de la misma manera en que integrarías cualquier test automatizado: en un pipeline de CI/CD, como una tarea dentro de un DAG de Airflow o como un paso de verificación antes de cargar datos a un almacén.
Componentes principales de GX
Para trabajar con GX, necesitas entender los cuatro bloques que forman su arquitectura. Cada uno tiene un rol específico y todos se conectan entre sí para construir un flujo de validación completo. A continuación, encontrarás una descripción clara de cada componente.
Data Context
El Data Context es el componente que inicia cualquier flujo de trabajo en GX. Actúa como la «torre de control» del proyecto: contiene las configuraciones, gestiona las conexiones a las fuentes de datos y almacena los metadatos de las validaciones. En la práctica, se crea con una sola línea de Python: context = gx.get_context(), y desde ahí se accede a todo lo demás.
Existen tres tipos de Data Context según el entorno: uno en memoria (Ephemeral), uno basado en archivos locales (FileDataContext) y uno conectado a GX Cloud (CloudDataContext). La elección depende de si trabajas en un proyecto individual, en un equipo pequeño o en una organización con necesidades de colaboración más amplias.
Expectations y Expectation Suites
Una Expectation es una afirmación verificable sobre los datos. Puede ser tan simple como «esta columna no debe tener valores nulos» o «los valores de este campo deben estar entre 0 y 100». GX incluye una biblioteca de más de 50 Expectations predefinidas que cubren los casos más comunes, y también puedes crear las tuyas propias si el proyecto lo requiere.
Las Expectations se agrupan en Expectation Suites, que son conjuntos de reglas asociados a un contexto específico. Por ejemplo, puedes tener una suite para validar datos de usuarios y otra para validar transacciones financieras. Esa separación permite aplicar reglas distintas a fuentes distintas, sin mezclar lógicas que no tienen relación entre sí.
Checkpoints
El Checkpoint es el componente que ejecuta las validaciones en un contexto de producción. Combina una Expectation Suite con una fuente de datos y lanza las pruebas; luego aplica acciones según el resultado. Esas acciones pueden incluir bloquear el pipeline si la validación falla, enviar una notificación a Slack o generar los Data Docs automáticamente.
Cuando integras GX con un orquestador como Apache Airflow, el Checkpoint se convierte en una tarea más dentro del DAG. Si la validación falla, el pipeline se detiene antes de que los datos incorrectos avancen. Esto es lo que hace de GX una herramienta de control real y no solo un verificador pasivo.
Data Docs
Los Data Docs son páginas HTML que GX genera automáticamente después de cada validación. Muestran qué Expectations se definieron, cuáles pasaron y cuáles fallaron, con un nivel de detalle suficiente para que cualquier persona del equipo entienda el estado de los datos. No hace falta saber programar para leer un Data Doc, lo que facilita la comunicación entre ingenieros y otros perfiles del equipo.
Esa característica convierte los Data Docs en algo más que un reporte técnico: son una forma de documentar los estándares de calidad del equipo de manera viva y actualizada. Cada vez que corre una validación, el documento se regenera con los resultados más recientes, creando un historial de la calidad de los datos a lo largo del tiempo.
¿Cómo funciona GX por dentro?
El flujo de trabajo de GX sigue un patrón claro y repetible. Primero defines el entorno mediante el Data Context. Luego conectas GX a tu fuente de datos: puede ser un archivo CSV, una base de datos SQL, un DataFrame de pandas o un clúster de Apache Spark. A continuación, declaras las reglas de calidad en una Expectation Suite y las ejecutas a través de un Checkpoint.
Lo que diferencia a GX de una simple verificación ad hoc es que el Validator empuja las comprobaciones directamente al motor que contiene los datos: si es un DataFrame de pandas, corre en pandas; si es una tabla en PostgreSQL o BigQuery, ejecuta las validaciones como consultas SQL sin mover los datos. Eso hace que GX sea eficiente incluso con grandes volúmenes.
Al terminar la validación, GX devuelve un objeto de resultado que indica si cada Expectation pasó o falló, junto con estadísticas básicas del lote analizado. Ese resultado alimenta los Data Docs y también puede usarse para disparar acciones programadas, como detener el pipeline, registrar el fallo en un sistema de monitoreo o notificar al equipo.
GX Core y GX Cloud: ¿cuál es la diferencia?
La plataforma de Great Expectations tiene dos componentes principales que conviene distinguir desde el principio. Entender para qué sirve cada uno te ayuda a elegir cuál se adapta mejor al momento de tu proyecto.
| Característica | GX Core | GX Cloud |
|---|---|---|
| Tipo | Librería open source (Python) | Plataforma SaaS gestionada |
| Licencia | Apache 2.0 (gratuita) | Plan de pago (con tier gratuito) |
| Instalación | pip install great_expectations | Cuenta online, sin instalación |
| Colaboración en equipo | Manual, con gestión propia | Integrada, con roles y permisos |
| Interfaz visual | Solo Data Docs (HTML local) | Panel web con historial y alertas |
| Ideal para | Proyectos individuales o pipelines de código | Equipos que necesitan observabilidad centralizada |
GX Core es el motor: contiene toda la lógica de validación, la biblioteca de Expectations y la capacidad de integración con orquestadores. GX Cloud añade la infraestructura de colaboración: programación de validaciones desde la interfaz, notificaciones configurables, historial de resultados y control de acceso por roles. Si estás empezando, GX Core es todo lo que necesitas.
¿Con qué herramientas se integra Great Expectations?
Una de las razones por las que GX se adoptó tan rápidamente en equipos de ingeniería de datos es su capacidad para encajar dentro del stack existente sin obligarte a reescribir nada. GX se integra de forma nativa con los principales orquestadores y motores de procesamiento que ya se usan en la mayoría de los pipelines modernos.
Integración con Apache Airflow
La integración entre GX y Apache Airflow es una de las más usadas en producción. Cuando aprendes a crear tu primer DAG en Apache Airflow, puedes añadir un Checkpoint de GX como una tarea más dentro del flujo. Si la validación falla, el DAG se detiene y los datos incorrectos no avanzan hacia las tareas siguientes, evitando que el problema se propague.
En la práctica, el Checkpoint de GX se ejecuta como un operador de Python dentro del DAG. Recibe el lote de datos del día, corre las Expectations definidas y devuelve un resultado. Si ese resultado indica fallo, Airflow puede lanzar una alerta, marcar la tarea como fallida y notificar al equipo. Todo esto ocurre sin intervención manual y en el momento exacto en que el problema aparece.
Integración con Spark y bases de datos SQL
Cuando tus datos viven en un clúster de Apache Spark, GX conecta directamente al motor y distribuye las validaciones entre las particiones del clúster. Las comprobaciones se ejecutan en paralelo, lo que las hace viables incluso con volúmenes que no cabrían en memoria en una sola máquina. El resultado se recoge al final como un resumen estadístico que alimenta los Data Docs.
Para bases de datos relacionales y almacenes modernos como PostgreSQL, BigQuery, Snowflake o Redshift, GX traduce las Expectations a consultas SQL que se ejecutan directamente en el motor. No extrae los datos a Python para validarlos: los valida donde están. Eso reduce el tiempo de ejecución y elimina la necesidad de mover grandes volúmenes de datos solo para comprobar su calidad.
Casos de uso reales de GX en pipelines de datos
Entender GX en abstracto es útil, pero verlo aplicado a situaciones reales ayuda a identificar cuándo y por qué conviene usarlo. Estos son los escenarios donde GX aporta más valor dentro del campo de la ingeniería de datos:
- Validación en la ingesta de datos: Cada vez que llegan datos externos —de una API, un proveedor o un archivo— GX verifica que el esquema y los valores cumplan las reglas antes de que entren al almacén. Si algo no cuadra, el pipeline se detiene y se genera una alerta.
- Control de calidad tras transformaciones: Después de que dbt u otra herramienta transforma los datos, GX comprueba que el resultado sea coherente: sin duplicados inesperados, sin valores fuera de rango, sin campos que deberían estar presentes pero faltan.
- Validación de datos para modelos de machine learning: Antes de entrenar un modelo, GX verifica que los datos de entrenamiento cumplan distribuciones esperadas y no contengan valores que rompan el proceso de entrenamiento o sesguen los resultados.
- Auditoría y cumplimiento normativo: GX permite documentar automáticamente que los datos cumplen requisitos regulatorios: campos obligatorios presentes, rangos aceptables, formatos correctos. Los Data Docs sirven como evidencia auditable.
- Monitoreo continuo de la calidad: En pipelines que corren a diario, GX actúa como un sistema de vigilancia que detecta degradaciones graduales: si la proporción de nulos en un campo empieza a crecer, GX lo detecta antes de que se convierta en un problema visible.
Limitaciones que debes conocer antes de usar GX
GX es una herramienta poderosa dentro de su ámbito, pero no resuelve todos los problemas de calidad de datos. Conocer sus límites desde el principio te ahorra frustraciones y te ayuda a combinarlo con otras herramientas cuando el proyecto lo requiere.
GX no es una plataforma de observabilidad completa: no rastrea el linaje de los datos, no detecta anomalías estadísticas sin que hayas definido las reglas correspondientes y no es adecuado para validar flujos de datos en tiempo real. Para esas necesidades existen otras herramientas que se complementan con GX en un stack más amplio.
Tampoco reemplaza a herramientas de orquestación como Airflow ni a transformadores como dbt. Su rol es específico: ser la capa de validación de calidad que actúa en puntos concretos del pipeline. Cuando se usa con esa claridad de propósito, GX cumple su función de forma precisa y sin fricciones innecesarias.
Preguntas frecuentes
¿Great Expectations es de código abierto?
Sí. GX Core, la librería principal de Great Expectations, es completamente de código abierto bajo la licencia Apache 2.0, lo que significa que puedes usarla, modificarla y distribuirla sin coste. La plataforma también ofrece GX Cloud, que es un servicio gestionado con funcionalidades adicionales de colaboración, pero GX Core no requiere ningún pago ni suscripción para usarse en proyectos individuales o de equipo. Puedes acceder al código fuente y a la documentación oficial en el sitio oficial de Great Expectations.
¿Qué lenguaje de programación usa Great Expectations?
Great Expectations está escrito enteramente en Python y se usa desde Python. Para instalar GX Core, basta con ejecutar pip install great_expectations en tu entorno. Toda la interacción con GX —definir Expectations, ejecutar Checkpoints, configurar el Data Context— se hace a través de código Python, lo que lo hace compatible con cualquier flujo de trabajo que ya use este lenguaje, incluidos notebooks, scripts y pipelines orquestados.
¿Cuál es la diferencia entre una Expectation y un Checkpoint en GX?
Una Expectation es una regla de calidad declarada sobre los datos, como «esta columna no debe tener nulos» o «los valores deben ser únicos». Un Checkpoint, por su parte, es el mecanismo que ejecuta un conjunto de Expectations (agrupadas en una Suite) sobre un lote de datos real. La Expectation define qué se debe cumplir; el Checkpoint es el que realmente lo comprueba y lanza las acciones correspondientes según el resultado de la validación.
¿GX valida datos en tiempo real o solo en lotes?
GX está diseñado principalmente para la validación por lotes (batch validation). Recibe un conjunto de datos, aplica las Expectations y devuelve un resultado. No está optimizado para validar flujos de datos continuos en tiempo real, como los que llegan a través de Kafka u otros sistemas de streaming. Si necesitas validación en tiempo real, GX puede complementarse con otras herramientas especializadas en observabilidad de streams, pero no es su caso de uso principal.
¿Qué son los Data Docs en Great Expectations?
Los Data Docs son páginas HTML que GX genera automáticamente al ejecutar una validación. Muestran las Expectations definidas, los resultados de cada una, las estadísticas del lote analizado y un resumen general de la calidad. Su propósito es hacer los resultados de las validaciones accesibles para todo el equipo, no solo para quienes escriben el código. Se pueden compartir como archivos locales, publicar en un bucket de almacenamiento en la nube o visualizar directamente desde GX Cloud.
¿Great Expectations reemplaza a dbt o Apache Airflow?
No. GX cumple un rol diferente al de dbt y Airflow. dbt se encarga de transformar los datos; Airflow los orquesta; GX valida su calidad. Las tres herramientas se complementan: Airflow puede ejecutar GX como una tarea dentro del pipeline, y GX puede validar los datos que dbt produce antes de que lleguen a los sistemas de consumo. Usarlos juntos da como resultado un pipeline más robusto, donde cada herramienta hace lo que mejor sabe hacer.
¿Cómo se instala Great Expectations?
La instalación de GX Core es sencilla y se realiza directamente desde pip. Con el entorno Python activo, basta con ejecutar pip install great_expectations en la terminal. Una vez instalado, puedes iniciar un Data Context con import great_expectations as gx seguido de context = gx.get_context(). No se requiere configuración adicional para empezar a definir Expectations sobre tus datos en un entorno local o de desarrollo.
Conclusión
Great Expectations (GX) es un framework de código abierto que convierte las reglas de calidad de datos en pruebas ejecutables dentro de tu pipeline. Su enfoque declarativo —definir qué esperas de tus datos y verificarlo automáticamente— resuelve uno de los problemas más comunes en ingeniería de datos: descubrir errores tarde, cuando ya afectaron decisiones o sistemas productivos.
A lo largo de este artículo viste sus cuatro componentes clave, cómo funciona por dentro, con qué herramientas se integra y cuáles son sus límites reales. Puedes empezar con GX Core de forma gratuita, integrarlo en un DAG de Airflow o usarlo para validar los resultados de tus transformaciones antes de que lleguen al consumidor final. La curva de entrada es corta y el impacto en la confiabilidad de tus pipelines es inmediato.
Si este tema despertó tu interés, en este sitio web encontrarás más contenido sobre herramientas, conceptos y buenas prácticas en el campo de los datos. Seguir explorando es la mejor forma de construir una base sólida en ingeniería de datos.
Sigue aprendiendo:
100 preguntas de entrevista para ingeniero de datos
¿Qué es PySpark y para qué sirve?
Librerías de Python para ingeniería de datos
¿Cómo optimizar jobs de Apache Spark?
Arquitectura de datos: El secreto que mueve los datos de tu empresa
Pipeline de datos: El mecanismo que nadie te explica bien
Diferencia entre Parquet y CSV
Apache Airflow: Automatiza y controla tus flujos de datos con Python
