
Airflow, Dagster y Prefect hacen lo mismo sobre el papel: orquestar pipelines de datos. Sin embargo, su forma de entender ese trabajo es tan diferente que elegir el equivocado puede costarte semanas de rediseño. Antes de decidir, vale la pena entender qué filosofía hay detrás de cada uno.
¿Qué es un orquestador de pipelines de datos?
Un orquestador de pipelines es una herramienta que coordina cuándo, en qué orden y bajo qué condiciones se ejecuta cada paso de un flujo de datos. No procesa ni transforma los datos por sí mismo; su trabajo es dirigir el tráfico: decide qué tarea arranca primero, cuál espera a que otra termine y qué ocurre si algo falla en el camino.
Sin orquestación, un pipeline de datos es un conjunto de scripts que alguien debe lanzar a mano o programar con cron jobs frágiles. Con un orquestador, ese mismo pipeline se convierte en un proceso reproducible, monitoreado y capaz de recuperarse de errores sin intervención humana constante.
¿Por qué la orquestación importa en ingeniería de datos?
A medida que un proyecto crece, el número de scripts, consultas y transferencias de datos también crece. Gestionar manualmente esas dependencias se vuelve insostenible muy rápido: un archivo que llega tarde rompe todo lo que depende de él, y sin un sistema centralizado, detectar el problema puede llevar horas. Un orquestador resuelve exactamente eso.
Además, la orquestación aporta trazabilidad: puedes ver qué se ejecutó, cuándo, cuánto tardó y si produjo el resultado esperado. Esa visibilidad es especialmente valiosa cuando varios equipos comparten los mismos datos y necesitan saber en qué estado se encuentra cada pieza del pipeline.
¿Cómo funciona un DAG y por qué lo usan estos tres orquestadores?
Un DAG, del inglés Directed Acyclic Graph, es una estructura que representa un flujo de trabajo como un conjunto de nodos (tareas) conectados por flechas que indican el orden de ejecución. La palabra «acíclico» significa que no hay ciclos: ninguna tarea puede depender de sí misma ni crear un bucle infinito.
Airflow, Dagster y Prefect usan variantes de este modelo para definir sus pipelines. La diferencia está en qué colocan en esos nodos: Airflow y Prefect ponen tareas, mientras que Dagster pone activos de datos, es decir, los resultados que cada paso debe producir. Esa distinción, aparentemente pequeña, cambia por completo la forma de trabajar con cada herramienta.
¿Cuál es la diferencia entre Airflow, Dagster y Prefect?
La diferencia central está en su modelo de orquestación: Airflow organiza el trabajo como una secuencia de tareas con dependencias explícitas; Prefect hace lo mismo, pero con una sintaxis más simple y centrada en Python puro; y Dagster cambia el enfoque radicalmente al poner los activos de datos —las tablas, los archivos, los modelos— en el centro del pipeline, no las tareas que los generan.
Desde el punto de vista práctico, esto afecta directamente a cómo depuras un error, cómo observas el estado de tus datos y cuánto tiempo tardas en arrancar. Airflow es el más maduro y el más complejo; Prefect es el más rápido de adoptar; Dagster es el más orientado a la calidad del dato. Los tres son open source y tienen opciones gestionadas en la nube.
Apache Airflow: el estándar consolidado
Apache Airflow es el orquestador de pipelines de datos más utilizado en la industria. Nació en Airbnb en 2014, se donó a la Apache Software Foundation en 2016 y desde entonces ha crecido hasta convertirse en la opción por defecto de equipos de ingeniería de datos en empresas de todos los tamaños. Su madurez, su comunidad y la cantidad de integraciones disponibles son su mayor argumento.
Modelo de tareas y DAGs en Airflow
En Airflow, todo gira alrededor del DAG. Defines cada paso de tu pipeline como una tarea, luego indicas qué tarea debe ejecutarse antes que otra, y el planificador de Airflow se encarga del resto: lanzar las tareas en el momento correcto, registrar su estado y reintentar las que fallen según la configuración que hayas establecido. Cada tarea es independiente y puede ejecutarse en su propio proceso o contenedor.
El planificador de Airflow lee los archivos Python donde defines tus DAGs y los almacena en una base de datos de metadatos. A partir de ahí, monitorea continuamente el tiempo y las dependencias para decidir cuándo ejecutar cada tarea. Este modelo es muy potente para pipelines batch con horarios fijos, pero puede volverse rígido cuando necesitas flujos más dinámicos.
Ecosistema, integraciones y opciones gestionadas
El ecosistema de Airflow es el más amplio de los tres. Cuenta con más de mil proveedores oficiales que permiten conectar con bases de datos, servicios en la nube, APIs, herramientas de transformación y mucho más, todo sin escribir código personalizado. Esa cobertura hace que sea más fácil integrarlo en un stack tecnológico existente que cualquiera de sus competidores.
En cuanto a opciones gestionadas, puedes usar Airflow en la nube a través de Amazon MWAA, Google Cloud Composer o Astronomer, que es la opción comercial más popular. Estas plataformas te ahorran la gestión de la infraestructura, aunque su coste puede ser significativo para equipos pequeños.
Ventajas y limitaciones de Airflow
✅ Ventajas
- Ecosistema de integraciones inigualable
- Comunidad enorme y documentación extensa
- Opciones gestionadas en los tres grandes proveedores cloud
- Alta escalabilidad para pipelines complejos
- Amplio mercado laboral con profesionales formados
⚠️ Limitaciones
- Curva de aprendizaje pronunciada al principio
- Infraestructura compleja de configurar y mantener
- DAGs estáticos: poco flexibles para flujos dinámicos
- Costo operativo elevado en entornos autogestionados
- Depuración de errores puede ser lenta
Dagster: orquestación centrada en activos de datos
Dagster es el más joven de los tres y también el que propone el cambio conceptual más profundo. En lugar de pensar en tareas que ejecutar, Dagster te pide que pienses en activos de datos que producir: una tabla en tu warehouse, un archivo Parquet, un modelo de machine learning. El pipeline existe para materializar esos activos, no al revés.
¿Qué son los software-defined assets y para qué sirven?
Un software-defined asset es una declaración explícita de que tu código produce un dato concreto. Cuando defines un asset en Dagster, la herramienta sabe qué produjo ese paso, cuándo se materializó por última vez y de qué otros assets depende. Esto genera automáticamente un grafo de dependencias entre datos, no entre tareas, lo que facilita enormemente entender el impacto de cualquier cambio.
Este enfoque es especialmente útil cuando trabajas con dbt, ya que Dagster puede tratar cada modelo de dbt como un asset de primera clase, con su propio historial de materializaciones y sus pruebas de calidad integradas. El resultado es un pipeline donde puedes ver el estado de cada dato del sistema de un solo vistazo.
Observabilidad y linaje en Dagster
Uno de los puntos diferenciales de Dagster es su capacidad de observabilidad. El catálogo de assets de Dagster registra cada materialización: qué se ejecutó, qué datos produjo, qué metadatos generó y si las comprobaciones de calidad pasaron correctamente. Cuando algo falla, puedes rastrear exactamente qué asset falló y cuál es el impacto en el resto del grafo.
El linaje de columnas —disponible en Dagster+, su versión gestionada— va un paso más allá y te permite ver no solo qué tablas dependen de qué, sino qué columnas específicas provienen de dónde. Para equipos que necesitan cumplir con normativas de datos o implementar una estrategia de ingeniería de datos robusta, esta capacidad puede ser determinante.
Ventajas y limitaciones de Dagster
✅ Ventajas
- Observabilidad y linaje de datos nativos
- Integración de primera clase con dbt
- Excelente experiencia de desarrollo local
- Testing sencillo gracias a la inyección de dependencias
- Pensado desde el inicio para calidad del dato
⚠️ Limitaciones
- El paradigma de assets puede ser difícil de asimilar al principio
- Ecosistema más pequeño que Airflow
- Menos profesionales formados en el mercado laboral
- Dagster+ tiene un modelo de precios basado en créditos
- Migrar desde Airflow requiere repensar la arquitectura
Prefect: la opción Python-first de menor fricción
Prefect nació con un objetivo claro: hacer que llevar un script de Python a producción sea lo más sencillo posible. Su filosofía es que un pipeline de datos no debería requerir cambiar radicalmente la forma en que ya escribes código. Con unos pocos decoradores, una función Python ordinaria se convierte en un flujo orquestado, con reintentos, logs y monitoreo incluidos.
Flujos y decoradores: cómo funciona Prefect
En Prefect, el concepto central es el flow. Un flow es simplemente una función Python decorada con @flow, y cada paso dentro de ella que decores con @task se convierte en una tarea rastreada. Prefect descubre el grafo de dependencias mientras la función se ejecuta, en tiempo real, lo que permite crear flujos dinámicos que Airflow no podría representar con un DAG estático.
Esta aproximación reduce significativamente la cantidad de código necesario para arrancar. No necesitas configurar un entorno complejo ni aprender un DSL propio; si ya sabes Python, en unas horas puedes tener tu primer pipeline funcionando. Esa baja fricción inicial es el principal argumento de Prefect frente a sus competidores.
Prefect Cloud y despliegue sin infraestructura propia
Prefect Cloud es la opción gestionada de la herramienta. Ofrece un panel de control, alertas, gestión de secretos y automatizaciones sin que necesites levantar ni mantener ningún servidor. Tu código corre en tu propia infraestructura (o en ninguna si usas workers serverless), y Prefect Cloud se limita a coordinar y registrar los resultados. Esto hace que el coste operativo sea notablemente bajo comparado con Airflow autogestionado.
El plan gratuito de Prefect Cloud es generoso para proyectos de tamaño reducido. A medida que escalas, los planes de pago ofrecen más usuarios, roles y funcionalidades de gobernanza. Para equipos que empiezan, es habitual arrancar en el tier gratuito y no necesitar más durante meses.
Ventajas y limitaciones de Prefect
✅ Ventajas
- La curva de aprendizaje más baja de los tres
- Flujos dinámicos sin las limitaciones de un DAG estático
- Prefect Cloud con plan gratuito generoso
- Monitoreo y alertas nativos muy completos
- Mínimo código adicional sobre Python estándar
⚠️ Limitaciones
- Ecosistema de integraciones más pequeño que Airflow
- Linaje de datos menos desarrollado que Dagster
- Primitivas de gobernanza empresarial más recientes
- Menos patrones establecidos para incidentes a gran escala
- Comunidad open source más pequeña que Airflow
Comparativa directa: Airflow vs. Dagster vs. Prefect
A continuación encontrarás una tabla que resume los aspectos más relevantes de los tres orquestadores para que puedas compararlos de un vistazo. Ninguna herramienta gana en todos los criterios; la clave está en identificar cuáles son prioritarios para tu proyecto concreto.
| Criterio | Apache Airflow | Dagster | Prefect |
|---|---|---|---|
| Modelo central | Tareas en DAGs | Activos de datos (assets) | Flujos Python (flows) |
| Curva de aprendizaje | Media-alta | Media-alta (paradigma nuevo) | Baja |
| Desarrollo local | Docker Compose | dagster dev (excelente) | pip install + ejecución directa |
| Testing | Complejo (requiere mocking) | Excelente (inyección de dependencias) | Sencillo (funciones Python puras) |
| Integración con dbt | BashOperator / provider | Assets de primera clase | Vía subprocess |
| Ecosistema | Enorme (+1.000 providers) | Mediano, creciendo | Mediano, creciendo |
| Opción gestionada | MWAA, Composer, Astronomer | Dagster+ | Prefect Cloud |
| Flujos dinámicos | Limitados | Sí, con auto-materialización | Sí, nativos en tiempo de ejecución |
| Observabilidad / linaje | Logs y grid view | Grafo de assets + linaje de columnas | Panel de flow runs y alertas |
| Comunidad open source | La más grande | Mediana, activa | Mediana, activa |
Al comparar también las herramientas vecinas del ecosistema, como ocurre con la comparativa entre Apache Flink vs. Spark Streaming, queda claro que en ingeniería de datos la elección correcta no depende de modas, sino de los requisitos reales del proyecto y del equipo.
¿Cuándo elegir cada orquestador?
La tabla anterior muestra las diferencias técnicas, pero la decisión real depende de factores más concretos: el tamaño de tu equipo, la madurez del proyecto, el presupuesto para infraestructura y la prioridad que le das a la velocidad frente a la robustez. No existe una opción universalmente correcta; existe la opción correcta para tu contexto.
Señales para escoger Airflow
Airflow encaja mejor cuando el contexto favorece la estabilidad y el ecosistema por encima de la velocidad de adopción. Si ya tienes pipelines funcionando en Airflow, la relación coste-beneficio de migrar a otra herramienta raramente compensa, especialmente si el equipo conoce bien la plataforma. También es la elección más segura cuando el proyecto tiene más de cien pipelines, requiere integraciones con sistemas poco comunes o necesita soporte empresarial garantizado.
Elige Airflow si…
- Tu equipo tiene un perfil de ingeniería de datos consolidado.
- Necesitas integraciones con sistemas legados o muy específicos.
- Ya tienes una inversión existente en Airflow que funciona bien.
- Requieres un mercado laboral amplio para contratar perfiles formados.
Señales para escoger Dagster
Dagster es la mejor opción cuando la calidad del dato y la trazabilidad son requisitos de primer nivel, no características opcionales. Si tu proyecto gira alrededor de dbt, si necesitas saber en todo momento qué datos están frescos y cuáles no, o si estás construyendo una plataforma de datos desde cero con visión a largo plazo, Dagster ofrece una arquitectura que crece con esa complejidad sin añadir caos.
Elige Dagster si…
- La calidad y el linaje de datos son prioritarios en tu organización.
- Usas dbt intensivamente y quieres observabilidad nativa.
- Estás construyendo una plataforma de datos nueva desde cero.
- Necesitas que tus pipelines se comporten como software bien testeado.
Señales para escoger Prefect
Prefect brilla en entornos donde la velocidad de entrega importa más que la profundidad de la observabilidad. Si tu equipo es pequeño, si los plazos son ajustados o si simplemente quieres llevar un pipeline a producción sin dedicar días a configurar infraestructura, Prefect es la ruta más corta. También es ideal para proyectos de machine learning o análisis donde los flujos cambian con frecuencia y necesitas flexibilidad dinámica.
Elige Prefect si…
- Eres un equipo pequeño o trabajas de forma individual.
- Quieres producción rápida con mínima infraestructura propia.
- Tus flujos son dinámicos y cambian con frecuencia.
- Priorizas el monitoreo y las alertas sobre el linaje de columnas.
Preguntas frecuentes
¿Qué diferencia hay entre un DAG y un activo de datos en orquestación?
Un DAG es una representación del flujo de trabajo centrada en las tareas: qué pasos ejecutar y en qué orden. Un activo de datos, en cambio, representa el resultado que debe producir ese paso: una tabla, un archivo o un modelo. Airflow y Prefect razonan en términos de tareas; Dagster razona en términos de activos. Esta diferencia cambia cómo observas el estado de tu pipeline: con un DAG ves si las tareas corrieron; con un activo, ves si el dato está actualizado y si pasó sus comprobaciones de calidad.
¿Puede un equipo pequeño usar Apache Airflow sin problemas?
Puede, pero no sin esfuerzo. Airflow requiere mantener varios componentes en producción: un scheduler, un webserver, una base de datos de metadatos y al menos un executor. Para un equipo de dos o tres personas sin un perfil de infraestructura dedicado, ese overhead puede consumir tiempo que debería invertirse en los propios datos. Las opciones gestionadas como Astronomer o Cloud Composer alivian ese problema, aunque a un coste que puede no estar justificado en proyectos pequeños. En ese escenario, Prefect suele ser la alternativa más sensata.
¿Es Dagster más difícil de aprender que Prefect?
En términos de sintaxis pura, Dagster y Prefect tienen una complejidad similar. La dificultad de Dagster no está en el código, sino en el cambio conceptual: pasar de pensar en tareas a pensar en activos requiere replantearse cómo diseñas tus pipelines desde el inicio. Para alguien que viene de Airflow, ese salto puede costar semanas. Prefect, en cambio, es intuitivo desde el primer día porque se parece mucho a escribir Python normal, con apenas dos decoradores nuevos que aprender.
¿Qué orquestador tiene mejor integración con dbt?
Sin duda, Dagster tiene la integración más profunda con dbt. Trata cada modelo de dbt como un asset de primera clase dentro de su catálogo, con historial de materializaciones, pruebas de calidad integradas y linaje automático. Airflow puede ejecutar dbt a través de un operador, pero no tiene visibilidad nativa del estado de los modelos individuales. Prefect ejecuta dbt como un subprocess con un wrapper oficial, lo que funciona bien, pero no ofrece la misma observabilidad que Dagster.
¿Prefect reemplaza a Airflow en todos los casos?
No. Prefect es una alternativa excelente para equipos que buscan sencillez y velocidad, pero no reemplaza a Airflow en todos los escenarios. Cuando un proyecto necesita integraciones con sistemas específicos que solo existen como providers de Airflow, o cuando requiere manejar miles de DAGs con alta heterogeneidad, Airflow sigue siendo más completo. Además, el ecosistema de Airflow acumula años de patrones probados en producción a gran escala que Prefect todavía no puede igualar en profundidad.
¿Cuál de los tres orquestadores tiene mayor comunidad open source?
Apache Airflow tiene, con diferencia, la comunidad open source más grande de los tres. Al ser un proyecto de la Apache Software Foundation, cuenta con contribuciones de cientos de empresas y miles de desarrolladores. Dagster y Prefect tienen comunidades medianas pero activas y en crecimiento, con ciclos de lanzamiento frecuentes y buena respuesta en sus canales de soporte. Para un proyecto que necesite apoyo externo inmediato, Airflow ofrece el mayor volumen de respuestas en foros, GitHub y Stack Overflow.
¿Airflow, Dagster y Prefect son gratuitos?
Los tres son open source y gratuitos en su versión autogestionada. Puedes descargarlos, instalarlos y ejecutarlos en tu propia infraestructura sin pagar nada. Las opciones gestionadas en la nube —Astronomer, Dagster+ y Prefect Cloud— tienen modelos de precios distintos: Prefect Cloud ofrece un tier gratuito generoso; Dagster+ arranca desde diez dólares al mes más créditos de ejecución; y Astronomer está orientado a empresas con precios acordados. Para empezar a aprender, cualquiera de los tres puede usarse sin coste.
Conclusión
Airflow, Dagster y Prefect resuelven el mismo problema de fondo —coordinar pipelines de datos— pero desde filosofías distintas. Airflow apuesta por la madurez y el ecosistema; Dagster, por la calidad y la observabilidad del dato; Prefect, por la velocidad y la sencillez. Ninguna de las tres es objetivamente superior: cada una tiene un contexto donde brilla.
Ahora que conoces las diferencias, puedes aplicar ese conocimiento de forma práctica: si tu equipo es pequeño y necesita resultados rápidos, empieza con Prefect. Si la calidad del dato es tu mayor preocupación, explora Dagster. Y si ya tienes pipelines en producción con Airflow que funcionan, probablemente lo mejor es seguir construyendo sobre esa base. La decisión más inteligente no es elegir la herramienta más popular, sino la que mejor encaja con tu equipo y tu momento.
La orquestación de datos es uno de los pilares de cualquier proyecto de ingeniería de datos sólido. Si quieres seguir profundizando en este y otros temas del ecosistema de datos, en este sitio web encontrarás más contenido pensado para ayudarte a tomar decisiones técnicas con criterio y sin rodeos.
Sigue aprendiendo:
Buenas prácticas de ingeniería de datos
Pipeline de datos: El mecanismo que nadie te explica bien
Procesamiento de datos en tiempo real
Proyectos de ingeniería de datos para portafolio
Microsoft Fabric y Azure Synapse Analytics
¿Qué lenguaje aprender para ser ingeniero de datos?
¿Qué es un data lake y cómo funciona?
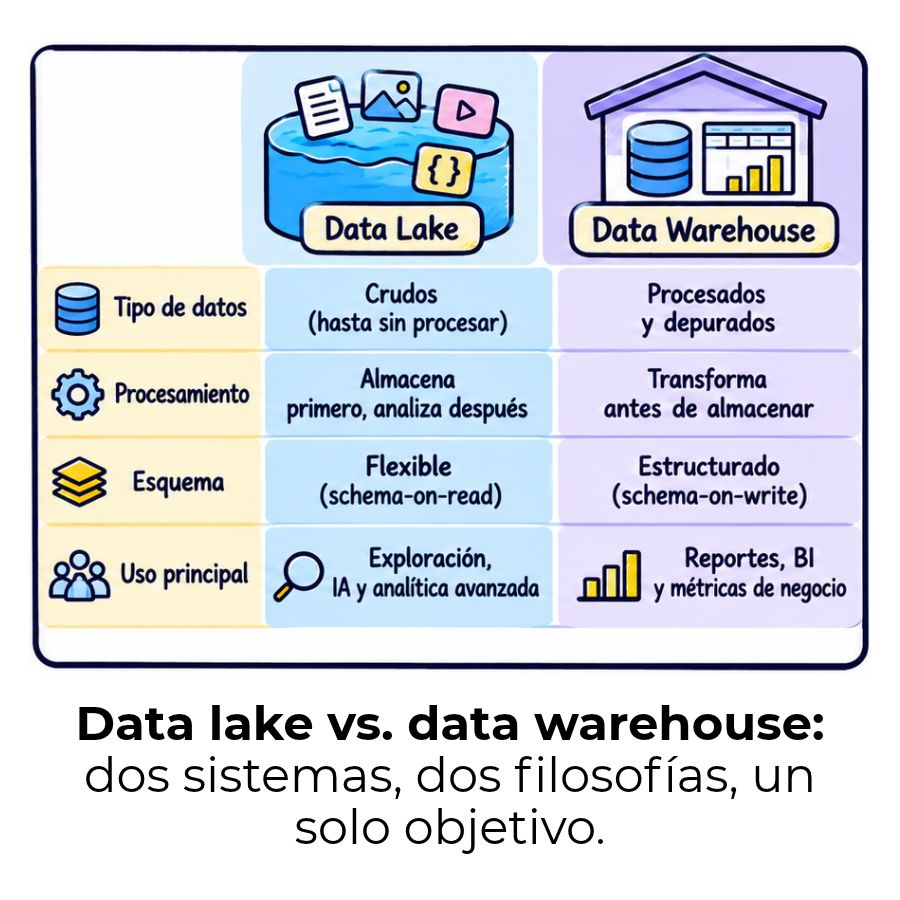
Diferencia entre data lake y data warehouse
