
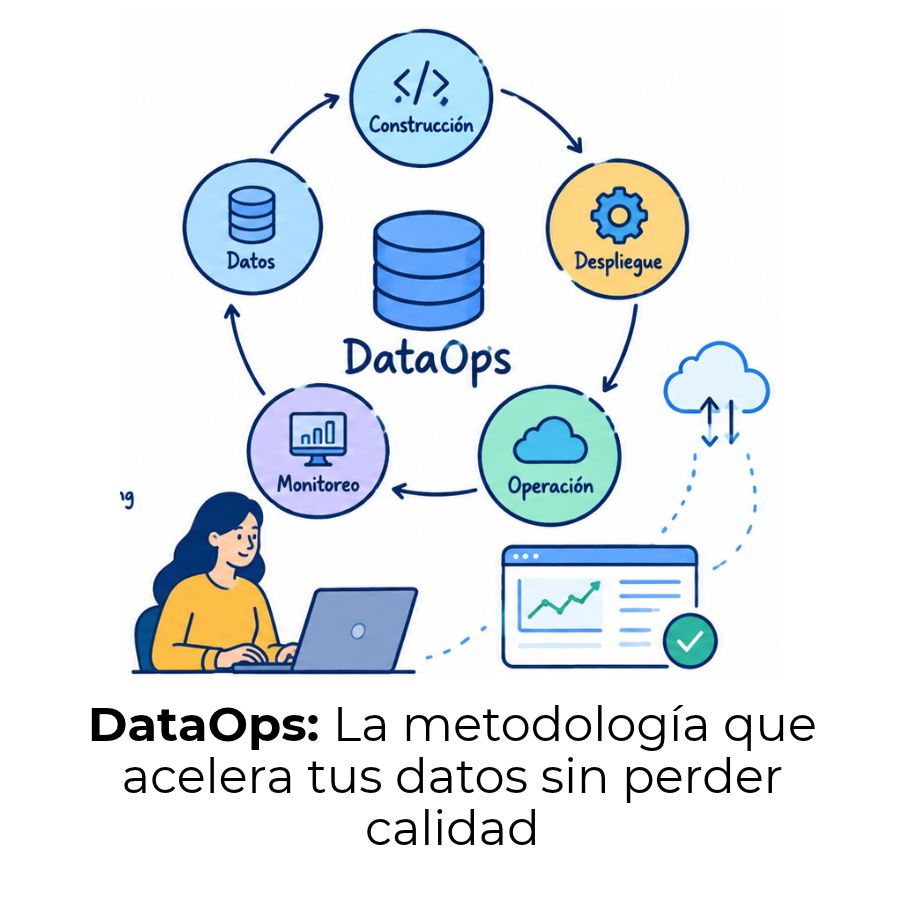
Tienes un equipo de datos, pipelines configurados y herramientas de análisis. Aun así, los datos llegan tarde, con errores o nadie sabe exactamente qué pasó en el proceso. Ese problema tiene nombre: falta de coordinación. Y tiene solución: DataOps. Pero antes de adoptar cualquier práctica, vale la pena entender exactamente qué significa.
¿Qué es DataOps y qué problema resuelve?
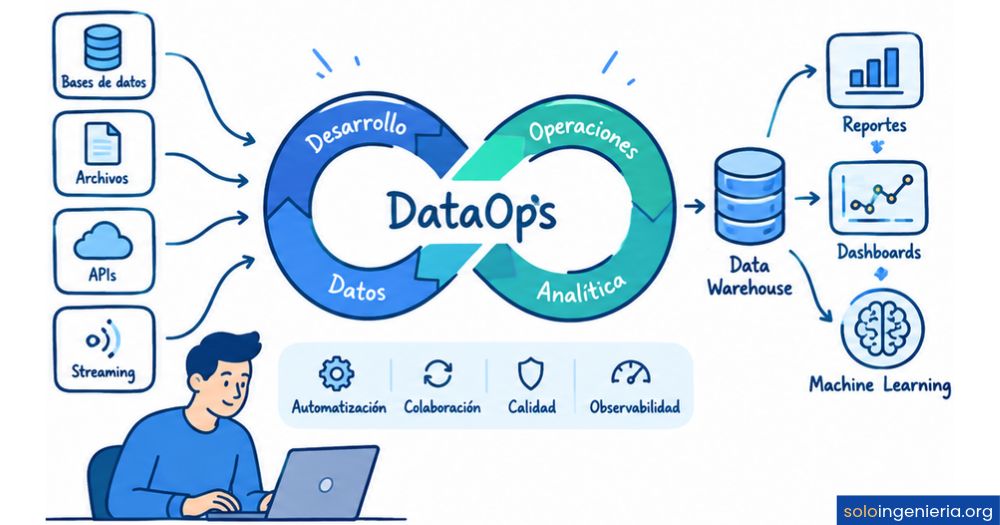
DataOps, cuyas siglas provienen de Data Operations, es una metodología ágil que combina automatización, prácticas colaborativas y principios del desarrollo de software para optimizar el ciclo de vida completo de los datos dentro de una organización. Su objetivo central es que los datos lleguen con rapidez, con calidad verificada y de forma confiable a quienes los necesitan para tomar decisiones.
El problema que resuelve es concreto: durante años, los equipos de ingeniería de datos trabajaron en compartimentos separados. Los ingenieros construían pipelines, los analistas pedían datos y los equipos de negocio esperaban resultados. Esa desconexión generaba retrasos, errores difíciles de rastrear y procesos imposibles de escalar sin duplicar esfuerzos.
El origen del término: de DevOps a DataOps
DataOps nació como una adaptación directa de DevOps, la filosofía que transformó el desarrollo de software al acercar a los equipos de desarrollo y operaciones. Mientras DevOps se concentra en entregar aplicaciones de forma rápida y confiable, DataOps traslada esa misma lógica al universo de los datos: velocidad de entrega, automatización de procesos y colaboración entre todas las partes involucradas en el ciclo de vida del dato.
El término ganó relevancia especialmente a partir de 2017, cuando el ecosistema de herramientas, publicaciones y proyectos de código abierto relacionados comenzó a crecer de forma notable. Desde entonces, se consolidó como una disciplina con principios propios, aunque comparte ADN con metodologías ágiles y el pensamiento Lean proveniente de la manufactura.
¿Por qué los métodos tradicionales de gestión de datos se quedaron cortos?
La gestión tradicional de datos funcionaba con procesos lineales y equipos aislados. Un equipo recopilaba datos, otro los almacenaba, otro los transformaba y, finalmente, alguien los usaba para generar un informe. Cada paso era manual, tardaba días y cualquier error en el origen tardaba semanas en detectarse. El resultado era información lenta, poco confiable y costosa de mantener.
DataOps rompe esa secuencia. En lugar de cadenas lineales, propone flujos continuos con validación automática en cada etapa, lo que permite detectar problemas en tiempo real y corregirlos sin detener todo el proceso. Este cambio de modelo es el que lo hace especialmente valioso cuando los volúmenes de datos crecen y las decisiones de negocio dependen de información actualizada.
Principios fundamentales de DataOps
DataOps se rige por un conjunto de principios que guían cómo los equipos deben pensar y actuar frente a los datos. No son reglas técnicas aisladas, sino compromisos culturales y operativos que definen la forma de trabajar. Cada principio refuerza a los demás y juntos crean un entorno donde los datos se gestionan como un producto de alto valor.
Automatización del ciclo de vida del dato
La automatización es uno de los pilares más concretos de DataOps. Se aplica desde el momento en que un dato entra al sistema —ingesta— hasta que se pone a disposición de los analistas o modelos de machine learning. Cada etapa del pipeline puede programarse para ejecutarse, validarse y monitorearse sin intervención manual constante, lo que reduce drásticamente los errores humanos y los tiempos de espera.
Automatizar no significa eliminar a las personas del proceso. Significa liberar su tiempo para tareas de mayor valor: diseñar mejores arquitecturas, interpretar resultados o resolver problemas complejos que una máquina no puede anticipar. La automatización bien implementada convierte un equipo reactivo en uno proactivo.
Colaboración entre equipos multidisciplinarios
Uno de los problemas más comunes en los equipos de datos es el trabajo en silos: cada área hace su parte sin conocer bien lo que necesita la siguiente. DataOps rompe esa dinámica al crear un marco compartido donde ingenieros de datos, científicos de datos, analistas y áreas de negocio trabajan con visibilidad mutua y objetivos alineados.
Esta colaboración no es solo cultural: se apoya en herramientas de control de versiones, documentación compartida y sistemas de monitoreo que permiten a cualquier miembro del equipo entender el estado del dato en cada momento. Cuando todos hablan el mismo idioma operativo, los problemas se detectan antes y se resuelven más rápido.
Agilidad e iteración continua
DataOps toma prestado de las metodologías ágiles del desarrollo de software el principio de trabajar en ciclos cortos y entregar valor de forma incremental. En lugar de construir un pipeline monolítico durante meses para después descubrir que no cumple con las necesidades del negocio, los equipos DataOps desarrollan, prueban y despliegan en iteraciones pequeñas que pueden ajustarse rápidamente.
Esto también aplica al dato mismo. Las fuentes cambian, los formatos evolucionan y los requisitos de análisis se transforman. Un equipo ágil en DataOps puede absorber esos cambios sin que el flujo completo colapse, porque sus procesos están diseñados para adaptarse, no para resistir el cambio.
¿Cómo funciona DataOps en la práctica?
En la práctica, DataOps organiza el trabajo alrededor del concepto de pipeline de datos: una secuencia automatizada de pasos que transforma datos brutos en información lista para su uso. Cada paso está definido, versionado, monitoreado y probado. No es un proceso que se configura una vez y se olvida: es un sistema vivo que el equipo mantiene, mejora y observa de forma continua.
El pipeline de datos como eje central
Un pipeline DataOps típico recorre varias etapas desde que el dato aparece hasta que llega a su destino final. Cada etapa está automatizada y validada, lo que garantiza que los errores no se propaguen de un extremo al otro sin ser detectados. Conocer estas etapas ayuda a entender por qué DataOps transforma radicalmente la forma de trabajar con datos.
Monitoreo, calidad y observabilidad del dato
En DataOps, el trabajo no termina cuando el pipeline se despliega. El monitoreo continuo es parte integral del proceso: se rastrean métricas de calidad, tiempos de ejecución, tasas de error y anomalías en los datos a lo largo de todo el ciclo. Cuando algo falla o se desvía del comportamiento esperado, el equipo recibe una alerta antes de que el problema llegue al usuario final.
La observabilidad del dato —la capacidad de entender qué ocurrió, cuándo y por qué en cada etapa— es una de las características que distingue a un equipo DataOps maduro. No se trata solo de saber que algo falló, sino de poder trazar exactamente el camino que recorrió el dato hasta ese punto. Esto reduce el tiempo de diagnóstico y facilita la mejora continua del sistema.
DataOps vs. DevOps: ¿en qué se diferencian?
Aunque DataOps nació inspirado en DevOps y comparte varios de sus principios —automatización, integración continua y colaboración entre equipos—, los dos enfoques operan sobre materias primas completamente distintas. Entender esa diferencia ayuda a no confundirlos ni a aplicar uno donde corresponde el otro.
| Dimensión | DevOps | DataOps |
|---|---|---|
| ¿Qué gestiona? | Código y aplicaciones de software | Datos y flujos de información |
| Objetivo principal | Entregar software de forma rápida y confiable | Entregar datos con calidad y velocidad |
| Equipos involucrados | Desarrolladores y operaciones de TI | Ingenieros, analistas, científicos y negocio |
| Producto final | Aplicación o servicio en producción | Dato confiable listo para su uso |
| Herramientas típicas | Jenkins, GitHub Actions, Docker, Kubernetes | Airflow, dbt, Great Expectations, Spark |
| Concepto central | CI/CD de software | CI/CD de datos y pipelines |
La diferencia más importante está en el objeto que se gestiona: DevOps cuida el código y el software que lo ejecuta; DataOps cuida el dato y el flujo que lo transforma. Ambos pueden coexistir en una misma organización, ya que abordan capas distintas de la infraestructura tecnológica.
Beneficios de aplicar DataOps en un equipo de datos
Adoptar DataOps no solo mejora la velocidad con la que los datos llegan a su destino. Genera cambios profundos en la forma en que un equipo opera, se comunica y evoluciona. Los beneficios son tanto técnicos como organizativos, y se hacen más evidentes a medida que el equipo madura en su aplicación.
Uno de los beneficios más citados por los equipos que implementan DataOps es la reducción significativa de los incidentes de datos en producción. Cuando los controles de calidad se ejecutan automáticamente en cada etapa del pipeline, los errores se interceptan antes de llegar al analista o al sistema de toma de decisiones, evitando el costoso proceso de retroalimentación tardía y corrección manual.
¿Cuándo tiene sentido implementar DataOps?
DataOps no es una solución universal que convenga aplicar desde el primer día en cualquier proyecto. Tiene más sentido en contextos donde los datos son numerosos, dinámicos y críticos para la operación. Reconocer esos contextos ayuda a priorizar cuándo merece la pena invertir en este enfoque y cuándo un proceso más simple es suficiente.
Tiene sentido implementarlo cuando tu equipo enfrenta algunos de estos escenarios concretos:
-
📦
Múltiples fuentes de datos: Cuando los datos provienen de bases de datos, APIs externas, archivos, sistemas en tiempo real y cada fuente tiene su propio formato o frecuencia de actualización.
-
⏱️
Entregas lentas o poco confiables: Si el equipo tarda días en responder una petición de datos o si los informes llegan con errores frecuentes que nadie detecta a tiempo.
-
🏢
Equipos que trabajan en silos: Cuando los ingenieros, analistas y áreas de negocio no comparten información ni acuerdan estándares comunes para manejar los datos.
-
🚀
Crecimiento acelerado del volumen: Si el volumen de datos crece más rápido que la capacidad del equipo para gestionarlos manualmente con los procesos actuales.
-
📋
Requisitos de cumplimiento y auditoría: Cuando el negocio necesita demostrar de dónde vienen los datos, cómo se transformaron y quién tuvo acceso en cada etapa del proceso.
Roles clave dentro de un equipo DataOps
DataOps no se implementa con una sola persona ni con un único perfil técnico. Es un esfuerzo colectivo que requiere de distintos roles con responsabilidades claras. La combinación de perfiles técnicos y de negocio es lo que permite que el enfoque funcione de extremo a extremo, sin que ninguna etapa del ciclo del dato quede huérfana de responsabilidad.
Entre estos roles, el DataOps Engineer suele ser el perfil más nuevo y específico de esta disciplina. A diferencia del ingeniero de datos tradicional, que se centra en construir pipelines en tiempo de diseño, el DataOps Engineer asume responsabilidad sobre la operación en producción: garantiza que los pipelines funcionen, que las alertas sean útiles y que el flujo de datos sea confiable a lo largo del tiempo.
Herramientas asociadas a DataOps
DataOps no se implementa con una sola plataforma. El ecosistema de herramientas que lo rodea es amplio y cada equipo combina distintas soluciones según sus necesidades, su infraestructura y el volumen de datos que maneja. Lo importante no es la herramienta en sí, sino cómo encaja dentro de los principios de automatización, colaboración y calidad que definen el enfoque.
Un catálogo de datos bien implementado es uno de los recursos más útiles dentro de un entorno DataOps, ya que permite a todos los equipos conocer qué datos existen, dónde están, quién es responsable de ellos y cómo se han transformado. Sin esa visibilidad compartida, la colaboración entre roles se vuelve mucho más difícil de sostener en la práctica.
| Categoría | Herramientas destacadas | ¿Para qué se usa? |
|---|---|---|
| Orquestación de pipelines | Apache Airflow, Prefect, Dagster | Planificar y coordinar la ejecución de flujos de datos |
| Transformación de datos | dbt (data build tool) | Transformar datos dentro del data warehouse con control de versiones |
| Calidad del dato | Great Expectations, Soda | Definir y ejecutar validaciones automáticas sobre los datos |
| Procesamiento a escala | Apache Spark, Apache Flink | Procesar grandes volúmenes de datos en batch o en tiempo real |
| Observabilidad | Monte Carlo, Bigeye, DataHub | Monitorear la salud del dato y detectar anomalías automáticamente |
| Control de versiones | Git, GitHub, GitLab | Versionar el código de transformación y los scripts de datos |
| Plataformas integradas | Databricks, Snowflake, dbt Cloud | Ofrecer un entorno unificado para ingesta, transformación y análisis |
La selección de herramientas debe seguir a la estrategia, no al revés. Adoptar muchas herramientas sin un proceso claro detrás no convierte a un equipo en DataOps; solo añade complejidad. El criterio de selección siempre debería responder a la pregunta: ¿Esta herramienta me ayuda a automatizar, colaborar o garantizar la calidad de mis datos de forma sostenible?
Preguntas frecuentes
¿Qué significa DataOps?
DataOps es la abreviatura de Data Operations, que en español se traduce como operaciones de datos. Se trata de una metodología ágil que aplica principios de DevOps, Lean y desarrollo iterativo al ciclo de vida completo de los datos. Su propósito es mejorar la velocidad, la calidad y la confiabilidad con la que los datos se producen, transforman y entregan a quienes los necesitan dentro de una organización.
¿Cuál es la diferencia entre DataOps y DevOps?
Aunque comparten principios como la automatización, la integración continua y la colaboración entre equipos, DataOps y DevOps trabajan sobre objetos distintos. DevOps gestiona el ciclo de vida del software: código, pruebas, despliegue y operación de aplicaciones. DataOps gestiona el ciclo de vida del dato: ingesta, transformación, validación, almacenamiento y entrega de información. Pueden coexistir en la misma organización sin conflicto, ya que abordan capas distintas de la infraestructura tecnológica.
¿Qué equipos participan en una implementación DataOps?
Una implementación DataOps involucra a ingenieros de datos, analistas, científicos de datos, DataOps engineers y representantes de las áreas de negocio que consumen los datos. También pueden participar equipos de gobernanza y cumplimiento, especialmente en organizaciones con requisitos regulatorios estrictos. La clave es que todos compartan un marco de trabajo común, con visibilidad sobre el estado del dato y responsabilidades claramente definidas en cada etapa del proceso.
¿DataOps y MLOps son lo mismo?
No son lo mismo, aunque están relacionados. DataOps se centra en el ciclo de vida completo de los datos dentro de una organización: su ingesta, transformación, calidad y entrega. MLOps, por su parte, se enfoca específicamente en el ciclo de vida de los modelos de machine learning: entrenamiento, validación, despliegue y monitoreo en producción. DataOps es una base sobre la que MLOps puede operar: sin datos de calidad y pipelines confiables, los modelos de ML tampoco funcionarán correctamente.
¿Qué herramientas se usan en DataOps?
El ecosistema de herramientas DataOps es amplio. Para orquestación de pipelines se usan principalmente Apache Airflow, Prefect y Dagster. Para transformación, dbt es la opción más extendida. La calidad del dato se gestiona con herramientas como Great Expectations o Soda. Para observabilidad y monitoreo existen soluciones como Monte Carlo o DataHub. La elección depende del volumen de datos, la infraestructura existente y las necesidades específicas del equipo.
¿Es DataOps solo para grandes empresas?
No. Aunque los casos más visibles de DataOps suelen venir de empresas con grandes volúmenes de datos, sus principios son aplicables en equipos de cualquier tamaño. Un equipo pequeño puede beneficiarse de automatizar sus pipelines, versionar su código de transformación y definir controles de calidad básicos. La escala de implementación varía, pero la lógica de fondo —automatizar, colaborar y garantizar calidad— tiene valor independientemente del tamaño de la organización.
¿Qué relación tiene DataOps con la calidad del dato?
La calidad del dato es uno de los pilares más importantes de DataOps. A diferencia de los enfoques tradicionales donde la calidad se verificaba al final del proceso, DataOps integra controles automáticos en cada etapa del pipeline. Esto significa que si un dato llega incompleto, con un formato incorrecto o fuera del rango esperado, el sistema lo detecta antes de que ese error se propague. El resultado es información más confiable, menos tiempo invertido en correcciones manuales y mayor confianza de los equipos en los datos que consumen.
Conclusión
DataOps no es una herramienta que instalas ni una tecnología que compras. Es una forma de organizar el trabajo alrededor del dato: con procesos automatizados, equipos que colaboran de verdad y controles de calidad que actúan antes de que los problemas lleguen a producción. Su valor real está en cambiar la manera en que un equipo piensa sobre los datos, no solo en las herramientas que elige para gestionarlos.
Si aplicas los principios que has visto aquí —automatización del ciclo de vida del dato, colaboración sin silos y validación continua—, tu equipo puede pasar de un modelo reactivo, donde los problemas se descubren tarde, a uno proactivo, donde los datos llegan a tiempo, con calidad verificada y con trazabilidad completa. El punto de partida no tiene que ser perfecto: una iteración pequeña bien ejecutada ya genera valor.
Si este tema te genera más preguntas, en este sitio web encontrarás más contenido sobre ingeniería de datos, pipelines, arquitecturas modernas y todo lo que rodea al mundo de los datos. Cada artículo está pensado para que puedas avanzar a tu ritmo, desde los conceptos más básicos hasta los más avanzados.
Sigue aprendiendo:
Proyectos de ingeniería de datos para portafolio
Change Data Capture (CDC): El secreto detrás de los datos en vivo
¿Qué hace un ingeniero de datos?
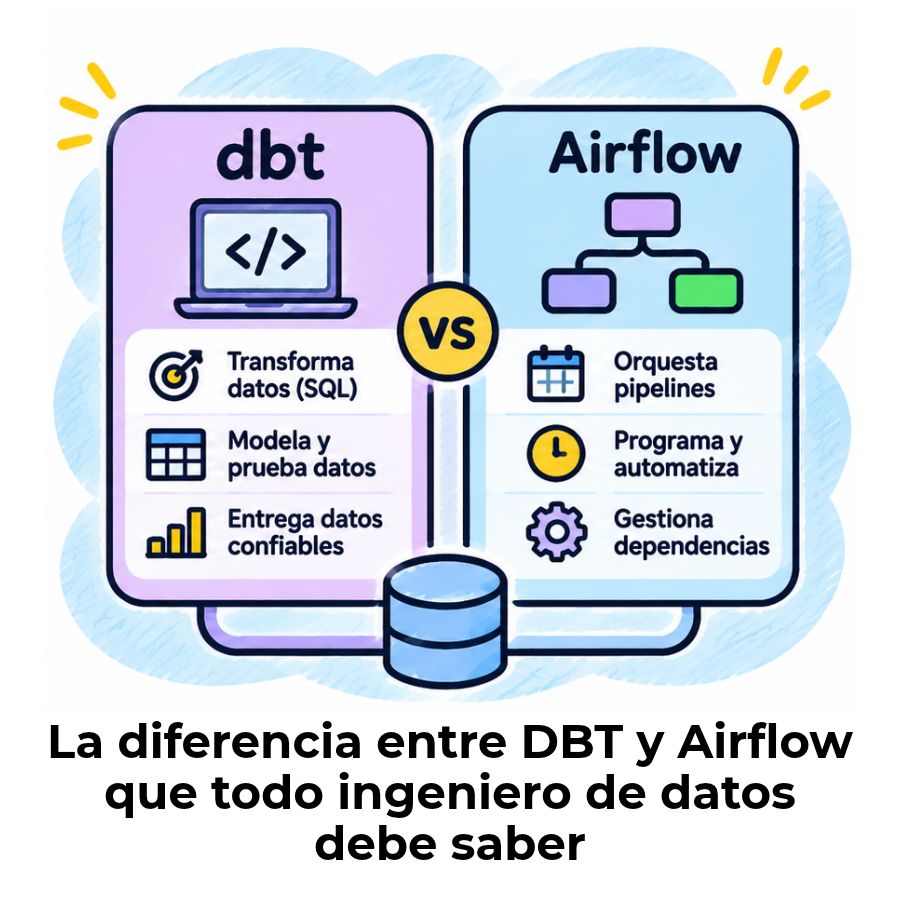
Diferencia entre DBT y Airflow
Cómo ser ingeniero de datos desde cero
Calidad de datos: El secreto que separa buenos de malos análisis
Gobierno de datos: Controla tu información y toma mejores decisiones 📊
Particionamiento de datos: El secreto detrás de las bases rápidas
