
Cada vez que rechazas una transacción sospechosa en segundos, o que ves actualizarse un marcador deportivo sin recargar la página, hay un sistema que tomó una decisión mientras los datos aún estaban en movimiento. Eso es exactamente lo que hace el procesamiento de datos en tiempo real: actuar antes de que el momento pase.
¿Qué es el procesamiento de datos en tiempo real?
El procesamiento de datos en tiempo real es la capacidad de un sistema para capturar, transformar y analizar información en el instante en que se genera, con una latencia que va de milisegundos a pocos segundos. A diferencia de los enfoques tradicionales que acumulan datos para analizarlos después, aquí cada evento se trata de forma individual, justo cuando entra al sistema.
El concepto central es que los datos nunca están quietos: fluyen de forma continua desde sensores, aplicaciones, transacciones y dispositivos. Procesar esos datos mientras se mueven, antes de que se almacenen o descarten, es precisamente lo que distingue a un sistema en tiempo real de cualquier otro enfoque convencional.
«El procesamiento en tiempo real se refiere a la capacidad de un sistema para procesar datos y proporcionar resultados casi instantáneamente después de que los datos son recibidos.»
Diferencia entre dato en movimiento y dato en reposo
Un dato en reposo es información que ya fue almacenada en una base de datos, un archivo o un data warehouse, lista para consultarse cuando alguien lo necesite. Un dato en movimiento, en cambio, es un evento que ocurre ahora mismo: un clic, una lectura de temperatura, una transferencia bancaria. El procesamiento en tiempo real trabaja precisamente sobre ese segundo tipo, antes de que el dato llegue a ningún almacén.
La distinción importa porque las estrategias, herramientas y arquitecturas que se aplican a cada caso son completamente distintas. No se puede usar la misma infraestructura para analizar el historial de ventas del último año que para detectar un fraude en los próximos tres segundos.
¿Cuándo se considera que un procesamiento es verdaderamente en tiempo real?
No existe una definición oficial con milisegundos exactos, pero en la práctica se habla de tiempo real cuando la latencia es suficientemente baja para que la respuesta del sistema sea útil antes de que el contexto del evento cambie. En detección de fraude, eso significa menos de un segundo. En un panel de analítica web, puede tolerarse un retraso de varios segundos sin que el valor de la información se pierda.
Lo que define el umbral no es un número fijo, sino el caso de uso. La pregunta clave es: ¿cuánto tiempo puede pasar antes de que esta información deje de ser accionable? Eso establece el límite de latencia que debe cumplir el sistema.
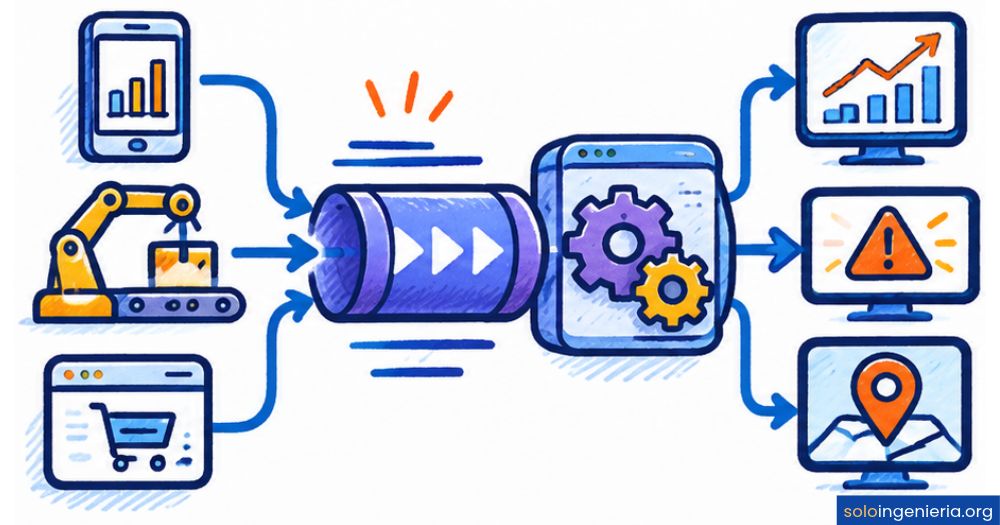
Cómo funciona el procesamiento en tiempo real paso a paso
Un sistema de procesamiento en tiempo real no es una sola pieza de software, sino una cadena de componentes que trabajan de forma coordinada. Cada eslabón tiene una función específica y, si alguno falla o se satura, toda la cadena se resiente. Entender qué hace cada capa es el primer paso para diseñar o evaluar este tipo de sistemas.
Ingesta
Los datos llegan desde múltiples fuentes simultáneas. El sistema los capta y los coloca en una cola durable para que no se pierdan aunque el procesador esté ocupado.
Transformación
El motor de stream processing filtra, enriquece y agrega los eventos. Puede combinar el flujo actual con datos de referencia o calcular métricas sobre ventanas de tiempo.
Almacenamiento
Los resultados procesados se escriben en un destino: una base de datos, un data warehouse, una caché o directamente en un panel de visualización en vivo.
Acción
El sistema responde: lanza una alerta, bloquea una operación, actualiza una recomendación o dispara un proceso automático, todo sin intervención humana.
Ingesta de datos: la entrada del flujo
La ingesta es el punto donde los datos externos entran al sistema. En un entorno de tiempo real, esta capa debe ser capaz de absorber picos de tráfico sin perder eventos ni generar cuellos de botella. Para eso se utilizan plataformas de mensajería distribuida que actúan como buffers entre los productores de datos y los procesadores.
La clave de esta etapa es la durabilidad: aunque el procesador esté ocupado o reiniciándose, los eventos no se pierden porque permanecen en la cola hasta que son consumidos. Esto garantiza que ninguna transacción, lectura de sensor o evento de usuario quede sin procesar, incluso ante fallos temporales del sistema.
Transformación y enriquecimiento del flujo
Una vez que los datos están en el sistema, el motor de procesamiento los trabaja al vuelo. Filtrar ruido, unir el evento actual con información de referencia o calcular un promedio sobre los últimos treinta segundos son operaciones típicas de esta etapa. Todo ocurre sobre datos que siguen moviéndose, sin detener el flujo.
Un concepto central aquí es el de ventana de tiempo: el sistema agrupa eventos en intervalos fijos o deslizantes para calcular métricas. Por ejemplo, el número de intentos de inicio de sesión fallidos en los últimos diez minutos, actualizado cada segundo. Esas ventanas permiten detectar patrones que no serían visibles analizando eventos de forma aislada.
Almacenamiento y servicio de resultados
El resultado del procesamiento necesita ir a algún lugar desde donde sea consultable o accionable. Las opciones varían según el caso de uso: una base de datos de baja latencia para servir respuestas rápidas, un data warehouse para análisis histórico posterior o una caché en memoria para alimentar paneles en tiempo real sin sobrecargar la base de datos principal.
Elegir el destino correcto tiene tanto peso como elegir la herramienta de procesamiento. Un motor excelente que escribe en un almacén lento puede arruinar toda la promesa de baja latencia. El rendimiento del sistema completo lo determina su eslabón más lento, no el más rápido.
Arquitecturas para el procesamiento en tiempo real
Elegir la arquitectura correcta es una de las decisiones más importantes al diseñar un sistema de procesamiento en tiempo real. No todas las organizaciones tienen los mismos requisitos de latencia, escala o tolerancia a errores, y cada patrón arquitectónico resuelve un conjunto diferente de compromisos. Conocer las tres grandes opciones ayuda a tomar esa decisión con claridad.
Comparativa de arquitecturas de procesamiento en tiempo real
| Arquitectura | Cómo funciona | Ventaja principal | Desafío |
|---|---|---|---|
| Lambda | Capa batch + capa streaming en paralelo, resultados combinados | Alta tolerancia a fallos y exactitud | Lógica duplicada, mayor mantenimiento |
| Kappa | Un solo motor de streaming para todo, incluyendo reprocesamiento | Simplicidad operativa, menos código | Reprocesar históricos puede ser costoso |
| Micro-lotes | Procesa pequeños grupos de eventos a intervalos muy cortos | Balance entre latencia y fiabilidad | No es tiempo real puro, hay latencia mínima |
Arquitectura Lambda: batch y streaming en paralelo
La arquitectura Lambda divide el procesamiento en dos capas que trabajan en simultáneo: una capa batch que procesa el histórico completo con alta precisión y una capa de velocidad que atiende los datos que llegan en este momento con baja latencia. Los resultados de ambas capas se combinan antes de servirlos al usuario final.
Su mayor debilidad es operativa: la misma lógica de negocio debe implementarse dos veces, una para cada capa. Eso duplica el esfuerzo de desarrollo y hace más difícil mantener la consistencia entre ambos caminos cuando el modelo de datos cambia. Aun así, sigue siendo una opción válida cuando la exactitud absoluta no puede negociarse.
Arquitectura Kappa: un solo motor de procesamiento
La arquitectura Kappa simplifica el modelo eliminando la capa batch por completo. Todo, tanto el streaming actual como el reprocesamiento de datos históricos, pasa por el mismo motor de streaming. Cuando hay que corregir un error o aplicar una nueva lógica al histórico, se relanza el flujo desde el origen del log de eventos.
El resultado es un sistema más fácil de mantener y evolucionar, con un solo codebase y una sola infraestructura que aprender. La contrapartida es que el reprocesamiento masivo de históricos puede ser costoso en recursos y tiempo, especialmente cuando el volumen de datos acumulados es muy alto.
Arquitectura de micro-lotes: el punto intermedio
En lugar de procesar cada evento de forma individual, la arquitectura de micro-lotes agrupa los eventos que llegan en un intervalo muy corto (típicamente entre cien milisegundos y unos pocos segundos) y los procesa juntos. El resultado se parece al tiempo real desde la perspectiva del usuario, aunque técnicamente haya un pequeño retraso. Apache Spark Streaming es el representante más conocido de este enfoque.
Este modelo ofrece una ventaja práctica importante: las garantías de exactitud y tolerancia a fallos propias del procesamiento batch se mantienen, pero con una latencia mucho menor. Es una opción especialmente atractiva para equipos que ya conocen el ecosistema batch y quieren introducirse en el streaming sin asumir toda la complejidad de un sistema de eventos puros.
Herramientas principales para procesar datos en tiempo real
El ecosistema de herramientas para el procesamiento en tiempo real ha madurado de forma notable en los últimos años. Hoy existen opciones para cada capa de la arquitectura, desde la ingesta hasta el almacenamiento de resultados. Las más adoptadas comparten tres características: tolerancia a fallos, escalabilidad horizontal y latencia predecible.
Apache Kafka: la columna vertebral del streaming
Apache Kafka es una plataforma de streaming distribuida que actúa como sistema nervioso central entre los productores de datos y los consumidores. Su diseño basado en un log de eventos inmutable permite que múltiples aplicaciones lean el mismo flujo de datos de forma independiente, sin que el consumo de uno afecte al de otro.
Kafka no procesa los datos, los transporta y los retiene durante un tiempo configurable. Esa separación entre transporte y procesamiento es lo que lo hace tan versátil: puede actuar como capa de ingesta para Flink, como origen de datos para Spark Streaming o como bus de eventos entre microservicios. Su capacidad de manejar millones de eventos por segundo lo ha convertido en el estándar de facto para pipelines de alta velocidad.
Apache Flink: procesamiento con baja latencia
Apache Flink es un motor de procesamiento de flujos que trabaja evento a evento, sin agruparlos en micro-lotes. Esa arquitectura le permite alcanzar latencias de milisegundos con garantías de exactitud, lo que lo convierte en la opción preferida para casos de uso donde cada milisegundo cuenta, como la detección de fraude o el trading algorítmico.
Una de sus capacidades más valoradas es el manejo del tiempo de evento frente al tiempo de procesamiento. Esto significa que Flink puede manejar correctamente eventos que llegan tarde o fuera de orden, algo habitual en sistemas distribuidos donde la red introduce retrasos variables. Esa robustez lo diferencia de alternativas más simples.
Apache Spark Streaming y Amazon Kinesis
Apache Spark Structured Streaming extiende el motor batch de Spark al modelo de micro-lotes, lo que permite reutilizar el mismo código para datos históricos y datos en movimiento. Su integración con el ecosistema Spark, que incluye SQL, machine learning y grafos, lo convierte en una opción muy atractiva para equipos que ya trabajan con Spark y quieren agregar capacidades de streaming sin aprender un nuevo sistema.
Amazon Kinesis, por su parte, es el servicio gestionado de AWS equivalente a Kafka. Elimina la necesidad de administrar infraestructura propia y se integra de forma nativa con el resto de servicios de la nube de Amazon. Es especialmente útil para organizaciones que ya están en el ecosistema AWS y quieren poner en marcha pipelines de streaming sin asumir la carga operativa de un clúster Kafka propio.
¿Cuándo conviene usar procesamiento en tiempo real?
No todo problema de datos requiere tiempo real. Adoptar este enfoque conlleva mayor complejidad, coste de infraestructura y exigencia operativa. Tiene sentido invertir en él cuando la demora en procesar un dato hace que ese dato pierda valor o genere un perjuicio concreto. Si el análisis de ayer sirve igual que el de ahora mismo, el procesamiento batch puede ser una opción más económica y fácil de mantener.
Casos de uso más comunes por industria
El procesamiento en tiempo real tiene aplicaciones directas en sectores donde la velocidad de respuesta es parte del servicio mismo. A continuación se muestran los casos más representativos agrupados por industria:
🏦 Servicios financieros
Detección de fraude en transacciones, alertas de riesgo en trading, actualización de balances y scoring crediticio dinámico.
🛒 Comercio electrónico
Recomendaciones personalizadas mientras el usuario navega, gestión de inventario en tiempo real y precios dinámicos.
🏭 Industria e IoT
Monitorización de maquinaria, mantenimiento predictivo, control de calidad en líneas de producción y logística con GPS.
🏥 Salud
Monitorización de constantes vitales, alertas en UCI, análisis de datos de dispositivos implantados y triaje inteligente.
📊 Analítica web y apps
Dashboards de sesiones activas, seguimiento de campañas en tiempo real, A/B testing con resultados al instante y detección de anomalías.
Procesamiento en tiempo real frente a procesamiento por lotes
El procesamiento por lotes acumula datos durante un periodo determinado y los analiza todos juntos en un momento posterior: cada noche, cada hora o cada semana. Es un modelo muy eficiente para grandes volúmenes de datos cuando la inmediatez no es un requisito. El tiempo real, en cambio, actúa sobre cada evento en el instante en que llega, lo que implica una infraestructura más compleja, pero resultados mucho más frescos.
Elegir entre uno y otro no siempre es una decisión binaria. Muchas organizaciones combinan ambos enfoques: usan streaming para las alertas y las decisiones urgentes, y procesamiento batch para los informes de negocio y los modelos de machine learning que requieren datos históricos completos. La arquitectura Lambda es precisamente la formalización de ese modelo híbrido. Puedes profundizar en cómo se orquestan estos flujos dentro de una ingeniería de datos bien estructurada.
Desafíos del procesamiento en tiempo real
Construir un sistema de procesamiento en tiempo real que funcione de forma fiable a escala no es trivial. Más allá de elegir las herramientas correctas, hay desafíos arquitectónicos y operativos que deben anticiparse desde el diseño. Ignorarlos suele traducirse en fallos costosos o en sistemas que prometen tiempo real, pero no lo cumplen bajo carga real.
Gestionar correctamente el DataOps del sistema, que incluye el versionado de pipelines, las pruebas de los flujos de datos y la monitorización continua, es parte indispensable de mantener un entorno de streaming saludable a lo largo del tiempo.
- Latencia vs. exactitud: Reducir la latencia a veces implica sacrificar garantías de procesamiento exacto. Encontrar el equilibrio correcto para cada caso de uso es una decisión de diseño que no tiene respuesta universal.
- Eventos fuera de orden: En sistemas distribuidos, los eventos no siempre llegan en el orden en que ocurrieron. El motor de procesamiento debe ser capaz de gestionar ese desorden sin producir resultados incorrectos.
- Gestión del estado: Muchas operaciones útiles requieren mantener información sobre eventos pasados, lo que genera un estado que debe almacenarse, replicarse y recuperarse ante fallos sin perder consistencia.
- Escalabilidad dinámica: El volumen de datos puede variar drásticamente en momentos de pico. El sistema debe escalar hacia arriba y hacia abajo de forma automática sin perder eventos ni introducir retrasos imprevistos.
- Monitorización y observabilidad: Detectar que un pipeline está degradado o procesando con retraso requiere instrumentación específica. Sin visibilidad en tiempo real sobre el propio sistema, los problemas se descubren tarde.
- Calidad del dato en el origen: Los errores en los datos de entrada se propagan a la velocidad del flujo. A diferencia del batch, donde se puede corregir antes de procesar, en tiempo real el dato corrupto ya tomó decisiones antes de que lo detectes.
Mantener un catálogo de datos actualizado es especialmente valioso en entornos de streaming: permite documentar qué flujos existen, qué esquema tiene cada uno y quién los consume, lo que reduce errores de integración y facilita la detección temprana de cambios en la calidad del dato.
Preguntas frecuentes
¿Qué es el procesamiento de datos en tiempo real con un ejemplo sencillo?
El procesamiento de datos en tiempo real es la capacidad de un sistema para analizar y actuar sobre cada dato en el instante en que lo recibe, con una demora de milisegundos a pocos segundos. Un ejemplo cotidiano es el sistema antifraude de un banco: cuando realizas una transferencia, el sistema analiza ese evento al momento, lo compara con tu historial de comportamiento y decide si aprobarlo o bloquearlo antes de que la operación se complete, todo en menos de un segundo.
¿Cuál es la diferencia entre streaming y procesamiento en tiempo real?
El streaming se refiere al canal por el que viajan los datos de forma continua, sin que haya un corte ni una acumulación. El procesamiento en tiempo real es la exigencia de latencia sobre ese flujo: que la respuesta llegue casi de forma inmediata. Se puede tener streaming sin tiempo real si los datos se procesan en micro-lotes con demoras tolerables. El streaming es el medio; el tiempo real es el requisito de velocidad que ese medio debe cumplir. Muchos sistemas combinan ambos conceptos, pero son dimensiones distintas de una misma arquitectura.
¿Qué herramientas se usan para el procesamiento de datos en tiempo real?
Las herramientas más utilizadas se agrupan por capa: para la ingesta y el transporte de eventos destacan Apache Kafka, Amazon Kinesis y Google Pub/Sub. Para el procesamiento propiamente dicho, Apache Flink es la opción preferida cuando se requiere baja latencia evento a evento, mientras que Apache Spark Structured Streaming se usa cuando el equipo ya trabaja con el ecosistema Spark. Para la visualización de resultados en tiempo real se emplean herramientas como Grafana o Apache Superset conectadas a bases de datos de baja latencia.
¿Qué es la latencia en el procesamiento de datos en tiempo real?
La latencia es el tiempo que transcurre desde que un evento ocurre hasta que el sistema produce una respuesta basada en ese evento. En el procesamiento en tiempo real, la latencia es el indicador clave de rendimiento: si es demasiado alta, el sistema deja de ser útil para los casos de uso que lo justifican. Los sistemas de alta exigencia, como la detección de fraude, buscan latencias por debajo de un segundo. Otros casos, como los paneles de analítica web, pueden tolerar varios segundos sin que el valor de la información se degrade de forma significativa.
¿Cómo se relaciona el procesamiento en tiempo real con la ingeniería de datos?
El procesamiento en tiempo real es una de las disciplinas centrales dentro de la ingeniería de datos. Los ingenieros de datos son quienes diseñan, construyen y mantienen los pipelines de streaming, eligen las herramientas, definen las arquitecturas y garantizan que los flujos sean fiables, escalables y observables. En un equipo de datos moderno, la capacidad de trabajar con datos en movimiento es tan importante como saber construir pipelines batch o diseñar modelos de almacenamiento eficientes.
¿Qué es la arquitectura Lambda en el procesamiento en tiempo real?
La arquitectura Lambda es un patrón de diseño que combina dos capas de procesamiento en paralelo: una capa batch que trabaja sobre el histórico completo de datos con alta exactitud y una capa de velocidad que procesa los datos que llegan en tiempo real con baja latencia. Los resultados de ambas capas se fusionan antes de servirlos al usuario final. Su principal ventaja es la tolerancia a fallos y la exactitud; su mayor coste es la duplicación de lógica, ya que el mismo cálculo debe implementarse dos veces en dos sistemas diferentes.
¿Qué ventajas tiene el procesamiento en tiempo real frente al procesamiento por lotes?
La ventaja principal es la inmediatez: las decisiones y alertas se basan en lo que está ocurriendo ahora, no en lo que ocurrió hace horas. Eso se traduce en detección temprana de problemas, mejores experiencias de usuario y capacidad de reaccionar antes de que el daño se produzca. El procesamiento en tiempo real también permite construir productos que serían imposibles con batch, como recomendaciones personalizadas al instante o paneles operativos con datos frescos. La contrapartida es una mayor complejidad técnica y un coste de infraestructura más elevado que debe justificarse con el valor que aporta esa inmediatez.
Conclusión
El procesamiento de datos en tiempo real transforma la forma en que los sistemas reaccionan al mundo: en lugar de analizar lo que ya pasó, actúan sobre lo que está ocurriendo ahora mismo. Esa capacidad, que antes era exclusiva de grandes empresas con recursos tecnológicos extraordinarios, hoy está al alcance de cualquier equipo que entienda bien sus fundamentos y elija las herramientas adecuadas.
Ahora tienes una visión clara de cómo funciona este enfoque por dentro: desde la ingesta de eventos hasta la respuesta del sistema, pasando por las tres grandes arquitecturas y las herramientas que las hacen posibles. El siguiente paso natural es identificar en tu propio contexto qué casos de uso realmente necesitan esa inmediatez y cuáles pueden resolverse de forma más simple con procesamiento batch, ahorrando complejidad sin perder valor.
Si este tema te ha abierto preguntas sobre cómo se organiza y gestiona el dato desde su origen hasta su consumo, en este sitio web encontrarás más contenido sobre ingeniería de datos que te ayudará a seguir construyendo esa comprensión de forma progresiva y sólida.
Sigue aprendiendo:
¿Qué hace un data steward y cuál es su rol?
Arquitectura de datos: El secreto que mueve los datos de tu empresa
Ingeniería en Análisis / Ciencia de Datos
Gobierno de datos: Controla tu información y toma mejores decisiones 📊
Stack de datos moderno: La revolución silenciosa del análisis
Azure Data Factory (ADF): El servicio que mueve tus datos en la nube ☁️
Ingeniero de datos vs. Científico de datos
¿Qué lenguaje aprender para ser ingeniero de datos?
