100 preguntas de entrevista para ingeniero de datos
Estás a punto de entrar a una sala (o a una videollamada) donde alguien va a evaluar todo lo que sabes sobre datos, pipelines y arquitectura. Los nervios son normales, pero llegar sin haber repasado las preguntas más comunes no es una opción. Aquí encontrarás 100 preguntas reales organizadas por tema, cada una con la respuesta que deberías dar.
¿Qué esperar en una entrevista para ingeniero de datos?
Cuando te presentas a una entrevista para ingeniero de datos, el proceso suele combinar preguntas teóricas con ejercicios prácticos. Los entrevistadores buscan evaluar tu comprensión de bases de datos, tu capacidad para diseñar pipelines y tu dominio de herramientas como SQL, Python y plataformas en la nube. No se trata solo de recitar definiciones, sino de demostrar que puedes resolver problemas reales con criterio técnico.
Las entrevistas varían según el nivel del puesto y la empresa, pero los temas centrales se mantienen bastante estables. Desde consultas SQL hasta decisiones de arquitectura, pasando por calidad de datos y orquestación de flujos, las 100 preguntas que encontrarás aquí cubren las áreas que más aparecen en procesos de selección reales. Si estás dando tus primeros pasos, te recomendamos revisar primero cómo ser Ingeniero de Datos desde cero para tener una base sólida antes de practicar.
Preguntas sobre fundamentos de bases de datos
Las bases de datos son el pilar de cualquier sistema de datos, por lo que los entrevistadores dedican buena parte de la conversación a evaluar tu comprensión de sus fundamentos. Necesitas distinguir con claridad entre modelos relacionales y no relacionales, entender cuándo conviene cada uno y conocer los principios que garantizan la integridad de la información. Estas preguntas suelen aparecer al inicio de la entrevista para validar tu base teórica.
Bases de datos relacionales
#
Pregunta
Respuesta sugerida
1
¿Qué es una base de datos relacional?
Es un sistema que organiza los datos en tablas con filas y columnas, donde las relaciones entre tablas se establecen mediante claves primarias y foráneas. Ejemplos: PostgreSQL, MySQL, SQL Server.
2
¿Qué es la normalización y por qué se usa?
Es el proceso de organizar las tablas para reducir la redundancia de datos y evitar anomalías de inserción, actualización y eliminación. Se aplica siguiendo formas normales (1NF, 2NF, 3NF, entre otras).
3
¿Cuál es la diferencia entre clave primaria y clave foránea?
La clave primaria identifica de forma única cada registro en una tabla. La clave foránea es un campo que referencia la clave primaria de otra tabla para establecer una relación entre ambas.
4
¿Qué son las propiedades ACID?
Atomicidad, Consistencia, Aislamiento y Durabilidad. Garantizan que las transacciones en una base de datos se ejecuten de forma fiable, incluso si ocurre un fallo del sistema.
5
¿Qué es un índice en una base de datos?
Es una estructura de datos que acelera las consultas al crear un acceso directo a las filas. Mejora la velocidad de lectura, pero puede ralentizar las escrituras porque el índice debe actualizarse con cada cambio.
6
¿Qué diferencia hay entre un índice clustered y uno non-clustered?
El clustered ordena físicamente los datos en disco según el índice (solo uno por tabla). El non-clustered crea una estructura separada con punteros a las filas, y puedes tener varios en una misma tabla.
7
¿Qué es la desnormalización y cuándo se aplica?
Consiste en introducir redundancia controlada para mejorar el rendimiento de lectura. Se usa en sistemas analíticos o data warehouses donde las consultas de lectura son mucho más frecuentes que las escrituras.
8
¿Qué es una vista y para qué sirve?
Es una consulta almacenada que se comporta como una tabla virtual. Sirve para simplificar consultas complejas, restringir el acceso a ciertos datos y reutilizar lógica de negocio sin duplicar código.
Bases de datos NoSQL
#
Pregunta
Respuesta sugerida
9
¿Qué es una base de datos NoSQL?
Es un tipo de base de datos que no utiliza el modelo relacional tradicional. Incluye modelos de documentos, clave-valor, columnar y grafos. Se diseñó para manejar grandes volúmenes de datos con esquemas flexibles.
10
¿Cuándo elegirías una base NoSQL sobre una relacional?
Cuando necesitas escalar horizontalmente, los datos no tienen un esquema fijo, el volumen es muy alto o la velocidad de escritura es prioritaria. Ejemplo: Logs de aplicaciones, catálogos de productos con atributos variables.
11
¿Qué es el teorema CAP?
Establece que un sistema distribuido solo puede garantizar dos de tres propiedades simultáneamente: Consistencia, Disponibilidad (Availability) y Tolerancia a particiones. Cada base de datos NoSQL prioriza diferentes combinaciones.
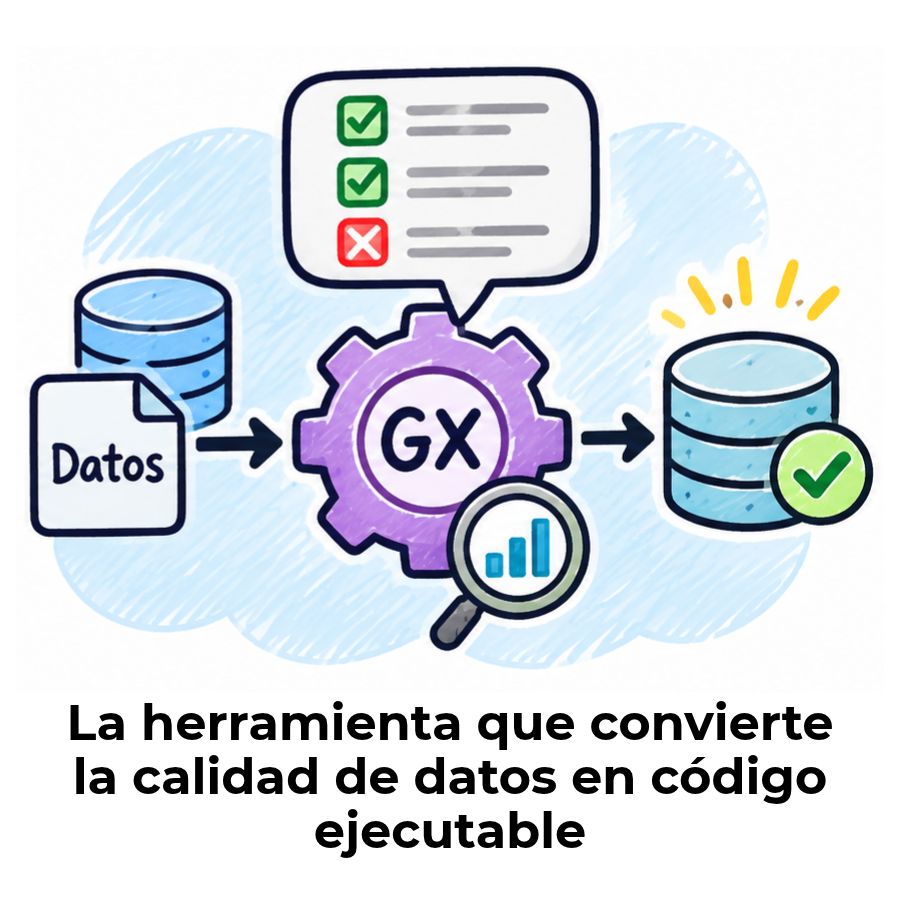
12
¿Qué diferencia hay entre una base de datos de documentos y una columnar?
La de documentos almacena datos como JSON o BSON (ejemplo: MongoDB) y es ideal para datos semiestructurados. La columnar organiza datos por columnas (ejemplo: Cassandra) y es eficiente para consultas analíticas sobre grandes volúmenes.
13
¿Qué es la consistencia eventual?
Es un modelo donde, tras una escritura, no todos los nodos reflejan el cambio inmediatamente, pero eventualmente todos convergen al mismo estado. Muchas bases NoSQL usan este modelo para priorizar disponibilidad y rendimiento.
Estos fundamentos forman la base sobre la que se construye todo lo demás. Si dominas las diferencias entre modelos relacionales y NoSQL, y entiendes cuándo aplicar cada uno, vas a transmitir confianza desde el primer momento de tu entrevista. Para profundizar en el campo completo, puedes explorar más sobre ingeniería de datos y sus diferentes ramas.
Preguntas sobre SQL y manipulación de datos
SQL es la herramienta que más van a evaluar en tu entrevista. Prácticamente todas las empresas esperan que puedas escribir consultas desde cero, optimizar su rendimiento y explicar tu razonamiento paso a paso. Las preguntas van desde lo básico hasta escenarios complejos con subconsultas, funciones de ventana y optimización de planes de ejecución. Dedica tiempo a practicar con datos reales.
Consultas básicas e intermedias
#
Pregunta
Respuesta sugerida
14
¿Cuál es la diferencia entre WHERE y HAVING?
WHERE filtra filas antes de la agrupación. HAVING filtra después de aplicar GROUP BY, por lo que puede usar funciones de agregación como COUNT o SUM.
15
¿Qué tipos de JOIN existen y cuándo usas cada uno?
INNER JOIN: Solo filas con coincidencia en ambas tablas. LEFT JOIN: Todas las del lado izquierdo más las coincidentes. RIGHT JOIN: Lo inverso. FULL OUTER JOIN: Todas las filas de ambas, con NULL donde no hay coincidencia. CROSS JOIN: Producto cartesiano.
16
¿Qué diferencia hay entre UNION y UNION ALL?
UNION combina resultados de dos consultas y elimina duplicados. UNION ALL los combina sin eliminar duplicados, por lo que es más rápido cuando sabes que no habrá filas repetidas.
17
¿Cómo funcionan GROUP BY y las funciones de agregación?
GROUP BY agrupa filas con valores iguales en las columnas especificadas. Las funciones de agregación (COUNT, SUM, AVG, MIN, MAX) se calculan sobre cada grupo. Toda columna en el SELECT que no tenga agregación debe estar en el GROUP BY.
18
¿Qué es una subconsulta y cuándo la usarías?
Es una consulta dentro de otra consulta. Se usa cuando necesitas filtrar basándote en un resultado intermedio, como obtener empleados cuyo salario supere el promedio de su departamento.
19
¿Qué diferencia hay entre DELETE, TRUNCATE y DROP?
DELETE elimina filas específicas (se puede filtrar con WHERE y se puede revertir). TRUNCATE elimina todas las filas rápidamente sin registrar cada fila borrada. DROP elimina la tabla completa, incluida su estructura.
20
¿Qué es un CTE (Common Table Expression)?
Es una expresión definida con WITH que crea un resultado temporal nombrado dentro de una consulta. Mejora la legibilidad frente a subconsultas anidadas y permite construir lógica paso a paso.
21
¿Cómo manejas valores NULL en SQL?
Usas IS NULL o IS NOT NULL para filtrar. COALESCE devuelve el primer valor no nulo de una lista. NULLIF devuelve NULL si dos expresiones son iguales. Los NULL no se cuentan en funciones como COUNT(columna).
Consultas avanzadas y optimización
#
Pregunta
Respuesta sugerida
22
¿Qué son las funciones de ventana (window functions)?
Son funciones que realizan cálculos sobre un conjunto de filas relacionadas con la fila actual, sin agruparlas. Se definen con OVER(). Ejemplos: ROW_NUMBER, RANK, DENSE_RANK, LAG, LEAD, SUM() OVER().
23
¿Cuál es la diferencia entre ROW_NUMBER, RANK y DENSE_RANK?
ROW_NUMBER asigna un número único secuencial. RANK asigna el mismo número a empates pero deja huecos en la secuencia. DENSE_RANK asigna el mismo número a empates sin dejar huecos.
24
¿Cómo leerías un plan de ejecución de una consulta?
Usas EXPLAIN o EXPLAIN ANALYZE. Buscas operaciones costosas como full table scans, nested loops sobre tablas grandes o sort en memoria. Los nodos con mayor costo relativo son los candidatos a optimizar primero.
25
¿Cómo optimizarías una consulta SQL lenta?
Revisas el plan de ejecución, agregas índices en las columnas de filtro y JOIN, evitas SELECT *, reduces subconsultas innecesarias, usas CTEs o tablas temporales y verificas que las estadísticas de las tablas estén actualizadas.
26
¿Qué es una tabla temporal y cuándo la usarías?
Es una tabla que existe solo durante la sesión o transacción actual. Se usa para almacenar resultados intermedios en procesos ETL complejos o para dividir consultas muy largas en pasos más manejables.
27
¿Qué es el particionamiento de tablas?
Divide una tabla grande en segmentos más pequeños (particiones) según un criterio, como fecha o región. Mejora el rendimiento porque las consultas solo escanean las particiones relevantes en lugar de toda la tabla.
28
¿Qué es un stored procedure y cuándo lo usarías?
Es un bloque de código SQL almacenado en la base de datos que se puede ejecutar como una función. Se usa para encapsular lógica de negocio repetitiva, mejorar la seguridad y reducir el tráfico entre la aplicación y la base de datos.
Preguntas sobre modelado de datos
El modelado de datos define cómo se organiza la información dentro de un sistema, y los entrevistadores lo evalúan para comprobar tu capacidad de pensar a largo plazo. Un buen modelo facilita las consultas, reduce errores y hace que el sistema escale sin problemas. Si puedes explicar con claridad las diferencias entre esquemas estrella, copo de nieve y cuándo aplicar cada uno, demuestras madurez técnica que va más allá de escribir código.
#
Pregunta
Respuesta sugerida
29
¿Qué es un esquema estrella (star schema)?
Es un modelo de datos donde una tabla de hechos central se conecta directamente a varias tablas de dimensiones. Es simple, fácil de entender y optimizado para consultas analíticas rápidas en data warehouses.
30
¿Qué diferencia hay entre esquema estrella y copo de nieve?
El copo de nieve normaliza las tablas de dimensiones, dividiéndolas en subtablas. Reduce la redundancia pero añade complejidad en los JOIN. El estrella es más simple y rápido para consultas, el copo de nieve ahorra espacio.
31
¿Qué es una tabla de hechos y una tabla de dimensiones?
La tabla de hechos almacena métricas cuantificables del negocio (ventas, clics, transacciones). Las tablas de dimensiones contienen los atributos descriptivos (producto, cliente, tiempo) que dan contexto a esos hechos.
32
¿Qué es una slowly changing dimension (SCD)?
Es una dimensión cuyos atributos cambian con el tiempo. El tipo 1 sobrescribe el valor anterior. El tipo 2 conserva el historial creando nuevas filas con fechas de vigencia. El tipo 3 agrega una columna para el valor anterior.
33
¿Qué diferencia hay entre OLTP y OLAP?
OLTP procesa transacciones operativas en tiempo real (inserciones, actualizaciones frecuentes). OLAP analiza grandes volúmenes de datos históricos para reportes y toma de decisiones. OLTP se normaliza; OLAP se desnormaliza.
34
¿Qué es un data vault y cuándo se usa?
Es una metodología de modelado que separa los datos en hubs (entidades clave), links (relaciones) y satellites (atributos descriptivos con historial). Se usa cuando necesitas máxima flexibilidad, auditoría y capacidad de integrar muchas fuentes.
35
¿Qué es una clave surrogada y por qué se usa?
Es una clave primaria artificial (generalmente un número autoincremental) que no tiene significado de negocio. Se usa para mantener la consistencia de las relaciones cuando las claves naturales pueden cambiar o no ser únicas entre fuentes.
36
¿Qué es un data mart?
Es un subconjunto del data warehouse enfocado en un área de negocio específica (ventas, finanzas, marketing). Ofrece consultas más rápidas y un modelo más sencillo para los usuarios de esa área.
Preguntas sobre ETL y pipelines de datos
Los procesos de extracción, transformación y carga (ETL) son el corazón del trabajo diario de un ingeniero de datos. En la entrevista van a evaluar si entiendes cómo mover datos entre sistemas de forma fiable, cómo manejar errores y cómo diseñar flujos que escalen cuando el volumen crece. Estas preguntas combinan teoría con casos prácticos, así que prepárate para justificar tus decisiones de diseño.
#
Pregunta
Respuesta sugerida
37
¿Qué es un proceso ETL?
Extract, Transform, Load. Se extraen datos de una o varias fuentes, se transforman (limpieza, validación, enriquecimiento) y se cargan en un destino como un data warehouse o un data lake.
38
¿Cuál es la diferencia entre ETL y ELT?
En ETL la transformación ocurre antes de la carga (en un servidor intermedio). En ELT los datos se cargan primero en bruto y se transforman dentro del destino, aprovechando su capacidad de cómputo. ELT es común en plataformas cloud como BigQuery o Snowflake.
39
¿Qué es un pipeline de datos?
Es una secuencia automatizada de pasos que mueve y transforma datos desde su origen hasta su destino. Puede incluir extracción, limpieza, validación, enriquecimiento, carga y notificaciones, todo orquestado para ejecutarse de forma programada o por eventos.
40
¿Cómo manejarías un fallo en medio de un pipeline?
Implementas reintentos con backoff exponencial, registras logs detallados, usas puntos de control (checkpoints) para retomar desde el último paso exitoso, configuras alertas automáticas y diseñas cada paso para que sea idempotente.
41
¿Qué es la idempotencia en un pipeline de datos?
Significa que ejecutar el mismo proceso varias veces produce el mismo resultado, sin duplicar ni corromper datos. Se logra usando estrategias como UPSERT, borrado-inserción o particionamiento por ventana de tiempo.
42
¿Qué diferencia hay entre procesamiento batch y streaming?
Batch procesa datos en bloques a intervalos programados (cada hora, cada día). Streaming procesa los datos en tiempo real o casi real a medida que llegan. Batch es más simple; streaming requiere herramientas como Kafka, Flink o Spark Streaming.
43
¿Qué es un data lake?
Es un repositorio centralizado que almacena datos en su formato original (estructurados, semiestructurados y no estructurados). Permite almacenar grandes volúmenes a bajo costo y aplicar transformaciones cuando se necesiten, no antes.
44
¿Qué diferencia hay entre un data lake y un data warehouse?
El data lake almacena datos en bruto y admite cualquier formato. El data warehouse almacena datos estructurados y ya procesados, optimizados para consultas analíticas. El lake es flexible; el warehouse es rápido para análisis.
45
¿Qué es un data lakehouse?
Combina la flexibilidad del data lake con las capacidades de gestión y rendimiento del data warehouse. Permite almacenar datos en bruto y aplicar esquemas, transacciones ACID y consultas SQL directamente sobre el lake. Ejemplos: Delta Lake, Apache Iceberg.
46
¿Qué es la carga incremental y cómo se diferencia de la carga completa?
La carga completa reemplaza todos los datos en cada ejecución. La incremental solo carga los registros nuevos o modificados desde la última ejecución, usando marcadores como timestamps o change data capture (CDC). Es más eficiente para tablas grandes.
47
¿Qué es change data capture (CDC)?
Es una técnica que detecta y captura los cambios realizados en una base de datos (inserciones, actualizaciones, eliminaciones) en tiempo real o casi real. Herramientas como Debezium leen el log de transacciones para identificar estos cambios sin impactar el rendimiento de la fuente.
48
¿Cómo garantizarías la calidad de los datos dentro de un pipeline?
Implementas validaciones en cada etapa: comprobaciones de esquema, reglas de negocio, detección de duplicados, control de valores nulos y umbrales de volumen. Herramientas como Great Expectations o dbt tests automatizan estas verificaciones.
Preguntas sobre herramientas y tecnologías del ecosistema
Conocer las herramientas del ecosistema es tan relevante como dominar los conceptos. Los entrevistadores quieren saber si has trabajado con tecnologías reales y si puedes comparar opciones para elegir la más adecuada según el contexto. No se espera que domines todas, pero sí que entiendas el propósito de cada una y en qué escenarios brilla cada herramienta frente a sus alternativas.
Apache Spark y procesamiento distribuido
#
Pregunta
Respuesta sugerida
49
¿Qué es Apache Spark y por qué se usa en ingeniería de datos?
Es un motor de procesamiento distribuido que permite analizar y transformar grandes volúmenes de datos en paralelo. Es rápido porque procesa en memoria, soporta batch y streaming, y tiene APIs en Python, Scala, Java y SQL.
50
¿Qué diferencia hay entre un RDD, un DataFrame y un Dataset en Spark?
RDD es la abstracción de bajo nivel, inmutable y distribuida. DataFrame añade un esquema tabular con optimizaciones del motor Catalyst. Dataset combina las ventajas de ambos con tipado seguro (disponible en Scala y Java). En PySpark se trabaja principalmente con DataFrames.
51
¿Qué son las transformaciones y acciones en Spark?
Las transformaciones (map, filter, groupBy) son operaciones lazy: definen qué hacer pero no se ejecutan hasta que se llama una acción. Las acciones (count, collect, write) disparan la ejecución real del plan.
52
¿Qué es la evaluación lazy en Spark?
Spark no ejecuta las transformaciones inmediatamente. Las acumula en un plan lógico (DAG) y las optimiza antes de ejecutarlas cuando se invoca una acción. Esto permite fusionar operaciones y reducir lecturas innecesarias de disco.
53
¿Qué es un shuffle en Spark y por qué es costoso?
Es la redistribución de datos entre nodos del clúster, necesaria en operaciones como groupBy o join. Es costoso porque implica serialización, escritura a disco y transferencia por red. Se debe minimizar optimizando particiones y evitando joins innecesarios.
54
¿Qué es Apache Kafka y cómo se usa con pipelines de datos?
Es una plataforma de streaming distribuida que permite publicar, suscribirse y almacenar flujos de eventos en tiempo real. Se usa como capa de ingestión entre fuentes de datos y sistemas de procesamiento como Spark Streaming o Flink.
55
¿Qué es Apache Hadoop y cómo se diferencia de Spark?
Hadoop es un ecosistema para almacenamiento distribuido (HDFS) y procesamiento (MapReduce). Spark surgió como alternativa más rápida porque procesa en memoria, mientras MapReduce escribe resultados intermedios en disco. Muchos entornos usan HDFS con Spark encima.
Herramientas de orquestación y cloud
#
Pregunta
Respuesta sugerida
56
¿Qué es Apache Airflow y para qué se usa?
Es una plataforma de orquestación que permite programar, monitorear y gestionar flujos de trabajo (DAGs) de datos. Define las dependencias entre tareas y se ejecutan de forma programada o por disparadores.
57
¿Qué es un DAG en Airflow?
Directed Acyclic Graph. Es la representación del flujo de trabajo como un grafo donde cada nodo es una tarea y las aristas definen el orden de ejecución. Acíclico significa que no hay dependencias circulares.
58
¿Qué es dbt y cómo encaja en un pipeline de datos?
dbt (data build tool) es una herramienta que permite transformar datos dentro del data warehouse usando SQL. Se enfoca en la capa T del ELT: defines modelos SQL versionados, con pruebas automáticas y documentación integrada.
59
¿Qué servicios de datos ofrece AWS para ingeniería de datos?
S3 para almacenamiento, Redshift como data warehouse, Glue para ETL serverless, Athena para consultas sobre S3, Kinesis para streaming, EMR para clústeres Spark/Hadoop y Lake Formation para gobernanza del data lake.
60
¿Qué servicios de datos ofrece Google Cloud?
BigQuery como data warehouse serverless, Cloud Storage para almacenamiento, Dataflow para procesamiento batch y streaming (basado en Apache Beam), Dataproc para Spark/Hadoop y Pub/Sub para mensajería en tiempo real.
61
¿Qué es Snowflake y qué lo diferencia de otros data warehouses?
Snowflake es un data warehouse en la nube con arquitectura de almacenamiento y cómputo separados. Escala independientemente cada capa, soporta datos semiestructurados nativamente y permite compartir datos entre organizaciones sin copiarlos.
62
¿Qué es un formato de archivo columnar y por qué se prefiere en big data?
Formatos como Parquet y ORC almacenan datos por columnas en lugar de por filas. Esto permite leer solo las columnas necesarias para una consulta, comprime mejor y reduce el I/O significativamente en consultas analíticas sobre grandes volúmenes.
Preguntas sobre arquitectura y diseño de sistemas
Las preguntas de diseño de sistemas suelen aparecer en entrevistas para puestos de nivel medio y senior, pero incluso si estás empezando, conviene que entiendas los principios básicos. El entrevistador quiere ver cómo piensas en grande: cómo escalarías un sistema, qué trade-offs evaluarías y cómo justificas tus decisiones técnicas. No buscan la respuesta perfecta, sino tu proceso de razonamiento.
#
Pregunta
Respuesta sugerida
63
¿Cómo diseñarías un pipeline de datos de principio a fin?
Primero identifico las fuentes y el destino. Defino el esquema de datos, elijo entre batch o streaming, selecciono las herramientas (ingestión, procesamiento, almacenamiento), implemento validaciones de calidad, orquesto con Airflow o similar y configuro monitoreo con alertas.
64
¿Qué es la escalabilidad horizontal y vertical?
La vertical añade más recursos a un solo servidor (más CPU, RAM). La horizontal añade más servidores al sistema. En big data se prefiere la horizontal porque permite crecer de forma elástica y distribuir la carga sin depender de una sola máquina.
65
¿Qué es la arquitectura Lambda?
Combina procesamiento batch y streaming en paralelo. La capa batch procesa datos históricos completos, la capa speed procesa datos en tiempo real y la capa serving unifica los resultados para consultas. Es robusta pero compleja de mantener.
66
¿Qué es la arquitectura Kappa?
Simplifica la Lambda usando solo la capa de streaming para todo el procesamiento. Los datos se ingestan como un flujo continuo y se reprocesan cuando es necesario leyendo el log desde el inicio. Es más sencilla pero requiere un sistema de streaming robusto como Kafka.
67
¿Qué es el acoplamiento débil (loose coupling) en un sistema de datos?
Significa que los componentes del sistema son independientes y se comunican a través de interfaces bien definidas (APIs, colas de mensajes). Si un componente cambia o falla, los demás no se ven afectados directamente. Facilita el mantenimiento y la escalabilidad.
68
¿Cómo manejarías datos duplicados en un sistema distribuido?
Uso claves únicas naturales o combinadas para deduplicación, operaciones UPSERT en la carga, ventanas de deduplicación en streaming y validaciones post-carga. La idempotencia del pipeline es clave para prevenir duplicados desde el diseño.
69
¿Qué es un esquema de datos y por qué es necesario gestionarlo?
Define la estructura, tipos de datos y relaciones de tu información. Gestionarlo (schema registry, versionado) evita que cambios en las fuentes rompan los pipelines. Herramientas como Confluent Schema Registry o AWS Glue Catalog ayudan a mantener la consistencia.
70
¿Qué es la arquitectura medallion (bronze, silver, gold)?
Organiza los datos en tres capas: Bronze (datos en bruto), Silver (datos limpiados y enriquecidos) y Gold (datos listos para consumo por analistas y dashboards). Cada capa añade calidad y estructura. Es común en data lakehouses con Delta Lake.
Preguntas sobre calidad de datos y gobernanza
La calidad y la gobernanza de datos son temas que han ganado protagonismo en las entrevistas durante los últimos años. Ya no basta con mover datos de un lugar a otro: las empresas quieren ingenieros que garanticen que esos datos sean correctos, completos, consistentes y accesibles solo para quienes deben verlos. Estas preguntas miden tu capacidad para pensar más allá de la ejecución técnica y considerar el impacto organizacional de tus decisiones.
#
Pregunta
Respuesta sugerida
71
¿Qué dimensiones definen la calidad de datos?
Precisión (los datos reflejan la realidad), completitud (sin campos vacíos innecesarios), consistencia (mismos valores entre sistemas), puntualidad (datos disponibles cuando se necesitan), unicidad (sin duplicados) y validez (cumplen las reglas de formato).
72
¿Qué es la gobernanza de datos?
Es el conjunto de políticas, procesos y estándares que aseguran que los datos se gestionen de forma segura, consistente y conforme a regulaciones. Incluye definición de roles, catálogo de datos, linaje, control de acceso y políticas de retención.
73
¿Qué es el linaje de datos (data lineage)?
Es el registro del recorrido completo de un dato: de dónde viene, qué transformaciones sufrió y dónde termina. Permite diagnosticar errores, cumplir con auditorías y entender el impacto de cambios en las fuentes.
74
¿Qué es un catálogo de datos?
Es un inventario organizado de todos los activos de datos de una organización, con metadatos como descripciones, propietarios, esquemas y clasificaciones. Herramientas como Apache Atlas, DataHub o Alation facilitan la búsqueda y el descubrimiento de datos.
75
¿Cómo manejarías datos sensibles o personales (PII)?
Aplico cifrado en tránsito y en reposo, enmascaramiento o anonimización de campos sensibles, control de acceso basado en roles, auditorías de uso y cumplimiento de regulaciones como GDPR o la ley de protección de datos aplicable en cada jurisdicción.
76
¿Qué es la observabilidad de datos?
Es la capacidad de monitorear la salud de tus datos en tiempo real: frescura (cuándo se actualizaron), volumen (cantidad esperada vs. real), distribución (valores dentro de rangos normales) y esquema (cambios inesperados). Herramientas como Monte Carlo o Elementary lo automatizan.
77
¿Qué es un contrato de datos (data contract)?
Es un acuerdo formal entre el productor y el consumidor de datos que especifica el esquema, la semántica, la frecuencia de actualización y los estándares de calidad. Si el productor cambia algo, debe comunicarlo y respetar la compatibilidad pactada.
78
¿Qué herramienta usarías para validar la calidad de datos automáticamente?
Great Expectations es una de las más populares: defines expectativas como reglas de validación (no nulos, rangos, unicidad) y las ejecutas como parte del pipeline. dbt tests ofrece validaciones integradas en el flujo de transformación. Soda Core es otra alternativa.
Preguntas sobre programación y scripting
Aunque SQL es el lenguaje principal, las entrevistas para ingeniero de datos también evalúan tus habilidades de programación general. Python es el lenguaje más demandado en este campo, y los entrevistadores esperan que puedas manipular datos, automatizar tareas y escribir código limpio y mantenible. Conocer conceptos básicos de control de versiones y buenas prácticas de desarrollo también suma puntos.
#
Pregunta
Respuesta sugerida
79
¿Por qué Python es el lenguaje más usado en ingeniería de datos?
Tiene una sintaxis clara, un ecosistema enorme de librerías para datos (Pandas, PySpark, SQLAlchemy), integración nativa con la mayoría de herramientas (Airflow, dbt, AWS SDK) y una comunidad muy activa. Es versátil para scripting, ETL y automatización.
80
¿Qué es Pandas y cuándo lo usarías?
Es una librería de Python para manipulación y análisis de datos tabulares. Se usa para limpiar, transformar y explorar datos que caben en memoria. Para volúmenes grandes que no caben en un solo servidor, se prefiere PySpark o Polars.
81
¿Cuál es la diferencia entre una lista y un diccionario en Python?
Una lista es una colección ordenada de elementos accesibles por índice numérico. Un diccionario almacena pares clave-valor y permite acceso rápido por clave. Los diccionarios son ideales para búsquedas rápidas; las listas para secuencias ordenadas.
82
¿Qué es una list comprehension en Python?
Es una forma compacta de crear listas en una sola línea, aplicando una expresión a cada elemento de un iterable, con opción de filtro. Ejemplo: [x*2 for x in range(10) if x > 3]. Es más legible y eficiente que un bucle for equivalente.
83
¿Qué son los decoradores en Python?
Son funciones que envuelven a otra función para añadir funcionalidad sin modificar su código. Se aplican con @nombre_decorador. Son comunes en frameworks como Flask y en Airflow (para definir tareas).
84
¿Qué es Git y por qué es necesario en ingeniería de datos?
Es un sistema de control de versiones que permite rastrear cambios en el código, colaborar con otros desarrolladores y revertir errores. En ingeniería de datos, se usa para versionar scripts ETL, modelos dbt, configuraciones de Airflow y documentación.
85
¿Qué es Docker y cómo se usa en proyectos de datos?
Docker permite empaquetar una aplicación con todas sus dependencias en un contenedor reproducible. En datos se usa para ejecutar Airflow localmente, probar pipelines en entornos aislados y garantizar que el código funcione igual en desarrollo y producción.
86
¿Qué es una API REST y cómo la consumirías con Python?
Es una interfaz que permite acceder a datos o servicios mediante peticiones HTTP (GET, POST, PUT, DELETE). En Python usas la librería requests para hacer llamadas, manejar autenticación con tokens y procesar las respuestas JSON.
87
¿Qué son las pruebas unitarias y por qué importan en pipelines de datos?
Son pruebas que verifican el comportamiento de funciones individuales de forma aislada. En pipelines aseguran que las transformaciones produzcan los resultados esperados antes de desplegar cambios. Se escriben con frameworks como pytest.
88
¿Qué es CI/CD y cómo se aplica en ingeniería de datos?
Integración continua (CI) y despliegue continuo (CD). Automatizan las pruebas, validaciones y la puesta en producción del código. En datos, se usa para que los cambios en modelos dbt, DAGs de Airflow o scripts ETL se validen y desplieguen automáticamente.
Consejos para preparar tu entrevista con éxito
Conocer las respuestas es solo una parte de la preparación. La forma en que comunicas tus ideas, cómo estructuras tu razonamiento y la confianza que transmites pesan tanto como el conocimiento técnico. Estos consejos te ayudan a maximizar tu rendimiento el día de la entrevista y a diferenciarte de otros candidatos que tienen un perfil técnico similar al tuyo.
Si quieres reforzar tu perfil con credenciales reconocidas por la industria, te recomendamos revisar las certificaciones para ingeniero de datos más valoradas. Una certificación en AWS, Google Cloud o Azure no solo valida tus conocimientos, sino que te da temas concretos de conversación durante la entrevista que demuestran tu compromiso con el aprendizaje continuo.
#
Pregunta
Respuesta sugerida
89
¿Cómo te mantienes actualizado en ingeniería de datos?
Leo blogs técnicos como el de Netflix, Uber y Airbnb, sigo comunidades en Reddit y LinkedIn, tomo cursos en plataformas como Coursera o DataCamp, y practico con proyectos personales donde pruebo herramientas nuevas.
90
Describe un proyecto de datos desafiante que hayas resuelto.
Estructura tu respuesta con el método STAR: Situación (contexto), Tarea (tu responsabilidad), Acción (qué hiciste técnicamente) y Resultado (impacto medible). Sé específico con las herramientas y decisiones, y menciona qué aprendiste.
91
¿Cómo priorizarías múltiples solicitudes de datos de diferentes equipos?
Evalúo el impacto de negocio de cada solicitud, la urgencia real, el esfuerzo técnico requerido y las dependencias. Comunico los plazos con transparencia, negocio prioridades con los stakeholders y documento las decisiones tomadas.
92
¿Qué harías si descubres un error en datos que ya se publicaron en producción?
Primero cuantifico el alcance del error. Notifico a los equipos afectados inmediatamente. Corrijo la fuente del problema, reproceso los datos afectados, valido que la corrección sea correcta y documento el incidente con una post-mortem para evitar que vuelva a ocurrir.
93
¿Cómo explicarías un concepto técnico complejo a un equipo no técnico?
Uso analogías del mundo real, evito jerga técnica, me centro en el impacto para el negocio y utilizo diagramas simples. Verifico que me hayan entendido haciendo preguntas de seguimiento y ajusto mi explicación según las reacciones.
Las últimas preguntas de la tabla anterior (89 a 93) son preguntas conductuales y situacionales. Aunque parecen menos técnicas, muchas empresas las usan como factor decisivo entre candidatos con habilidades similares. Practica tus respuestas usando el método STAR y prepara al menos tres historias reales de tu experiencia que puedas adaptar a diferentes preguntas.
#
Pregunta
Respuesta sugerida
94
¿Qué es un schema-on-read y un schema-on-write?
Schema-on-write aplica el esquema al momento de escribir los datos (como en un data warehouse relacional). Schema-on-read aplica el esquema cuando se leen los datos (como en un data lake). El primero garantiza consistencia; el segundo ofrece flexibilidad.
95
¿Qué es Apache Iceberg y qué problema resuelve?
Es un formato de tabla abierto para data lakes que añade transacciones ACID, versionado de esquemas, time travel y particionamiento oculto. Resuelve los problemas de consistencia y gestión que tienen los data lakes basados únicamente en archivos.
96
¿Qué es la serialización de datos y qué formatos conoces?
Es el proceso de convertir estructuras de datos en un formato que se pueda transmitir o almacenar. Formatos comunes: JSON (legible), Avro (binario, con esquema), Protobuf (binario, compacto), Parquet (columnar para analítica) y ORC (columnar optimizado para Hive).
97
¿Qué es un data mesh?
Es un paradigma organizacional donde la propiedad de los datos se descentraliza hacia los equipos de dominio. Cada equipo es responsable de producir y mantener sus propios productos de datos, siguiendo estándares de gobernanza compartidos.
98
¿Qué son los data products?
Son conjuntos de datos tratados como productos: tienen un propietario, documentación, SLAs de calidad, versionado y una interfaz clara para sus consumidores. El objetivo es que los datos sean tan fiables y fáciles de usar como cualquier API de software.
99
¿Qué es la latencia de datos y cómo la reducirías?
Es el tiempo que tarda un dato en estar disponible desde que se genera en la fuente. Se reduce usando streaming en lugar de batch, optimizando las transformaciones, paralelizando tareas y eligiendo infraestructura con baja latencia de red.
100
¿Qué tendencias ves en el futuro de la ingeniería de datos?
La consolidación del data lakehouse como arquitectura dominante, la adopción de data mesh en organizaciones grandes, la integración de IA generativa en herramientas de datos, la automatización de la calidad con observabilidad y la creciente importancia de los data contracts.
Preguntas frecuentes
¿Cuánto tiempo toma prepararse para una entrevista de ingeniero de datos?
El tiempo varía según tu experiencia previa, pero un plan de preparación de cuatro a ocho semanas suele ser suficiente si dedicas al menos una hora diaria. Durante ese período puedes repasar los fundamentos de SQL, practicar con ejercicios en plataformas especializadas, revisar conceptos de modelado y arquitectura, y construir al menos un proyecto personal que demuestre tus habilidades. Si ya tienes experiencia laboral, el tiempo se reduce porque tu enfoque estará más en pulir la comunicación que en aprender desde cero.
¿Qué nivel de SQL necesito para una entrevista de ingeniería de datos?
Necesitas un nivel avanzado que incluya funciones de ventana, CTEs recursivos, optimización de consultas y comprensión de planes de ejecución. No basta con saber escribir un SELECT básico. Los entrevistadores suelen pedir que resuelvas problemas con datos en tiempo real, expliques cómo optimizarías una consulta lenta o diseñes un esquema de tablas para un caso de negocio. Practicar con conjuntos de datos reales te da mucha más preparación que estudiar solo la teoría.
¿Hacen pruebas técnicas en vivo en las entrevistas para ingeniero de datos?
Sí, muchas empresas incluyen pruebas de código en vivo donde debes escribir consultas SQL, resolver problemas con Python o diseñar un pipeline de datos en una pizarra virtual. Algunas usan plataformas como CoderPad o HackerRank donde escribes y ejecutas código en tiempo real mientras el entrevistador observa tu proceso. La clave es pensar en voz alta, explicar tu enfoque antes de escribir código y manejar los errores con calma, porque evalúan tanto tu técnica como tu capacidad para resolver problemas bajo presión.
¿Qué diferencia hay entre una entrevista para ingeniero de datos junior y senior?
En posiciones junior, las preguntas se centran en fundamentos de SQL, bases de datos, programación básica en Python y comprensión de conceptos como ETL y normalización. Para roles senior, las entrevistas profundizan en diseño de sistemas, decisiones de arquitectura, manejo de datos a gran escala, liderazgo técnico y resolución de problemas ambiguos donde no existe una única respuesta correcta. Los seniors también deben demostrar experiencia real con trade-offs y la capacidad de comunicarse eficazmente con equipos no técnicos.
¿Qué certificaciones ayudan a destacar en una entrevista de ingeniero de datos?
Las certificaciones más valoradas son Google Professional Data Engineer, AWS Certified Data Analytics, Azure Data Engineer Associate y Databricks Certified Data Engineer. No sustituyen la experiencia práctica, pero demuestran que has estudiado una plataforma de forma estructurada y que conoces sus servicios y mejores prácticas. Durante la entrevista, puedes mencionar los proyectos que hiciste para preparar la certificación como evidencia concreta de tu capacidad técnica.
¿Es necesario saber programar en Python para ser ingeniero de datos?
Aunque técnicamente puedes trabajar solo con SQL y herramientas de interfaz gráfica, Python es prácticamente un requisito en la mayoría de las ofertas laborales actuales. Lo necesitas para automatizar tareas, escribir transformaciones complejas, interactuar con APIs, usar PySpark para procesamiento distribuido y crear scripts de ingestión o validación. Aprender Python no significa dominar toda la programación avanzada, sino manejar con soltura las estructuras de datos básicas, las librerías clave como Pandas y la lógica necesaria para escribir código limpio y reutilizable.
¿Qué proyectos personales puedo mostrar en una entrevista de ingeniería de datos?
Los proyectos más impresionantes son pipelines de datos de principio a fin que ingesten datos de una API pública, los transformen y los carguen en un data warehouse o data lake. Puedes usar datos de clima, deportes, finanzas o redes sociales. Añade orquestación con Airflow, transformaciones con dbt, almacenamiento en BigQuery o Snowflake y un dashboard final con alguna herramienta de visualización. Publícalo en GitHub con un README claro que explique la arquitectura, las decisiones técnicas y cómo ejecutar el proyecto.
Conclusión
Preparar una entrevista para ingeniero de datos requiere cubrir un espectro amplio de conocimientos, desde los fundamentos de bases de datos y SQL hasta arquitectura de sistemas, calidad de datos y herramientas del ecosistema cloud. Las 100 preguntas que has revisado aquí representan los temas que más aparecen en procesos de selección reales, y tener una respuesta clara para cada una te pone en una posición mucho más fuerte que la mayoría de los candidatos.
Lo más relevante es que no te limites a memorizar respuestas. Practica SQL todos los días, construye al menos un proyecto personal completo, repasa los conceptos de modelado y arquitectura con ejemplos concretos y entrena tu capacidad de explicar decisiones técnicas en voz alta. Si aplicas estos puntos de forma constante durante varias semanas, vas a llegar a tu entrevista con la confianza que solo da la preparación genuina.
Tu próximo paso es elegir las áreas donde te sientes menos seguro y profundizar en ellas con ejercicios prácticos. La ingeniería de datos es un campo que premia la curiosidad y el aprendizaje continuo, y cada entrevista es una oportunidad para crecer. Sigue explorando los recursos disponibles en este sitio web para fortalecer tu perfil y acercarte cada vez más al puesto que buscas.
Soy ingeniero con amplia experiencia en el desarrollo de proyectos y la divulgación de temas de ingeniería.
A lo largo de mi carrera he aprendido que compartir el conocimiento es fundamental para el crecimiento profesional y personal. Por eso, me esfuerzo en crear contenido útil y accesible para quienes desean adentrarse en el mundo de la ingeniería.