
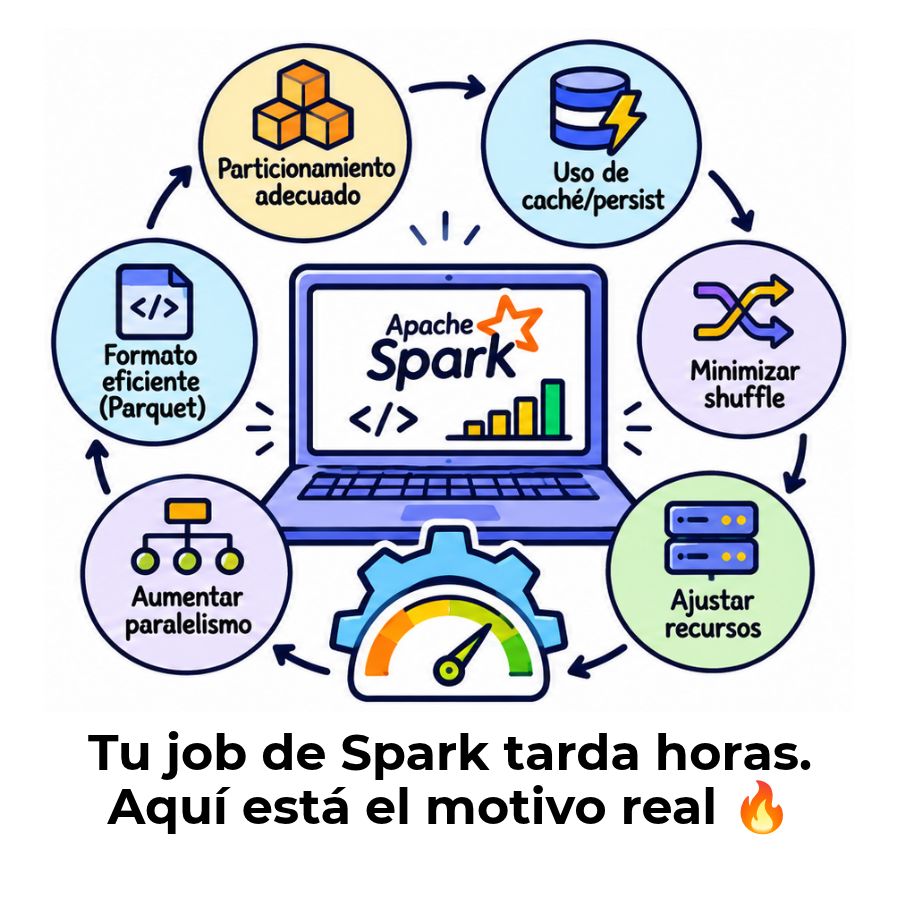
Optimizar un job de Apache Spark significa reducir el tiempo de ejecución y el consumo de recursos ajustando cómo el motor procesa, distribuye y almacena los datos. Las técnicas van desde elegir el número correcto de particiones hasta activar funcionalidades automáticas como Adaptive Query Execution, disponible desde Spark 3.
¿Qué significa optimizar un job en Apache Spark?
Un job en Apache Spark es la unidad de trabajo que se dispara cada vez que el motor necesita ejecutar una acción sobre los datos, como recopilar resultados, escribir en disco o contar registros. Cuando hablamos de optimizarlo, hablamos de reducir el tiempo que tarda esa unidad en completarse y la cantidad de recursos de CPU, memoria y red que consume para lograrlo.
La diferencia entre un job bien optimizado y uno que no lo está puede ser de minutos o de horas, dependiendo del volumen de datos. Esto tiene un impacto directo en los costos de infraestructura, especialmente cuando se trabaja con clústeres en la nube, donde cada minuto de ejecución tiene un precio.
¿Cómo funciona Spark internamente antes de ejecutar un job?
Cuando escribes una transformación en Spark, el motor no la ejecuta de inmediato. En cambio, construye un DAG (Directed Acyclic Graph), que es un mapa detallado de todas las operaciones necesarias para producir el resultado. Este proceso se llama evaluación perezosa o lazy evaluation, y es fundamental para entender por qué ciertas decisiones de código tienen impacto directo en el rendimiento.
Solo cuando se llama a una acción, como count(), collect() o write(), Spark materializa ese plan y lo convierte en jobs, stages y tasks distribuidos entre los executors del clúster. El DAG Scheduler decide cómo dividir ese plan en etapas, y el Task Scheduler se encarga de asignar cada tarea al nodo disponible más adecuado.
¿Por qué un job mal configurado consume más recursos de los necesarios?
El problema más habitual no es el código en sí, sino cómo ese código interactúa con la distribución de los datos. Un job que mueve más datos de los necesarios entre nodos, que tiene particiones desbalanceadas o que recomputa el mismo DataFrame varias veces, terminará consumiendo más memoria, más CPU y más tiempo de red que uno diseñado con cuidado.
Tres patrones concentran la mayoría de los problemas de rendimiento: el shuffle excesivo, que mueve datos entre nodos de forma innecesaria; el data skew, que sobrecarga algunas particiones mientras otras están vacías; y la configuración por defecto, que rara vez se adapta bien al tamaño real del dataset que estás procesando.
¿Cómo identificar cuellos de botella en tus jobs de Spark?
Antes de aplicar cualquier optimización, es necesario saber exactamente dónde está el problema. Intentar mejorar el rendimiento sin antes medir es una pérdida de tiempo, porque podrías optimizar una parte del job que no es el verdadero limitante. El punto de partida siempre debe ser la observación y el análisis de lo que ya está ocurriendo.
¿Qué información te da la Spark UI?
La Spark UI es la herramienta de monitoreo integrada en el motor y es el primer lugar donde debes buscar cuando un job no rinde como esperas. Se accede normalmente desde el puerto 4040 del nodo driver y muestra en tiempo real el estado de cada job, stage y tarea. No hace falta instalar nada adicional: Spark la activa por defecto en cada sesión.
¿Qué debes revisar en la Spark UI?
Pestaña Jobs
Muestra todos los jobs activos y completados, con su duración total y número de stages.
Pestaña Stages
Detalla cada stage: tareas fallidas, tareas lentas, spill a disco y volumen de shuffle.
Pestaña Storage
Lista los RDDs y DataFrames en caché, con su tamaño en memoria y en disco.
Pestaña Executors
Refleja el uso de CPU, memoria, GC time y la cantidad de datos leídos por cada nodo.
¿Cómo detectar data skew en tus particiones?
El data skew ocurre cuando los datos no se distribuyen de forma uniforme entre las particiones. El síntoma más visible en la Spark UI es que la mayoría de las tareas de un stage terminan rápido, pero una o dos se quedan procesando durante minutos o incluso horas. Esas tareas rezagadas son las que contienen la mayor cantidad de datos y están bloqueando la finalización del stage completo.
Para confirmar si hay skew, puedes revisar la distribución de filas por partición directamente desde tu código. Si encuentras que algunas particiones tienen diez o veinte veces más registros que otras, estás ante un caso de desbalanceo que necesita corrección antes de cualquier otra optimización.
Particionado de datos: la base del rendimiento
El particionado es el mecanismo que permite a Spark procesar datos en paralelo. Cada partición es una porción del dataset que un executor puede manejar de forma independiente, sin necesidad de comunicarse con otros nodos. Un particionado correcto es la decisión de optimización con mayor impacto en casi todos los jobs, porque afecta directamente el paralelismo, el balanceo de carga y el uso de memoria.
¿Cómo elegir el número correcto de particiones?
El valor por defecto de spark.sql.shuffle.partitions es 200, y eso no es adecuado para la mayoría de los casos reales. Para datasets pequeños, 200 particiones generan una sobrecarga innecesaria porque hay más tareas que datos útiles que procesar. Para datasets muy grandes, pueden ser demasiado pocas, lo que hace que cada partición sea enorme y tarde demasiado.
Una regla práctica es apuntar a que cada partición contenga entre 100 MB y 200 MB de datos. Si sabes el tamaño total del dataset, puedes dividirlo entre ese rango para obtener una estimación inicial. Después, ajusta en función de lo que ves en la Spark UI: si las tareas son muy rápidas, probablemente tienes demasiadas particiones; si algunas son muy lentas, posiblemente tienes pocas o hay skew.
¿Qué es el data skew y cómo corregirlo con salting?
El data skew ocurre cuando ciertos valores de una columna son mucho más frecuentes que otros. Si haces un groupBy o un join usando esa columna, todas las filas con ese valor van a la misma partición, que termina con mucho más trabajo que las demás. La técnica del salting consiste en añadir un sufijo numérico aleatorio a esa clave para distribuir artificialmente los datos entre más particiones.
El proceso implica añadir un número aleatorio entre 0 y N a la clave original antes del join o la agregación, y luego replicar la tabla pequeña N veces con cada posible valor del sufijo. Al final, eliminas el sufijo para obtener el resultado correcto. Es una técnica con algo de complejidad, pero en casos de skew severo puede reducir el tiempo de ejecución de forma dramática.
¿Cómo reducir las operaciones de shuffle en Spark?
El shuffle es el proceso por el que Spark redistribuye datos entre los nodos del clúster para completar operaciones como joins o agregaciones. Es la operación más costosa en términos de red, disco y tiempo de procesamiento. Reducir el shuffle al mínimo posible es una de las palancas de optimización con mayor retorno, independientemente del tamaño del dataset.
Los shuffles implican redistribuir datos a través de la red y son con frecuencia la parte más costosa de un job de Spark.
Broadcast joins: cuándo y cómo aplicarlos
Un broadcast join es una estrategia que evita el shuffle por completo cuando uno de los dos datasets que estás uniendo es suficientemente pequeño. En lugar de mover los datos de la tabla grande hacia los nodos que tienen la tabla pequeña, Spark envía una copia de la tabla pequeña a todos los executors. El join ocurre localmente en cada nodo, sin ningún movimiento de red adicional.
¿Cuándo usar un broadcast join?
✅ Úsalo cuando…
La tabla pequeña pesa menos de 100 MB (configurable). Hay una tabla grande y una tabla de referencia o catálogo. Quieres eliminar el shuffle por completo en un join.
❌ Evítalo cuando…
Ambas tablas son grandes. La memoria del executor es limitada. El driver no puede serializar la tabla completa sin problemas.
Puedes activarlo manualmente con broadcast(df_pequeño) o ajustando spark.sql.autoBroadcastJoinThreshold.
Filtrar y seleccionar columnas antes del shuffle
Una de las formas más directas de reducir el costo del shuffle es reducir el volumen de datos antes de que ocurra. Si aplicas filtros de filas y seleccionas solo las columnas necesarias al principio del pipeline, el shuffle opera sobre un dataset más pequeño y termina más rápido. Este patrón se conoce como predicate pushdown y, cuando se usa con formatos como Parquet, Spark puede incluso evitar leer del disco los bloques que no necesita.
El error más habitual es hacer un SELECT * al leer los datos y aplicar los filtros después de operaciones costosas. Invertir ese orden, leer solo las columnas necesarias y filtrar lo antes posible, puede reducir significativamente tanto el tiempo de lectura como el volumen de datos que viaja por la red durante el shuffle.
Gestión de memoria y serialización en Spark
La memoria es un recurso crítico en Spark. El motor la usa para almacenar datos en caché, para realizar operaciones de shuffle y para ejecutar las transformaciones. Cuando no hay suficiente memoria disponible, Spark empieza a escribir datos en disco, lo que se conoce como spill. Un spill frecuente es una señal clara de que la configuración de memoria necesita ajuste.
¿Cómo configurar la memoria del executor?
El parámetro spark.executor.memory define cuánta memoria JVM asignas a cada executor. Pero la memoria total que consume un executor en el sistema operativo es mayor, porque hay que sumar el overhead, que se configura con spark.executor.memoryOverhead y cubre el uso de JVM, Python y threads internos. No configurar el overhead correctamente es una de las causas más frecuentes de errores de memoria en clústeres con YARN o Kubernetes.
Dentro de la memoria del executor, Spark divide el espacio en dos grandes regiones: la memoria de ejecución, usada para operaciones como shuffles y joins, y la memoria de almacenamiento, usada para datos en caché. Ambas regiones comparten un mismo pool y pueden prestarse espacio entre sí, lo que se controla con spark.memory.fraction y spark.memory.storageFraction.
¿Por qué Kryo serialization supera a Java serialization?
Cuando Spark mueve datos entre nodos o los almacena en disco durante un shuffle, necesita serializar esos datos: convertirlos a un formato binario que se pueda transmitir y luego reconstruir. Por defecto, usa Java serialization, que es sencilla pero lenta y produce representaciones más grandes de lo necesario. Kryo serialization es entre cinco y diez veces más rápida y produce objetos de menor tamaño.
Activarla es una operación de una sola línea: basta con establecer spark.serializer en org.apache.spark.serializer.KryoSerializer. Para obtener el máximo beneficio, puedes además registrar las clases que usas con frecuencia, aunque esto es opcional. En Azure Synapse con runtime 3.1 o superior, Kryo ya viene activado por defecto.
Caché y persistencia: cuándo realmente valen la pena
El caché en Spark permite almacenar un DataFrame o RDD en memoria para reutilizarlo en múltiples acciones sin volver a computarlo desde cero. Es una herramienta poderosa, pero usarla sin criterio puede consumir la memoria que el motor necesita para otras operaciones críticas como el shuffle. La regla básica es simple: solo cachea lo que vas a usar más de una vez.
Diferencia entre cache() y persist()
| Método | Nivel de almacenamiento | Cuándo usarlo |
|---|---|---|
cache() |
MEMORY_AND_DISK | Reutilización simple; Spark gestiona el spill automáticamente |
persist(MEMORY_ONLY) |
Solo memoria RAM | Cuando el dataset cabe cómodamente en memoria y el recómputo es caro |
persist(MEMORY_AND_DISK_SER) |
Memoria + disco serializado | Datasets grandes que no caben del todo en RAM |
persist(DISK_ONLY) |
Solo disco | Cuando la memoria es muy limitada pero el recómputo es muy costoso |
¿Cómo evitar el abuso del caché?
Un error habitual es llamar a cache() en cada DataFrame del pipeline como práctica defensiva. El problema es que el caché ocupa espacio en la Unified Memory y puede desplazar datos que el motor necesita para operaciones de ejecución como joins o aggregations, provocando spill a disco y, paradójicamente, empeorando el rendimiento.
Además, Spark no libera el caché automáticamente hasta que termina la sesión o hasta que necesita el espacio para otra cosa. Si ya no vas a reutilizar un DataFrame, es buena práctica llamar a unpersist() para liberar la memoria de forma explícita. Puedes revisar qué está ocupando espacio en la pestaña Storage de la Spark UI en cualquier momento.
Adaptive Query Execution: optimización automática en Spark 3
Adaptive Query Execution (AQE) es una funcionalidad disponible desde Spark 3.0 que permite al motor ajustar el plan de ejecución de un job en tiempo real, basándose en las estadísticas que va recopilando durante la propia ejecución. Antes de AQE, Spark fijaba el plan de ejecución al inicio del job, sin posibilidad de corregirlo aunque los datos resultaran distintos a lo esperado.
AQE incluye tres capacidades principales. La primera es el coalesce automático de particiones: después de un shuffle, Spark puede detectar que muchas particiones quedaron casi vacías y combinarlas para reducir el número de tareas. La segunda es la conversión dinámica de joins: si durante la ejecución Spark descubre que una tabla es más pequeña de lo esperado, puede convertir automáticamente un sort-merge join en un broadcast join. La tercera es la resolución automática de skew: detecta particiones con mucho más datos que el promedio y las subdivide.
Activar AQE requiere una sola configuración: spark.sql.adaptive.enabled = true. Si estás en Spark 3.2 o superior, viene habilitado por defecto. Para versiones anteriores de Spark 3.x, es recomendable activarlo de forma explícita al crear la sesión. No tiene contraindicaciones significativas y, en la mayoría de los casos, mejora el rendimiento sin necesidad de ajustes adicionales.
Formatos de archivo y almacenamiento eficiente
El formato en que almacenas tus datos tiene un impacto directo en la velocidad de lectura, el volumen de datos que Spark necesita procesar y la efectividad de las optimizaciones que el motor puede aplicar automáticamente. No todos los formatos son iguales, y elegir el incorrecto puede anular gran parte del trabajo de optimización hecho en otras capas.
¿Por qué Parquet con compresión Snappy es la opción recomendada?
Parquet es un formato de almacenamiento columnar, lo que significa que los datos de cada columna se guardan juntos en disco. Cuando Spark lee solo algunas columnas de un dataset grande, no necesita leer las demás, lo que reduce drásticamente el volumen de I/O. Además, Parquet almacena estadísticas por bloque (mínimo, máximo, recuento) que permiten al motor saltar bloques enteros que no cumplen los filtros de la consulta.
La compresión Snappy es la más común junto a Parquet porque ofrece un buen balance entre velocidad de compresión/descompresión y tamaño del archivo resultante. Zstandard (Zstd) es una alternativa más reciente con mejor ratio de compresión a un costo de CPU similar, especialmente útil para datasets muy grandes donde el espacio en disco o el ancho de banda de red son el cuello de botella.
Partition pruning: cómo Spark salta datos irrelevantes
El partition pruning es la capacidad de Spark para leer solo las particiones de un dataset que son relevantes para una consulta. Para que funcione, los datos deben estar organizados en carpetas según una columna de particionado, como la fecha o la región, y la consulta debe filtrar por esa misma columna. Cuando se cumple, Spark simplemente no lee los archivos de las particiones que no necesita, como si no existieran.
La columna de particionado ideal es aquella que usas con frecuencia en tus filtros. Particionar por fecha es el caso más habitual en pipelines de ingeniería de datos, porque la mayoría de las consultas de producción operan sobre ventanas de tiempo concretas. Particionar por columnas de muy alta cardinalidad, como un ID único por registro, es un error común que genera miles de carpetas pequeñas y empeora el rendimiento de lectura.
Si quieres profundizar en los fundamentos de la gestión de datos y en los roles que intervienen en su gobierno, puedes consultar el artículo sobre qué hace un Data Steward, donde se explica cómo los profesionales de datos garantizan la calidad y organización de la información que luego consumen herramientas como Spark.
Preguntas frecuentes
¿Qué configuración de Spark tiene mayor impacto en el rendimiento?
No existe una única configuración universal, pero tres parámetros concentran la mayor parte de los problemas de rendimiento en la mayoría de los jobs: spark.sql.shuffle.partitions, que controla cuántas particiones se crean después de un shuffle y cuyo valor por defecto de 200 raramente es el óptimo; spark.executor.memory, que define cuánta memoria tiene disponible cada executor para operar; y spark.sql.adaptive.enabled, que activa AQE y permite que Spark ajuste el plan de ejecución en tiempo real. Ajustar estos tres en función de las características reales del dataset es el primer paso en cualquier proceso de optimización.
¿Cuántas particiones debo usar en un job de Spark?
La regla práctica más usada es apuntar a que cada partición contenga entre 100 MB y 200 MB de datos después del shuffle. Para estimarlo, divide el tamaño total del dataset entre ese rango y usa el resultado como punto de partida. Si tus tareas terminan en pocos segundos, probablemente tienes demasiadas particiones y puedes reducirlas. Si algunas tareas duran mucho más que otras y no hay skew, puede que necesites más particiones para distribuir mejor la carga. Con AQE activado, Spark puede ajustar este número automáticamente.
¿Qué es el data skew y cómo afecta a mis jobs de Spark?
El data skew ocurre cuando la distribución de datos entre las particiones es muy desigual: algunas particiones tienen una cantidad de registros mucho mayor que el resto. El síntoma visible es que la mayoría de las tareas de un stage terminan rápido, pero una o dos se quedan procesando durante mucho más tiempo, bloqueando la finalización de todo el stage. Esto sucede habitualmente cuando haces un groupBy o un join usando una columna cuya distribución de valores es muy desigual, como una categoría con un valor dominante que concentra la mayoría de los registros.
¿Cuándo debo usar cache() en un job de Spark?
Usa cache() o persist() únicamente cuando vayas a reutilizar el mismo DataFrame en dos o más acciones dentro del mismo job. Si un DataFrame solo se usa una vez, el caché no aporta ningún beneficio y sí ocupa memoria. Los candidatos ideales para cachear son los DataFrames resultado de transformaciones costosas (con joins o aggregations complejas) que luego se usan en múltiples ramas del pipeline. Siempre llama a unpersist() cuando ya no lo necesites para liberar el espacio de forma explícita.
¿Qué diferencia hay entre repartition() y coalesce() en Spark?
Ambos métodos cambian el número de particiones de un DataFrame, pero lo hacen de formas distintas con costos diferentes. repartition(n) realiza un shuffle completo para redistribuir los datos de forma uniforme entre las nuevas particiones: es costoso, pero produce un resultado balanceado, ideal cuando quieres aumentar particiones o redistribuir datos con skew. coalesce(n) reduce el número de particiones sin shuffle, simplemente combinando particiones existentes en el mismo nodo: es mucho más eficiente, pero puede generar particiones desbalanceadas. Usa repartition() para aumentar particiones o corregir skew, y coalesce() para reducir particiones antes de escribir en disco.
¿Qué es Adaptive Query Execution y para qué sirve en Spark 3?
Adaptive Query Execution (AQE) es una funcionalidad de Spark 3 que permite al motor reoptimizar el plan de ejecución de un job mientras lo está ejecutando, en lugar de fijarlo todo al inicio. Recoge estadísticas en tiempo real después de cada stage y usa esa información para tomar decisiones más inteligentes: colapsar particiones pequeñas, convertir joins costosos en broadcast joins o dividir particiones con skew. Se activa con spark.sql.adaptive.enabled = true y, en Spark 3.2 en adelante, viene habilitado por defecto. En la práctica, mejora el rendimiento de forma automática sin que necesites ajustar cada job manualmente.
¿Cómo funciona un broadcast join en Apache Spark?
En un join normal entre dos tablas grandes, Spark necesita redistribuir los datos de ambas entre los nodos para emparejar los registros que comparten la misma clave, lo que genera un shuffle costoso. Un broadcast join elimina ese shuffle enviando una copia completa de la tabla pequeña a todos los executors, de forma que cada nodo puede hacer el join localmente con su porción de la tabla grande sin mover datos por la red. Para activarlo manualmente, puedes usar la función broadcast(df) alrededor del DataFrame pequeño. Spark también puede convertir joins a broadcast de forma automática con AQE, si detecta que una tabla es suficientemente pequeña.
¿Por qué los UDFs ralentizan los jobs de Spark?
Los UDFs (User Defined Functions) en Python tienen tres limitaciones que los hacen inherentemente más lentos que las funciones nativas de Spark. Primero, rompen la optimización del Catalyst: el optimizador de consultas de Spark no puede «ver dentro» de un UDF para aplicar sus propias optimizaciones. Segundo, cuando usas UDFs de Python, Spark necesita serializar cada fila del DataFrame para pasarla al proceso de Python y luego deserializar el resultado, lo que genera una sobrecarga significativa. Tercero, procesan fila por fila en lugar de operar de forma vectorizada sobre columnas completas. La alternativa es siempre buscar primero si existe una función equivalente en pyspark.sql.functions, que sí aprovecha el motor columnar de Spark.
Conclusión
Optimizar un job de Apache Spark no es una tarea puntual, sino un proceso iterativo que empieza por entender cómo el motor ejecuta tu código y dónde están los cuellos de botella reales. Las técnicas que has visto aquí, desde el particionado y la reducción del shuffle hasta AQE y la elección del formato de archivo, forman un conjunto coherente de decisiones que se refuerzan entre sí.
El camino más efectivo es empezar por la Spark UI para identificar el problema concreto antes de aplicar cualquier cambio. Una vez que sabes si el problema es skew, spill de memoria o shuffle excesivo, puedes aplicar la técnica adecuada: salting, ajuste de memoria, broadcast join o activar AQE. Cambiar una sola variable a la vez te permitirá medir el impacto real de cada decisión.
Si te interesa seguir profundizando en el mundo del procesamiento de datos a gran escala, en este sitio web encontrarás más contenido sobre ingeniería de datos, donde se tratan los fundamentos, herramientas y buenas prácticas que todo profesional del área necesita conocer.
Sigue aprendiendo:
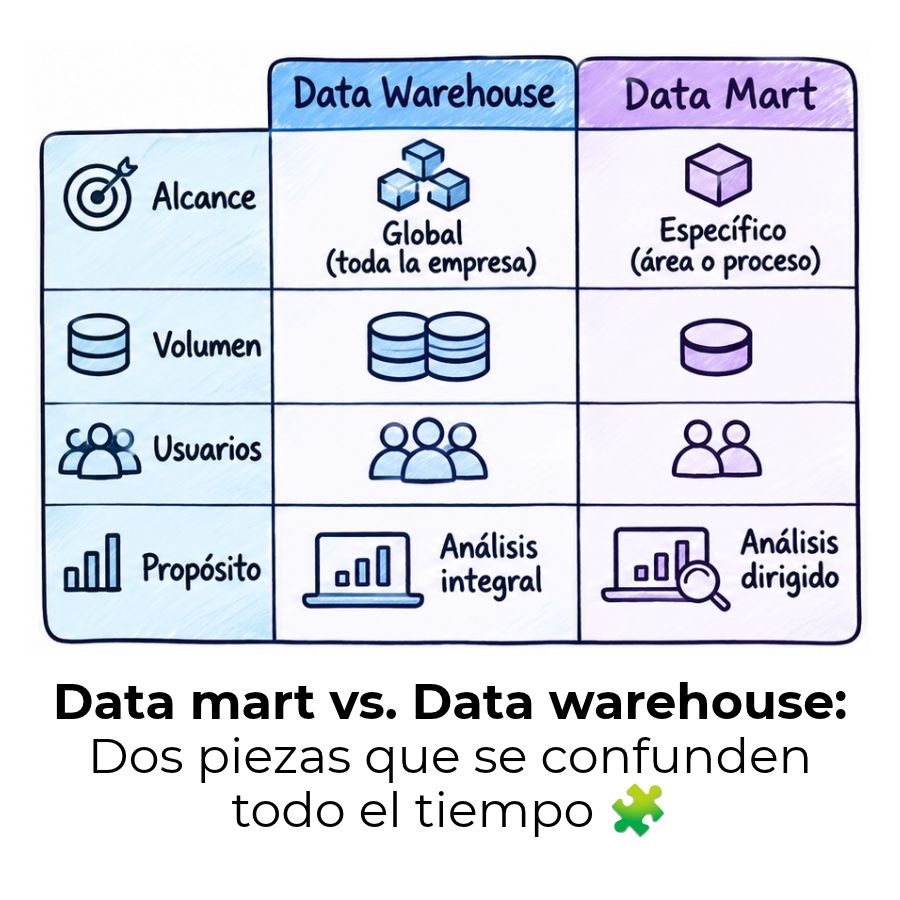
Diferencia entre data mart y data warehouse
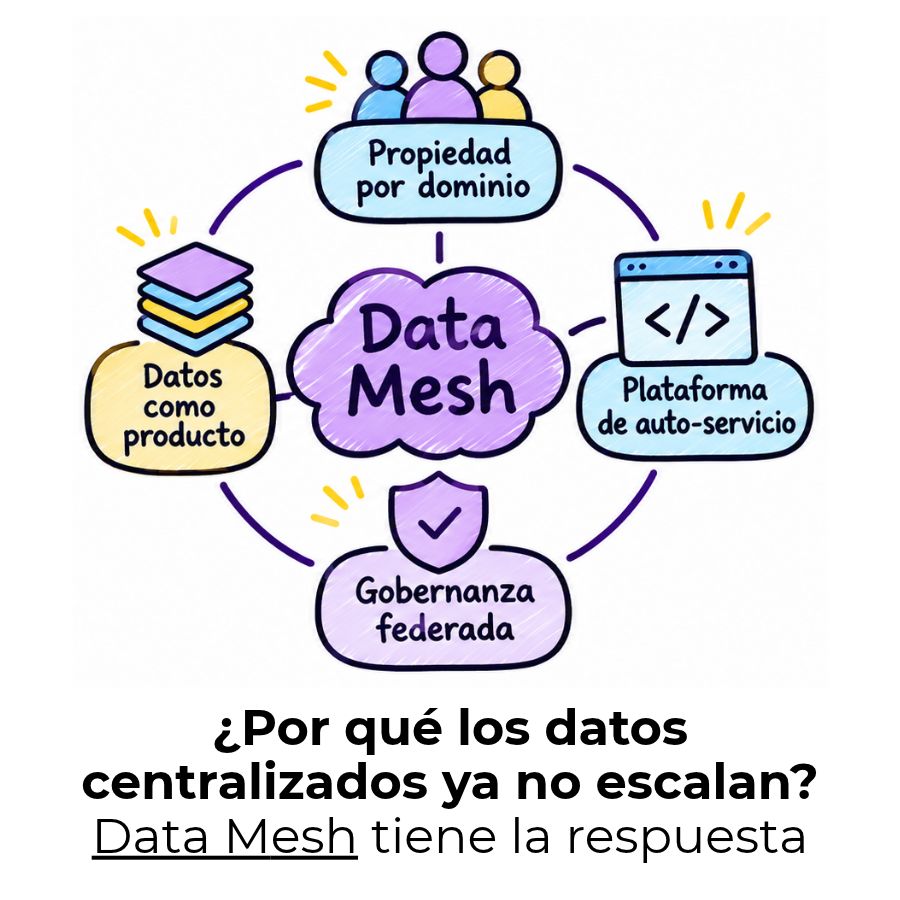
Data Mesh: La arquitectura que descentraliza datos
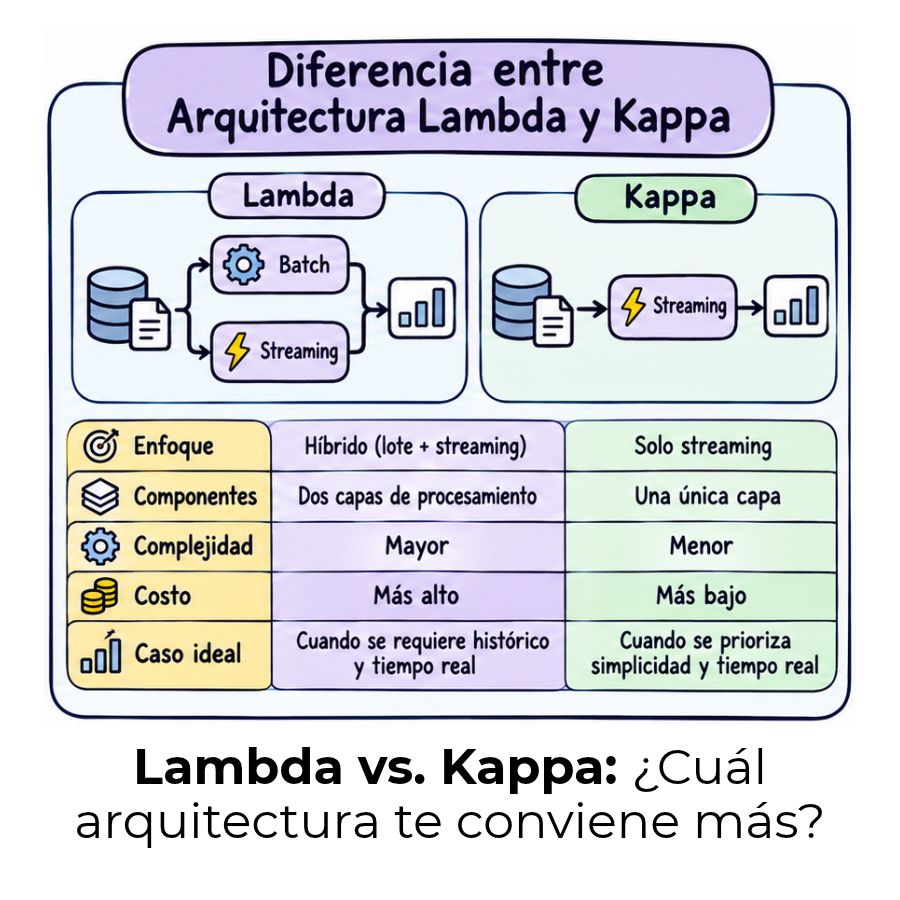
Diferencia entre arquitectura Lambda y Kappa
Azure Data Factory (ADF): El servicio que mueve tus datos en la nube ☁️
Cómo ser ingeniero de datos desde cero
Linaje de datos: El mapa oculto detrás de cada dato
¿Qué lenguaje aprender para ser ingeniero de datos?
¿Qué hace un ingeniero de datos?
