
El linaje de datos es el registro que muestra el origen, las transformaciones y el destino final de cada dato dentro de una organización. Te permite rastrear cómo evoluciona la información desde su captura hasta su uso, aportando claridad, trazabilidad y seguridad en cada decisión basada en datos.
¿Qué es el linaje de datos?
El linaje de datos es el registro detallado del recorrido que sigue un dato desde su origen hasta su destino final dentro de un sistema. Documenta cada paso, cada transformación y cada sistema por el que pasa. Gracias a esta visibilidad, cualquier profesional puede entender cómo se construye una métrica, dónde se originan los errores y qué partes del flujo son críticas para la organización.
Definición técnica y conceptual
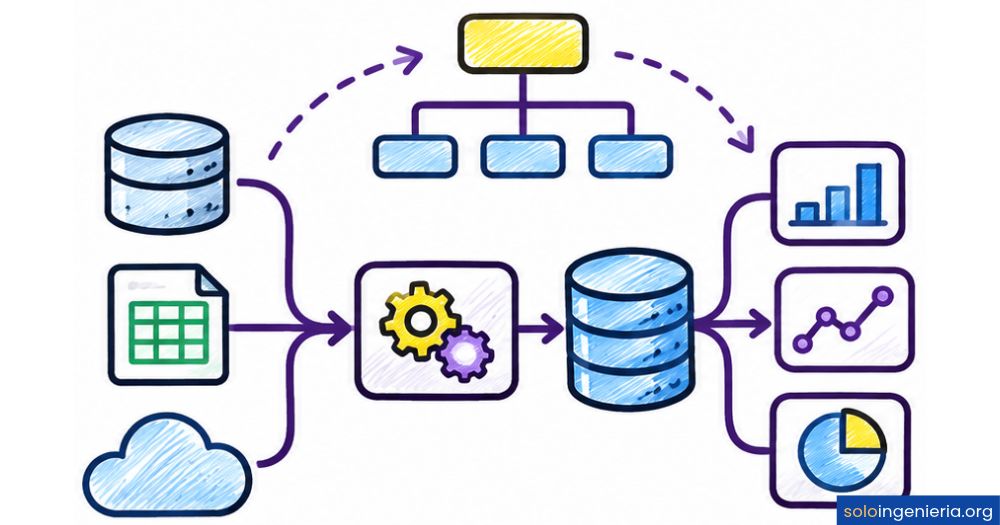
Desde una perspectiva técnica, el linaje describe el mapa de dependencias entre tablas, columnas, pipelines, scripts y sistemas. Cada vez que un dato se mueve o se transforma, el linaje captura esa acción como un nodo o una relación. Esto permite reconstruir el historial completo de la información, identificar cuellos de botella y entender el impacto real de cualquier cambio técnico sobre los procesos posteriores.
Diferencia entre linaje de datos y gobernanza de datos
Muchas personas confunden ambos conceptos, pero cumplen funciones distintas. La gobernanza define las políticas, roles y normas que regulan el uso de los datos. En cambio, el linaje es una herramienta operativa que muestra cómo se mueve la información. Uno establece las reglas del juego y el otro demuestra que esas reglas realmente se cumplen a lo largo de cada flujo técnico y analítico.
¿Para qué sirve el linaje de datos en una organización?
El linaje aporta valor en múltiples niveles dentro de una empresa. No se limita a equipos técnicos: También beneficia a áreas de negocio, cumplimiento, analítica e incluso a la alta dirección. Al mostrar con claridad cómo fluye cada dato, reduce la incertidumbre y aumenta la confianza en los procesos que dependen de la información para operar y para tomar decisiones estratégicas.
Trazabilidad de información crítica
Cuando aparece un error en un reporte financiero, la pregunta inmediata es: ¿De dónde vino ese dato? Sin linaje, responderla puede tomar días. Con linaje, el origen y las transformaciones se rastrean en minutos. Esta capacidad es vital en sectores como banca, salud o retail, donde cualquier dato incorrecto puede provocar consecuencias económicas, reputacionales o legales difíciles de revertir después.
Cumplimiento normativo y auditoría
Regulaciones como el GDPR europeo o la Ley de Protección de Datos exigen demostrar cómo se recopila, procesa y almacena la información personal. El linaje facilita esta tarea porque entrega evidencia visual y documentada de todo el ciclo de vida del dato. Los auditores pueden revisar flujos completos sin depender de entrevistas manuales ni documentación dispersa en múltiples equipos.
Puedes consultar la guía oficial de la normativa europea de protección de datos para entender mejor las exigencias actuales de trazabilidad.
Tipos de linaje de datos
No existe una única forma de representar el linaje. Según el objetivo, la madurez tecnológica y las necesidades del equipo, se utilizan distintos enfoques. Cada tipo aporta un nivel diferente de detalle y automatización, lo que influye directamente en la facilidad con la que puedes mantenerlo actualizado, escalarlo y aprovecharlo en entornos empresariales reales.
Linaje de datos descriptivo
Se construye de forma manual mediante documentación, diagramas y descripciones elaboradas por los propios equipos. Es útil en entornos pequeños o cuando no existe presupuesto para herramientas especializadas. Sin embargo, su mayor debilidad es la dificultad para mantenerlo actualizado, ya que cualquier cambio en los pipelines debe reflejarse manualmente y eso genera inconsistencias con el tiempo.
Linaje de datos automático
Este enfoque usa herramientas que analizan los metadatos, los scripts SQL, los procesos ETL y las APIs para generar el linaje de manera automática y continua. Es la opción preferida en organizaciones con grandes volúmenes de información porque reduce el esfuerzo humano, minimiza errores y mantiene el mapa actualizado cada vez que algo cambia dentro de la infraestructura de datos.
Linaje de datos a nivel de negocio
Está pensado para audiencias no técnicas como gerentes, analistas de negocio o responsables de cumplimiento. Muestra el linaje en términos comprensibles, sin detalles técnicos abrumadores. Su valor radica en traducir el recorrido de los datos a un lenguaje orientado a procesos y resultados, lo que permite a las áreas de negocio tomar decisiones informadas sin depender de los equipos de ingeniería.
Componentes clave del linaje de datos
Para que un linaje funcione de forma efectiva, necesita una serie de piezas que trabajen de manera coordinada. Cada componente cumple un rol específico y, en conjunto, construyen una vista coherente y confiable del flujo de información. Conocerlos te ayuda a evaluar cualquier herramienta o solución disponible en el mercado antes de implementarla.
📥 Metadatos
Información descriptiva sobre cada dato, tabla y campo. Son la base sobre la que se construye el linaje.
🔄 Transformaciones
Scripts, consultas y procesos ETL que modifican los datos a lo largo de su recorrido completo.
🗂️ Repositorios
Sistemas donde se almacenan los datos: Bases de datos, data warehouses, data lakes y archivos.
📊 Visualización
Interfaz gráfica que muestra las conexiones y dependencias entre los distintos elementos del flujo.
¿Cómo funciona el linaje de datos?
El linaje opera mediante un proceso técnico estructurado que se ejecuta de manera continua. Aunque las herramientas automatizan gran parte del trabajo, entender cada fase te ayuda a evaluar la calidad y confiabilidad de cualquier implementación. A continuación, conoces las tres etapas principales que todo sistema moderno de linaje debe cubrir sin excepción.
Captura de metadatos
La primera fase consiste en extraer metadatos desde todas las fuentes relevantes: Bases de datos, herramientas de integración, APIs, archivos de configuración y scripts. Esta captura puede realizarse en modo batch o mediante técnicas de Change Data Capture (CDC). Sin una recolección completa y confiable de metadatos, el linaje resultante será parcial y poco útil para auditorías o análisis de impacto.
Mapeo de transformaciones
Una vez recolectados los metadatos, el sistema analiza cada transformación aplicada al dato. Esto incluye consultas SQL, procesos de limpieza, agregaciones, joins y cualquier lógica de negocio. El resultado es un grafo de dependencias que conecta orígenes con destinos, mostrando con precisión qué pasos intermedios ocurrieron. Este mapeo es clave para rastrear errores hasta su causa raíz real.
Visualización del flujo
La última etapa transforma los datos técnicos en una representación visual comprensible. Normalmente, se muestra como un grafo interactivo donde cada nodo representa una tabla, columna o proceso. Los usuarios pueden navegar el flujo completo, hacer zoom en secciones específicas y detectar dependencias ocultas que serían prácticamente imposibles de identificar revisando código o documentación manual tradicional.
Beneficios del linaje de datos para equipos técnicos y de negocio
Implementar linaje no es solo una buena práctica técnica: Genera beneficios tangibles en toda la organización. Los equipos ganan velocidad, confianza y capacidad de reacción ante incidentes, mientras que el negocio obtiene mejor visibilidad sobre sus procesos y mayor seguridad en sus decisiones basadas en información analítica cada vez más compleja.
- Análisis de impacto: Identificas rápidamente qué reportes, modelos o dashboards se verán afectados por un cambio en una tabla.
- Depuración acelerada: Detectas el origen de errores sin revisar cada paso manualmente, ahorrando horas de trabajo técnico.
- Confianza en los datos: Los equipos saben de dónde viene cada cifra, lo que aumenta la credibilidad de los análisis presentados.
- Documentación automática: El propio sistema genera la documentación del flujo, reduciendo el esfuerzo manual constante.
- Mejor colaboración: Áreas técnicas y de negocio comparten un lenguaje visual común para hablar sobre los datos.
- Gestión del riesgo: Identificas puntos críticos donde un fallo podría tener consecuencias serias para la operación diaria.
Herramientas populares para gestionar el linaje de datos
Existen múltiples soluciones en el mercado, cada una con fortalezas específicas según el tipo de infraestructura, el presupuesto y el nivel de automatización deseado. Elegir la herramienta adecuada depende del ecosistema tecnológico ya existente y del objetivo principal que persiga tu equipo con la implementación del linaje dentro de la organización.
| Herramienta | Tipo | Fortaleza principal |
|---|---|---|
| Apache Atlas | Open source | Ideal para ecosistemas Hadoop y big data |
| Collibra | Comercial | Fuerte enfoque en gobernanza empresarial |
| Alation | Comercial | Catálogo de datos con linaje integrado |
| OpenLineage | Open source | Estándar abierto para múltiples plataformas |
| Microsoft Purview | Comercial | Integración nativa con entorno Azure |
| Informática EDC | Comercial | Linaje técnico detallado en grandes empresas |
Retos comunes al implementar el linaje de datos
Aunque los beneficios son claros, la implementación puede enfrentar varios obstáculos. Conocerlos de antemano te ayuda a planificar mejor el proyecto y evitar errores frecuentes. La mayoría de estos retos no son técnicos en su totalidad: Muchos están relacionados con la cultura organizacional y con la forma en que los equipos gestionan sus procesos actuales.
Integrar sistemas antiguos con modernos requiere conectores específicos y mucha configuración.
Las grandes organizaciones generan cantidades masivas de metadatos difíciles de procesar.
Algunos equipos ven el linaje como una herramienta de control en lugar de un apoyo real.
El linaje debe actualizarse con cada cambio en los pipelines para seguir siendo confiable.
Además, cuando el procesamiento de datos en tiempo real forma parte de la arquitectura, el linaje debe actualizarse al mismo ritmo que los eventos. Esta exigencia añade una capa de complejidad que requiere herramientas preparadas para operar bajo latencias muy bajas y con alta disponibilidad constante dentro de todo el ecosistema analítico moderno.
Preguntas frecuentes
¿Qué diferencia hay entre linaje de datos y catálogo de datos?
El catálogo de datos es un inventario que organiza y describe los activos de información disponibles en la organización. El linaje, en cambio, muestra el recorrido y las relaciones entre esos activos. Aunque suelen complementarse, el catálogo responde a la pregunta «qué existe» y el linaje responde a «cómo se conecta y transforma cada dato».
¿El linaje de datos es obligatorio por ley?
No existe una ley que lo exija de forma directa, pero muchas regulaciones demandan trazabilidad completa sobre datos personales o financieros. Normativas como GDPR, HIPAA o SOX requieren demostrar cómo se gestionan los datos, y el linaje es la forma más eficiente y auditable de cumplir esas exigencias dentro de cualquier organización moderna.
¿Puede implementarse el linaje de datos en tiempo real?
Sí, varias herramientas modernas soportan linaje en tiempo real integrándose con plataformas de streaming como Kafka, Flink o Spark Streaming. Esto permite registrar cada evento y transformación conforme ocurre, resultando especialmente útil en sectores como banca, fraude o telecomunicaciones, donde la latencia debe reducirse al mínimo posible para operar correctamente.
¿Qué perfil profesional gestiona el linaje de datos?
Habitualmente, lo gestionan ingenieros de datos, arquitectos de datos y especialistas en gobernanza. También participan analistas de negocio y responsables de cumplimiento normativo. En equipos maduros existe el rol de data steward, encargado específicamente de mantener la calidad y confiabilidad del linaje como parte central de las responsabilidades de la ingeniería de datos.
¿Cuál es la relación entre linaje de datos e inteligencia artificial?
La inteligencia artificial depende de datos de entrada de calidad para entrenar modelos confiables. El linaje permite verificar el origen de esos datos, detectar sesgos potenciales y auditar las transformaciones aplicadas. Sin linaje, resulta muy difícil demostrar que un modelo está siendo alimentado con información adecuada, trazable y conforme a las normativas vigentes.
¿Cómo se representa visualmente el linaje de datos?
Se representa normalmente como un grafo dirigido donde los nodos son tablas, columnas o procesos, y las flechas indican el flujo. Las herramientas modernas ofrecen interfaces interactivas con zoom, filtros y vistas por niveles. También existen representaciones tipo árbol o diagrama de flujo, según la complejidad del entorno y la audiencia objetivo del análisis.
¿Qué tan costoso es implementar una solución de linaje de datos?
El costo varía según el tamaño de la organización, las herramientas elegidas y el nivel de automatización deseado. Existen opciones open source gratuitas como Apache Atlas y OpenLineage, mientras que las soluciones comerciales suelen requerir licencias anuales. El verdadero costo también incluye tiempo de configuración, integración y mantenimiento continuo del sistema.
Conclusión
El linaje de datos es mucho más que una herramienta técnica: Es la base sobre la que se construye la confianza en la información dentro de cualquier organización moderna. Te permite entender el recorrido completo de cada dato, desde su origen hasta su uso final, con un nivel de claridad imposible de lograr mediante documentación manual tradicional.
Ya conoces los tipos, componentes, beneficios y herramientas que conforman este campo. Puedes empezar evaluando el nivel actual de trazabilidad en tu entorno, identificar las fuentes más críticas y explorar soluciones que se adapten a tu infraestructura. Cada paso que des hacia una mejor visibilidad fortalece la calidad de tus decisiones basadas en datos.
Entender esta pieza fundamental te acerca al estándar que siguen los equipos de datos más avanzados del mundo. Si quieres seguir profundizando en temas relacionados, en este sitio web encontrarás contenidos cuidadosamente preparados para acompañarte en cada etapa de tu aprendizaje sobre ingeniería y gestión moderna de la información.
Sigue aprendiendo:
Apache Spark: El motor de datos que no conocías
Stack de datos moderno: La revolución silenciosa del análisis
¿Qué es un data warehouse y para qué sirve?
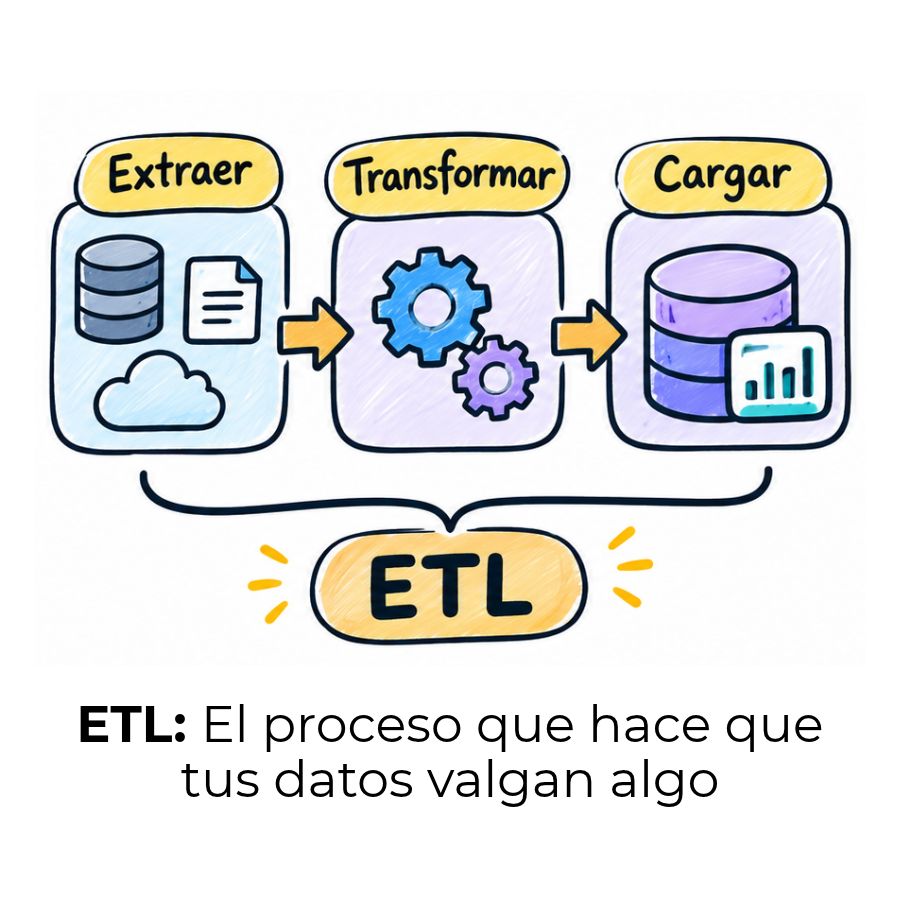
¿Qué es ETL? – Extracción, Transformación y Carga
DataOps: El enfoque que rompe los silos entre datos y equipos
Particionamiento de datos: El secreto detrás de las bases rápidas
¿Qué lenguaje aprender para ser ingeniero de datos?
Proyectos de ingeniería de datos para portafolio
