
Para ser ingeniero de datos, necesitas dominar SQL y Python, aprender a construir pipelines de datos y familiarizarte con al menos una plataforma en la nube. No hace falta una carrera universitaria específica: lo que más peso tiene es la práctica y un portafolio con proyectos reales.
¿Qué es un ingeniero de datos y qué hace exactamente?
Un ingeniero de datos es el profesional que construye y mantiene los sistemas que permiten que la información fluya, se transforme y llegue lista para ser analizada. Su trabajo no consiste en interpretar los datos, sino en garantizar que estén disponibles, limpios y estructurados en el momento en que alguien los necesite. Sin este rol, los datos de una empresa serían un conjunto disperso de archivos sin ningún valor práctico.
En el día a día, un ingeniero de datos diseña pipeline de datos, configura bases de datos, automatiza procesos de extracción y transformación, y conecta distintas fuentes de información en un único sistema coherente. También trabaja junto a científicos de datos y analistas para que estos últimos puedan centrarse en extraer conclusiones sin preocuparse por la infraestructura.
Diferencia entre ingeniero de datos, científico de datos y analista
Estos tres roles trabajan con datos, pero desde ángulos muy distintos. El ingeniero de datos construye la infraestructura; el científico de datos usa esa infraestructura para crear modelos predictivos; y el analista de datos interpreta los resultados para tomar decisiones de negocio. Confundirlos es uno de los errores más comunes cuando alguien se acerca por primera vez a este campo.
| Rol | ¿Qué construye o hace? | Herramientas habituales |
|---|---|---|
| Ingeniero de datos | Pipelines, bases de datos, infraestructura de datos | SQL, Python, Spark, Airflow, nube |
| Científico de datos | Modelos predictivos, análisis estadístico avanzado | Python, R, TensorFlow, scikit-learn |
| Analista de datos | Informes, dashboards, interpretación de métricas | SQL, Excel, Power BI, Tableau |
¿Qué habilidades necesitas para ser ingeniero de datos?
Las habilidades de un ingeniero de datos se agrupan en dos grandes categorías: las técnicas, que son las que definen su trabajo diario, y las transversales, que determinan si puede colaborar bien dentro de un equipo. El dominio de SQL y Python es el punto de partida ineludible, pero a medida que avanzas, el ecosistema de herramientas se amplía de forma considerable.
Lenguajes de programación esenciales
SQL es el lenguaje más importante que aprenderás como ingeniero de datos. Se usa para consultar, filtrar, unir y transformar datos en casi cualquier entorno. No basta con conocer las consultas básicas: las window functions, los CTEs y la optimización de queries son habilidades que marcan la diferencia en el trabajo real. Python completa este dúo y se usa para automatizar procesos, conectar con APIs y manipular datos con librerías como pandas o Polars.
🐍 Python
Manipulación de datos con pandas y Polars, scripts de automatización, conexión con APIs y testing de pipelines. Nivel intermedio es suficiente para empezar.
🗄️ SQL
La base de todo. Joins complejos, subqueries, CTEs, window functions y optimización de consultas. Sin SQL sólido, el resto de herramientas pierde sentido.
Bases de datos relacionales y no relacionales
Un ingeniero de datos trabaja constantemente con dos tipos de bases de datos. Las relacionales, como PostgreSQL o MySQL, organizan la información en tablas con relaciones definidas y son ideales para datos estructurados. Las no relacionales, como MongoDB o Cassandra, permiten almacenar información más flexible y sin esquema fijo, muy útiles cuando los datos llegan en formatos variados o a gran velocidad.
Saber cuándo usar cada tipo es una de las decisiones arquitectónicas más frecuentes en este rol. No se trata de elegir una sobre la otra, sino de entender qué necesita el proyecto. Con el tiempo, también aprenderás a trabajar con almacenes de datos como Snowflake o BigQuery, que combinan lo mejor de ambos mundos a escala masiva. Puedes profundizar en qué implica esto al entender qué abarca la ingeniería de datos como disciplina completa.
Herramientas de orquestación y procesamiento
Una vez que sabes mover y transformar datos, el siguiente paso es automatizar ese proceso para que ocurra solo, en el momento correcto y sin fallos. Apache Airflow es hoy el estándar para orquestar flujos de trabajo de datos: permite programar tareas, gestionar dependencias entre ellas y detectar errores de forma automática. Para el procesamiento a gran escala, Apache Spark —y en particular PySpark— se convierte en la herramienta principal.
dbt (data build tool) es otra herramienta que ha ganado un peso enorme en los últimos años. Su función principal es transformar datos dentro del almacén usando SQL versionado y probado, lo que convierte el modelado de datos en un proceso más ordenado, reproducible y fácil de mantener entre varios colaboradores. Hoy se considera una pieza clave del stack moderno de ingeniería de datos.
Roadmap paso a paso para convertirte en ingeniero de datos
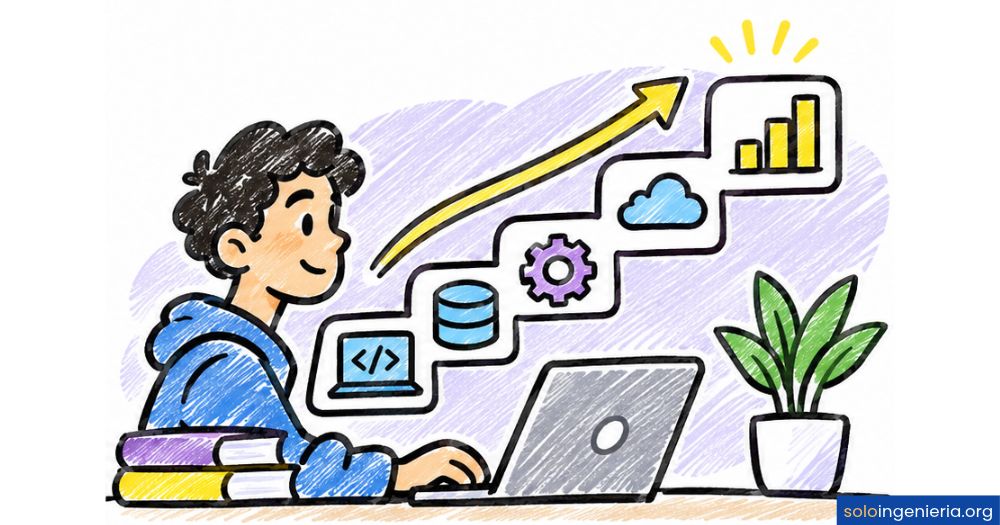
No existe una única ruta para llegar a este rol, pero sí hay un orden lógico que permite avanzar sin perderse. El camino más efectivo empieza por los fundamentos, construye sobre ellos con herramientas reales y termina con proyectos propios que demuestren lo aprendido. Cada fase prepara el terreno para la siguiente, por lo que saltarse pasos suele crear vacíos que se notan más tarde.
Fundamentos — Meses 1 a 3
Aprende SQL hasta el nivel de window functions y CTEs. Aprende Python hasta poder leer archivos, llamar a APIs y manipular datos con pandas. Estos dos lenguajes son la base de todo lo que viene después.
Herramientas de datos — Meses 3 a 6
Aprende a construir pipelines ETL básicos, usa Apache Airflow para automatizar tareas y empieza con dbt para transformar datos. Instala PostgreSQL localmente y practica con conjuntos de datos públicos reales.
Nube y big data — Meses 6 a 9
Elige una plataforma cloud (AWS, GCP o Azure) y aprende sus servicios de datos. Empieza con Spark y PySpark para procesar volúmenes grandes. Conoce los conceptos de streaming con Kafka o similares.
Proyectos y portafolio — Mes 9 en adelante
Construye al menos dos proyectos end-to-end: uno que extraiga datos de una API pública, los transforme y los almacene; otro que automatice ese flujo con Airflow. Publica el código en GitHub con documentación clara.
Fase 1 — Fundamentos de programación y SQL
El primer objetivo es salir de esta fase siendo capaz de escribir consultas SQL complejas y de manipular archivos de datos con Python. No necesitas dominar la estadística ni el machine learning en este punto; lo que importa es que puedas leer un fichero CSV, hacer una consulta con JOIN y escribir un script limpio que otro programador pueda entender. Plataformas como Mode, DataLemur o SQLZoo ofrecen ejercicios prácticos y gratuitos para SQL.
Fase 2 — Herramientas de datos y pipelines
En esta fase construyes tu primer pipeline de datos de principio a fin: extraes datos de alguna fuente, los limpias con Python o SQL, los transformas con dbt y los almacenas en una base de datos. El objetivo no es que el pipeline sea perfecto, sino que funcione de forma automatizada y reproducible. Este proceso, conocido como ETL (Extract, Transform, Load), es el núcleo del trabajo diario de cualquier ingeniero de datos junior.
Fase 3 — Nube y big data
Hoy, casi toda la infraestructura de datos vive en la nube. Elegir entre AWS, Google Cloud o Azure al principio es menos importante que aprender los conceptos: almacenamiento de objetos, servicios de bases de datos administrados, permisos y costes. Una vez que entiendes cómo funciona una plataforma, migrar a otra es mucho más sencillo. Para el procesamiento a escala, Spark se convierte en tu herramienta principal, especialmente a través de su interfaz en Python.
Fase 4 — Proyectos reales y portafolio
Un portafolio con proyectos reales tiene más peso que cualquier certificado cuando buscas tu primer empleo. El proyecto ideal conecta una fuente de datos pública, transforma esa información con alguna lógica real y la presenta en un formato útil. Puede ser un pipeline que consuma datos meteorológicos de una API y los almacene en BigQuery, o uno que procese transacciones ficticias y detecte patrones. Lo que importa es que el código esté en GitHub, documentado y funcionando. Para entender mejor el perfil completo de este profesional, vale la pena conocer en detalle qué hace un ingeniero de datos en su trabajo cotidiano.
¿Cuánto tiempo se tarda en ser ingeniero de datos desde cero?
La respuesta depende en gran medida del tiempo que puedas dedicar cada semana y de tu punto de partida. Alguien sin experiencia previa en programación puede alcanzar un nivel junior en entre nueve y doce meses estudiando con constancia y construyendo proyectos reales. Si ya manejas Python o SQL de forma básica, ese tiempo puede reducirse a seis o siete meses. No es un camino corto, pero tampoco requiere años de formación antes de poder postularte a un empleo.
⏱️ Tiempo estimado según perfil de partida
Sin experiencia previa
9 a 12 meses dedicando al menos 10–15 horas semanales.
Con Python o SQL básico
6 a 8 meses centrándose en herramientas y proyectos de datos.
Con experiencia en programación
3 a 5 meses reorientando habilidades hacia el ecosistema de datos.
Lo que más acelera el proceso no es la cantidad de cursos que completas, sino la consistencia con la que construyes cosas. Una hora diaria de práctica real supera a ocho horas de vídeos un fin de semana. El cerebro asimila mejor cuando hay repetición espaciada y cuando los conceptos se aplican a problemas concretos, no abstractos.
Formación y recursos para aprender ingeniería de datos
Hoy existen más opciones de formación que nunca, lo que puede resultar abrumador al principio. La clave no es encontrar el recurso perfecto, sino elegir uno, terminarlo y construir algo con lo aprendido. Tanto las rutas universitarias como las no universitarias pueden llevarte al mismo destino; la diferencia está en el tiempo, el coste y la estructura de cada una.
Rutas universitarias y no universitarias
Una carrera en Informática, Matemáticas o Estadística ofrece una base conceptual sólida, especialmente en álgebra, sistemas operativos y arquitectura de computadores. Sin embargo, muchos ingenieros de datos llegan al rol a través de bootcamps intensivos, formación profesional o aprendizaje autodirigido. Lo que importa al final no es el papel, sino lo que eres capaz de construir y demostrar en una entrevista técnica o con tu portafolio en GitHub.
Plataformas como Coursera o DataCamp ofrecen rutas estructuradas específicas para ingeniería de datos, con proyectos prácticos incluidos. Los bootcamps especializados, con duraciones de entre tres y seis meses, son una opción válida para quienes buscan un camino más guiado y con mentores activos. La formación profesional en ciclos de informática también puede ser un trampolín útil si partes desde cero total.
Certificaciones reconocidas en el mercado
Las certificaciones no son obligatorias, pero sí ayudan en momentos concretos: cuando no tienes experiencia laboral y necesitas demostrar que sabes lo que dices saber, o cuando quieres dar un salto de nivel dentro de una empresa. Las más reconocidas son las de los grandes proveedores de nube: AWS Certified Data Engineer, Google Professional Data Engineer y Microsoft Azure Data Engineer Associate. Cada una se centra en el ecosistema de su propia plataforma, por lo que conviene elegir la que coincida con las herramientas que ya estés aprendiendo.
¿Cuánto gana un ingeniero de datos?
La ingeniería de datos es uno de los roles tecnológicos mejor remunerados del mercado. Los salarios varían según el país, la empresa y el nivel de experiencia, pero en términos generales se sitúan muy por encima de la media del sector tecnológico. En mercados como España o Latinoamérica, las cifras son más modestas que en Estados Unidos, aunque la demanda de perfiles sigue siendo alta y en crecimiento.
| Nivel de experiencia | EE. UU. (salario anual base) | España (aproximado) |
|---|---|---|
| Junior (0–2 años) | 80.000 – 130.000 USD | 28.000 – 40.000 € |
| Mid-level (3–5 años) | 130.000 – 180.000 USD | 40.000 – 60.000 € |
| Senior (5+ años) | 170.000 – 240.000 USD | 60.000 – 85.000 € |
Los rangos en Estados Unidos provienen de fuentes como Glassdoor y ZipRecruiter para 2026. El trabajo remoto ha abierto la posibilidad de que profesionales en Latinoamérica y España accedan a salarios del mercado norteamericano trabajando para empresas extranjeras, lo que convierte a este rol en especialmente atractivo desde el punto de vista económico.
Errores frecuentes al comenzar en ingeniería de datos
Conocer los errores más comunes antes de cometerlos te ahorra meses de frustración. El más frecuente es intentar aprenderlo todo a la vez: SQL, Python, Spark, Kafka, dbt y cloud al mismo tiempo. El resultado es conocimiento superficial en todo sin profundidad en nada. La especialización progresiva, en cambio, construye una base sólida que luego se puede ampliar sin esfuerzo.
⚠️ Errores que frenan tu progreso (y cómo evitarlos)
Aprender herramientas sin entender los conceptos
Saber ejecutar un comando de Airflow sin entender qué es un DAG o por qué se usa limita tu crecimiento. Los conceptos son los que permanecen; las herramientas cambian.
Acumular cursos sin construir proyectos
Ver horas de vídeo genera una falsa sensación de progreso. Lo que un reclutador quiere ver es código funcionando en GitHub, no certificados en el perfil de LinkedIn.
Ignorar SQL en favor de herramientas más vistosas
Spark o Kafka parecen más impresionantes, pero SQL sigue siendo la herramienta con la que se resuelve la mayoría de los problemas reales del día a día en cualquier empresa.
Esperar a «estar listo» para postularse a empleo
Muchos candidatos posponen indefinidamente la búsqueda de trabajo porque sienten que les falta algo. Postularse con un portafolio sólido, aunque incompleto, siempre enseña más que seguir estudiando solo.
Otro error habitual es subestimar las habilidades blandas. Comunicar de forma clara qué hace un pipeline, por qué se diseñó de cierta manera y qué impacto tiene en el negocio es tan valioso como el código en sí. Los ingenieros de datos trabajan junto a analistas, científicos de datos y responsables de negocio, y la capacidad de explicar decisiones técnicas en términos comprensibles marca la diferencia entre un buen técnico y alguien que puede crecer dentro de una organización.
Preguntas frecuentes
¿Se puede ser ingeniero de datos sin saber programar?
Técnicamente es posible iniciarse en el campo con herramientas de bajo código, pero en la práctica la programación es una habilidad que necesitarás tarde o temprano. SQL es el punto de entrada más accesible y no requiere experiencia previa en desarrollo. A partir de ahí, Python se convierte en la extensión natural. No necesitas haber estudiado informática, pero sí necesitas estar dispuesto a aprender a escribir código desde cero, algo que con práctica constante cualquier persona puede lograr en pocos meses.
¿Qué lenguaje de programación debo aprender primero?
La respuesta más honesta es SQL, porque es el lenguaje que usarás en prácticamente todos los entornos de datos, independientemente de las demás herramientas que uses. Después de SQL, Python es el segundo lenguaje prioritario. No necesitas aprender Python a nivel avanzado desde el principio; con dominar la lectura de archivos, el uso de pandas y la escritura de scripts simples tienes más que suficiente para empezar a construir proyectos reales y seguir avanzando de forma progresiva.
¿Es necesaria una carrera universitaria para trabajar como ingeniero de datos?
No es un requisito en la mayoría de las empresas, aunque algunas grandes corporaciones sí lo solicitan formalmente. Lo que realmente evalúan los reclutadores técnicos es tu capacidad para resolver problemas reales con datos, lo que se demuestra con proyectos en GitHub, habilidad para superar pruebas técnicas y conocimiento sólido de los conceptos fundamentales. Muchos profesionales en activo llegaron al rol a través de bootcamps, formación online autodidacta o ciclos de formación profesional en informática sin pasar por una universidad.
¿Cuánto tiempo lleva aprender a construir un pipeline de datos?
Con SQL y Python básicos, puedes construir tu primer pipeline funcional en cuatro a seis semanas de práctica enfocada. Un pipeline sencillo que extrae datos de una API, los transforma con Python y los carga en una base de datos es un proyecto alcanzable en ese plazo. Lo que tarda más es hacer que ese pipeline sea robusto, tolerante a errores, automático y escalable, habilidades que se desarrollan con la práctica acumulada a lo largo de varios meses de trabajo real.
¿Qué diferencia hay entre un ingeniero de datos y un científico de datos?
El ingeniero de datos construye la infraestructura que permite que los datos lleguen limpios, organizados y disponibles. El científico de datos usa esa infraestructura para crear modelos estadísticos y predictivos. Sin el trabajo del ingeniero, el científico de datos no tendría datos con los que trabajar. Son roles complementarios, no competidores: en equipos pequeños una misma persona puede asumir ambas funciones, pero en empresas medianas o grandes cada rol es una posición independiente con responsabilidades bien definidas.
¿Qué certificaciones son más valoradas para un ingeniero de datos?
Las certificaciones más reconocidas son las de los tres grandes proveedores de nube: AWS Certified Data Engineer Associate, Google Professional Data Engineer y Microsoft Azure Data Engineer Associate. Más allá de estas, certificaciones orientadas a herramientas concretas como dbt Certified Developer o Databricks Certified Associate Developer for Apache Spark también tienen buena reputación en el mercado. La elección depende de las plataformas que usa la empresa a la que quieres postularte o ya estás aprendiendo.
¿Qué es dbt y por qué lo usan los ingenieros de datos?
dbt (data build tool) es una herramienta que permite transformar datos directamente dentro del almacén de datos usando SQL, con la misma disciplina que se aplica al desarrollo de software: versionado en Git, pruebas automáticas y documentación integrada. Su adopción creció de forma muy rápida porque resuelve un problema real: transformaciones SQL dispersas, sin pruebas y difíciles de mantener. Hoy se considera una pieza central del stack de datos moderno y aparece con frecuencia en las ofertas de empleo para ingenieros de datos de nivel medio y senior.
Conclusión
Convertirte en ingeniero de datos desde cero es un camino que requiere orden, constancia y práctica real. No parte de un talento especial ni de una carrera universitaria específica, sino de aprender los fundamentos correctos en el orden correcto y de construir proyectos que demuestren lo que sabes hacer. SQL, Python y los conceptos de pipelines son la base sobre la que se construye todo lo demás.
A lo largo de este artículo has visto qué hace exactamente este profesional, qué habilidades necesitas, cómo estructurar tu aprendizaje por fases, cuánto tiempo puede llevarte y qué errores conviene evitar desde el principio. Con ese mapa claro, el siguiente paso no es buscar más información, sino empezar: escribe tu primera consulta SQL hoy, construye tu primer script mañana y no pares hasta tener un pipeline funcionando en GitHub.
Si te interesa seguir profundizando en este campo, en este sitio web encontrarás más contenido sobre herramientas, conceptos y recursos de ingeniería de datos que te ayudarán a avanzar con seguridad en cada etapa de tu camino. Cada artículo está pensado para que entiendas de verdad lo que estás aprendiendo, no para que lo memorices y lo olvides al día siguiente.
Sigue aprendiendo:
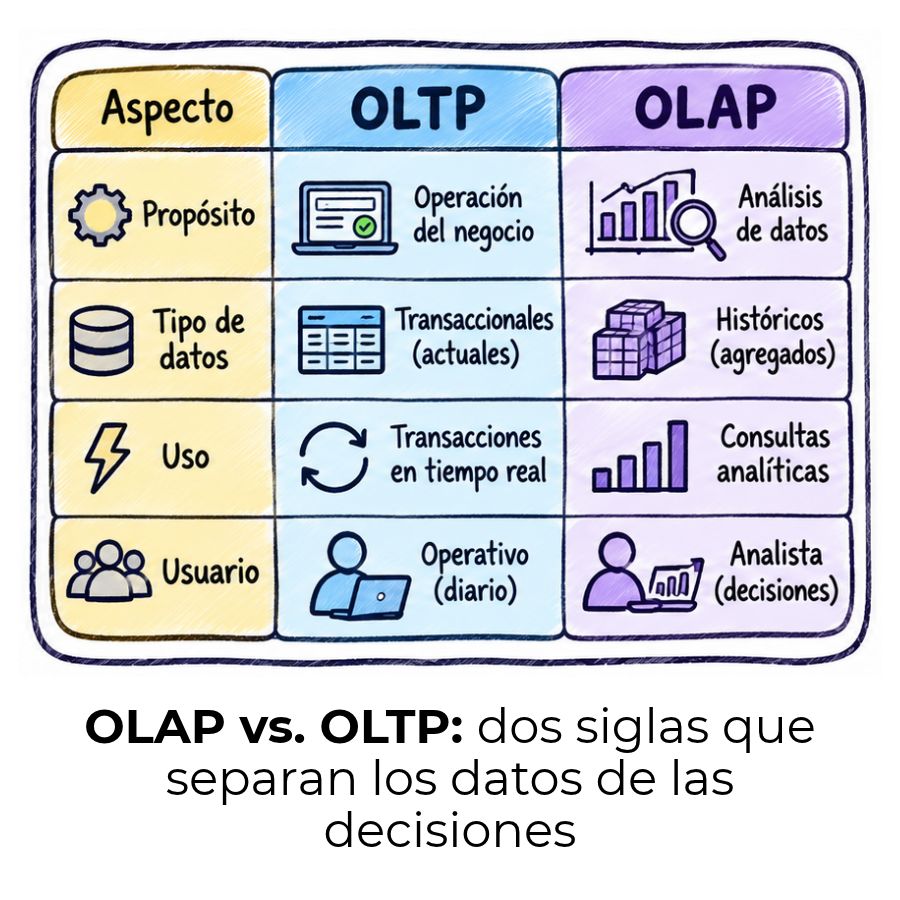
OLAP vs. OLTP: Diferencias clave que debes conocer
DBT: La herramienta que cambió cómo se trabajan los datos
Ingeniería en Análisis / Ciencia de Datos
¿En qué consiste la ingeniería de base de datos?
Gobierno de datos: Controla tu información y toma mejores decisiones 📊
AWS Glue: El secreto detrás de los grandes pipelines de datos
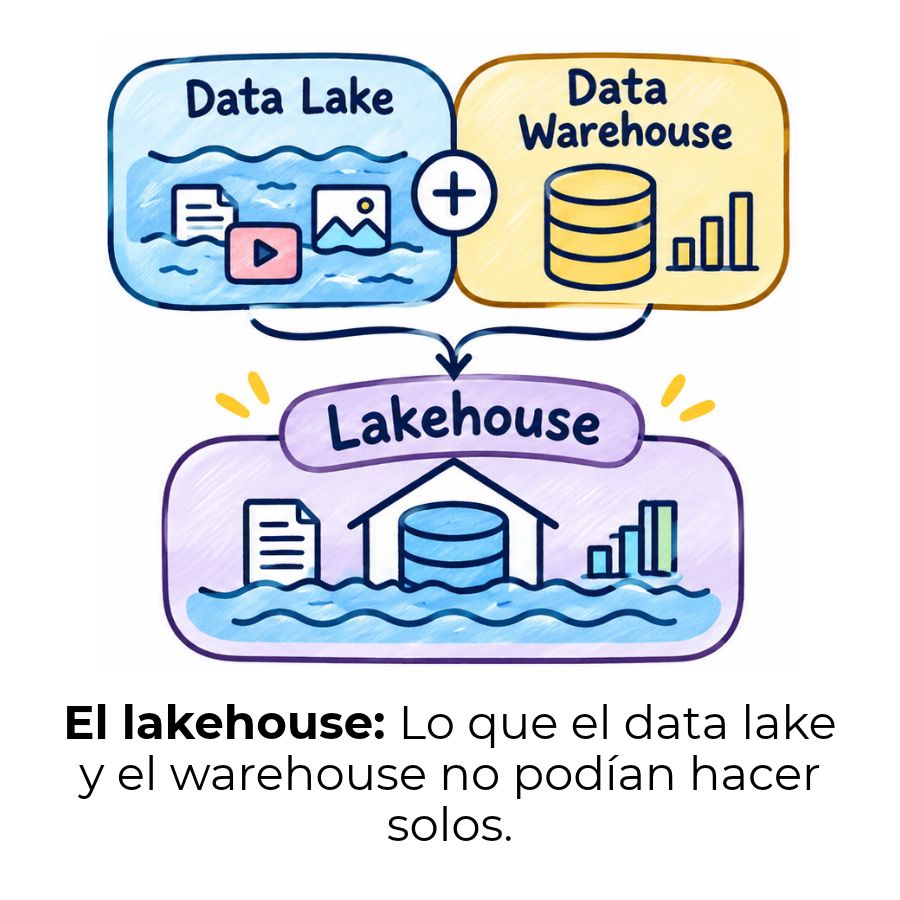
Lakehouse: La arquitectura que unifica todo
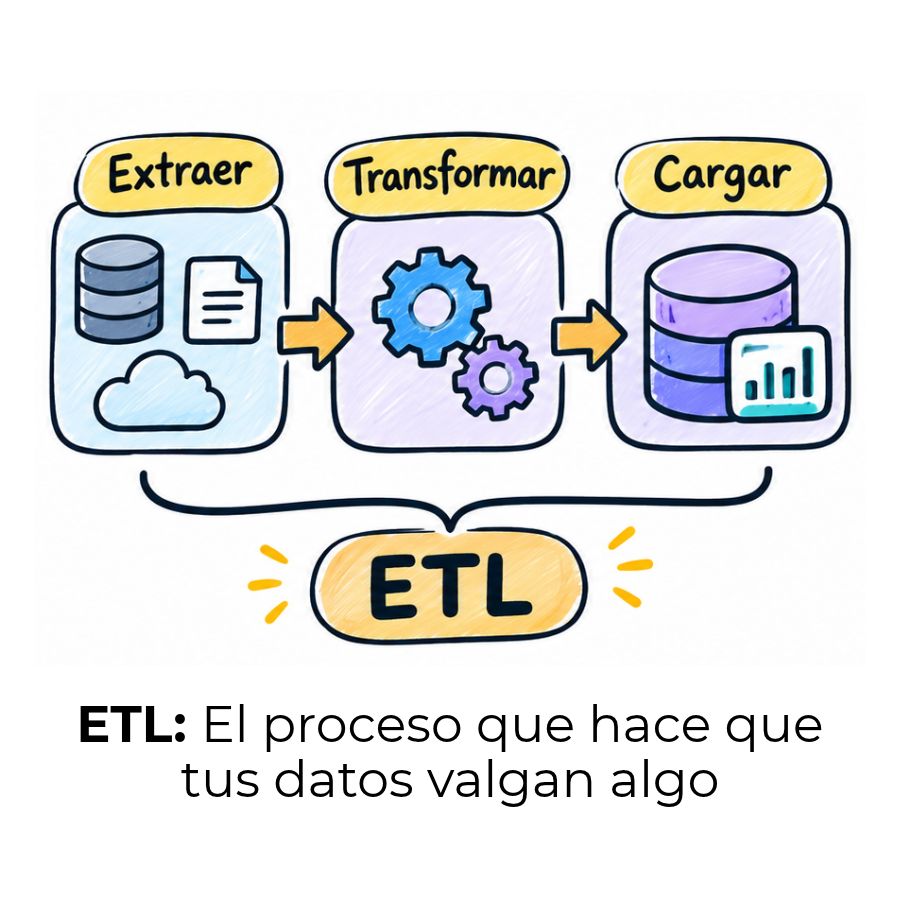
¿Qué es ETL? – Extracción, Transformación y Carga
