
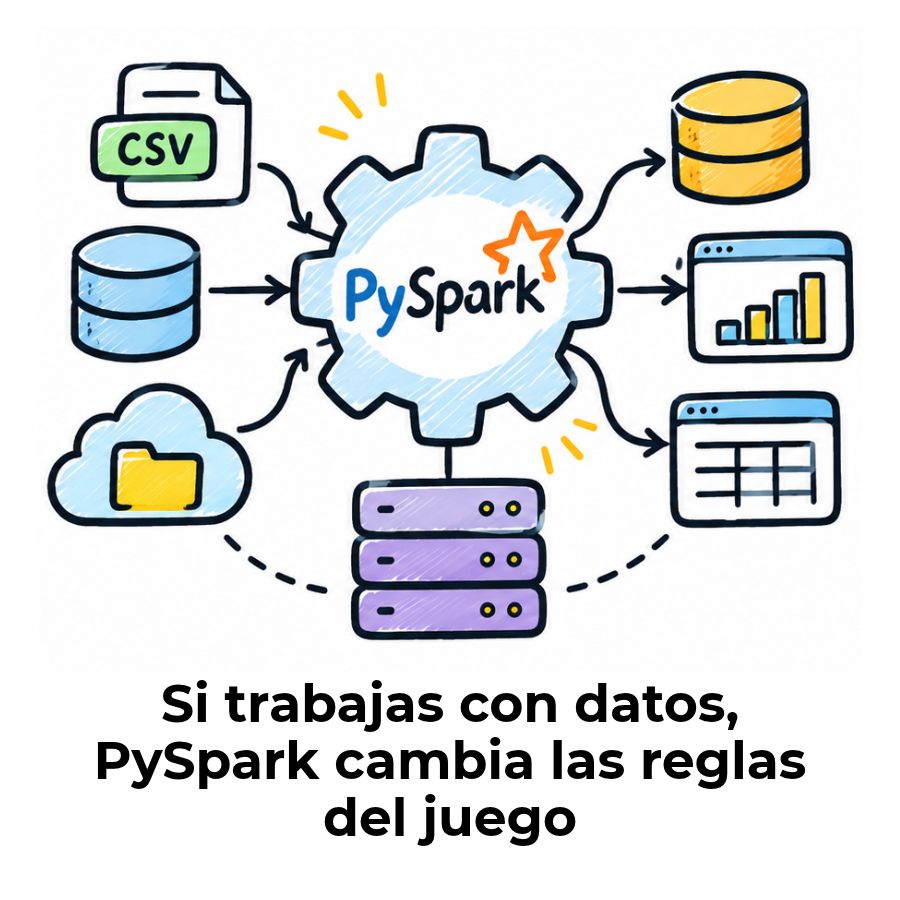
PySpark es la API de Python para Apache Spark, el motor que permite procesar grandes volúmenes de datos distribuyendo el trabajo entre varios equipos de forma paralela. Si trabajas o quieres trabajar con datos a escala, entender qué hace PySpark y en qué contextos tiene sentido usarlo es uno de los conocimientos más valiosos que puedes sumar a tu perfil.
¿Qué es PySpark exactamente?
PySpark es la API oficial de Python para Apache Spark, el motor de procesamiento distribuido de datos más utilizado en la industria. En términos simples, te permite escribir código Python y ejecutarlo sobre un entorno que reparte el trabajo entre varios ordenadores al mismo tiempo, logrando velocidades y capacidades que una sola máquina nunca podría alcanzar.
Apache Spark está escrito originalmente en Scala, un lenguaje que no todos los profesionales de datos dominan. PySpark nació precisamente para eliminar esa barrera: si ya sabes Python, puedes aprovechar toda la potencia de Spark sin necesidad de aprender Scala desde cero. La conexión entre ambos mundos se logra mediante una librería llamada Py4J, que actúa como puente entre Python y la máquina virtual de Java donde corre Spark.
Su relación con Apache Spark
Apache Spark es un motor diseñado para procesar datos a escala de forma rápida y en paralelo. Nació como respuesta a las limitaciones de Hadoop MapReduce, que realizaba sus operaciones escribiendo resultados intermedios en disco. Spark, en cambio, mantiene los datos en memoria durante el procesamiento, lo que lo hace considerablemente más veloz para tareas iterativas como el entrenamiento de modelos de machine learning.
PySpark no es una herramienta separada de Spark: es su interfaz para Python. Cuando escribes código PySpark, en realidad estás enviando instrucciones al motor de Spark, que las ejecuta de forma distribuida. Esto significa que todo el ecosistema de Spark está disponible desde Python: SQL, streaming, machine learning y procesamiento de grafos.
¿Cómo funciona el procesamiento distribuido?
El procesamiento distribuido consiste en dividir una tarea enorme en partes más pequeñas y repartirlas entre varios equipos conectados en red, llamados nodos. Cada nodo trabaja en su porción de datos al mismo tiempo, y al final los resultados se combinan. En lugar de que una sola máquina cargue con todo el trabajo, el clúster lo resuelve en paralelo.
Componentes principales de PySpark
PySpark no es una herramienta monolítica: se organiza en módulos con funciones muy específicas. Cada componente está diseñado para resolver un tipo concreto de tarea dentro del mundo del procesamiento de datos, desde consultas SQL hasta modelos de machine learning o análisis de grafos sociales. Conocerlos te ayuda a entender dónde y cómo aplicar PySpark según el problema que tengas delante.
RDD (Resilient Distributed Datasets)
Los RDD son la estructura de datos fundamental de PySpark. Se trata de colecciones de elementos distribuidos entre los nodos del clúster, que pueden procesarse en paralelo. La palabra «resiliente» hace referencia a su capacidad de recuperarse ante fallos: si un nodo cae durante la ejecución, Spark puede reconstruir la partición perdida usando el historial de transformaciones, sin necesidad de reiniciar todo desde cero.
Hoy en día, los RDD se usan principalmente cuando necesitas un control muy bajo nivel sobre los datos. Para la mayoría de los casos de uso cotidianos, los DataFrames ofrecen una interfaz más cómoda y con mejor rendimiento, ya que Spark puede optimizar automáticamente las operaciones sobre ellos.
DataFrames y Spark SQL
Los DataFrames son la abstracción más utilizada en PySpark. Representan datos organizados en columnas con tipos definidos, de forma parecida a una tabla de base de datos relacional o a un DataFrame de Pandas. La diferencia clave es que un DataFrame de PySpark puede distribuirse entre cientos de nodos y manejar terabytes de datos sin problema.
Spark SQL permite ejecutar consultas sobre estos DataFrames usando sintaxis SQL estándar. Esto hace que profesionales con experiencia en bases de datos puedan trabajar con big data sin aprender una sintaxis completamente nueva. Además, Spark SQL conecta con fuentes de datos como Parquet, JSON, CSV, bases de datos relacionales e incluso Apache Hive.
MLlib: machine learning a escala
MLlib es la biblioteca de machine learning de PySpark. Incluye algoritmos de clasificación, regresión, clustering, reducción de dimensionalidad y filtrado colaborativo, todos diseñados para funcionar de forma distribuida. Puedes entrenar modelos sobre conjuntos de datos que nunca cabrían en la memoria de una sola máquina.
Uno de sus puntos fuertes es la API de pipelines, que permite encadenar etapas de preprocesamiento, transformación y entrenamiento en un flujo coherente y reproducible. Esto facilita enormemente el trabajo en equipos de ciencia de datos que necesitan experimentos repetibles y escalables.
Spark Streaming
Spark Streaming, conocido también como Structured Streaming, permite procesar datos en tiempo real o casi en tiempo real. Los datos llegan de forma continua desde fuentes como Apache Kafka, sockets de red o sistemas de archivos, y PySpark los procesa en microlotes o de forma totalmente continua, dependiendo de la configuración que elijas.
Este componente se usa, por ejemplo, para detectar transacciones fraudulentas en el sector financiero a medida que ocurren, o para actualizar tableros de métricas en tiempo real sin esperar a que termine un proceso por lotes. Es una de las características que hace de PySpark una herramienta válida tanto para análisis histórico como para datos en movimiento.
¿Para qué sirve PySpark en proyectos reales?
Entender para qué sirve PySpark requiere salir de la teoría y observar cómo se aplica en equipos de ingeniería y ciencia de datos reales. PySpark brilla en tres grandes áreas: construcción de pipelines de datos, análisis a gran escala y entrenamiento de modelos de machine learning. En cada una de ellas, el factor común es el volumen: cuando los datos superan lo que una sola máquina puede manejar, PySpark se convierte en la opción más sólida.
Construcción de pipelines de datos (ETL)
ETL son las siglas de Extract, Transform, Load: extraer datos de una fuente, transformarlos y cargarlos en un destino. Es uno de los procesos más habituales en ingeniería de datos, y PySpark es una de las herramientas preferidas para construirlos. Permite leer datos desde múltiples fuentes, aplicar transformaciones complejas en paralelo y escribir el resultado en bases de datos, data lakes o sistemas de análisis.
La ventaja frente a otras soluciones es que PySpark puede manejar tanto ficheros pequeños como archivos de cientos de gigabytes con el mismo código, simplemente ajustando los recursos del clúster. Esto lo convierte en una solución que crece con las necesidades del proyecto sin necesidad de reescribir la lógica desde cero.
Análisis de grandes volúmenes de datos
Cuando necesitas analizar el comportamiento de millones de usuarios, procesar logs de servidores con miles de millones de líneas o cruzar tablas de ventas de una cadena de supermercados global, PySpark ofrece la capacidad de hacerlo de forma interactiva. Puedes ejecutar consultas SQL sobre datos distribuidos y obtener resultados en minutos en lugar de esperar horas como ocurriría con un proceso secuencial.
Esta capacidad de análisis interactivo a escala lo hace especialmente útil en entornos de trabajo como Databricks, donde los equipos de datos pueden colaborar sobre cuadernos compartidos y ejecutar transformaciones sobre los datos directamente en el clúster. Si te interesa entender cómo encajan estas herramientas en el ecosistema más amplio del dato, puedes explorar más sobre la diferencia entre Databricks y Snowflake, dos plataformas que frecuentemente aparecen junto a PySpark en arquitecturas de datos modernas.
Modelos de machine learning distribuido
Entrenar un modelo de machine learning sobre un conjunto de datos de varios terabytes es inviable en una sola máquina con scikit-learn o una librería convencional. MLlib, el módulo de machine learning de PySpark, resuelve este problema distribuyendo tanto los datos como el cómputo entre los nodos del clúster. Los algoritmos se ejecutan en paralelo sobre particiones del dataset, lo que reduce drásticamente el tiempo de entrenamiento.
Además, PySpark se integra bien con librerías externas como TensorFlow o PyTorch cuando necesitas ir más allá de lo que MLlib ofrece. En esos casos, PySpark actúa como capa de preparación y distribución de los datos, mientras la librería de deep learning se ocupa del entrenamiento en sí.
¿Cuándo usar PySpark y cuándo no?
PySpark no es la herramienta correcta para todos los escenarios. Tiene sentido usarla cuando el volumen o la complejidad de los datos supera lo que una sola máquina puede procesar eficientemente. Antes de adoptarla, conviene tener claro qué problema estás tratando de resolver, porque el coste de configuración y mantenimiento de un clúster no siempre está justificado para proyectos pequeños.
Una referencia práctica que se usa frecuentemente: si tus datos ocupan menos de 10 GB y el análisis es exploratorio, Pandas es más rápido de poner en marcha y más sencillo de depurar. El salto a PySpark tiene sentido cuando los datos crecen más allá de lo que la memoria de una sola máquina puede alojar, o cuando necesitas que el proceso escale de forma predecible en producción.
Ventajas y limitaciones de PySpark
Como cualquier tecnología, PySpark tiene puntos fuertes muy claros y también aspectos que conviene conocer antes de comprometerse con ella. Entender ambos lados te ayuda a tomar decisiones más informadas sobre cuándo integrarlo en tu flujo de trabajo y cuándo optar por otras alternativas.
A continuación se detallan las ventajas más relevantes para alguien que se acerca a PySpark por primera vez:
- Escalabilidad horizontal: PySpark puede escalar añadiendo más nodos al clúster sin modificar el código. Esto permite crecer desde unos pocos gigabytes hasta petabytes de datos con la misma lógica.
- Procesamiento en memoria: A diferencia de sistemas más antiguos como Hadoop MapReduce, PySpark mantiene los datos intermedios en memoria siempre que es posible, lo que acelera significativamente las operaciones iterativas.
- Tolerancia a fallos: Si un nodo del clúster falla durante la ejecución, PySpark puede reconstruir automáticamente las particiones afectadas usando el linaje de transformaciones registrado en los RDD.
- Accesible para quien sabe Python: No necesitas dominar Scala para usar Apache Spark. PySpark expone prácticamente toda la funcionalidad de Spark a través de Python, con una curva de entrada mucho más suave.
- Plataforma unificada: Desde un mismo entorno puedes hacer procesamiento por lotes, consultas SQL, streaming en tiempo real, machine learning y análisis de grafos, sin cambiar de herramienta.
- Integración con el ecosistema de datos: PySpark se conecta con Hadoop, Kafka, Hive, Delta Lake, Databricks y la mayoría de los data lakes y almacenes de datos modernos.
Y estas son las limitaciones que deberías tener presentes antes de adoptarlo:
- Coste de configuración inicial: Montar y mantener un clúster, ya sea en local o en la nube, requiere conocimientos de infraestructura que no siempre están disponibles en equipos pequeños.
- Sobrecarga para datos pequeños: PySpark tiene una latencia de arranque y un coste operativo que solo se justifica cuando los datos son grandes. Para tareas con pocos gigabytes, Pandas resulta más ágil.
- Depuración más compleja: Los errores en un entorno distribuido son más difíciles de rastrear que en un script de Python convencional, ya que el problema puede estar en cualquier nodo del clúster.
- Consumo de recursos: PySpark requiere una cantidad considerable de memoria y CPU para funcionar de forma eficiente, lo que puede suponer un coste notable en entornos de nube si no se dimensiona con cuidado.
¿Quién usa PySpark y en qué sectores?
PySpark no es una tecnología de nicho: está presente en algunas de las empresas más grandes del mundo. Walmart, Trivago y Runtastic son ejemplos conocidos de organizaciones que lo tienen integrado en sus arquitecturas de datos. Detrás de cada recomendación de producto, cada análisis de precios en tiempo real o cada app de fitness que registra millones de entrenamientos, hay muy probablemente una capa de procesamiento distribuido como la que ofrece PySpark.
Los perfiles profesionales que más trabajan con PySpark son los ingenieros de datos, los científicos de datos y los ingenieros de machine learning. También lo usan arquitectos de datos cuando diseñan sistemas que deben escalar, y administradores de bases de datos que buscan resolver cuellos de botella en el procesamiento. Si quieres profundizar en cómo se organiza este tipo de trabajo, el artículo sobre ingeniería de datos te da una visión completa del campo y del papel que herramientas como PySpark juegan en él.
En cuanto a sectores, PySpark está presente en finanzas para la detección de fraude, en salud para el procesamiento de registros clínicos, en entretenimiento para motores de recomendación, en manufactura para el análisis de sensores industriales y en e-commerce para la personalización de experiencias. Su presencia crece en cualquier industria donde los datos son voluminosos, continuos o ambas cosas a la vez.
El perfil de ingeniero de datos es uno de los más demandados en el sector tecnológico, y el dominio de herramientas como PySpark figura habitualmente entre los requisitos de las ofertas de trabajo más bien remuneradas. Si te interesa ver cómo PySpark encaja en el diseño de estructuras de datos más complejas, el artículo sobre modelado dimensional te muestra cómo se organiza la información en entornos analíticos donde este tipo de procesamiento resulta clave.
Preguntas frecuentes
¿PySpark es lo mismo que Apache Spark?
No, aunque están íntimamente relacionados. Apache Spark es el motor de procesamiento distribuido, escrito en Scala, que hace todo el trabajo pesado. PySpark es la API que te permite interactuar con ese motor desde Python. Cuando escribes código PySpark, en realidad estás enviando instrucciones al motor de Spark, que las ejecuta de forma distribuida. PySpark no existe sin Spark, pero Spark puede usarse también desde Scala, Java o R.
¿PySpark es mejor que Pandas?
Depende del contexto. Pandas es más rápido y sencillo cuando los datos caben en la memoria de tu máquina, generalmente por debajo de los 10 GB. PySpark es la opción adecuada cuando los datos superan ese límite o cuando necesitas procesar en un clúster, trabajar con streaming o ejecutar pipelines de producción a gran escala. No son herramientas rivales, sino complementarias: muchos ingenieros usan Pandas para exploración local y PySpark para producción a escala.
¿Es difícil aprender PySpark si ya sé Python?
La curva de aprendizaje es notablemente más suave si ya dominas Python. La sintaxis de PySpark para trabajar con DataFrames se parece bastante a la de Pandas, y los conceptos de transformaciones y acciones son intuitivos una vez que entiendes el modelo de ejecución diferida de Spark. El mayor reto inicial no es el código, sino comprender cómo funciona el procesamiento distribuido: el modelo de particiones, el plan de ejecución y la diferencia entre transformaciones y acciones son los conceptos que requieren más atención al principio.
¿PySpark sirve para procesar datos en tiempo real?
Sí. A través del módulo Structured Streaming, PySpark puede consumir datos de fuentes como Apache Kafka, archivos en continua actualización o sockets de red, y procesarlos de forma casi instantánea. Puedes definir transformaciones y agregaciones sobre flujos de datos con la misma API que usas para datos estáticos, lo que simplifica el desarrollo. Es especialmente útil en casos como la detección de fraude financiero, el monitoreo de métricas de aplicaciones o la actualización de tableros en tiempo real.
¿PySpark es una herramienta ETL?
PySpark se usa ampliamente para construir y ejecutar procesos ETL, pero no es una herramienta ETL en el sentido tradicional del término. Es un motor de procesamiento distribuido de propósito general sobre el que puedes construir ETL, entre otras muchas cosas. Su flexibilidad es precisamente lo que lo hace tan popular en este contexto: puedes leer de prácticamente cualquier fuente, aplicar transformaciones complejas en paralelo y escribir el resultado donde necesites, con el mismo código.
¿Qué lenguajes de programación soporta Apache Spark?
Apache Spark ofrece APIs oficiales para cuatro lenguajes: Scala, que es el lenguaje nativo del motor; Java, para entornos empresariales consolidados; Python, a través de PySpark; y R, a través de SparkR. Python es el lenguaje más utilizado en la práctica gracias a la popularidad de Python en el mundo de los datos y a que PySpark cubre prácticamente toda la funcionalidad de Spark de forma accesible.
¿En qué empresas se usa PySpark?
Entre las organizaciones que han hecho pública su adopción de PySpark se encuentran Walmart, Trivago, Runtastic y Sanofi. Más allá de los nombres reconocidos, PySpark está presente en empresas de todos los tamaños que operan con grandes volúmenes de datos: plataformas de streaming, bancos, aseguradoras, cadenas de distribución y compañías farmacéuticas. Cualquier organización que tenga que procesar datos a escala de forma regular es candidata a usarlo, independientemente de su sector.
Conclusión
PySpark es la API de Python para Apache Spark, el motor que permite procesar datos a gran escala repartiendo el trabajo entre varios equipos de forma paralela. Su valor no está en reemplazar herramientas como Pandas, sino en resolver el problema que aparece cuando los datos crecen más allá de lo que una sola máquina puede manejar: volumen masivo, velocidad y necesidad de escalar sin reescribir la lógica desde cero.
A lo largo de este artículo has visto sus cuatro componentes principales, los escenarios donde tiene más sentido usarlo y los perfiles profesionales que lo integran en su día a día. Si te dedicas o quieres dedicarte a la ingeniería o la ciencia de datos, conocer PySpark no es opcional: es parte del vocabulario técnico que el mercado ya da por descontado. Puedes empezar explorando su documentación oficial en Apache Spark Python API y practicar con conjuntos de datos reales para fijar los conceptos.
Si llegaste aquí con curiosidad y te vas con ganas de seguir, estás exactamente en el camino correcto. Este sitio web tiene más contenido sobre ingeniería de datos, arquitecturas de procesamiento y las herramientas que mueven los datos del mundo real: todo explicado para que puedas avanzar a tu propio ritmo.
Sigue aprendiendo:
AWS Glue: El secreto detrás de los grandes pipelines de datos
¿Qué es un data warehouse y para qué sirve?
DBT: La herramienta que cambió cómo se trabajan los datos
OLAP vs. OLTP: Diferencias clave que debes conocer
Ingeniero de datos vs. Científico de datos
Lakehouse: La arquitectura que unifica todo
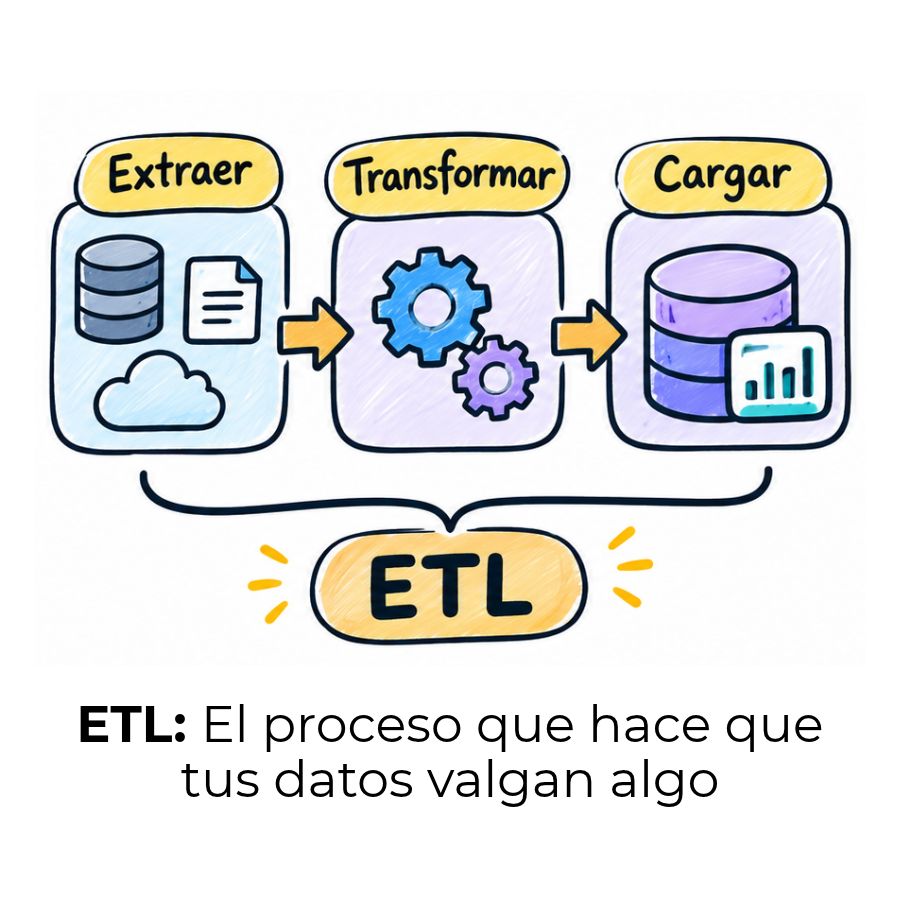
¿Qué es ETL? – Extracción, Transformación y Carga
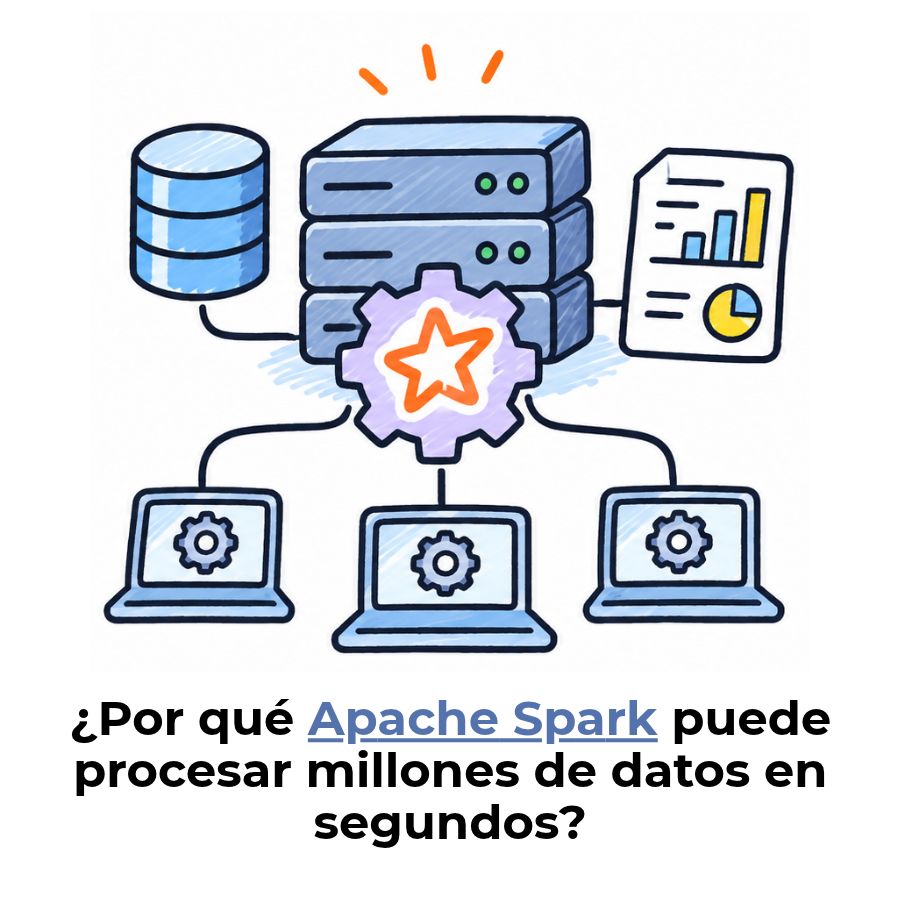
Apache Spark: El motor de datos que no conocías
