
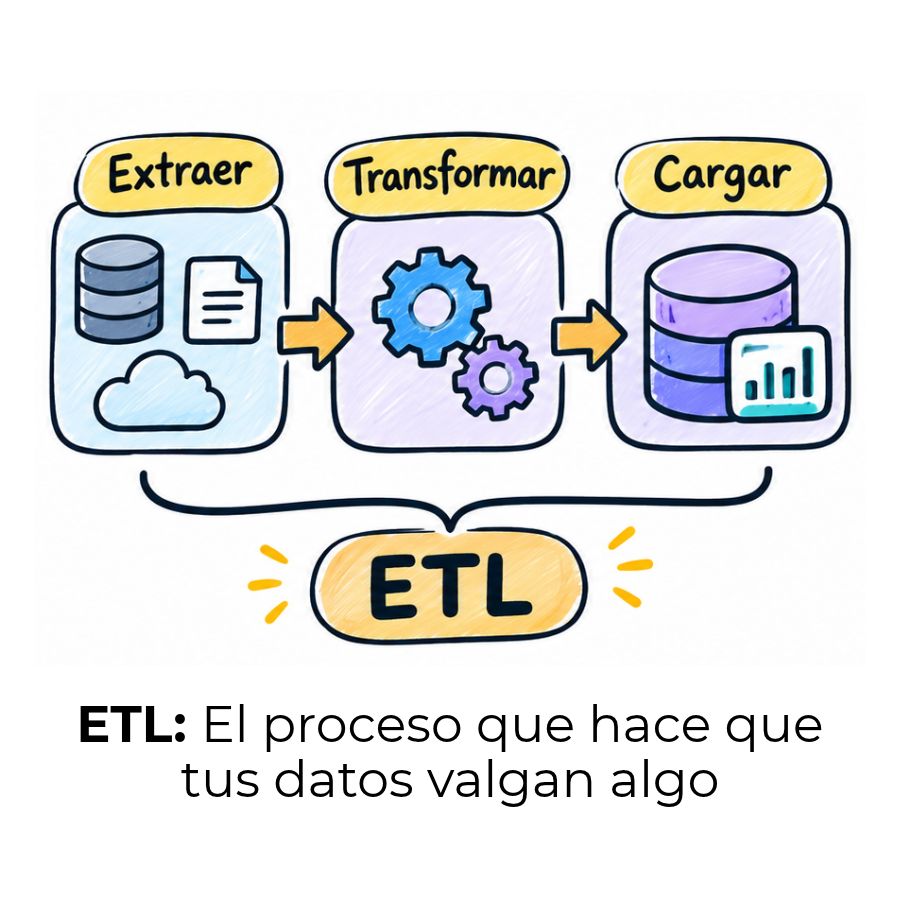
Cada decisión respaldada por datos tiene algo en común: alguien preparó esos datos antes de que llegaras a verlos. Ese trabajo invisible tiene nombre, y se llama ETL. Si alguna vez te has preguntado cómo los datos pasan de estar dispersos en decenas de sistemas a aparecer ordenados en un informe, estás en el lugar correcto.
¿Qué significa ETL y de dónde viene?
ETL son las siglas de Extract, Transform, Load, que en español se traduce como extraer, transformar y cargar. Es el proceso que recoge datos desde sus fuentes de origen, los limpia y les da la estructura que necesitan, y los deposita en un destino central donde ya están listos para el análisis. Aunque el término suena técnico, el concepto detrás es directo: mover datos de un lugar a otro, pero haciéndolo bien.
El proceso ETL no es una herramienta concreta, sino una metodología de trabajo dentro de la ingeniería de datos. Distintas plataformas y lenguajes de programación pueden ejecutarla, pero la lógica de las tres etapas siempre es la misma: primero extraes, luego transformas y, al final, cargas. Ese orden no es arbitrario; responde a una necesidad práctica de garantizar la calidad de los datos antes de que lleguen al análisis.
Las siglas detrás del nombre
Cada letra de ETL representa una acción concreta: la E de Extract es la extracción de datos desde sus fuentes originales; la T de Transform es la fase donde esos datos se limpian, validan y reorganizan; y la L de Load es la carga del resultado en un sistema de almacenamiento centralizado, habitualmente un data warehouse o un data lake. Las tres letras juntas describen el flujo completo que siguen los datos.
Breve historia del proceso ETL
El concepto de ETL surgió en las décadas de 1970 y 1980, cuando las empresas comenzaron a necesitar consolidar datos de sistemas heterogéneos en un único repositorio para facilitar el análisis. Con la aparición de los primeros data warehouses en los años noventa, el proceso ETL se convirtió en el mecanismo estándar de integración de datos. Hoy sigue siendo una pieza central en la arquitectura de datos, aunque ha evolucionado con variantes como ELT y los pipelines de streaming en tiempo real.
Las tres etapas del proceso ETL explicadas paso a paso
El proceso ETL se compone de tres etapas bien diferenciadas que siempre se ejecutan en el mismo orden. Cada fase tiene una función específica, y saltarse o descuidar cualquiera de ellas compromete la calidad del resultado final. Entender qué ocurre en cada paso es la base para comprender por qué ETL es tan valioso en la gestión de datos.
Extracción: el punto de partida de los datos
La extracción es el primer movimiento del proceso. Su objetivo es obtener los datos desde sus fuentes originales sin modificarlos, conservando exactamente lo que hay en cada sistema de origen. Esas fuentes pueden ser bases de datos relacionales, archivos CSV, hojas de cálculo, APIs, aplicaciones empresariales como CRM o ERP, e incluso servicios en la nube. Durante esta fase, el sistema copia los datos y los lleva a un área intermedia llamada zona de preparación o staging area.
Un detalle importante es que la extracción no altera el sistema de origen. Los datos originales permanecen intactos, lo que garantiza que, si algo falla en etapas posteriores, siempre es posible volver a empezar desde el mismo punto. También existe la extracción incremental, que solo recoge los datos que han cambiado desde la última ejecución del proceso, lo que ahorra tiempo y recursos en entornos con grandes volúmenes de información.
Transformación: donde los datos toman sentido
La transformación es la etapa más compleja y, a la vez, la más valiosa del proceso ETL. Aquí los datos en bruto se convierten en información coherente, limpia y lista para ser analizada. Esta fase incluye operaciones como eliminar duplicados, corregir errores, estandarizar formatos, unificar unidades y validar que cada registro cumpla las reglas de calidad definidas para el sistema de destino.
Un ejemplo sencillo: si una base de datos almacena fechas como «15/03/2024» y otra las guarda como «2024-03-15», la transformación se encarga de unificar ese formato antes de que los datos lleguen al destino. Sin esta homogeneización, comparar datos de diferentes fuentes sería imposible. También pueden crearse nuevos campos calculados, como totales de ventas o promedios, que no existen en los datos originales pero que el análisis necesita.
Carga: los datos llegan a su destino
La carga es la fase final del proceso ETL. Consiste en mover los datos ya transformados al sistema de destino, que suele ser un data warehouse, un data lake o una base de datos analítica. Existen dos grandes modalidades de carga: la carga completa, que reemplaza todos los datos del destino con los nuevos, y la carga incremental, que solo añade o actualiza los registros que han cambiado desde la última ejecución.
La elección entre una modalidad u otra depende del volumen de datos y de la frecuencia con la que necesitas actualizar el destino. Una vez completada la carga, los datos están disponibles para los analistas, los sistemas de inteligencia de negocio y cualquier herramienta de visualización que dependa de esa fuente centralizada. Es el momento en que el trabajo previo se traduce en información accionable.
¿Para qué sirve ETL en una empresa?
Las empresas generan datos constantemente desde decenas de sistemas diferentes: el CRM registra interacciones con clientes, el ERP gestiona inventario y finanzas, las plataformas de marketing acumulan métricas de campañas y los sistemas de ventas guardan cada transacción. El problema es que todos esos sistemas hablan idiomas distintos y almacenan los datos en formatos incompatibles entre sí. ETL es el traductor universal que los une.
Usos prácticos de ETL en una empresa
Consolidación de datos
Une información dispersa en un único repositorio analítico.
Calidad de datos
Detecta y corrige errores antes de que lleguen al análisis.
Migración de sistemas
Mueve datos de sistemas heredados a plataformas modernas.
Reportes e inteligencia de negocio
Alimenta paneles de control con datos actualizados y fiables.
Automatización
Ejecuta el proceso de forma programada sin intervención manual.
Cumplimiento normativo
Garantiza trazabilidad y auditoría de los datos procesados.
Gracias al proceso ETL, los analistas y directivos pueden tomar decisiones respaldadas por datos limpios y coherentes, en lugar de trabajar con información desactualizada o contradictoria. No es casualidad que ETL sea uno de los procesos más consolidados en cualquier arquitectura de datos seria: sin él, el análisis simplemente no funciona.
Otro uso relevante es la migración de datos entre sistemas. Cuando una empresa decide reemplazar un software antiguo por uno nuevo, necesita mover años de información al nuevo entorno sin perder ni un registro. ETL gestiona ese proceso con precisión, transformando los datos al formato que el nuevo sistema requiere y verificando que todo llegue correctamente. También te encontrarás con ETL en proyectos de ingeniería en análisis y ciencia de datos, donde es el primer paso para preparar los datos que alimentarán modelos de predicción y análisis avanzado.
ETL vs. ELT: ¿cuál es la diferencia?
ETL y ELT comparten el mismo objetivo: mover y preparar datos para el análisis. La diferencia está en el orden en que ocurre la transformación. En ETL, los datos se transforman antes de llegar al destino. En ELT —Extract, Load, Transform—, los datos se cargan primero en el destino y la transformación ocurre allí, aprovechando la potencia de cómputo del propio almacén.
| Aspecto | ETL | ELT |
|---|---|---|
| Orden del proceso | Extraer → Transformar → Cargar | Extraer → Cargar → Transformar |
| Dónde ocurre la transformación | En un servidor o motor ETL externo | Dentro del sistema de destino |
| Uso habitual | Sistemas tradicionales y on-premise | Plataformas modernas en la nube |
| Escalabilidad | Limitada al servidor ETL | Alta, hereda la del destino |
| Latencia | Mayor (transformación antes de cargar) | Menor (carga inmediata) |
| Privacidad de datos | Los datos pasan por un sistema intermedio | Los datos van directamente al destino |
ETL sigue siendo la opción predominante en entornos con requisitos estrictos de privacidad o cuando el sistema de destino no tiene capacidad de transformación propia. ELT, por su parte, ha ganado terreno con el auge de los almacenes de datos en la nube como Snowflake, BigQuery o Redshift, que pueden procesar transformaciones complejas de forma muy eficiente directamente sobre los datos ya cargados.
Herramientas ETL más usadas en ingeniería de datos
El mercado ofrece una variedad amplia de herramientas para ejecutar procesos ETL, desde soluciones empresariales con interfaz gráfica hasta frameworks de código abierto que se programan directamente. La elección depende del volumen de datos, del presupuesto, del nivel técnico del equipo y de la infraestructura disponible. Conocer las opciones más consolidadas te da una ventaja clara a la hora de decidir con cuál empezar.
Herramientas ETL destacadas
Apache Airflow
Orquestador de pipelines de datos de código abierto, muy popular en ingeniería de datos.
Apache Spark
Motor de procesamiento distribuido ideal para transformar grandes volúmenes de datos.
AWS Glue
Servicio ETL gestionado de Amazon Web Services, sin necesidad de administrar servidores.
Azure Data Factory
Solución de Microsoft para crear flujos ETL en la nube con una interfaz visual intuitiva.
Talend
Plataforma de integración de datos con versión open source y versión empresarial.
dbt (data build tool)
Herramienta enfocada en la capa de transformación, muy usada en entornos ELT modernos.
Informatica PowerCenter
Solución empresarial clásica con capacidades avanzadas de integración y calidad de datos.
Python + Pandas
Combinación muy usada para construir pipelines ETL personalizados con código propio.
Si estás empezando en el campo de la ingeniería de datos, una buena forma de acercarte a ETL en la práctica es con Python y la librería Pandas. Te permite construir un pipeline funcional desde cero, entender cada paso con claridad y, después, escalar a herramientas más especializadas cuando el volumen de datos lo exija. Aprender el concepto antes que la herramienta siempre da mejores resultados a largo plazo.
¿Cómo encaja ETL en un pipeline de datos moderno?
Un pipeline de datos es el flujo completo que sigue la información desde que se genera hasta que llega a manos de quien la analiza. ETL no es el pipeline completo, sino una de sus piezas más importantes: la que se encarga de que los datos lleguen al destino en condiciones óptimas. Entender dónde encaja ETL dentro del pipeline ayuda a ver el panorama completo de la arquitectura de datos.
En un pipeline moderno, los datos fluyen de izquierda a derecha: parten de las fuentes, pasan por el proceso ETL, llegan al almacén centralizado y desde allí alimentan las herramientas de análisis, los paneles de control y los modelos de machine learning. ETL es el puente que conecta el origen con el análisis, y su calidad determina directamente la fiabilidad de todo lo que viene después.
Los pipelines modernos también incorporan conceptos como el streaming de datos, que permite procesar información en tiempo real en lugar de hacerlo por lotes programados. En esos escenarios, ETL evoluciona hacia arquitecturas más dinámicas, pero la lógica de las tres etapas sigue siendo el fundamento conceptual sobre el que se construyen esos sistemas más avanzados.
«Un pipeline de datos es tan fiable como el proceso ETL que lo alimenta; la calidad de los datos en el destino depende directamente de lo que se hizo en la transformación.»
Preguntas frecuentes
¿Qué es ETL en términos simples?
ETL es un proceso de tres pasos que mueve datos desde donde se generan hasta donde se analizan. Primero los extrae de sus fuentes originales, luego los limpia y les da la estructura adecuada, y finalmente los carga en un sistema centralizado. El resultado son datos ordenados, coherentes y listos para ser usados en análisis, reportes o modelos de predicción, independientemente de cuántos sistemas distintos los hayan generado originalmente.
¿Cuáles son las tres fases del proceso ETL?
Las tres fases son extracción, transformación y carga. La extracción recoge datos de múltiples fuentes sin modificarlas. La transformación limpia, valida y estructura esos datos según las reglas del sistema de destino. La carga deposita los datos ya preparados en el almacén final, ya sea un data warehouse, un data lake u otra base de datos analítica, donde quedan disponibles para su análisis inmediato.
¿Para qué sirve un proceso ETL en una empresa?
En una empresa, ETL permite consolidar en un único lugar los datos dispersos en múltiples sistemas, garantizar su calidad antes de analizarlos, automatizar la actualización de los informes y facilitar la migración de información entre plataformas. Sin ETL, comparar datos de diferentes departamentos o sistemas sería prácticamente inviable, porque cada fuente usa formatos y estructuras distintas que no son directamente compatibles entre sí.
¿Qué diferencia hay entre ETL y ELT?
La diferencia principal está en cuándo ocurre la transformación. En ETL, los datos se transforman antes de llegar al destino, en un servidor o motor externo. En ELT, los datos se cargan primero en el sistema de destino y la transformación ocurre allí. ELT es más habitual en entornos de nube modernos, donde el almacén de datos tiene suficiente capacidad de cómputo para realizar transformaciones complejas directamente sobre los datos ya cargados.
¿Qué herramientas ETL existen y cuáles son las más populares?
El abanico de herramientas ETL es amplio. Entre las más usadas en la práctica están Apache Airflow, Apache Spark, AWS Glue, Azure Data Factory, Talend, dbt e Informatica PowerCenter. Para quienes empiezan, Python con la librería Pandas es una combinación accesible y muy potente para construir pipelines ETL personalizados desde cero, ya que permite entender cada paso del proceso antes de migrar a herramientas más especializadas.
¿Qué es un data warehouse y cómo se relaciona con ETL?
Un data warehouse es un repositorio centralizado donde se almacenan datos estructurados provenientes de múltiples fuentes, optimizado para consultas analíticas. ETL y data warehouse están estrechamente relacionados porque ETL es el mecanismo que alimenta el data warehouse: extrae datos de los sistemas operacionales, los transforma para que sean coherentes entre sí y los carga en el warehouse, donde los analistas pueden consultarlos de forma unificada y eficiente.
¿ETL y pipeline de datos son lo mismo?
No son exactamente lo mismo, aunque están muy relacionados. Un pipeline de datos es el flujo completo que recorre la información desde su origen hasta el análisis final, e incluye múltiples componentes como la ingesta, el almacenamiento, la orquestación y la visualización. ETL es una parte de ese pipeline, concretamente la encargada de integrar y preparar los datos. En muchos contextos, ETL es la pieza central del pipeline, pero no abarca todo el recorrido de los datos.
Conclusión
ETL es mucho más que un término técnico: es el proceso que convierte datos dispersos y desordenados en información coherente, lista para respaldar cualquier decisión. Sus tres etapas —extracción, transformación y carga— forman un flujo lógico y necesario que está presente en prácticamente toda arquitectura de datos seria, desde las más simples hasta las más complejas.
Ahora que conoces qué significa cada fase y cómo encaja ETL dentro de un pipeline moderno, tienes una base sólida para seguir profundizando. Puedes comenzar explorando herramientas como Apache Airflow o practicando con Python y Pandas para construir tu primer pipeline funcional. Cada concepto que domines en este campo se conecta con el siguiente y hace que todo tenga más sentido.
Si quieres seguir avanzando en el mundo de los datos, este sitio web tiene contenido pensado para acompañarte en ese camino, desde los fundamentos hasta los temas más avanzados. No tienes que aprenderlo todo de golpe; basta con dar un paso a la vez.
Sigue aprendiendo:
¿Qué es un data warehouse y para qué sirve?
¿Qué hace un ingeniero de datos?
Ingeniero de datos vs. Científico de datos
Apache Airflow: Automatiza y controla tus flujos de datos con Python
Ingeniería en Análisis / Ciencia de Datos
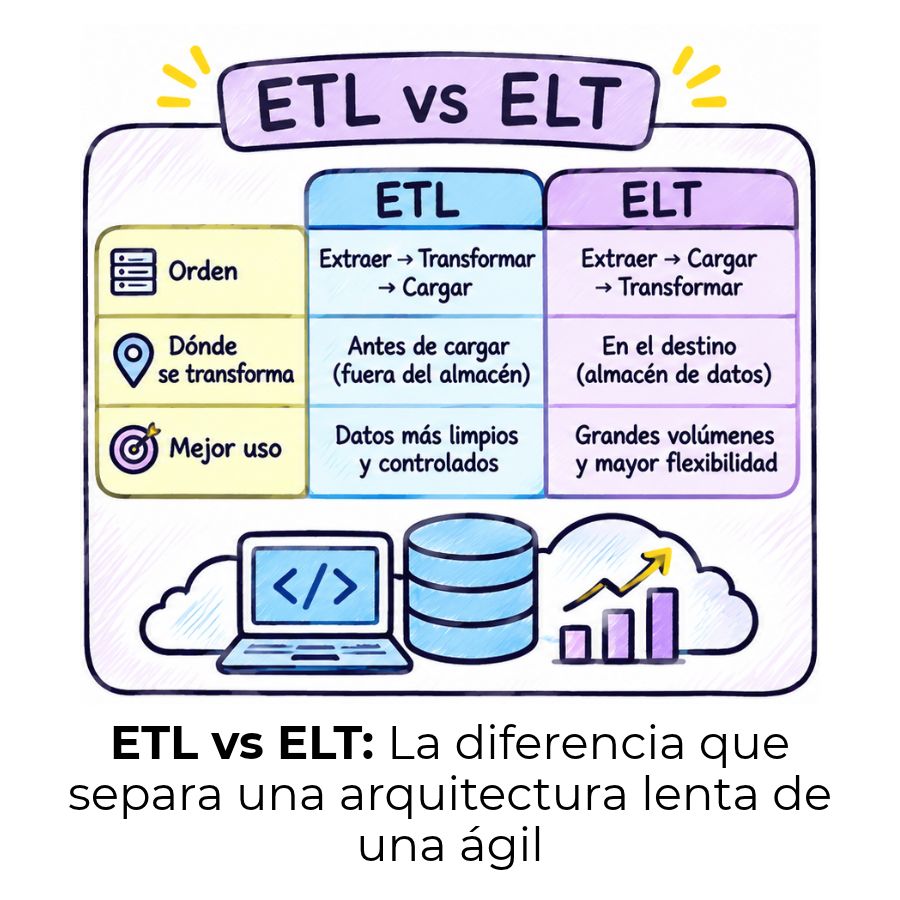
ETL vs. ELT: Transforma tus datos con la estrategia correcta
Cómo ser ingeniero de datos desde cero
Catálogo de datos: El mapa que nadie te enseñó a leer
