
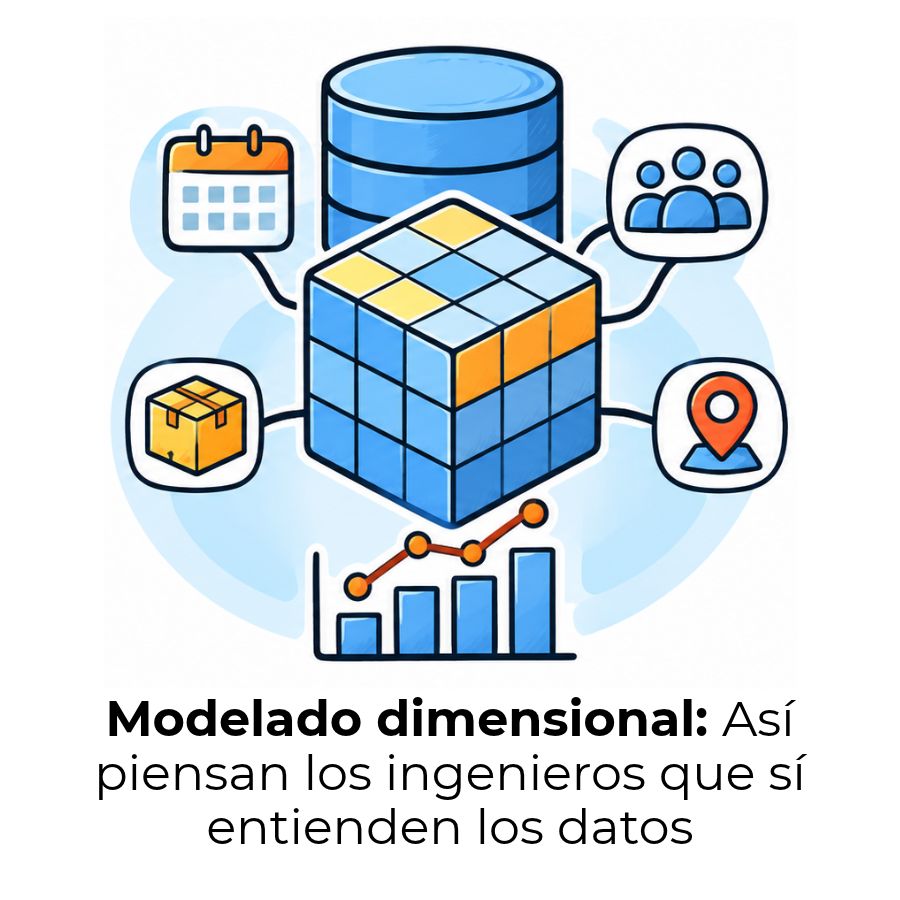
Tienes una base de datos llena de registros, pero cuando alguien pregunta cuánto se vendió el mes pasado por región, nadie puede responder rápido. Ese es exactamente el problema que el modelado dimensional resuelve: organizar los datos para que las preguntas del negocio tengan respuestas claras, rápidas y confiables.
¿Qué es el modelado dimensional?
El modelado dimensional es una técnica de diseño de bases de datos concebida específicamente para almacenes de datos, conocidos como data warehouses. Su objetivo central es organizar la información de forma que las consultas analíticas sean rápidas, intuitivas y fáciles de interpretar, tanto para ingenieros de datos como para analistas de negocio sin perfil técnico profundo.
A diferencia de los modelos diseñados para operaciones del día a día —como registrar una venta o actualizar un inventario—, el modelado dimensional se orienta completamente al análisis. Responde preguntas del tipo: ¿cuánto se vendió?, ¿en qué período?, ¿en qué región? y ¿qué producto lideró las ventas?, con un rendimiento que los modelos tradicionales no pueden igualar cuando el volumen de datos crece.
Origen y concepto según Ralph Kimball
El concepto fue desarrollado y popularizado por Ralph Kimball, uno de los referentes más influyentes en el diseño de almacenes de datos. Kimball planteó que la clave para hacer útil un data warehouse no estaba en normalizar al máximo las tablas, sino en organizarlas de una forma que el negocio pudiera comprender y consultar con rapidez.
Su propuesta se materializó en el llamado enfoque Kimball, que estructura los datos en dos grandes grupos: los hechos, que son las métricas medibles, y las dimensiones, que son el contexto que da significado a esas métricas. Esta dualidad simple y poderosa sigue siendo la base del modelado dimensional hasta hoy, décadas después de su formulación original.
Diferencia entre modelado dimensional y relacional
El modelo relacional prioriza la integridad y la eficiencia en operaciones de escritura: inserta, actualiza y elimina registros con la menor redundancia posible. El modelado dimensional, en cambio, acepta cierta desnormalización de forma deliberada. Desnormalizar significa que algunos datos se repiten en distintas tablas para evitar uniones complejas y acelerar las consultas de lectura, que son las que dominan en un entorno analítico.
Esta diferencia no convierte a uno en superior al otro: cada modelo responde a una necesidad distinta. Los sistemas transaccionales —como los que registran compras en tiempo real— usan el modelo relacional. Los sistemas de análisis e inteligencia de negocio usan el dimensional. Conocer cuándo aplicar cada uno es una habilidad fundamental en la ingeniería de datos.
Componentes principales de un modelo dimensional
Todo modelo dimensional se construye sobre tres elementos que trabajan juntos: las tablas de hechos, las tablas de dimensiones y el concepto de grano. Entender qué hace cada uno y cómo se relacionan entre sí es el punto de partida para diseñar modelos que realmente funcionen en un entorno de análisis de datos.
Tablas de hechos: dónde viven las métricas
La tabla de hechos es la pieza central del modelo. Almacena las métricas cuantitativas del negocio, es decir, los números que se quieren analizar: ventas, ingresos, unidades despachadas, visitas a un sitio web, tiempo de respuesta de un servicio. Cada fila representa un evento o transacción medible que ocurrió en un momento y contexto específico.
Además de las métricas, la tabla de hechos contiene claves foráneas que la conectan con cada una de las tablas de dimensiones. Son esas claves las que permiten filtrar y segmentar los datos cuando se ejecuta una consulta. Sin ellas, los números existirían, pero no habría manera de saber a qué cliente, producto, fecha o región corresponden.
Tablas de dimensiones: el contexto de los datos
Si la tabla de hechos responde «cuánto», las tablas de dimensiones responden «quién», «cuándo», «dónde» y «qué». Una dimensión de tiempo, por ejemplo, puede contener el día, el mes, el trimestre y el año de cada registro, lo que permite analizar tendencias y comparar períodos sin necesidad de transformar los datos en el momento de la consulta.
Las tablas de dimensiones suelen ser más anchas que profundas: tienen muchas columnas descriptivas y relativamente pocas filas comparadas con la tabla de hechos. Este diseño desnormalizado es intencional, porque facilita que los analistas de negocio exploren los datos con herramientas de visualización sin tener que ejecutar uniones complejas de múltiples tablas.
El grano: la unidad mínima de medida
El grano define con precisión qué representa cada fila dentro de la tabla de hechos. Puede ser, por ejemplo, «una transacción de venta por producto», «una sesión de usuario por día» o «una llamada al servicio de soporte». Definir el grano correcto es la decisión más crítica en todo el proceso de diseño, porque de ella dependen las dimensiones que se pueden incluir y los hechos que tiene sentido registrar.
Un grano mal definido genera problemas difíciles de corregir después: datos que se duplican al cruzar fuentes, métricas que no se pueden comparar o dimensiones que no encajan con la granularidad real de los registros. Por eso, el grano siempre se define primero, antes de seleccionar cualquier hecho o dimensión.
Tipos de esquemas en el modelado dimensional
Una vez que se tienen claros los componentes, el siguiente paso es elegir cómo organizarlos físicamente en la base de datos. Esa organización recibe el nombre de esquema. Existen tres patrones principales, cada uno con sus propias características de rendimiento, complejidad y mantenimiento.
Esquema estrella: simplicidad y velocidad
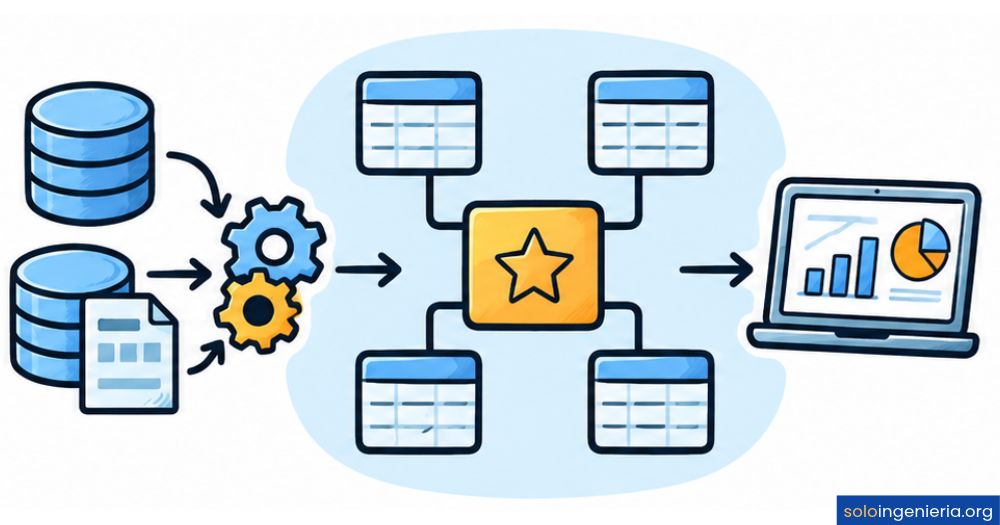
El esquema estrella es el más común y el más recomendado para la mayoría de los casos. Consiste en una tabla de hechos central rodeada directamente por las tablas de dimensiones, sin tablas intermedias. La forma resultante recuerda visualmente a una estrella, de ahí su nombre. Las dimensiones están completamente desnormalizadas, lo que significa que toda la información descriptiva de una dimensión vive en una sola tabla.
El resultado es un modelo muy sencillo de entender y de consultar. Las herramientas de inteligencia de negocio y visualización de datos se integran de forma natural con este esquema, porque el número de uniones necesarias para responder cualquier pregunta es mínimo. La penalización es un mayor consumo de almacenamiento por la repetición de datos, aunque en la práctica ese costo es perfectamente manejable.
Esquema copo de nieve: mayor normalización
El esquema copo de nieve parte del mismo concepto que el estrella, pero normaliza las tablas de dimensiones en sub-dimensiones adicionales. Por ejemplo, en vez de tener toda la información geográfica en una sola tabla de dimensión «ubicación», la separa en tablas de «ciudad», «región» y «país» enlazadas entre sí. El resultado se parece visualmente a un copo de nieve con ramificaciones.
Esta estructura reduce la redundancia de datos y puede ahorrar espacio en almacenamiento. Sin embargo, aumenta la complejidad de las consultas, porque requiere más uniones para recuperar información completa. Se usa principalmente cuando la coherencia y la reducción de redundancia pesan más que la velocidad de consulta.
Esquema constelación: múltiples tablas de hechos
El esquema constelación, también llamado esquema de constelación de hechos, extiende el concepto estrella para incluir varias tablas de hechos que comparten algunas dimensiones entre sí. Es el esquema adecuado cuando el modelo necesita representar varios procesos de negocio distintos que tienen dimensiones en común, como ventas y devoluciones, que comparten las dimensiones de producto, tiempo y cliente.
Su mayor ventaja es la consistencia del análisis: al compartir dimensiones, los reportes de distintos procesos hablan el mismo idioma. La complejidad de diseño y mantenimiento es mayor, por lo que se recomienda únicamente cuando la necesidad real lo justifica y no como punto de partida de un modelo nuevo.
| Esquema | Normalización | Velocidad de consulta | Complejidad | Mejor caso de uso |
|---|---|---|---|---|
| Estrella | Baja (desnormalizado) | Muy alta | Baja | Mayoría de proyectos analíticos |
| Copo de nieve | Media-alta | Media | Media | Cuando el espacio y la coherencia importan |
| Constelación | Variable | Variable | Alta | Múltiples procesos de negocio relacionados |
¿Cómo se diseña un modelo dimensional?
El proceso de diseño de un modelo dimensional sigue una secuencia de cuatro pasos que Kimball formalizó en lo que se conoce como el proceso de modelado de cuatro etapas. Seguir este orden evita los errores más comunes, como elegir hechos antes de tener claro el grano o incluir dimensiones que no corresponden al proceso que se quiere analizar.
Los 4 pasos del diseño dimensional
Identificar el proceso de negocio
Define qué actividad quieres analizar: ventas, logística, atención al cliente, etc.
Definir el grano
Decide qué representa cada fila de la tabla de hechos. Esta decisión condiciona todo lo demás.
Elegir las dimensiones
Selecciona las dimensiones que describen el contexto de cada evento: tiempo, producto, cliente, región.
Identificar los hechos
Define las métricas numéricas que se almacenarán: importes, cantidades, duraciones, conteos.
Identificar el proceso de negocio
El primer paso consiste en seleccionar el proceso que se va a modelar. Un proceso de negocio es una actividad medible y repetible: las ventas de una tienda, las entregas de un operador logístico, las sesiones de usuarios en una plataforma digital. Cada proceso de negocio da lugar a un modelo dimensional independiente, aunque varios modelos pueden compartir dimensiones entre sí.
Elegir bien el proceso desde el inicio evita uno de los errores más frecuentes: intentar construir un modelo que lo cubra todo a la vez. Los mejores modelos son los que resuelven un proceso concreto con precisión, y luego se expanden de forma controlada hacia otros procesos cuando es necesario.
Definir el grano
Una vez identificado el proceso, hay que decidir a qué nivel de detalle se va a registrar la información. ¿Cada fila representa una transacción completa o una línea dentro de una transacción? ¿Un resumen diario o cada evento individual? Cuanto más atómico sea el grano, mayor flexibilidad tendrás para agregar los datos de distintas formas en las consultas, pero también mayor será el volumen de filas en la tabla de hechos.
Elegir las dimensiones
Con el grano definido, el tercer paso consiste en identificar qué dimensiones describen cada evento registrado. Una buena forma de hacerlo es responder a las preguntas: ¿quién participó?, ¿cuándo ocurrió?, ¿dónde fue?, ¿qué producto o servicio estuvo involucrado? Las respuestas a esas preguntas son las dimensiones del modelo.
Cada dimensión que selecciones debe ser coherente con el grano elegido. Si el grano es «una línea de pedido», la dimensión de producto tiene sentido. Si el grano es «un pedido completo», la dimensión de producto a nivel de línea ya no encaja y habría que replantearlo. Esta coherencia es la que garantiza que el modelo produzca análisis correctos.
Identificar los hechos
El último paso es determinar qué métricas se van a almacenar en la tabla de hechos. Los hechos deben ser numéricos y medibles, y deben ser coherentes con el grano definido. Los hechos más útiles son los aditivos, es decir, aquellos que se pueden sumar a lo largo de cualquier dimensión: cantidad de unidades vendidas, importe de la venta, número de pedidos.
También existen hechos semi-aditivos, que solo tienen sentido al sumar a lo largo de algunas dimensiones, y hechos no aditivos, como ratios o porcentajes, que nunca se suman directamente. Identificar el tipo de hecho desde el diseño evita errores de cálculo en los reportes finales y ahorra tiempo de corrección en etapas más avanzadas del proyecto.
Tipos de dimensiones que debes conocer
Dentro del modelado dimensional existen varios tipos de dimensiones que responden a situaciones y necesidades específicas. Conocer cuál aplica en cada caso te permite construir modelos más robustos y evitar problemas cuando los datos cambian con el tiempo.
Dimensiones conformadas
Una dimensión conformada es aquella que se define una sola vez y se reutiliza en múltiples modelos dimensionales dentro de la misma organización. La dimensión de tiempo es el ejemplo clásico: se diseña una vez con todos sus atributos —día, semana, mes, trimestre, año, día festivo, etc.— y luego se enlaza tanto al modelo de ventas como al de logística, marketing o finanzas.
El valor de las dimensiones conformadas está en la consistencia: cuando dos equipos analizan sus datos usando la misma dimensión de tiempo, los reportes son comparables sin necesidad de reconciliar definiciones. Este principio es uno de los pilares del enfoque Kimball para construir almacenes de datos empresariales.
Dimensiones de cambio lento (SCD)
Las dimensiones de cambio lento, conocidas por sus siglas en inglés SCD (Slowly Changing Dimensions), abordan uno de los desafíos más comunes: qué hacer cuando un atributo de una dimensión cambia con el tiempo. Por ejemplo, un cliente cambia de ciudad, o un producto cambia de categoría. Existen tres tipos principales según cómo se gestiona ese cambio.
Tipos de dimensiones de cambio lento (SCD)
SCD Tipo 1
Sobreescribe el valor anterior. No conserva historial. Útil cuando el cambio es una corrección de datos y el historial no importa.
SCD Tipo 2
Agrega una nueva fila con el nuevo valor y conserva la fila anterior. Permite analizar el historial completo de cambios.
SCD Tipo 3
Agrega una columna nueva para guardar el valor anterior. Solo conserva un nivel de historial, no toda la secuencia.
Dimensiones degeneradas y basura
Una dimensión degenerada es aquella que no tiene atributos descriptivos adicionales y por eso vive directamente en la tabla de hechos en lugar de en una tabla separada. El número de pedido o el número de factura son ejemplos típicos: son identificadores únicos que contextualizan el hecho, pero no hay una tabla de «pedidos» con más atributos que valga la pena construir.
Las dimensiones basura agrupan en una sola tabla varios atributos indicadores de baja cardinalidad que no justifican una tabla propia por sí solos, como banderas booleanas, estados o tipos. En lugar de crear cinco tablas de una sola columna, se combinan en una única dimensión, lo que simplifica el esquema sin perder información.
Ventajas y limitaciones del modelado dimensional
El modelado dimensional es una herramienta muy poderosa para el análisis de datos, pero como toda técnica tiene un alcance definido. Conocer sus fortalezas y sus limitaciones te ayuda a decidir cuándo aplicarlo y cuándo combinarlo con otros enfoques.
Ventajas principales:
- Rendimiento en consultas analíticas: Al estar desnormalizado, reduce el número de uniones necesarias y devuelve resultados más rápidamente cuando se trabaja con grandes volúmenes de datos.
- Comprensión para el negocio: La estructura de hechos y dimensiones es intuitiva para personas que no tienen perfil técnico, lo que facilita la colaboración entre ingenieros y analistas de negocio.
- Adaptabilidad a los cambios: Agregar una nueva dimensión o un nuevo atributo a una dimensión existente no rompe las consultas que ya funcionan, lo que hace al modelo extensible con el tiempo.
- Integración con herramientas de BI: La mayoría de las plataformas de visualización de datos y Business Intelligence están diseñadas para trabajar directamente con esquemas estrella, el patrón principal del modelado dimensional.
Limitaciones que debes tener en cuenta:
- No es adecuado para operaciones transaccionales: No está optimizado para escrituras frecuentes ni para sistemas que necesitan alta consistencia en tiempo real, como los sistemas OLTP.
- Redundancia de datos: La desnormalización implica que ciertos datos se repiten, lo que aumenta el espacio de almacenamiento necesario respecto a un modelo relacional normalizado.
- Escalabilidad en modelos muy complejos: Cuando el número de procesos de negocio y dimensiones crece mucho, gestionar la coherencia entre modelos puede volverse una tarea exigente.
- Requiere un diseño cuidadoso desde el inicio: Un grano mal definido o una dimensión mal elegida generan problemas que son costosos de corregir una vez que el modelo está en producción.
¿Dónde se aplica el modelado dimensional en la práctica?
El modelado dimensional no es un concepto teórico reservado para grandes corporaciones. Se aplica en organizaciones de todos los tamaños, en industrias muy diversas, siempre que haya necesidad de transformar datos operacionales en información útil para tomar decisiones.
Casos de uso reales del modelado dimensional
🛒 Comercio minorista
Análisis de ventas por producto, tienda, período y categoría para detectar tendencias y optimizar el inventario.
🏦 Servicios financieros
Seguimiento de transacciones, ingresos por producto financiero, análisis de riesgo y comportamiento de clientes.
🌐 Plataformas digitales
Análisis de sesiones, conversiones, embudos de usuario y rendimiento de campañas en canales de marketing.
🏥 Sector salud
Seguimiento de atenciones médicas, ocupación hospitalaria, tiempos de espera y consumo de recursos por especialidad.
🚚 Logística y cadena de suministro
Control de entregas, tiempos de tránsito, tasas de cumplimiento y análisis de proveedores por región y período.
📡 Telecomunicaciones
Análisis de consumo de red, churn de clientes, desempeño de tarifas y eficiencia operativa por zona geográfica.
En todos estos contextos, el modelado dimensional actúa como el puente entre los datos brutos almacenados en los sistemas operacionales y los reportes, dashboards y análisis que consumen los equipos de toma de decisiones. Comprender sus principios es parte esencial del perfil de un ingeniero de datos, ya que la construcción y el mantenimiento de estos modelos es una de las responsabilidades más habituales en el rol, algo que lo distingue claramente cuando se analiza la diferencia entre ingeniero de datos y científico de datos.
Preguntas frecuentes
¿Qué diferencia hay entre una tabla de hechos y una tabla de dimensiones?
La tabla de hechos almacena las métricas cuantitativas y medibles del negocio, como importes de ventas, cantidades o tiempos de respuesta, junto con las claves foráneas que la conectan con las dimensiones. La tabla de dimensiones, en cambio, contiene los atributos descriptivos que dan contexto a esos números: quién compró, qué se vendió, cuándo ocurrió y dónde. Son complementarias: sin hechos no hay qué medir; sin dimensiones no hay forma de interpretar lo que se mide.
¿Qué es el grano en el modelado dimensional?
El grano define con precisión qué representa cada fila de la tabla de hechos. Es la unidad mínima de información que el modelo registra. Por ejemplo, el grano puede ser «una línea de producto por transacción de venta» o «una sesión de usuario por día». Definir el grano es el paso más crítico del diseño, porque de él dependen todas las decisiones posteriores: qué dimensiones incluir y qué hechos almacenar. Un grano mal definido produce modelos que no responden correctamente las preguntas del negocio.
¿Cuándo conviene usar el esquema estrella y cuándo el copo de nieve?
El esquema estrella es la opción más recomendada en la gran mayoría de los casos porque ofrece el mejor rendimiento en consultas y es el más fácil de entender y mantener. El esquema copo de nieve conviene cuando el ahorro de espacio de almacenamiento es una prioridad y cuando la organización tiene disciplina para gestionar la mayor complejidad de las uniones que implica. Si tienes dudas entre los dos, empieza con el esquema estrella: es más sencillo escalar hacia el copo de nieve que hacer el camino inverso.
¿El modelado dimensional solo funciona con bases de datos relacionales?
No. Aunque el modelado dimensional se implementa con más frecuencia en bases de datos relacionales mediante esquemas estrella o copo de nieve, el concepto es independiente del motor de almacenamiento. El mismo enfoque lógico de hechos y dimensiones se puede aplicar en bases de datos multidimensionales, en entornos de procesamiento en la nube y en arquitecturas modernas como lakehouses. Lo que cambia es la tecnología que lo soporta, no el modelo conceptual en sí.
¿Qué relación tiene el modelado dimensional con un data warehouse?
El modelado dimensional es la técnica de diseño más utilizada para estructurar los datos dentro de un data warehouse. El data warehouse es el sistema que centraliza y almacena los datos de una organización para su análisis; el modelado dimensional es la forma en que se organizan esos datos dentro del sistema. Sin un modelo dimensional bien diseñado, un data warehouse puede almacenar grandes volúmenes de datos, pero las consultas serán lentas, difíciles de escribir y difíciles de interpretar.
¿Qué son las dimensiones de cambio lento (SCD)?
Las dimensiones de cambio lento, o SCD por sus siglas en inglés, son un mecanismo para gestionar los atributos de una dimensión que cambian con el tiempo. Por ejemplo, si un cliente cambia de dirección o un producto cambia de categoría, hay que decidir si se sobreescribe el valor anterior (Tipo 1), si se agrega una nueva fila conservando el historial (Tipo 2) o si se agrega una columna adicional con el valor anterior (Tipo 3). El Tipo 2 es el más utilizado porque preserva el historial completo, lo que permite analizar cómo era el dato en el momento en que ocurrió cada transacción.
¿El modelado dimensional sigue siendo relevante con los data lakes modernos?
Sí, y de forma muy clara. Los data lakes permiten almacenar datos en bruto de cualquier formato y estructura, pero por sí solos no garantizan que esos datos sean fáciles de consultar o analizar. El modelado dimensional sigue siendo la capa que transforma esos datos brutos en información organizada y lista para el análisis. En arquitecturas modernas como el lakehouse, se combinan ambos conceptos: el data lake almacena los datos raw y el modelado dimensional estructura las capas analíticas que consumen los equipos de negocio e inteligencia artificial.
Conclusión
El modelado dimensional es la técnica que convierte un almacén de datos en una herramienta verdaderamente útil para el análisis. Al organizar la información en tablas de hechos y dimensiones, con un grano bien definido y un esquema coherente, logras que las preguntas del negocio tengan respuestas rápidas, claras y confiables, independientemente del volumen de datos que manejes.
Los conceptos que has visto aquí —hechos, dimensiones, grano, esquema estrella, copo de nieve, dimensiones conformadas y SCD— no son elementos aislados: trabajan juntos como un sistema. Puedes aplicarlos empezando por un proceso de negocio concreto, definiendo el grano con precisión y construyendo el modelo desde ahí hacia afuera, ampliándolo a medida que tu comprensión del dominio y las necesidades del negocio evolucionan.
Si este tema te resulta interesante, en este sitio web encontrarás más contenido sobre ingeniería de datos, arquitectura de sistemas analíticos y las habilidades que se necesitan para trabajar con datos de forma profesional. Hay mucho más por explorar y cada concepto que dominas te da una base más sólida para el siguiente.
Sigue aprendiendo:
Diferencia entre Databricks y Snowflake
Herramientas ETL: Elige la correcta y ahorra horas de trabajo
AWS Glue: El secreto detrás de los grandes pipelines de datos
Ingeniería en Análisis / Ciencia de Datos
Gobierno de datos: Controla tu información y toma mejores decisiones 📊
Arquitectura de datos: El secreto que mueve los datos de tu empresa
Cómo ser ingeniero de datos desde cero
Apache Airflow: Automatiza y controla tus flujos de datos con Python
