
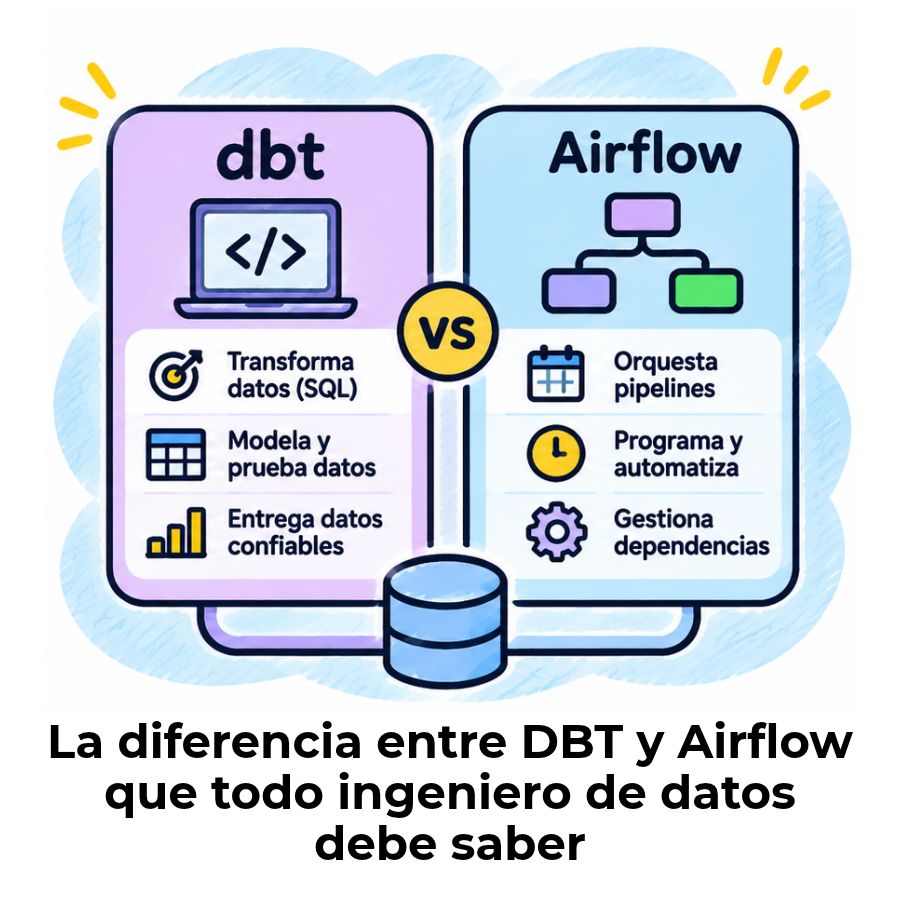
Si alguna vez viste DBT y Airflow mencionados en la misma conversación y no quedó claro cuál hace qué, no estás solo. Son dos de las herramientas más nombradas en ingeniería de datos, pero resuelven problemas completamente distintos. Aquí vas a entender cuál es el rol de cada una y cuándo tiene sentido usarlas juntas.
¿Qué es DBT y para qué sirve en ingeniería de datos?
DBT, cuyas siglas corresponden a data build tool, es una herramienta de transformación de datos que permite a analistas e ingenieros convertir datos crudos en modelos limpios, documentados y probados, todo dentro del propio almacén de datos. Su lenguaje principal es SQL, lo que la hace accesible para perfiles que no trabajan con Python de forma habitual.
Lo que distingue a DBT de otras soluciones es que no mueve datos entre sistemas: trabaja exclusivamente con los datos que ya están dentro del almacén, ya sea Snowflake, BigQuery, Redshift u otro. Su trabajo empieza donde termina la carga de datos y convierte tablas crudas en modelos estructurados listos para consumir.
Además de transformar, DBT permite documentar automáticamente cada modelo y ejecutar pruebas de calidad de datos con simples declaraciones en archivos YAML. Esto significa que puedes verificar si una columna tiene valores únicos o si no hay nulos, sin escribir código adicional.
DBT Core vs. DBT Cloud: ¿cuál es la diferencia?
DBT existe en dos versiones. DBT Core es la versión de código abierto que instalas en tu propia máquina o servidor: necesitas configurar tú mismo cómo y cuándo se ejecuta, ya que no incluye un scheduler propio. Por su parte, DBT Cloud es la versión gestionada en la nube, que añade una interfaz web, un programador de trabajos integrado y un entorno de desarrollo con detección de errores en tiempo real.
La elección entre los dos depende del contexto del equipo. Si trabajas en solitario o en un equipo pequeño con pipelines sencillos, DBT Core junto con un orquestador externo puede ser suficiente. DBT Cloud simplifica la operación para equipos que prefieren no mantener infraestructura adicional.
¿Qué es Apache Airflow y cómo funciona?
Apache Airflow es una plataforma de orquestación de flujos de trabajo de código abierto. Su función principal es decidir cuándo se ejecuta cada paso de un pipeline, en qué orden, qué ocurre si algo falla y cómo se coordinan tareas que involucran sistemas completamente distintos: bases de datos, APIs externas, scripts de Python, trabajos de machine learning o herramientas como DBT.
En Airflow, los flujos de trabajo se definen como código Python. Cada pipeline es un DAG (grafo acíclico dirigido), que es básicamente un conjunto de tareas con un orden de ejecución definido. Airflow se encarga de ejecutarlas en ese orden, reintentar las que fallen y notificar cuando algo no va bien.
A diferencia de DBT, Airflow no transforma datos por sí mismo: llama a otras herramientas o sistemas para que lo hagan. Su poder está en coordinar piezas heterogéneas de una arquitectura de datos, desde la ingesta hasta la activación de dashboards.
¿Qué es un DAG en Airflow?
Un DAG, o grafo acíclico dirigido, es la forma en que Airflow representa un pipeline. Imagínalo como un diagrama de flujo donde cada nodo es una tarea y cada flecha indica que una tarea debe completarse antes de que comience la siguiente. La palabra «acíclico» significa que el flujo nunca puede volver a un paso anterior, lo que garantiza que el pipeline no entre en un bucle infinito.
Diferencia entre DBT y Airflow: transformación vs. orquestación
La confusión más frecuente entre estas dos herramientas surge porque ambas aparecen juntas en las mismas arquitecturas de datos. Sin embargo, operan en capas completamente distintas del pipeline. DBT responde a la pregunta «¿cómo se construyen los datos?», mientras que Airflow responde a «¿cuándo y en qué orden ocurre todo?».
DBT maneja el «qué» a través del modelado, las pruebas y el linaje de datos. Airflow maneja el «cuándo» y el «cómo» a través de la programación, la resolución de dependencias y los reintentos entre sistemas heterogéneos.
Entender esta distinción desde el principio evita errores comunes, como intentar escribir transformaciones SQL complejas dentro de operadores de Airflow o esperar que DBT coordine sistemas externos por sí solo. Cada herramienta existe porque la otra tiene límites claros, y esos límites son precisamente lo que las hace complementarias.
¿Qué hace DBT que Airflow no puede hacer igual de bien?
DBT tiene características especializadas para la transformación de datos dentro del almacén que Airflow no replica de forma nativa. Intentar imitar esas capacidades en Airflow requiere escribir código adicional que mezcla lógica de negocio con lógica de orquestación, lo que complica el mantenimiento.
- Modelado modular con SQL: DBT organiza las transformaciones en modelos reutilizables con dependencias declaradas automáticamente, sin necesidad de escribir Python.
- Pruebas de calidad de datos nativas: Con simples bloques YAML puedes verificar unicidad, integridad referencial y ausencia de nulos en cualquier columna.
- Linaje automático: DBT genera un grafo completo que muestra cómo se relacionan las tablas entre sí, útil para diagnosticar el origen de errores en los datos.
- Documentación siempre actualizada: La documentación se genera directamente desde el código, por lo que nunca queda desincronizada con la realidad del proyecto.
- Procesamiento incremental nativo: DBT permite procesar solo los registros nuevos o modificados, reduciendo el tiempo y el costo de cada ejecución.
¿Qué hace Airflow que DBT no puede hacer?
Airflow opera a un nivel más amplio que DBT. Mientras que DBT vive dentro del almacén de datos, Airflow coordina todo lo que ocurre alrededor de él: la ingesta de datos desde sistemas externos, la ejecución de scripts de Python, el lanzamiento de trabajos de machine learning y la notificación cuando algo falla.
- Orquestación entre sistemas heterogéneos: Airflow puede conectar bases de datos, APIs REST, servicios en la nube y herramientas de terceros dentro de un mismo flujo de trabajo.
- Programación avanzada con cron y eventos: Permite definir con precisión cuándo se ejecuta cada tarea, con soporte para ejecución basada en disponibilidad de datos.
- Reintentos y manejo de fallos configurables: Si una tarea falla, Airflow la reintenta automáticamente y puede enviar alertas por correo o Slack.
- Visibilidad operacional completa: Su interfaz web muestra el estado de cada tarea en tiempo real, el historial de ejecuciones y los logs de errores.
- Escalado horizontal: Airflow puede distribuir el trabajo entre múltiples trabajadores usando ejecutores como Celery o Kubernetes.
¿Cuándo usar DBT, Airflow o ambos juntos?
La respuesta depende del alcance de tu pipeline. Si todo tu trabajo de datos ocurre dentro del almacén —es decir, los datos ya están allí y solo necesitas transformarlos—, DBT con su propio scheduler puede ser suficiente. Muchos equipos pequeños operan con éxito usando únicamente DBT Cloud sin ningún orquestador externo.
El momento en que necesitas Airflow llega cuando tu pipeline cruza los límites del almacén: cuando hay que esperar a que lleguen datos de una fuente externa, coordinar una tarea de Python antes de transformar o lanzar una actualización en un sistema de BI después de que DBT termine. En ese punto, Airflow es el pegamento que une todas las piezas.
¿Cuál te corresponde según tu situación?
Usa solo DBT si…
- Tus datos ya están en el almacén
- Solo necesitas transformar con SQL
- Tu equipo es pequeño y el pipeline es simple
- Usas DBT Cloud con scheduler integrado
Añade Airflow si…
- Necesitas coordinar sistemas externos
- Tu pipeline incluye extracción e ingesta
- Requieres reintentos y alertas robustas
- Tienes tareas en Python, Spark o APIs
Usa los dos cuando…
- Tu pipeline es de extremo a extremo
- Manejas múltiples fuentes de datos
- Necesitas gobernanza y observabilidad
- Tu equipo tiene perfiles mixtos
Un buen criterio práctico: si tu pregunta es «¿qué deben contener mis tablas?», la respuesta está en DBT. Si tu pregunta es «¿cuándo y cómo se ejecuta todo esto?», la respuesta está en Airflow. Cuando ambas preguntas coexisten en el mismo proyecto, la combinación de las dos herramientas es el camino natural.
¿Cómo trabajan DBT y Airflow juntos en un pipeline real?
En un pipeline de producción típico, Airflow actúa como el director que coordina cada acto. Primero, dispara la herramienta de ingesta —puede ser Airbyte, Fivetran u otra— para traer los datos crudos al almacén. Una vez que esa tarea termina con éxito, Airflow lanza DBT para que transforme esos datos en modelos limpios y ejecute las pruebas de calidad.
Cuando DBT completa su trabajo y todas las pruebas pasan, Airflow puede desencadenar las tareas siguientes: actualizar un dashboard en Looker, enviar una notificación al equipo o iniciar un trabajo de machine learning que depende de los datos ya transformados. DBT no sabe nada de lo que ocurre antes ni después de su ejecución: solo recibe la orden de Airflow y hace su trabajo dentro del almacén.
Esta arquitectura permite que cada herramienta haga lo que mejor sabe hacer. Si el trabajo de DBT falla porque una prueba de calidad no pasa, Airflow lo detecta, reintenta si está configurado para ello y notifica al equipo. La responsabilidad queda claramente dividida: Airflow sabe si las tareas se ejecutaron, DBT sabe si los modelos compilaron y los datos pasaron las validaciones.
También existe la posibilidad de integrar ambas herramientas mediante el proveedor oficial de DBT para Apache Airflow, que incluye operadores específicos para lanzar trabajos de DBT Cloud directamente desde un DAG, monitorear su estado y manejar los fallos de forma centralizada.
Comparativa completa: DBT vs. Airflow
La siguiente tabla resume las diferencias más relevantes entre las dos herramientas para que puedas identificar de un vistazo cuál corresponde a cada necesidad dentro de tu stack de datos.
| Dimensión | DBT | Apache Airflow |
|---|---|---|
| Rol principal | Transformación de datos dentro del almacén | Orquestación de flujos de trabajo entre sistemas |
| Lenguaje principal | SQL (con soporte opcional de Python) | Python |
| ¿Mueve datos? | No. Solo trabaja con datos ya en el almacén | No directamente, pero coordina herramientas que sí lo hacen |
| Pruebas de datos | Sí, nativas y declarativas en YAML | No tiene un framework nativo de calidad de datos |
| Scheduler propio | Solo en DBT Cloud; DBT Core lo delega | Sí, con soporte cron y basado en eventos |
| Documentación automática | Sí, generada desde el código del proyecto | Solo a nivel de DAG, no de modelos de datos |
| Curva de aprendizaje | Baja para perfiles con SQL | Mayor, requiere habilidades en Python y plataforma |
| Perfil de usuario típico | Analytics engineer, analista de datos | Ingeniero de datos, ingeniero de plataforma |
| Código abierto | Sí (DBT Core) | Sí (Apache Airflow) |
| ¿Pueden usarse juntos? | Sí. Es la combinación más habitual en equipos maduros de ingeniería de datos | |
Un aspecto que merece atención especial es la calidad de datos. DBT tiene un enfoque propio y maduro para validar que los datos cumplen las expectativas definidas por el equipo. Para complementar esa capa de validación con pruebas más avanzadas antes de que los datos lleguen al almacén, herramientas como Great Expectations (GX) ofrecen capacidades adicionales que se integran bien en este tipo de arquitecturas.
En el campo más amplio de la ingeniería de datos, DBT y Airflow representan dos capas distintas del stack moderno de datos: la capa de transformación y la capa de orquestación. Conocer cuándo usar cada una es una de las habilidades más valoradas en equipos que trabajan con datos a escala.
Preguntas frecuentes
¿DBT reemplaza a Airflow?
No. DBT puede reemplazar la lógica de transformación SQL que algunos equipos escriben directamente dentro de operadores de Airflow, pero no puede hacer lo que Airflow hace: coordinar sistemas externos, gestionar dependencias entre herramientas distintas o manejar reintentos y alertas a nivel de pipeline completo. DBT se ocupa de lo que ocurre dentro del almacén; Airflow, de todo lo que lo rodea. Son responsabilidades diferentes y, en la mayoría de los pipelines de producción, ambas son necesarias.
¿Airflow puede reemplazar a DBT?
Técnicamente, Airflow puede ejecutar consultas SQL y gestionar dependencias entre tareas de transformación. Sin embargo, hacerlo implica perder todo lo que hace especial a DBT: el modelado modular, las pruebas declarativas, el linaje automático y la documentación generada desde el código. Reconstruir esas capacidades en Airflow significa escribir mucho más código y mezclar lógica de negocio con lógica de orquestación, lo que complica el mantenimiento a medida que el proyecto crece.
¿Qué lenguaje usa cada herramienta, SQL o Python?
DBT usa principalmente SQL como lenguaje de definición de transformaciones, con soporte opcional de Python para modelos más complejos disponible en algunas plataformas. Esto lo hace accesible para analistas que no programan en Python. Airflow, en cambio, define todos sus flujos de trabajo en Python: cada DAG es un archivo Python donde se declaran las tareas, sus dependencias y su comportamiento ante fallos. Por eso Airflow requiere habilidades de desarrollo más sólidas.
¿Cuál de las dos herramientas es más difícil de aprender?
Airflow tiene una curva de aprendizaje más pronunciada. Requiere entender cómo funciona la infraestructura del orquestador, los ejecutores, la base de datos de metadatos y el despliegue en producción, además de programar en Python. DBT, al estar centrado en SQL, resulta más accesible para perfiles analíticos desde el principio. Dominar DBT Core en un entorno sencillo puede llevarte días; configurar y operar Airflow en producción puede llevar semanas, especialmente si no tienes experiencia previa con herramientas de orquestación.
¿Pueden usarse DBT y Airflow al mismo tiempo?
Sí, y de hecho es la configuración más habitual en equipos de datos con pipelines de producción. Airflow actúa como el orquestador que decide cuándo ejecutar DBT, mientras que DBT se encarga de la transformación y validación de los datos dentro del almacén. La integración puede realizarse de distintas formas: ejecutando comandos de DBT Core como tareas de Airflow o usando el proveedor oficial de DBT Cloud para Airflow, que permite disparar y monitorear trabajos de DBT Cloud directamente desde un DAG.
¿Qué perfil profesional trabaja con DBT y cuál con Airflow?
DBT está orientado principalmente al perfil de analytics engineer y al analista de datos con conocimiento de SQL. Es la herramienta que conecta el mundo del análisis con la ingeniería de datos. Airflow, en cambio, suele ser territorio del ingeniero de datos o del ingeniero de plataforma, ya que requiere habilidades de programación en Python, conocimiento de infraestructura y experiencia con sistemas distribuidos. En equipos más pequeños, una misma persona puede manejar las dos herramientas.
¿Es necesario Airflow si ya tengo DBT Cloud?
No siempre. DBT Cloud incluye un scheduler propio que permite programar trabajos sin necesidad de un orquestador externo. Si tu pipeline completo vive dentro del almacén de datos y no necesitas coordinar herramientas externas, DBT Cloud puede ser suficiente. Pero en cuanto tu pipeline incluya pasos de ingesta, transformaciones en otros sistemas, trabajos de machine learning o dependencias externas, añadir Airflow a la ecuación te dará el control y la visibilidad que DBT Cloud no puede ofrecer por sí solo.
Conclusión
DBT y Apache Airflow no son herramientas rivales: cada una ocupa una capa distinta en el stack de datos moderno. DBT se encarga de transformar, documentar y validar los datos dentro del almacén usando SQL, mientras que Airflow coordina cuándo y en qué orden ocurre cada paso del pipeline, incluida la ejecución de DBT. Entender esa división de responsabilidades es lo que separa una arquitectura frágil de una realmente mantenible.
Ahora que conoces el rol de cada herramienta, puedes aplicar ese criterio en tus proyectos: usa DBT cuando el problema sea «¿cómo deben quedar mis datos?» y recurre a Airflow cuando la pregunta sea «¿cuándo y cómo se ejecuta todo esto?». Si tu pipeline cruza los límites del almacén, la combinación de las dos herramientas es el camino más sólido y el que adoptan los equipos de datos más maduros.
Si este tema te genera más preguntas, en este sitio web encontrarás más contenido sobre herramientas, conceptos y arquitecturas de ingeniería de datos explicados con el mismo nivel de claridad. Seguir aprendiendo sobre el stack moderno de datos es una de las mejores inversiones que puedes hacer en tu carrera técnica.
Sigue aprendiendo:
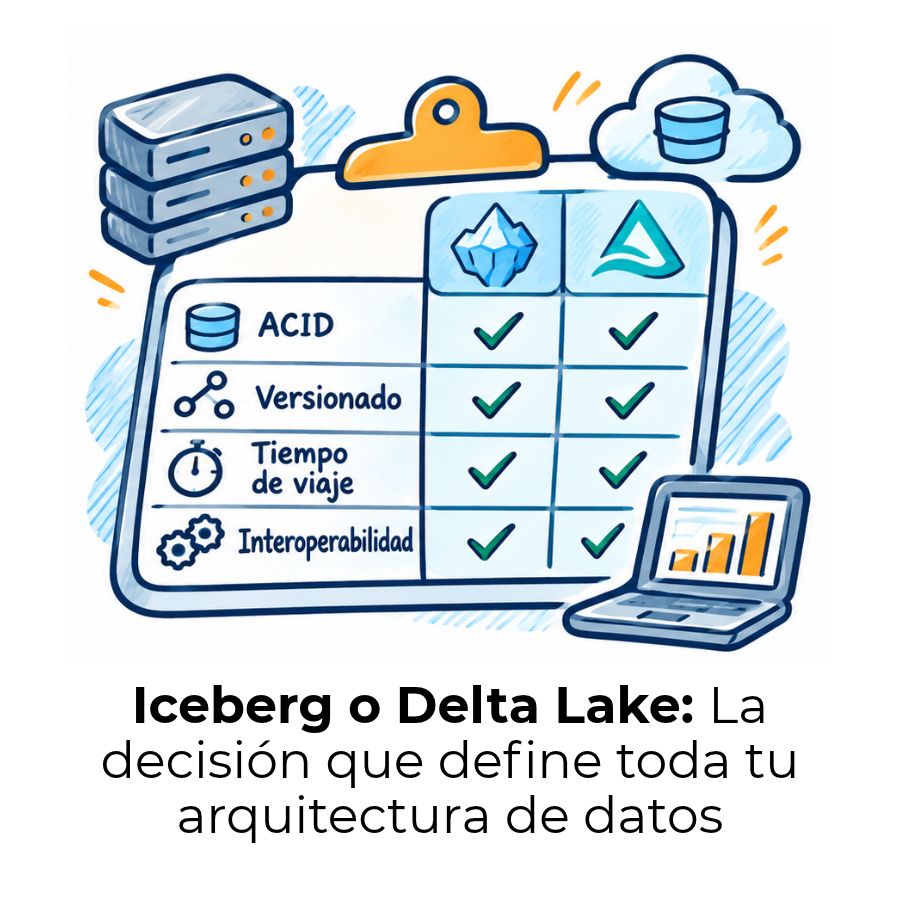
Apache Iceberg vs. Delta Lake: ¿Cuál elegir?
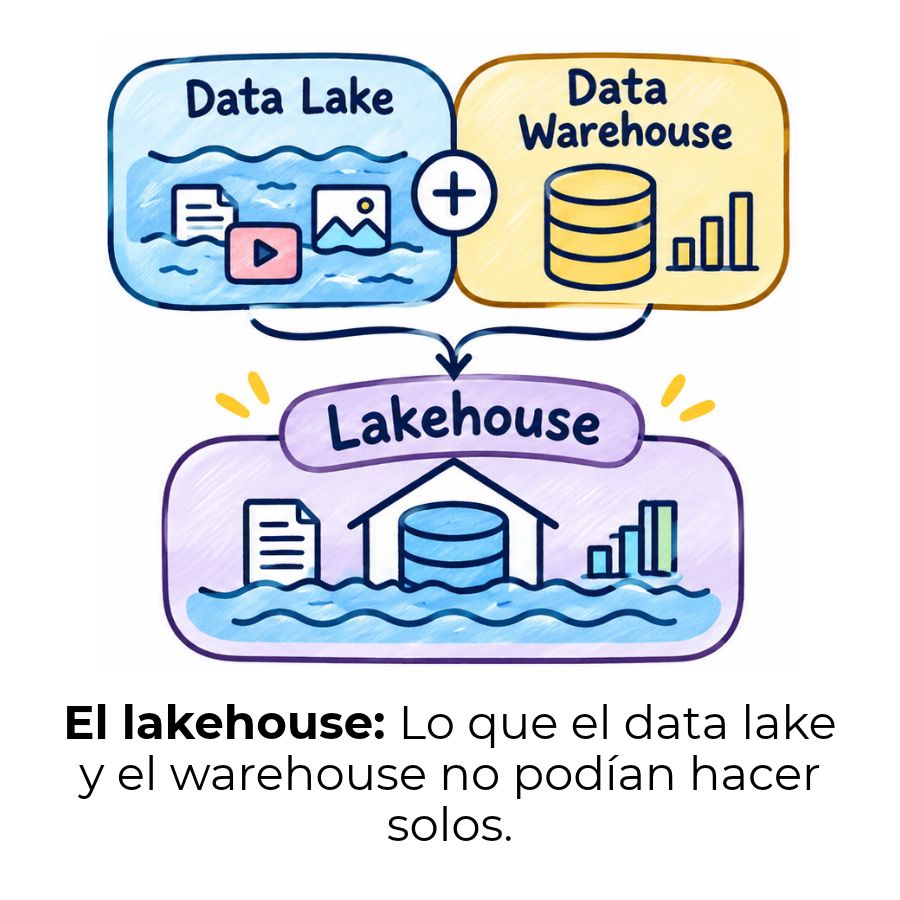
Lakehouse: La arquitectura que unifica todo
Airflow vs. Dagster vs. Prefect: ¿Cuál elegir?
DataOps: El enfoque que rompe los silos entre datos y equipos
¿Qué es un data lake y cómo funciona?
Certificaciones para ingeniero de datos
Snowflake vs. BigQuery vs. Redshift: Comparativa
100 preguntas de entrevista para ingeniero de datos
