
Cuando ves una oferta de trabajo para ingeniero de datos, la lista de herramientas parece interminable: Pandas, PySpark, Airflow, DuckDB, SQLAlchemy… Y lo más confuso es que no todas hacen lo mismo. Entender para qué sirve cada una marca la diferencia entre escribir código que funciona y construir pipelines que realmente escalan.
¿Qué es una librería de Python y por qué importa en ingeniería de datos?
Una librería de Python es un conjunto de código preescrito que amplía las capacidades del lenguaje sin que tengas que programar cada función desde cero. En lugar de construir una herramienta para leer archivos CSV o conectarte a una base de datos, importas la librería adecuada y ya tienes esa funcionalidad disponible en segundos. Este modelo de trabajo es lo que hace a Python tan eficiente para proyectos de datos.
En el campo de la ingeniería de datos, estas herramientas no son accesorios opcionales: son el núcleo de cualquier pipeline. Desde que un dato entra al sistema hasta que llega limpio y listo para análisis, existe al menos una librería involucrada en cada etapa del proceso. Elegir bien cuál usar determina la velocidad, la escalabilidad y el mantenimiento de todo el flujo.
¿Cómo funcionan las librerías dentro de un proyecto de datos?
Cuando trabajas en ingeniería de datos, cada etapa del pipeline tiene necesidades diferentes. La extracción de datos requiere herramientas que se comuniquen con APIs o bases de datos; la transformación necesita estructuras que procesen tablas con rapidez; y la carga final exige conectores fiables. Las librerías de Python cubren cada una de estas etapas con herramientas específicas.
Lo práctico de este ecosistema es que las librerías están diseñadas para trabajar juntas. Pandas puede leer datos directamente de una consulta hecha con SQLAlchemy, y el resultado puede pasarse sin fricción a un modelo de Scikit-learn. Esta interoperabilidad es lo que convierte a Python en un lenguaje tan productivo para trabajar con datos a diario.
¿Por qué Python domina la ingeniería de datos?
Python no llegó al tope del campo por ser el lenguaje más rápido en ejecución, sino porque tiene el ecosistema de librerías más completo y maduro para trabajar con datos. Su sintaxis legible y su comunidad activa hacen que aprender una nueva herramienta sea mucho más accesible que en otros lenguajes orientados a datos como Scala o R.
Además, la mayoría de las plataformas cloud modernas —como AWS, Google Cloud o Azure— ofrecen soporte nativo para Python en sus servicios de datos. Esto significa que el código que escribes en tu computadora local puede escalar a producción sin reescribirse desde cero, algo que tiene un peso enorme a la hora de elegir un lenguaje para proyectos reales.
Librerías para manipulación y transformación de datos
La transformación de datos es el corazón de cualquier pipeline. Aquí es donde los datos crudos se limpian, se reordenan, se cruzan con otras fuentes y se convierten en algo útil para el análisis o para alimentar un sistema. Las siguientes librerías son las protagonistas de esta etapa y conocerlas bien te ahorra horas de trabajo.
Pandas: el estándar para datos tabulares
Pandas es la librería más usada en ciencia e ingeniería de datos para trabajar con datos estructurados. Su estructura central, el DataFrame, te permite representar tablas en memoria y aplicarles filtros, agrupaciones, uniones y transformaciones con pocas líneas de código. Es el punto de partida de casi cualquier proyecto que maneje datos en formato tabular.
Su fortaleza está en la comodidad y la velocidad de desarrollo. Para datasets que caben en la memoria de tu máquina —hasta varios gigabytes según el equipo—, Pandas es difícilmente superable en términos de productividad. Pandas se instala con pip install pandas y está disponible en el repositorio oficial de PyPI.
Polars: la alternativa de alto rendimiento
Polars es una librería de DataFrames escrita en Rust que se ejecuta desde Python. Su diseño interno, basado en el modelo de memoria columnar de Apache Arrow, le permite procesar datos mucho más rápido que Pandas en operaciones de filtrado, agrupación y transformación sobre conjuntos de datos grandes. Es especialmente útil cuando el rendimiento es una prioridad.
A diferencia de Pandas, Polars evalúa las operaciones de forma diferida: primero construye un plan de ejecución y luego lo optimiza antes de correrlo. Esto reduce el consumo de memoria y acelera los tiempos de procesamiento. Polars es una opción a considerar seriamente cuando tu pipeline empieza a tener problemas de velocidad con Pandas.
NumPy: la base del cálculo numérico
NumPy es la librería que da soporte a casi todo el ecosistema científico de Python. Proporciona arrays multidimensionales de alta eficiencia y un conjunto amplio de funciones matemáticas que operan sobre ellos de forma vectorizada, es decir, sin necesidad de bucles explícitos. Pandas, por ejemplo, está construido sobre NumPy internamente.
Aunque en el trabajo diario de ingeniería de datos no siempre se usa NumPy directamente, su presencia es constante detrás de otras librerías. Conocer sus arrays y sus operaciones básicas te ayuda a entender cómo funcionan herramientas más especializadas y a depurar problemas de rendimiento cuando aparecen en medio de un pipeline de transformación.
Comparativa: Pandas vs. Polars vs. NumPy
Pandas
✔ Sintaxis intuitiva
✔ Enorme comunidad
✔ Integración total con el ecosistema
Mejor para: datasets que caben en memoria
Polars
✔ Muy alta velocidad
✔ Evaluación diferida
✔ Bajo consumo de RAM
Mejor para: transformaciones con miles de columnas o millones de filas
NumPy
✔ Arrays vectorizados
✔ Base del ecosistema
✔ Operaciones matemáticas avanzadas
Mejor para: cálculo numérico y soporte a otras librerías
Librerías para visualización de datos
En ingeniería de datos, visualizar no es solo una tarea estética. Revisar distribuciones, detectar valores atípicos y validar transformaciones son partes del proceso de trabajo cotidiano. Las librerías de visualización te permiten inspeccionar los datos en segundos y detectar problemas que serían invisibles en una tabla de números.
Matplotlib: gráficos desde cero
Matplotlib es la librería gráfica de referencia en Python. Te permite construir prácticamente cualquier tipo de gráfico —líneas, barras, dispersión, histogramas— con un control muy fino sobre cada elemento visual. Es la base sobre la que se construyeron otras librerías de visualización como Seaborn y Plotly, por lo que entenderla bien facilita el aprendizaje de las demás.
Su curva de aprendizaje es mayor que la de otras herramientas porque requiere configurar manualmente aspectos como ejes, leyendas y estilos. Sin embargo, cuando necesitas personalización total o quieres exportar gráficos en un formato específico para un informe, Matplotlib sigue siendo la opción más completa y versátil del ecosistema Python.
Seaborn: estadística visual sin esfuerzo
Seaborn está construida sobre Matplotlib y está pensada para facilitar la exploración estadística de los datos. Con pocas líneas de código puedes generar gráficos de distribución, mapas de calor o gráficos de regresión que con Matplotlib requerirían mucho más trabajo. Su integración natural con los DataFrames de Pandas la convierte en una herramienta muy práctica para explorar datos tabulares.
Plotly: visualizaciones interactivas
Plotly destaca por generar gráficos interactivos directamente en el navegador, lo que la hace especialmente útil para dashboards o para compartir resultados con personas no técnicas. Sus gráficos permiten hacer zoom, filtrar y explorar los datos con el ratón, algo que Matplotlib y Seaborn no ofrecen de forma nativa. Es una opción habitual cuando el producto final es un reporte web o una aplicación de datos.
¿Qué librería de Python se usa para construir pipelines ETL?
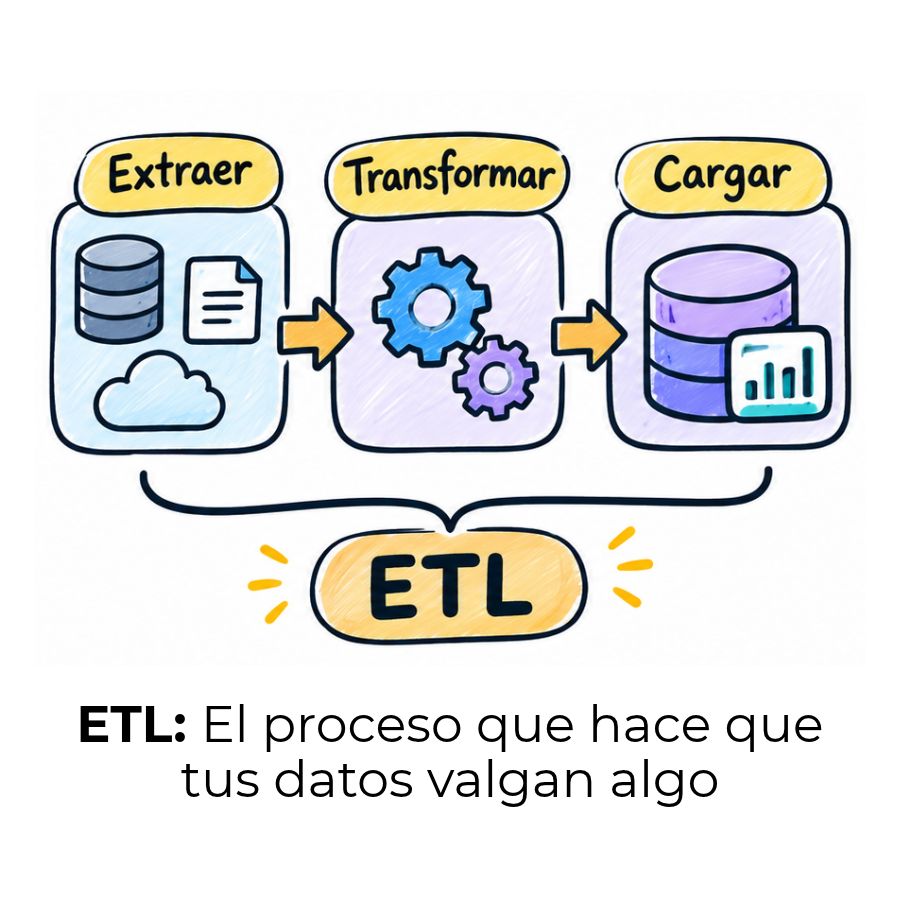
Un pipeline ETL (Extract, Transform, Load) es el flujo que mueve datos desde una fuente hasta un destino procesado y listo para su uso. Construir un pipeline ETL sólido en Python requiere al menos una librería de orquestación, una de transformación y una de conectividad a bases de datos. Las tres categorías tienen herramientas específicas dentro del ecosistema Python.
Apache Airflow: orquestación de flujos de datos
Apache Airflow es la herramienta de orquestación más usada en equipos de datos a escala profesional. Permite definir flujos de trabajo como grafos acíclicos dirigidos (DAGs) escritos en Python, donde cada nodo es una tarea y las aristas representan dependencias entre ellas. Puedes programar cuándo se ejecuta cada tarea, monitorear su estado y reintentarla si falla.
Lo importante es entender que Airflow no transforma datos por sí mismo: su función es orquestar y coordinar las tareas que sí lo hacen. Se conecta con Pandas, Spark, bases de datos y APIs externas para ejecutar el pipeline completo de forma automatizada. Seguir las buenas prácticas de ingeniería de datos al diseñar tus DAGs hace que el mantenimiento sea mucho más sencillo a largo plazo.
SQLAlchemy: conexión con bases de datos
SQLAlchemy es la librería de Python más popular para interactuar con bases de datos relacionales. Ofrece dos niveles de uso: un ORM (Object Relational Mapper) que permite trabajar con tablas como si fueran objetos Python, y un nivel más bajo que ejecuta SQL directamente con una interfaz unificada independiente del motor de base de datos que uses.
En el contexto de los pipelines ETL, SQLAlchemy actúa como el conector que permite cargar datos transformados en PostgreSQL, MySQL, SQLite o cualquier base compatible. Pandas puede usar SQLAlchemy directamente para leer y escribir DataFrames en bases de datos con métodos como read_sql() y to_sql(), lo que convierte a SQLAlchemy en una pieza clave del stack de datos.
DuckDB: análisis SQL dentro de Python
DuckDB es una base de datos analítica que se ejecuta directamente dentro del proceso de Python, sin necesidad de un servidor externo. Su enfoque columnar la hace muy eficiente para consultas analíticas sobre archivos locales, como CSV o Parquet, y puede consultar DataFrames de Pandas y Polars sin copiar los datos. Se la conoce informalmente como «el SQLite del análisis de datos» por su facilidad de instalación y su potencia para datasets medianos.
Librerías para procesamiento distribuido y big data
Cuando el volumen de datos supera lo que puede manejar una sola máquina, el enfoque cambia radicalmente. Ya no basta con leer un archivo CSV en memoria y aplicar transformaciones; hace falta distribuir el trabajo entre varios nodos o aprovechar al máximo los múltiples núcleos del procesador. Para estos escenarios, Python cuenta con dos herramientas principales: PySpark y Dask.
PySpark: escala horizontal con Apache Spark
PySpark es la interfaz de Python para Apache Spark, el motor de procesamiento distribuido más usado en entornos de big data. Permite escribir código Python que se ejecuta en paralelo sobre un clúster de máquinas, distribuyendo automáticamente las tareas entre los nodos disponibles. Es la opción estándar cuando necesitas procesar datasets que no caben en la memoria de un solo servidor y que requieren escalar horizontalmente.
La sintaxis de PySpark es similar a la de Pandas en muchos aspectos, lo que facilita la transición. Sin embargo, su modelo de ejecución es diferente: las operaciones también son diferidas y se optimizan antes de ejecutarse. Configurar un entorno PySpark requiere más pasos que instalar Pandas, pero los entornos cloud como Databricks o EMR de AWS simplifican mucho este proceso para equipos que trabajan a escala.
Dask: paralelismo sin salir de Python
Dask está diseñado para quien ya conoce Pandas y NumPy y necesita escalar sus cálculos sin cambiar de paradigma. Su API imita deliberadamente la de estas librerías, de modo que la curva de adopción es mucho más suave que con PySpark. Dask divide los datos en particiones y las procesa en paralelo usando todos los núcleos del procesador o, si se configura, en un clúster distribuido.
Es una buena opción para datos que son demasiado grandes para Pandas, pero no tan masivos como para justificar un clúster de Spark. Si tu dataset ocupa decenas de gigabytes y tu máquina tiene varios núcleos disponibles, Dask puede multiplicar significativamente la velocidad de procesamiento sin necesidad de infraestructura adicional ni de aprender un nuevo paradigma de programación.
¿Cuándo usar Dask y cuándo PySpark?
Elige Dask si…
- Tu código ya usa Pandas o NumPy
- Los datos caben en unos pocos cientos de GB
- No tienes infraestructura de clúster disponible
- Quieres paralelismo local sin configurar servidores
Elige PySpark si…
- Los datos superan los terabytes
- Tienes un clúster o usas una plataforma cloud como Databricks
- El equipo ya trabaja con el ecosistema Apache Spark
- Necesitas procesamiento en tiempo real con Spark Streaming
Librerías de machine learning aplicadas a ingeniería de datos
La ingeniería de datos y el machine learning están estrechamente ligados: el ingeniero de datos construye los pipelines que alimentan a los modelos. Por eso, conocer las librerías de machine learning más comunes te permite diseñar mejores flujos de datos, entender qué formato esperan los modelos y preparar las transformaciones necesarias desde el principio.
Scikit-learn es la librería de machine learning más popular en Python para tareas supervisadas y no supervisadas. Incluye algoritmos de clasificación, regresión, clustering y reducción de dimensionalidad, todos con una interfaz homogénea. Desde el punto de vista del ingeniero de datos, Scikit-learn es relevante porque sus pipelines de preprocesamiento —imputación, escalado, codificación— son parte del flujo de transformación de datos.
Para tareas de aprendizaje profundo, PyTorch y TensorFlow son las referencias del campo. Aunque su uso directo es más habitual en el rol de científico de datos o ML engineer, el ingeniero de datos necesita saber cómo preparar los datos en el formato que estas librerías esperan: tensores, batches y pipelines de ingesta de datos específicos para modelos neuronales.
Comparativa rápida de las principales librerías
Elegir la librería correcta depende de lo que necesitas resolver, no de seguir una moda. Esta tabla resume las principales librerías de Python para ingeniería de datos, su categoría, su caso de uso principal y cuándo tiene sentido usarla, para que puedas tomar decisiones informadas desde el primer momento.
| Librería | Categoría | Caso de uso principal | Cuándo usarla |
|---|---|---|---|
| Pandas | Transformación | Manipulación de datos tabulares en memoria | Datasets hasta varios GB en una sola máquina |
| Polars | Transformación | Procesamiento de alto rendimiento con DataFrames | Cuando Pandas es lento o consume demasiada RAM |
| NumPy | Cálculo numérico | Arrays y operaciones matemáticas vectorizadas | Base de otras librerías y cálculos científicos |
| Matplotlib | Visualización | Gráficos estáticos altamente personalizables | Informes con control total del diseño visual |
| Seaborn | Visualización | Exploración estadística rápida | Análisis exploratorio de datos tabulares |
| Plotly | Visualización | Gráficos interactivos para web | Dashboards y reportes compartibles |
| Apache Airflow | Orquestación | Programación y monitoreo de pipelines | Flujos automáticos con múltiples pasos dependientes |
| SQLAlchemy | Conectividad | Conexión con bases de datos relacionales | Cargar o leer datos desde PostgreSQL, MySQL, SQLite |
| DuckDB | Análisis SQL | Consultas SQL sobre archivos locales y DataFrames | Análisis rápido sin servidor externo |
| PySpark | Big data | Procesamiento distribuido a gran escala | Datasets en terabytes o clústeres cloud |
| Dask | Big data | Paralelismo local con API similar a Pandas | Datos grandes que no justifican un clúster Spark |
| Scikit-learn | Machine learning | Modelos clásicos y preprocesamiento de datos | Clasificación, regresión y transformaciones de features |
Preguntas frecuentes
¿Qué librerías de Python debe conocer un ingeniero de datos?
Un ingeniero de datos debe dominar al menos las librerías esenciales de cada categoría del pipeline: Pandas o Polars para transformar datos, SQLAlchemy para conectarse a bases de datos, Apache Airflow para orquestar flujos y PySpark o Dask cuando el volumen de datos lo exige. NumPy y Scikit-learn son un complemento muy habitual que conviene conocer, aunque no sean el foco principal del rol.
¿Cuál es la diferencia entre Pandas y Polars para ingeniería de datos?
Pandas es la opción más madura, con la comunidad más grande y la mayor cantidad de tutoriales disponibles, lo que la hace ideal para empezar. Polars, por su parte, está escrita en Rust y usa el modelo columnar de Apache Arrow, lo que la hace considerablemente más rápida en operaciones sobre grandes volúmenes de datos. La diferencia principal no es de funciones, sino de rendimiento: para datasets pequeños o medianos, Pandas es perfectamente válido; cuando el rendimiento se convierte en un problema, Polars ofrece una ventaja real sin necesitar infraestructura distribuida.
¿Qué es PySpark y cuándo conviene usarlo?
PySpark es la interfaz de Python para Apache Spark, un motor de procesamiento distribuido que divide el trabajo entre varios nodos de un clúster. Conviene usarlo cuando los datos superan la capacidad de memoria de una sola máquina, cuando el volumen de procesamiento se mide en terabytes o cuando el equipo ya trabaja con infraestructura cloud como Databricks o Amazon EMR. No es la herramienta adecuada para proyectos pequeños, ya que su configuración y overhead son significativos comparados con Pandas o Dask.
¿Cómo se instala una librería de Python para trabajar con datos?
La forma más común es usar pip, el gestor de paquetes de Python, ejecutando el comando pip install nombre_libreria desde la terminal. Por ejemplo, pip install pandas o pip install polars. Otra opción muy popular en entornos de datos es usar conda, especialmente con la distribución Anaconda, que instala las librerías junto con sus dependencias de forma más integrada. Se recomienda siempre trabajar dentro de un entorno virtual para evitar conflictos entre proyectos.
¿Qué librería de Python se usa para orquestar pipelines de datos?
Apache Airflow es el estándar de la industria para orquestar pipelines de datos en Python. Permite programar flujos de trabajo complejos como DAGs, monitorear su ejecución desde una interfaz web y gestionar reintentos automáticos cuando una tarea falla. Existen alternativas más modernas como Prefect y Dagster, que ofrecen una experiencia de desarrollo más sencilla, aunque Airflow sigue siendo la opción más extendida en equipos de datos consolidados.
¿Es necesario aprender todas las librerías al mismo tiempo?
No, y hacerlo así sería contraproducente. Lo más efectivo es empezar por las librerías de transformación —Pandas y NumPy— y avanzar progresivamente hacia las de orquestación y procesamiento distribuido conforme los proyectos lo requieran. Cada librería resuelve un problema concreto, y aprenderla cuando ya tienes ese problema en frente hace que el aprendizaje sea mucho más sólido y duradero que estudiarlas todas de forma teórica sin contexto real.
¿Qué librería de Python es mejor para análisis de datos a gran escala?
Depende del tamaño y del entorno disponible. Para datos que rondan los cientos de gigabytes y se procesan en una sola máquina con múltiples núcleos, Dask es una solución muy práctica porque imita la API de Pandas. Para volúmenes de terabytes en un clúster, PySpark es la opción más robusta y ampliamente adoptada. DuckDB también es una alternativa competitiva para consultas analíticas rápidas sobre archivos grandes sin necesitar infraestructura de clúster.
Conclusión
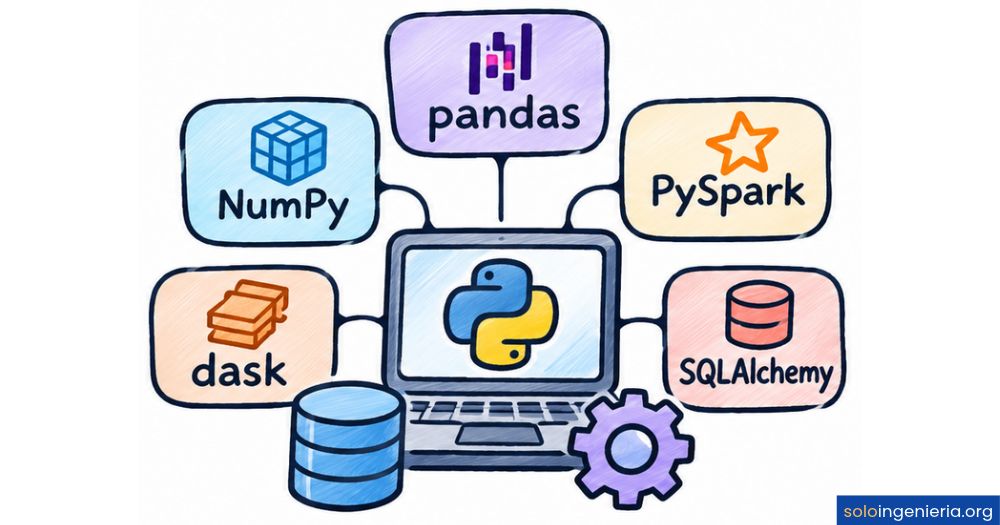
El ecosistema de librerías de Python para ingeniería de datos es amplio, pero cada herramienta ocupa un lugar concreto dentro del pipeline. Pandas y Polars manejan la transformación; SQLAlchemy y DuckDB conectan con las bases de datos; Airflow orquesta los flujos; y PySpark o Dask escalan el procesamiento cuando el volumen lo exige. Ninguna librería lo hace todo, pero juntas forman un stack muy completo y coherente.
Lo más valioso que puedes llevarte de este recorrido es saber qué herramienta usar en cada situación. Empieza con Pandas para ganar confianza, agrega SQLAlchemy cuando necesites bases de datos y explora Airflow en cuanto tus flujos crezcan. No es necesario dominar todo el stack antes de empezar: cada proyecto te irá llevando naturalmente a la siguiente herramienta.
Si quieres seguir construyendo tus conocimientos en este campo, en este sitio web encontrarás más contenido sobre herramientas, conceptos y flujos de trabajo para que tu camino en la ingeniería de datos sea claro y progresivo desde el primer paso.
Sigue aprendiendo:
Particionamiento de datos: El secreto detrás de las bases rápidas
¿Cómo crear tu primer DAG en Apache Airflow?
Linaje de datos: El mapa oculto detrás de cada dato
Stack de datos moderno: La revolución silenciosa del análisis
Snowflake vs. BigQuery vs. Redshift: Comparativa
Catálogo de datos: El mapa que nadie te enseñó a leer
¿Qué es ETL? – Extracción, Transformación y Carga
Lakehouse: La arquitectura que unifica todo
