
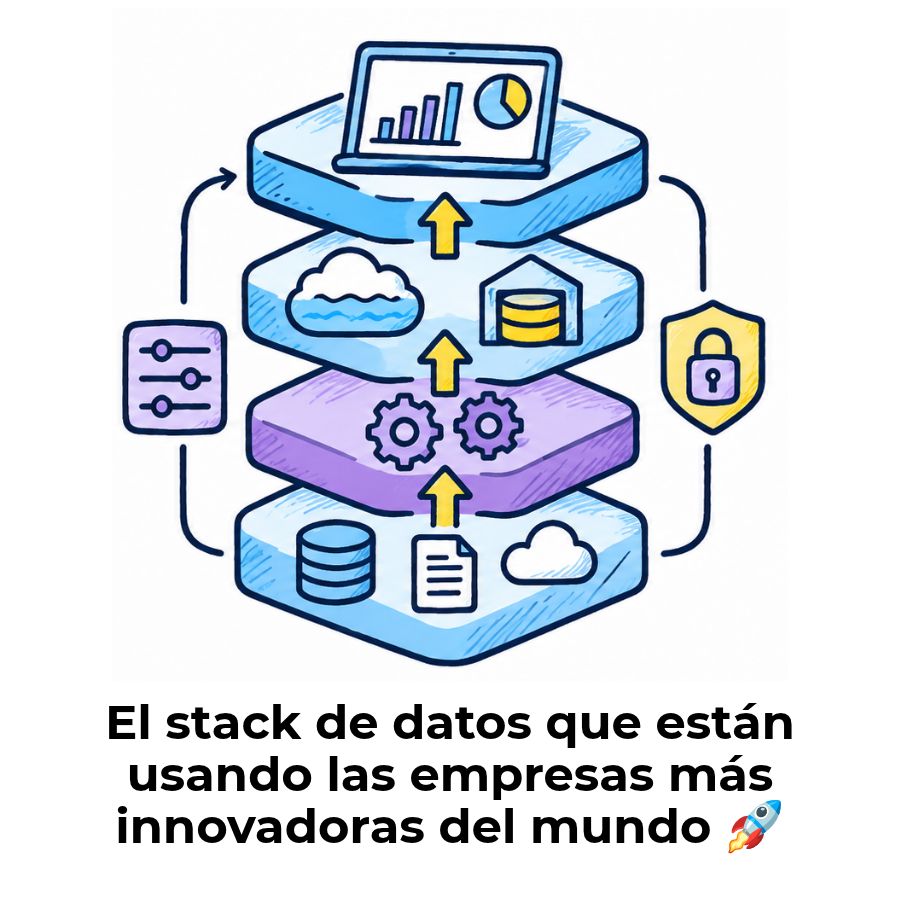
El stack de datos moderno es el conjunto de herramientas en la nube que permiten ingerir, almacenar, transformar y analizar datos de forma ágil. Combina servicios como Fivetran, Snowflake, dbt y Looker para que cualquier equipo pueda construir una infraestructura analítica potente sin montar servidores.
¿Qué es el stack de datos moderno?
El stack de datos moderno es un conjunto de herramientas basadas en la nube que se integran entre sí para gestionar todo el ciclo de vida del dato: Desde su captura en las fuentes originales hasta su consumo final en informes y modelos analíticos. Su gran diferencia está en que cada pieza se especializa en una función concreta y se conecta mediante estándares abiertos.
Este enfoque modular rompe con los sistemas monolíticos del pasado. Ya no dependes de una única plataforma pesada que lo haga todo a medias. Eliges la mejor solución para cada capa, pagas solo por lo que consumes y escalas de forma elástica según el volumen de información. Así, equipos reducidos logran resultados que antes exigían infraestructuras complejas.
Diferencias frente al stack de datos tradicional
El stack tradicional se construía sobre servidores propios, con procesos ETL rígidos que exigían semanas de desarrollo para cada cambio. Los equipos de TI custodiaban cada paso y cualquier nueva fuente de datos implicaba largas negociaciones. Esta rigidez frenaba la capacidad de respuesta del negocio y encarecía proyectos que hoy se resuelven en días.
El modelo moderno invierte esta lógica. La nube absorbe la complejidad de infraestructura y los equipos se concentran en generar valor con los datos. Los procesos ELT permiten cargar primero y transformar después, aprovechando la potencia de cómputo del warehouse. Además, cada herramienta se puede sustituir sin romper el resto del sistema.
| Aspecto | Stack tradicional | Stack moderno |
|---|---|---|
| Infraestructura | Servidores propios | Servicios en la nube |
| Proceso | ETL (extrae, transforma, carga) | ELT (extrae, carga, transforma) |
| Escalabilidad | Limitada al hardware | Elástica y bajo demanda |
| Tiempo de implementación | Meses | Semanas o días |
| Costo inicial | Alto y fijo | Bajo y por consumo |
| Flexibilidad | Rígida | Modular e intercambiable |
Componentes principales del stack de datos moderno
Un stack de datos moderno se organiza en capas que cumplen funciones específicas. Cada una resuelve un problema concreto del ciclo de vida del dato y se integra con las demás mediante conectores estándar. Conocer estas piezas te permite diseñar arquitecturas sólidas y elegir las herramientas adecuadas para cada necesidad del proyecto.
Ingesta y replicación de datos
La capa de ingesta se encarga de mover los datos desde sus fuentes originales hasta el almacén central. Las fuentes pueden ser bases de datos transaccionales, APIs de aplicaciones SaaS, hojas de cálculo o eventos en tiempo real. Las herramientas modernas automatizan conectores preconstruidos para servicios como Salesforce, Stripe o Google Analytics, evitando que programes integraciones manuales.
Esta capa resuelve un problema clásico: La fricción de conectar decenas de sistemas heterogéneos. Al centralizar la extracción, reduces errores, aseguras frescura en los datos y liberas tiempo del equipo técnico. Fivetran y Airbyte dominan este espacio con enfoques diferentes: El primero totalmente gestionado y el segundo con opción de código abierto para mayor control.
Almacenamiento en la nube y data warehouse
El data warehouse en la nube es el corazón del stack. Aquí se guardan los datos ya ingresados y se ejecutan las consultas analíticas que alimentan los informes. A diferencia de los almacenes tradicionales, estos sistemas separan cómputo y almacenamiento, lo que permite escalar cada recurso de forma independiente y pagar solo por lo que realmente usas.
Si te interesa profundizar en los distintos modelos de almacenamiento analítico, revisa la diferencia entre data mart y data warehouse para entender cuándo conviene cada uno. Snowflake, BigQuery y Redshift lideran el mercado con arquitecturas que procesan terabytes en segundos. Esta capacidad de consulta instantánea es lo que permite al resto del stack funcionar con fluidez.
Transformación de datos con dbt
La transformación convierte los datos crudos en modelos limpios y listos para analizar. En el stack moderno, esta etapa ocurre dentro del warehouse mediante SQL, aprovechando su potencia de cómputo. La herramienta de referencia es dbt, que aplica principios de ingeniería de software al modelado de datos: Control de versiones, pruebas automatizadas y documentación generada a partir del código.
Este cambio es profundo. Antes, las transformaciones vivían dispersas en procedimientos almacenados, scripts dispersos y hojas de cálculo frágiles. Con dbt centralizas la lógica, permites revisiones entre pares y garantizas que cada modelo se construya con calidad. Los analistas ganan autonomía sin depender del equipo de ingeniería para cada ajuste.
Orquestación de flujos de trabajo
La orquestación coordina cuándo y cómo se ejecuta cada proceso del stack. Define dependencias entre tareas, programa ejecuciones periódicas y gestiona reintentos cuando algo falla. Sin esta capa, los procesos se ejecutarían de forma desordenada y perderías visibilidad sobre el estado real de tus pipelines, abriendo la puerta a errores silenciosos y datos desactualizados.
Apache Airflow fue el pionero y sigue siendo el estándar en muchas organizaciones. Prefect y Dagster aparecieron después con enfoques más modernos, pensados para flujos dinámicos y entornos nativos en la nube. La elección depende del volumen de pipelines, la complejidad de las dependencias y el nivel de madurez del equipo que mantendrá el sistema.
Visualización y analítica de negocio
Esta capa traduce los datos ya modelados en información accionable para quienes toman decisiones. Dashboards interactivos, informes programados y exploraciones ad hoc permiten que áreas como marketing, finanzas o producto respondan sus preguntas sin depender del equipo técnico. La clave está en ofrecer interfaces claras conectadas directamente al warehouse para evitar duplicar la lógica de negocio.
Looker, Tableau, Power BI y Metabase son las opciones más extendidas. Cada una tiene su filosofía: Looker apuesta por un lenguaje de modelado centralizado, Tableau prioriza la exploración visual y Metabase destaca por su facilidad para equipos pequeños. La elección debe alinearse con la cultura de datos y el perfil técnico de los usuarios finales.
Observabilidad y gobierno de datos
Esta capa transversal garantiza que los datos sean confiables y que los equipos entiendan su origen y significado. La observabilidad detecta anomalías, caídas de frescura o cambios inesperados en los esquemas antes de que lleguen a los informes. El gobierno documenta linaje, define propietarios y asegura que cada tabla cumpla con las políticas de la organización.
Herramientas como Monte Carlo, Soda o Great Expectations automatizan estas tareas. Sin esta capa, los equipos pierden confianza en los números y las decisiones se vuelven inseguras. Invertir en observabilidad desde el inicio evita que el stack se convierta en una caja negra difícil de mantener conforme crece el número de modelos y fuentes integradas.
¿Cómo funciona el flujo de datos de extremo a extremo?
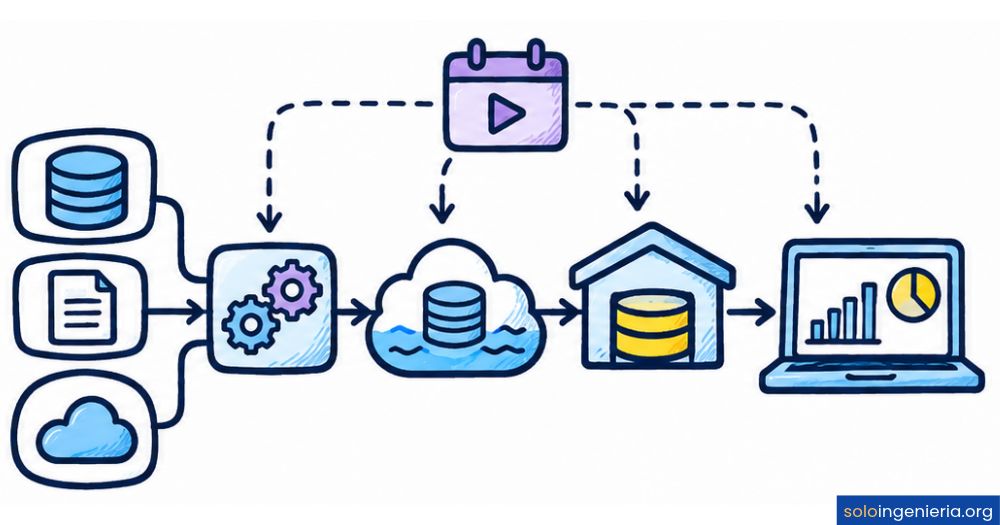
El recorrido del dato empieza en las fuentes originales: Aplicaciones de negocio, bases transaccionales, APIs externas o sistemas de archivos. La capa de ingesta extrae esta información y la deposita en el warehouse sin transformarla. Este enfoque, conocido como ELT, aprovecha la potencia del almacén para procesar los datos ya cargados.
Una vez dentro, los modelos de transformación organizan los datos en capas lógicas. Primero se construyen tablas de staging que limpian los campos crudos. Después, modelos intermedios aplican reglas de negocio y, por último, se generan los modelos finales que alimentan los dashboards. La orquestación coordina todo este flujo y garantiza que cada paso se ejecute en el orden correcto.
Flujo completo del dato
CRM, ERP, APIs, bases de datos operacionales y eventos de aplicaciones.
Conectores automatizados replican los datos al warehouse sin transformarlos.
Modelos SQL organizan la información en capas: staging, intermedia y mart.
Dashboards, modelos predictivos y APIs analíticas alimentan al negocio.
Herramientas más utilizadas en cada capa
El ecosistema del stack moderno ha crecido muchísimo en los últimos años. Cientos de herramientas compiten en cada capa y elegir entre ellas puede abrumar. La buena noticia es que algunas se han consolidado como referentes y conocerlas te dará una base sólida para empezar cualquier proyecto profesional de ingeniería de datos.
A la hora de seleccionar, considera factores como el volumen de datos que vas a procesar, el presupuesto disponible, la curva de aprendizaje y la madurez de la comunidad. No existe una combinación universal: Cada equipo construye su propio stack según sus necesidades, aunque hay patrones muy comunes que funcionan como punto de partida fiable.
| Capa | Opciones gestionadas | Opciones de código abierto |
|---|---|---|
| Ingesta | Fivetran, Stitch, Hevo | Airbyte, Meltano |
| Almacenamiento | Snowflake, BigQuery, Redshift | DuckDB, ClickHouse |
| Transformación | dbt Cloud | dbt Core, SQLMesh |
| Orquestación | Prefect Cloud, Dagster Cloud | Airflow, Prefect, Dagster |
| Visualización | Looker, Tableau, Power BI | Metabase, Superset |
| Observabilidad | Monte Carlo, Bigeye | Great Expectations, Soda |
Ventajas y desventajas de adoptarlo
Adoptar un stack de datos moderno transforma la manera en que una organización trabaja con información. Los beneficios son evidentes para equipos que buscan agilidad y escalabilidad, pero también hay retos importantes que conviene conocer antes de dar el salto. Entender ambas caras te permite tomar decisiones informadas y evitar sorpresas durante la implementación.
Beneficios clave para equipos de datos
La ventaja más celebrada es la velocidad. Lo que antes tomaba meses ahora se logra en semanas gracias a herramientas que eliminan la fricción técnica. Los equipos pequeños pueden construir arquitecturas que antes requerían departamentos enteros, y la curva de aprendizaje es mucho más amable al apoyarse en SQL como lenguaje común para la mayoría de las transformaciones.
Los beneficios se extienden a toda la organización:
- Escalabilidad elástica: La infraestructura crece con el volumen de datos sin necesidad de planificar capacidad por adelantado.
- Costos variables: Pagas solo por el cómputo y almacenamiento que realmente consumes cada mes.
- Autonomía analítica: Los analistas construyen modelos sin depender del equipo de ingeniería para cada ajuste.
- Modularidad: Puedes sustituir cualquier herramienta sin rediseñar todo el sistema desde cero.
- Tiempo de valor reducido: Los primeros dashboards llegan al negocio en días, no en trimestres.
Retos y limitaciones a considerar
El principal reto es la fragmentación. Al combinar varias herramientas, debes gestionar múltiples contratos, aprender varias interfaces y mantener la integración entre ellas. Los costos variables pueden escalar rápido si no monitorizas el consumo, especialmente en consultas mal optimizadas que disparan la facturación del warehouse sin aportar valor real al negocio.
Otro aspecto crítico es la gobernanza. La facilidad para crear modelos puede generar proliferación descontrolada de tablas duplicadas y lógica inconsistente entre equipos. Sin una estrategia clara desde el inicio, el stack puede volverse difícil de mantener. La seguridad y el cumplimiento normativo también exigen atención, sobre todo al mover datos sensibles a plataformas gestionadas por terceros.
Casos de uso reales en empresas
Las empresas de comercio electrónico utilizan el stack moderno para unificar datos de ventas, inventario, logística y marketing en un único punto de verdad. Esto les permite calcular métricas como el valor de vida del cliente, segmentar audiencias para campañas y detectar patrones de abandono en el proceso de compra con una frescura casi en tiempo real.
En servicios financieros, el stack alimenta modelos de riesgo, detección de fraude y reportes regulatorios. Las startups tecnológicas lo aprovechan para analizar métricas de producto como retención, activación y adopción de funcionalidades. Incluso sectores tradicionales como manufactura e industria ya integran datos de sensores, producción y cadena de suministro para optimizar sus operaciones de manera continua.
Análisis del comportamiento del cliente, atribución de marketing y previsión de demanda con dashboards actualizados cada hora.
Scoring crediticio, detección de fraude y generación automatizada de reportes regulatorios para auditorías.
Métricas de producto, cohortes de retención y análisis de churn para ciclos de mejora continua.
Monitoreo de sensores IoT, optimización de producción y trazabilidad de la cadena de suministro.
¿Cómo empezar a construir tu propio stack de datos?
El primer paso es definir qué preguntas quieres responder con los datos. Sin este anclaje, acabarás comprando herramientas que no usarás. Identifica las fuentes imprescindibles, los informes críticos y el volumen de información que manejas. Con este mapa inicial podrás dimensionar las capas y evitar la trampa de montar una arquitectura sobredimensionada desde el primer día.
Empieza con una configuración mínima viable:
- Un warehouse gestionado: Snowflake o BigQuery ofrecen niveles gratuitos para experimentar sin compromisos iniciales.
- Un conector de ingesta: Airbyte de código abierto es ideal para aprender sin costos de licencia.
- dbt Core instalado localmente: Te permite modelar con buenas prácticas desde el primer modelo.
- Una herramienta de visualización ligera: Metabase o Superset son gratuitas y fáciles de desplegar.
- Un repositorio Git: Guarda el código de los modelos y aplica revisiones entre pares para mantener calidad.
Con esta base podrás aprender los fundamentos sin gastar dinero y escalar cuando el proyecto lo justifique. Documenta cada decisión, comparte los aprendizajes con tu equipo y mide el impacto real en el negocio. La madurez llega con la práctica y con la disciplina de tratar los datos como un producto que merece atención continua.
Preguntas frecuentes
¿Qué lenguaje de programación necesito para trabajar con un stack de datos moderno?
SQL es el lenguaje imprescindible porque sostiene prácticamente todas las transformaciones dentro del warehouse. Python te resultará muy útil para orquestación con Airflow o Prefect y para tareas de automatización. YAML aparece en archivos de configuración de dbt y conectores. Con SQL sólido y nociones básicas de Python tendrás una base suficiente para empezar.
¿Cuánto cuesta implementar un stack de datos moderno?
El costo varía muchísimo según el volumen de datos, el número de usuarios y las herramientas elegidas. Un proyecto inicial con opciones gratuitas y de código abierto puede arrancar con gasto casi nulo. Configuraciones empresariales con herramientas gestionadas suelen situarse en rangos mensuales que escalan con el consumo del warehouse y el número de conectores activos.
¿Qué diferencia hay entre ETL y ELT en este contexto?
En ETL los datos se transforman antes de cargarlos en el destino, lo que exige servidores intermedios potentes. En ELT se cargan primero crudos en el warehouse y luego se transforman aprovechando su capacidad de cómputo. El stack moderno adopta ELT porque los warehouses en la nube escalan de forma elástica y simplifican mucho el flujo de trabajo.
¿Es necesario un data warehouse o puedo usar un data lake?
Depende del caso de uso. El warehouse está optimizado para consultas analíticas sobre datos estructurados y ofrece rendimiento inmediato. El data lake almacena cualquier formato a bajo costo, ideal para datos crudos y volúmenes masivos. Muchas empresas combinan ambos en una arquitectura llamada lakehouse, aprovechando las ventajas de cada enfoque según el tipo de información.
¿Qué perfiles profesionales intervienen en su mantenimiento?
El ingeniero de datos diseña y mantiene los pipelines. El analytics engineer modela la información con dbt y garantiza la calidad de los datos entregados. El analista de datos explota los modelos en dashboards e informes. En equipos maduros también aparecen roles como data product manager o data governance lead para coordinar la estrategia global.
¿El stack de datos moderno sirve para pequeñas empresas?
Sí, y precisamente ahí brilla con más fuerza. Las herramientas modernas eliminan la barrera de entrada que antes impedía a empresas pequeñas acceder a análisis sofisticados. Con presupuestos muy razonables puedes montar una arquitectura completa que te dé visibilidad sobre ventas, clientes y operaciones, apoyando decisiones estratégicas desde el primer mes de uso.
¿Cómo garantiza la calidad de los datos?
Mediante pruebas automatizadas que verifican unicidad, valores nulos, rangos esperados y relaciones entre tablas. Herramientas como dbt incluyen pruebas integradas y sistemas de observabilidad como Monte Carlo o Soda detectan anomalías antes de que afecten al negocio. La calidad se construye en capas, combinando pruebas unitarias, monitoreo continuo y documentación clara del linaje de cada dato.
Conclusión
El stack de datos moderno representa un cambio profundo en cómo las organizaciones trabajan con información. Al sustituir infraestructuras monolíticas por servicios en la nube especializados, abre la puerta a equipos más ágiles y decisiones mejor fundamentadas. Comprender sus capas te da una ventaja real en cualquier proyecto analítico.
Has visto cómo encajan la ingesta, el almacenamiento, la transformación, la orquestación y la visualización. También conoces las herramientas más usadas y los retos que acompañan a esta arquitectura. Puedes empezar con una configuración mínima gratuita, practicar con datos reales y crecer de forma progresiva según tus necesidades y presupuesto disponible.
El camino hacia una cultura de datos sólida se construye con constancia y curiosidad. Cada modelo que diseñas, cada pipeline que mantienes y cada dashboard que entregas suma experiencia valiosa. En este sitio web encontrarás más contenidos para profundizar en ingeniería de datos, arquitecturas analíticas y buenas prácticas que te acompañarán en tu desarrollo profesional.
Sigue aprendiendo:
DataOps: El enfoque que rompe los silos entre datos y equipos
Apache Airflow: Automatiza y controla tus flujos de datos con Python
Ingesta de datos: Transforma fuentes caóticas en valor real
Apache Iceberg vs. Delta Lake: ¿Cuál elegir?
Particionamiento de datos: El secreto detrás de las bases rápidas
AWS Glue: El secreto detrás de los grandes pipelines de datos
Linaje de datos: El mapa oculto detrás de cada dato
Arquitectura medallion: El secreto detrás de los datos limpios
