
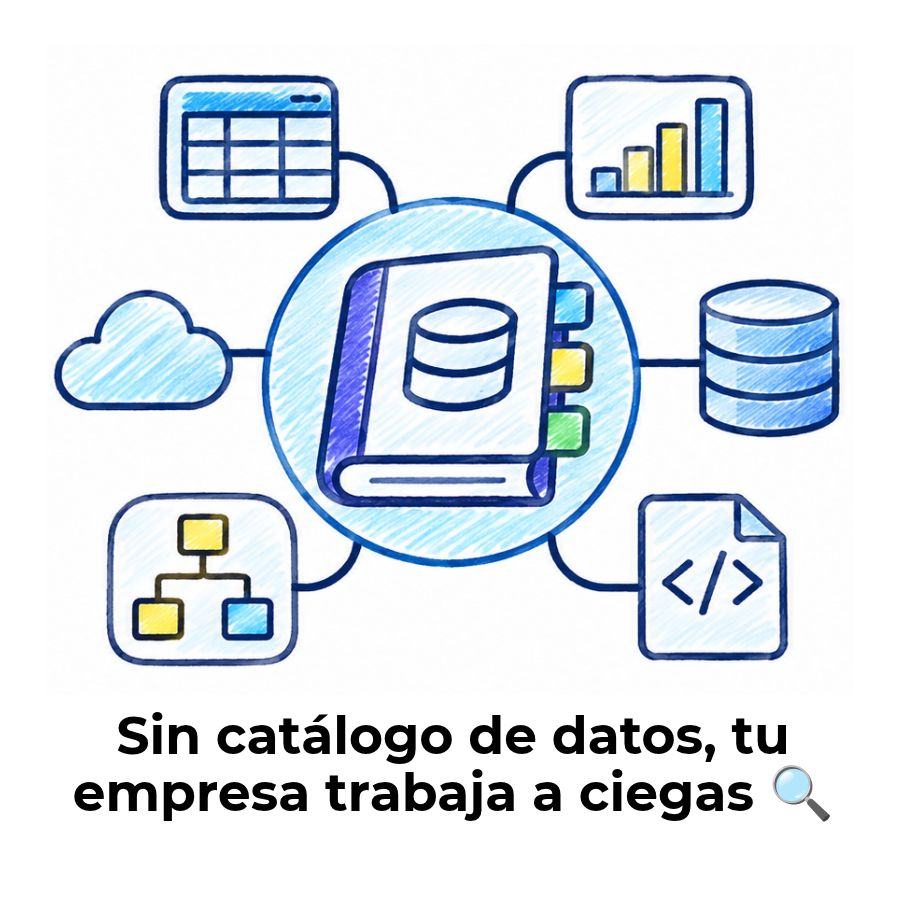
Imagina que llegas al trabajo y necesitas una tabla con ventas del último trimestre. Preguntas a un compañero, te manda a otro, y ese tercero tampoco sabe con certeza si la información está actualizada. Eso tiene solución, y se llama catálogo de datos.
¿Qué es un catálogo de datos?
Un catálogo de datos es un inventario centralizado y organizado de todos los activos de datos de una organización. Su función principal es documentar qué datos existen, dónde están almacenados, quién es responsable de ellos y cómo se relacionan entre sí. Piensa en él como el índice de una biblioteca gigante: no contiene los libros, pero te dice exactamente dónde encontrar cada uno.
Desde el punto de vista técnico, un catálogo de datos opera sobre los metadatos, es decir, sobre la información que describe a los datos. Cuando un analista necesita una tabla específica, no tiene que preguntar a varios colegas ni explorar decenas de sistemas: consulta el catálogo y obtiene la respuesta de forma directa, con contexto completo y confiable.
¿Qué almacena un catálogo de datos y qué no?
Una de las confusiones más frecuentes al acercarse a este concepto es pensar que el catálogo guarda los datos directamente. No es así. Un catálogo de datos almacena únicamente metadatos: nombres de tablas, esquemas, descripciones, propietarios, etiquetas y relaciones. La conexión con la fuente original es de solo lectura y extrae estructura, no contenido.
| ¿Qué SÍ almacena? | ¿Qué NO almacena? |
|---|---|
| Nombres de tablas y columnas | Filas de datos reales |
| Tipos de datos y esquemas | Imágenes, documentos o archivos |
| Propietario y responsable del dato | Contraseñas o credenciales de acceso |
| Fecha de última actualización | Resultados de consultas SQL |
| Linaje y trazabilidad del dato | Datos personales sensibles sin anonimizar |
| Etiquetas de clasificación y sensibilidad | Backups o réplicas de bases de datos |
Componentes de un catálogo de datos
Para cumplir sus funciones correctamente, un catálogo de datos se organiza en varios elementos que trabajan juntos. Cada componente aporta una capa distinta de información que, sumada al resto, ofrece una visión completa y útil de cada activo de datos dentro de la organización.
Metadatos técnicos
Los metadatos técnicos son el punto de partida de cualquier catálogo. Describen la estructura interna de los datos: nombres de tablas, tipos de columnas, esquemas, formatos de archivo y la frecuencia con que se actualizan. En la mayoría de los casos, estos metadatos se recopilan de forma automática mediante conectores que se integran con las fuentes de datos existentes.
Metadatos de negocio
Mientras que los metadatos técnicos describen cómo está construido un dato, los metadatos de negocio explican qué significa y quién lo gestiona. Incluyen la descripción del activo, el propietario asignado, las etiquetas temáticas y el nivel de sensibilidad (por ejemplo, si contiene información personal o confidencial). Este tipo de metadato suele enriquecerse manualmente por personas del equipo de datos o del área de negocio.
Linaje de datos
El linaje de datos registra el recorrido completo de un dato: desde dónde se originó, qué transformaciones sufrió y en qué sistemas o informes terminó siendo utilizado. Este componente es clave para entender el impacto de cualquier cambio en el pipeline: si modificas una tabla en el origen, el linaje te muestra exactamente qué reportes o modelos downstream se verán afectados.
Glosario de negocio y diccionario de datos
El glosario de negocio reúne los términos que usa la organización y les da una definición estándar para que todos los equipos hablen el mismo idioma. El diccionario de datos, por su parte, describe campo a campo el significado técnico de cada variable. Juntos, cierran la brecha entre el lenguaje del área de negocio y el lenguaje técnico del equipo de ingeniería de datos.
¿Para qué sirve un catálogo de datos?
Más allá de ser un repositorio de metadatos, un catálogo de datos resuelve problemas concretos del día a día en los equipos que trabajan con información. Sus beneficios se perciben desde la primera semana de uso, especialmente en organizaciones donde los datos están dispersos entre muchos sistemas y equipos.
Descubrimiento y búsqueda de datos
Sin un catálogo, encontrar el conjunto de datos correcto puede llevar horas o días. Con él, cualquier miembro del equipo puede buscar por nombre, etiqueta, propietario o descripción y llegar al activo que necesita en segundos. El catálogo actúa como un motor de búsqueda interno de los activos de datos, sin necesidad de acceder directamente a los sistemas donde están almacenados.
Calidad y confiabilidad de los datos
Cuando se ingresa un nuevo conjunto de datos al catálogo, se pueden asociar métricas de calidad, registros de auditoría y fechas de última actualización. Esto permite que cualquier usuario sepa de antemano si un dato es confiable antes de usarlo en un análisis o en un modelo de machine learning, reduciendo decisiones basadas en información incorrecta o desactualizada.
Apoyo al gobierno de datos
El catálogo de datos es uno de los pilares del gobierno de datos en cualquier organización. Gracias a él, es posible definir roles y responsabilidades sobre cada activo, aplicar políticas de acceso, gestionar datos sensibles y cumplir con normativas de privacidad. Sin catálogo, el gobierno de datos se convierte en un ejercicio teórico sin respaldo práctico.
¿Para qué se usa realmente un catálogo de datos?
Búsqueda de datos
Localizar el activo correcto sin preguntar a nadie.
Control de calidad
Conocer el estado y fiabilidad de los datos antes de usarlos.
Trazabilidad
Ver el recorrido completo del dato desde su origen.
Cumplimiento normativo
Identificar y proteger datos sensibles con facilidad.
Tipos de catálogos de datos
No todos los catálogos de datos funcionan de la misma manera. Según cómo gestionan los metadatos y cómo se integran con el resto de la infraestructura, existen dos enfoques principales que determinan su arquitectura y comportamiento dentro de la organización.
Catálogo independiente (stand-alone)
En este enfoque, cada sistema o entidad mantiene su propio catálogo de forma autónoma, con metadatos activos que no se comparten automáticamente con otros sistemas. Es útil en entornos donde los dominios de datos están claramente separados y cada área necesita gestionar su propio inventario sin depender de una plataforma central compartida.
Catálogo integrado (embedded)
El catálogo integrado opera con metadatos pasivos y todos los sistemas de la organización comparten un único repositorio centralizado. Cualquier equipo accede a la misma información desde la misma fuente, lo que elimina inconsistencias y facilita la colaboración entre áreas. Este es el modelo predominante en organizaciones con grandes volúmenes de datos y múltiples equipos consumidores.
| Característica | Catálogo independiente | Catálogo integrado |
|---|---|---|
| Tipo de metadatos | Activos (propios de cada sistema) | Pasivos (compartidos centralmente) |
| Gestión | Descentralizada por dominio | Centralizada en una sola plataforma |
| Colaboración entre equipos | Limitada | Alta |
| Complejidad de implementación | Baja | Media-alta |
| Ideal para | Organizaciones pequeñas o por dominio | Grandes organizaciones con múltiples fuentes |
¿Cómo se construye un catálogo de datos?
Construir un catálogo de datos no requiere empezar desde cero con toda la información de la organización. El proceso funciona mejor cuando se aborda de forma incremental, comenzando con las fuentes más críticas y expandiendo el inventario con el tiempo. A continuación se describen las tres etapas fundamentales.
Recopilación de metadatos
El primer paso consiste en conectar el catálogo con las fuentes de datos de la organización: bases de datos relacionales, data lakes, almacenes en la nube, herramientas ETL y APIs. La recopilación puede ser automática mediante conectores nativos que extraen esquemas, tipos de datos y frecuencias de actualización sin intervención manual. Esta fase genera los metadatos técnicos base del catálogo.
Clasificación y etiquetado
Una vez recopilados los metadatos técnicos, el siguiente paso es enriquecerlos con contexto de negocio. Los responsables de cada activo añaden descripciones, asignan propietarios, aplican etiquetas temáticas y marcan el nivel de sensibilidad de los datos. Este enriquecimiento manual convierte un inventario técnico en un recurso útil para toda la organización, incluyendo perfiles no técnicos como analistas de negocio o directivos.
Publicación y mantenimiento
El catálogo solo tiene valor si está actualizado. Por eso, el mantenimiento continuo es la etapa más importante a largo plazo: hay que definir quién es responsable de actualizar cada activo, establecer alertas cuando un dato queda desactualizado y revisar periódicamente la calidad de los metadatos. Un catálogo abandonado pierde su utilidad rápidamente y genera desconfianza entre los equipos.
Proceso de construcción de un catálogo de datos
① Recopilación
Conectar fuentes y extraer metadatos técnicos de forma automática.
② Clasificación
Enriquecer con descripciones, propietarios, etiquetas y sensibilidad.
③ Mantenimiento
Mantener el catálogo actualizado con responsables y alertas periódicas.
Herramientas populares de catálogo de datos
El mercado ofrece opciones que van desde plataformas comerciales de nivel empresarial hasta soluciones de código abierto listas para instalar. La elección depende del tamaño del equipo, el stack tecnológico existente y el presupuesto disponible. Conocer las opciones más consolidadas te permite tomar una decisión informada antes de comenzar cualquier implementación.
| Herramienta | Tipo | Destacado por | Ideal para |
|---|---|---|---|
| Apache Atlas | Open source | Linaje y gobernanza en ecosistemas Hadoop | Equipos con infraestructura on-premise |
| DataHub (LinkedIn) | Open source | Linaje técnico muy potente y flexible | Ingenieros con stacks modernos |
| OpenMetadata | Open source | Interfaz moderna y fácil de integrar | Equipos que empiezan desde cero |
| Alation | Comercial | Adopción por usuarios de negocio | Organizaciones maduras con analistas |
| Collibra | Comercial | Gestión de políticas y cumplimiento normativo | Grandes empresas reguladas |
| Atlan | Comercial | Integración moderna con dbt, Fivetran, Snowflake | Stacks analíticos cloud-native |
| IBM Watson Knowledge Catalog | Comercial | IA integrada y gobierno centralizado | Empresas con stack IBM / casos de ML |
| Google Dataplex Universal Catalog | Cloud gestionado | Integración nativa con BigQuery y Google Cloud | Organizaciones en ecosistema GCP |
Las herramientas ETL que alimentan las fuentes de datos suelen integrarse de forma nativa con los catálogos más modernos. Si quieres entender cómo los datos llegan desde su origen hasta el catálogo, revisar las herramientas ETL más usadas en el sector te dará un contexto muy valioso para comprender el flujo completo.
Catálogo de datos vs. conceptos relacionados
El catálogo de datos convive con otros conceptos que a veces generan confusión. Entender las diferencias entre ellos es necesario para saber qué herramienta usar en cada situación y cómo encajan dentro de una arquitectura de datos moderna. Estos tres elementos son complementarios, no intercambiables.
El catálogo de datos responde «¿qué datos tenemos y dónde están?», el data lake responde «¿dónde guardamos los datos?» y el glosario de negocio responde «¿qué significan esos datos?». Los tres juntos forman la columna vertebral de una gestión de datos madura, pero cada uno tiene un propósito distinto y no puede reemplazar a los demás.
«Un catálogo de datos moderno solo almacena metadatos: nombres de tablas, columnas, descripciones, etiquetas y relaciones. La conexión a las fuentes es de solo lectura.»
Ejemplo visual: así luce un catálogo de datos
Para entender cómo se estructura un catálogo de datos en la práctica, nada mejor que ver un ejemplo real con datos representativos. La siguiente tabla muestra cómo se documentaría un activo de datos típico dentro de un catálogo, con todos sus campos de metadatos técnicos y de negocio completados.
| Campo del catálogo | Tipo de metadato | Ejemplo de valor | Descripción del campo |
|---|---|---|---|
| Nombre del activo | Técnico | ventas_trimestre_q3_2024 | Nombre único del dataset o tabla en el sistema de almacenamiento |
| Descripción | Negocio | Registro de ventas por producto y región para el tercer trimestre de 2024 | Texto que explica qué contiene el activo y para qué se usa |
| Propietario | Negocio | equipo-analitica@empresa.com | Persona o equipo responsable de la calidad y actualización del dato |
| Sistema de origen | Técnico | CRM Salesforce → Data Warehouse BigQuery | Fuente original del dato y sistema donde se almacena actualmente |
| Formato | Técnico | Tabla SQL / Parquet | Formato en que están almacenados los datos |
| Frecuencia de actualización | Operacional | Diaria (00:30 UTC) | Con qué periodicidad se refresca la información del activo |
| Última actualización | Operacional | 2024-11-08 00:31:12 UTC | Fecha y hora exacta del último refresco de datos confirmado |
| Columnas principales | Técnico | id_venta, fecha, producto_id, región, importe_eur, canal | Listado de campos más relevantes con sus tipos de datos asociados |
| Nivel de sensibilidad | Negocio | Interno — No contiene datos personales | Clasificación de confidencialidad según política de gobierno de datos |
| Etiquetas temáticas | Negocio | #ventas #crm #analítica #q3-2024 | Palabras clave que facilitan la búsqueda y clasificación del activo |
| Linaje (origen) | Linaje | Salesforce Opportunities → ETL pipeline → BigQuery dataset | Trazabilidad del dato desde su creación hasta el almacén actual |
| Consumidores conocidos | Operacional | Dashboard Looker «Ventas Q3», Modelo ML forecasting_ventas_v2 | Sistemas, reportes o modelos que consumen activamente este activo |
| Métricas de calidad | Calidad | Completitud: 99,2% • Duplicados: 0,1% • Nulos en importe: 0% | Indicadores que reflejan el estado actual de la calidad del dato |
| Acceso | Gobernanza | Equipo de Analítica, Dirección Comercial (previa solicitud) | Roles y equipos con permisos de lectura sobre este activo |
| Términos del glosario vinculados | Negocio | «Venta confirmada», «Canal digital», «Región comercial» | Términos del glosario de negocio que definen conceptos usados en este activo |
Este ejemplo refleja cómo un único activo de datos puede documentarse de forma completa dentro de un catálogo. Cada fila representa un campo que aporta valor a un perfil diferente: los campos técnicos interesan al ingeniero, los de negocio al analista, los de calidad al responsable de gobierno y los de acceso al equipo de seguridad. Toda esa información convive en un mismo registro del catálogo.
Gestionar correctamente estos activos forma parte del trabajo cotidiano en la ingeniería de datos. Si quieres entender mejor el contexto en el que opera un catálogo dentro de una organización, profundizar en el campo completo te dará una visión mucho más sólida.
Preguntas frecuentes
¿Qué diferencia hay entre un catálogo de datos y un diccionario de datos?
El diccionario de datos describe campo a campo el significado técnico de cada variable dentro de un conjunto de datos: tipos, formatos, restricciones y reglas de validación. El catálogo de datos es más amplio: incluye el diccionario, pero añade metadatos de negocio, linaje, propietario, calidad y capacidades de búsqueda que permiten descubrir activos en toda la organización. El diccionario responde «¿qué significa este campo?» y el catálogo responde «¿qué datos tenemos, dónde están y quién los gestiona?».
¿Un catálogo de datos almacena los datos reales de la empresa?
No. Un catálogo de datos almacena únicamente metadatos, es decir, información sobre los datos: su nombre, estructura, origen, propietario y relaciones. La conexión con la fuente original es de solo lectura y extrae estructura, no contenido. Los datos reales permanecen en sus sistemas de origen: bases de datos, data lakes o almacenes en la nube. Esta distinción es importante tanto desde el punto de vista técnico como de privacidad.
¿Qué relación tiene el catálogo de datos con el gobierno de datos?
El catálogo de datos es uno de los componentes operativos más importantes del gobierno de datos. Mientras que el gobierno establece las políticas, roles y estándares que debe seguir la organización, el catálogo es la herramienta que hace posible aplicar esas políticas en la práctica: quién tiene acceso a qué dato, qué datos son sensibles, quién es el responsable de cada activo y cómo se garantiza su calidad. Sin catálogo, el gobierno de datos se queda en el plano teórico.
¿Qué es el linaje de datos dentro de un catálogo?
El linaje de datos es el registro del recorrido completo de un dato: desde dónde se originó, qué transformaciones sufrió en el camino y en qué sistemas, reportes o modelos terminó siendo utilizado. Dentro del catálogo, el linaje te permite entender el impacto de cualquier cambio: si modificas una tabla en el origen, puedes ver exactamente qué dashboards, pipelines o modelos se verán afectados antes de hacer el cambio.
¿Cuándo necesita una organización un catálogo de datos?
Una organización empieza a necesitar un catálogo de datos cuando los equipos pierden tiempo buscando información, cuando existen dudas sobre qué versión de un dato es la correcta o cuando diferentes áreas usan los mismos términos con significados distintos. No hay un umbral de tamaño para empezar: incluso equipos pequeños con cinco o diez fuentes de datos se benefician de tener un inventario ordenado. El catálogo se vuelve imprescindible cuando la falta de contexto sobre los datos comienza a afectar la calidad de las decisiones.
¿Qué son los metadatos en un catálogo de datos?
Los metadatos son datos que describen a otros datos. En el contexto de un catálogo, incluyen información técnica como el nombre de las tablas, los tipos de columnas y el origen del sistema, pero también información de negocio como la descripción del activo, su propietario y su nivel de sensibilidad. Sin metadatos, un catálogo de datos es simplemente una lista vacía: son ellos los que le dan utilidad y contexto a cada activo registrado.
¿Qué herramientas de código abierto existen para crear un catálogo de datos?
Las tres herramientas de código abierto más consolidadas son Apache Atlas, especialmente útil en ecosistemas Hadoop y entornos on-premise; DataHub, desarrollado originalmente por LinkedIn y muy potente para gestionar linaje técnico en stacks modernos; y OpenMetadata, una opción más reciente con una interfaz moderna y una integración ágil con fuentes de datos variadas. Las tres son gratuitas y tienen comunidades activas que publican documentación, integraciones y actualizaciones con regularidad.
Conclusión
Un catálogo de datos es mucho más que una lista de tablas: es el sistema que permite a tu organización saber qué información tiene, dónde está, quién la gestiona y si es confiable. Sin ese conocimiento centralizado, trabajar con datos se convierte en un proceso lento, propenso a errores y difícil de escalar.
A lo largo de este artículo has visto qué contiene un catálogo, cómo se construye paso a paso, qué tipos existen y qué herramientas puedes usar para implementarlo. Con esa base, ya puedes evaluar qué opción encaja mejor con tu stack tecnológico, el tamaño de tu equipo y los problemas concretos que quieres resolver.
Si este tema te genera más preguntas, en este sitio web encontrarás más contenido sobre ingeniería de datos, gobierno de datos y arquitecturas modernas que te ayudarán a construir una visión completa del campo. Cada concepto que domines hoy se convierte en una herramienta más sólida para el trabajo de mañana.
Sigue aprendiendo:
¿Qué es un data warehouse y para qué sirve?
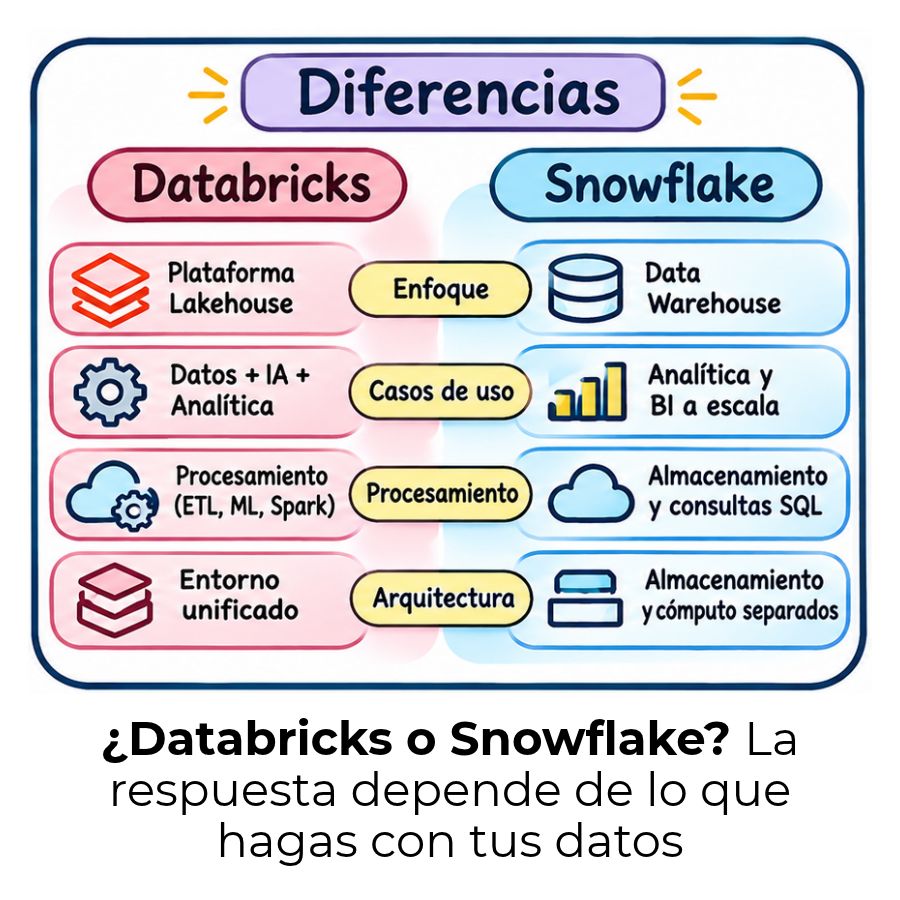
Diferencia entre Databricks y Snowflake
Arquitectura de datos: El secreto que mueve los datos de tu empresa
Ingeniería en Análisis / Ciencia de Datos
Modelado dimensional: Organiza datos para tomar mejores decisiones
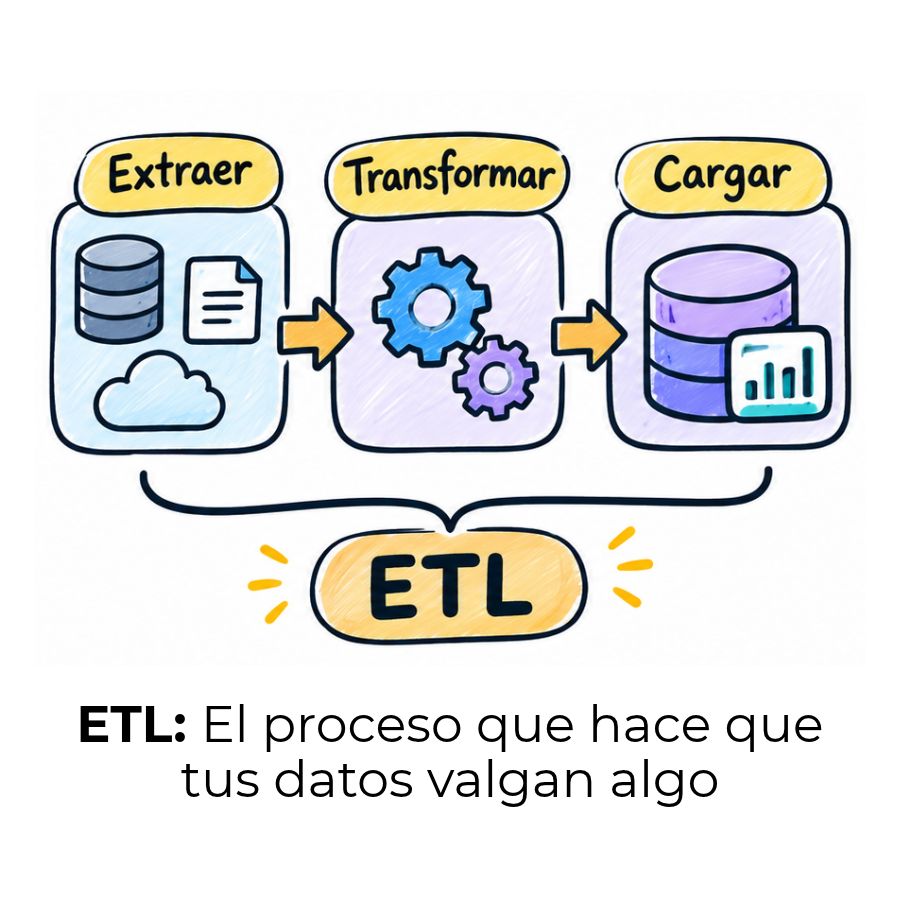
¿Qué es ETL? – Extracción, Transformación y Carga
ETL con Python: Extrae, transforma y carga datos
Diferencia entre data lake y data warehouse
