
Armar un portafolio de ingeniería de datos puede parecer difícil si no sabes por dónde empezar. Pero la buena noticia es que hay proyectos concretos, ordenados por nivel, que puedes construir desde hoy mismo usando datos públicos y herramientas gratuitas. Aquí encuentras las mejores opciones, desde un ETL básico hasta pipelines en la nube, con todo lo que necesitas para presentarlos bien.
¿Qué es un portafolio de ingeniería de datos?
Un portafolio de ingeniería de datos es una colección de proyectos funcionales que demuestran tu capacidad para diseñar, construir y mantener flujos de datos reales. No es un documento de presentación ni una lista de tecnologías que «conoces»: es evidencia concreta de que puedes resolver los problemas que enfrentan los equipos de datos en las empresas.
A diferencia de un CV tradicional, el portafolio te permite mostrar cómo piensas, cómo estructuras un problema y qué decisiones técnicas tomas cuando trabajas con datos. Es la herramienta más poderosa que tienes para conseguir una entrevista, especialmente si no tienes experiencia laboral formal en el área.
¿Por qué los proyectos prácticos pesan más que los certificados?
Un certificado confirma que seguiste un curso hasta el final. Un proyecto demuestra que sabes qué hacer cuando las cosas no funcionan como el tutorial prometía. Los equipos de ingeniería contratan personas que resuelven problemas reales, no quienes repiten procedimientos en entornos controlados.
Además, un proyecto bien documentado en GitHub actúa como una entrevista técnica anticipada: el reclutador ve tu razonamiento, tus elecciones de diseño y la calidad de tu código antes incluso de hablar contigo. Eso convierte cada proyecto en una oportunidad de demostrar lo que vales.
Proyectos para principiantes paso a paso
Cuando empiezas en ingeniería de datos, el objetivo no es construir el sistema más complejo, sino demostrar que entiendes el ciclo completo de los datos: desde que llegan en bruto hasta que están listos para ser analizados. Los siguientes proyectos cubren ese ciclo con herramientas usadas en entornos profesionales reales.
Pipeline ETL con datos abiertos y Python
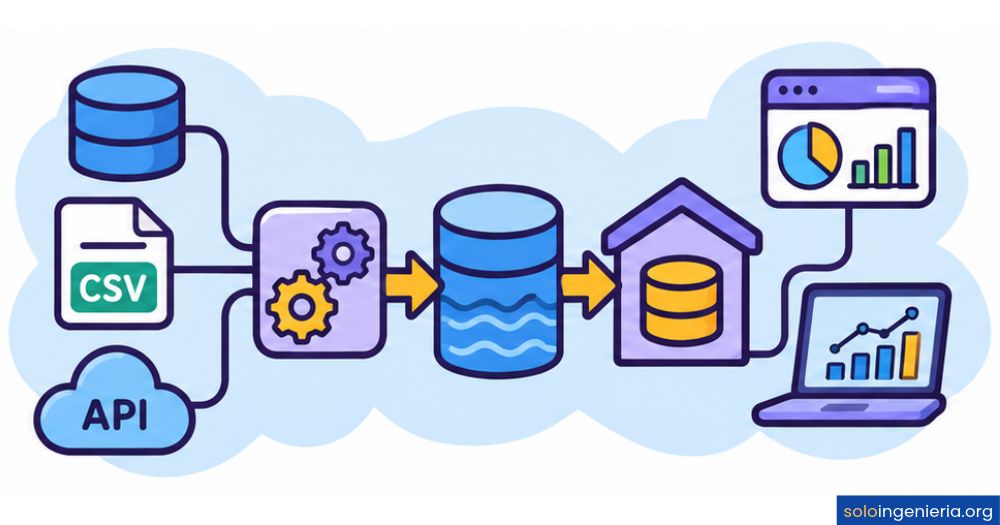
Un pipeline ETL (Extraer, Transformar y Cargar) es el proyecto de entrada más valorado por los reclutadores. La idea es sencilla: tomas datos de una fuente pública en formato CSV, los limpias con pandas y los cargas en una base de datos como PostgreSQL o directamente en un servicio de nube como BigQuery.
Lo que hace interesante este proyecto no es la dificultad técnica, sino la decisión de qué transformaciones aplicar y por qué. Documentar cada paso de transformación con una justificación clara convierte un ejercicio simple en evidencia de criterio técnico, que es exactamente lo que un equipo de datos quiere ver.
🛠️ Cómo construir tu primer pipeline ETL
- Elige un dataset público — Kaggle, datos.gob.es o cualquier API abierta de tu interés (clima, transporte, economía).
- Extrae los datos — Con Python y la librería
requestso leyendo un CSV directamente. - Transforma con pandas — Elimina duplicados, normaliza formatos de fecha, maneja valores nulos.
- Carga en un destino — PostgreSQL local para comenzar; BigQuery o Snowflake si quieres sumar experiencia cloud.
- Automatiza la ejecución — Un script con
scheduleo un DAG básico en Airflow te da un punto extra inmediato. - Publica en GitHub — Con un README que explique el problema, las decisiones y los resultados.
Sistema de recolección de datos desde APIs públicas
Este proyecto consiste en conectarte a una API pública —de clima, criptomonedas, transporte urbano o datos deportivos— y construir un sistema que extraiga datos de forma periódica, los almacene en una base de datos y los mantenga actualizados sin intervención manual. Es el tipo de tarea que los ingenieros de datos ejecutan a diario.
La clave para que este proyecto destaque en tu portafolio está en mostrar el historial de ejecuciones: capturas del log de tareas, registros en la base de datos con fechas y una explicación de cómo manejas los errores de conexión. Un sistema que lleva semanas ejecutándose sin fallos demuestra fiabilidad, y eso es uno de los valores más difíciles de acreditar sin proyectos reales.
Monitoreo de calidad de datos con pandas
La calidad de los datos es uno de los problemas más costosos para cualquier empresa que depende de ellos. Construir un sistema básico de monitoreo —que detecte valores nulos inesperados, rangos fuera de lo normal o registros duplicados— demuestra que piensas más allá de mover datos y que entiendes el impacto que tiene un dato corrupto en las decisiones de negocio.
Para este proyecto puedes usar pandas junto con la librería great_expectations, que permite definir reglas de validación y generar reportes automáticos. Presentar un reporte visual de calidad generado automáticamente convierte este proyecto en una pieza memorable dentro de cualquier portafolio de principiante.
Proyectos de nivel intermedio para destacar
Una vez que tienes claro cómo funciona un ETL básico, el siguiente paso es trabajar con volúmenes de datos mayores, herramientas de orquestación y arquitecturas pensadas para escalar. Los proyectos intermedios son los que más aparecen en las descripciones de puestos de entrada y nivel medio en el mercado.
Pipeline en tiempo real con Apache Kafka
Apache Kafka es el estándar de la industria para procesar flujos de datos continuos. Un proyecto típico con Kafka consiste en crear un productor que envía eventos —por ejemplo, transacciones simuladas o lecturas de sensores— a un tópico, y un consumidor que los procesa y almacena en tiempo real en una base de datos o sistema de visualización.
Aunque parece intimidante al principio, puedes montar Kafka localmente con Docker en pocas horas. El valor de este proyecto está en entender la diferencia entre procesamiento por lotes y procesamiento en tiempo real, que es una distinción fundamental que todo ingeniero de datos debe dominar antes de trabajar con sistemas de producción.
Data warehouse con dbt y BigQuery
dbt (data build tool) permite escribir transformaciones SQL como si fueran código versionado, con pruebas y documentación integradas. Combinado con BigQuery —que tiene una capa gratuita generosa— puedes construir un pipeline ELT completo donde los datos brutos llegan al warehouse y dbt se encarga de transformarlos en modelos listos para análisis.
Este proyecto introduce conceptos de modelado que son directamente aplicables al trabajo diario. Para profundizar en cómo organizar esos modelos dentro del warehouse, resulta muy útil entender la diferencia entre el esquema en estrella vs. copo de nieve, dos enfoques que definen cómo se estructuran las tablas de dimensiones y hechos en cualquier data warehouse moderno.
Análisis de datos de transporte o clima
Los datasets de transporte público y datos meteorológicos son ideales para proyectos intermedios porque son ricos, públicos y presentan problemas reales: valores faltantes, formatos inconsistentes, registros duplicados y necesidad de combinar varias fuentes. Trabajar con ellos obliga a tomar decisiones de diseño que no aparecen en los cursos estándar.
Un proyecto concreto puede consistir en extraer datos históricos de temperatura de una API pública, almacenarlos en un warehouse, modelarlos con dbt y crear un dashboard con Metabase o Looker Studio. El dashboard final convierte datos abstractos en algo visualmente comprensible, lo que facilita que el reclutador entienda el valor del proyecto en segundos.
¿Qué proyectos avanzados te abren puertas laborales?
Los proyectos avanzados no son los más complejos por su dificultad técnica pura, sino por la cantidad de decisiones de arquitectura que involucran. Cuando un reclutador los ve, entiende que el candidato sabe diseñar sistemas que funcionan a escala y que pueden mantenerse en el tiempo sin convertirse en deuda técnica.
Arquitectura Data Lake en AWS o Azure
Un Data Lake es un repositorio centralizado donde los datos se almacenan en su formato original —estructurado, semiestructurado o no estructurado— antes de ser procesados. En AWS, el flujo típico consiste en ingestar datos en S3, catalogarlos con AWS Glue y consultarlos con Amazon Athena o cargarlos en Redshift para análisis más complejos.
En Azure, el equivalente es Azure Data Lake Storage con Azure Data Factory para la ingesta y Azure Synapse para el análisis. Implementar una arquitectura medallón (bronce, plata y oro) dentro del Data Lake —donde cada capa representa un nivel de refinamiento del dato— es uno de los proyectos más completos que puedes mostrar en un portafolio avanzado, porque replica exactamente cómo trabajan los equipos de datos en empresas medianas y grandes.
Orquestación de flujos con Apache Airflow
Apache Airflow permite definir flujos de trabajo como código Python usando DAGs (grafos acíclicos dirigidos). Cada nodo del grafo representa una tarea —extraer datos, transformarlos, cargarlos, enviar una alerta— y Airflow se encarga de ejecutarlas en el orden correcto, manejar los errores y registrar el historial de ejecuciones.
Un proyecto concreto puede consistir en orquestar un pipeline completo que extrae datos de varias fuentes, los transforma con dbt y los carga en un warehouse cada noche. Mostrar capturas del panel de Airflow con el historial de ejecuciones exitosas durante varias semanas es una señal muy clara de que el proyecto está operativo y no es solo código sin ejecutar.
Pipeline de observabilidad y calidad en producción
Un pipeline de observabilidad monitorea la salud de los datos en cada etapa del flujo: detecta anomalías en volumen, valores fuera de rango estadístico o cambios inesperados en el esquema. Este tipo de proyecto muestra que sabes pensar en los datos como un sistema que puede fallar, no como un proceso lineal que siempre funciona.
Puedes construirlo combinando great_expectationsparalas validaciones, Airflow para la orquestación y un dashboard sencillo para visualizar las métricas de calidad. Este proyecto es especialmente valorado en entrevistas porque demuestra mentalidad de producción, una habilidad que distingue a un ingeniero junior de uno con criterio real de ingeniería.
¿Cómo estructurar y presentar tu portafolio?
Tener proyectos bien construidos es solo la mitad del trabajo. La otra mitad es presentarlos de manera que cualquier persona —técnica o no— pueda entender qué problema resolviste, qué herramientas usaste y qué resultados obtuviste. Un proyecto sin buena documentación pasa desapercibido aunque el código sea excelente.
GitHub como repositorio principal de proyectos
GitHub es la plataforma estándar para publicar y compartir proyectos de ingeniería de datos. Más allá de ser un lugar para guardar código, tu perfil de GitHub funciona como una vitrina profesional: los reclutadores lo consultan antes de la entrevista para evaluar la calidad de tu trabajo, la frecuencia de tus commits y cómo organizas tus repositorios.
Cada proyecto debe tener su propio repositorio, con un nombre descriptivo y una estructura de carpetas clara. Separa los scripts de ingesta, los modelos de transformación, los archivos de configuración y los notebooks de exploración en carpetas distintas. Un repositorio ordenado comunica que sabes trabajar en equipo y que tu código está pensado para que otros lo entiendan.
README efectivo: qué debe incluir sí o sí
El README es lo primero que lee cualquier persona que entra a tu repositorio. Si no explica claramente de qué trata el proyecto en los primeros diez segundos, el visitante cierra la página. No importa cuán sofisticado sea el código si el README no comunica su valor.
📄 Estructura recomendada para un README de ingeniería de datos
✅ Lo que no puede faltar
- Descripción del problema que resuelve
- Arquitectura del pipeline (diagrama o texto)
- Herramientas y versiones utilizadas
- Instrucciones para reproducirlo
- Capturas o resultados del proyecto
❌ Lo que hace daño
- Solo el título del curso del que salió
- Sin instrucciones de instalación
- Código sin comentarios ni contexto
- README genérico copiado de una plantilla
- Sin evidencia de que el proyecto corre
Errores comunes al publicar proyectos de datos
El error más frecuente es subir proyectos que nunca se ejecutaron más allá del notebook del curso. Si el código depende de datos que no están en el repositorio o de credenciales que no se pueden reproducir, el proyecto no comunica nada útil. Siempre incluye los datos de muestra o instrucciones para obtenerlos, y nunca subas credenciales reales al repositorio.
Otro error habitual es publicar diez proyectos mediocres en lugar de tres sólidos. Un portafolio con dos o tres proyectos bien documentados, con código limpio y resultados visibles, genera más confianza que diez repositorios a medio terminar. La calidad siempre gana a la cantidad cuando se trata de portafolios técnicos.
Herramientas clave según el nivel del proyecto
Elegir las herramientas adecuadas para cada nivel de proyecto evita la frustración de intentar usar tecnología avanzada sin los fundamentos necesarios. La siguiente tabla organiza las herramientas más valoradas en el mercado según el nivel de madurez del proyecto, para que puedas construir tu stack de forma progresiva.
| Nivel | Lenguajes | Herramientas de transformación | Orquestación | Almacenamiento |
|---|---|---|---|---|
| Principiante | Python, SQL | pandas, great_expectations | schedule, cron | PostgreSQL, SQLite |
| Intermedio | Python, SQL, Bash | dbt, PySpark | Apache Airflow | BigQuery, Snowflake, Redshift |
| Avanzado | Python, Scala, SQL | Spark, dbt, Delta Lake | Airflow, Prefect, Dagster | AWS S3 + Redshift, Azure ADLS, GCS |
No es necesario dominar todas las herramientas de un nivel antes de avanzar al siguiente. Lo importante es que los proyectos de tu portafolio muestren una progresión coherente: que se note que empezaste con lo básico y fuiste ganando profundidad técnica. Esa progresión es, en sí misma, una señal de aprendizaje continuo, que es una de las cualidades más buscadas en un candidato de ingeniería de datos.
Preguntas frecuentes
¿Cuántos proyectos debe tener un portafolio de ingeniería de datos?
No existe un número mágico, pero la recomendación más extendida entre los profesionales del área es contar con entre dos y cuatro proyectos bien documentados y funcionales. Lo que realmente importa no es la cantidad, sino que cada proyecto demuestre una habilidad distinta: uno puede mostrar dominio de ETL básico, otro la capacidad de orquestar flujos con Airflow y un tercero la experiencia con arquitecturas cloud. Tres proyectos sólidos y ejecutables pesan más que diez repositorios abandonados a mitad del desarrollo.
¿Qué lenguajes de programación se usan en proyectos de ingeniería de datos?
Python es el lenguaje principal en la inmensa mayoría de los proyectos de ingeniería de datos, gracias a su ecosistema de librerías especializadas: pandas para transformación, requests para consumo de APIs, SQLAlchemy para interacción con bases de datos y PySpark para procesamiento distribuido. SQL es igualmente indispensable y se usa en casi todas las etapas del pipeline, especialmente en las transformaciones dentro del warehouse. Para proyectos más avanzados con Apache Spark en su versión JVM, Scala es una opción valorada, aunque Python cubre el noventa por ciento de los casos de uso del mercado de entrada y nivel medio.
¿Dónde encuentro datos reales para mis proyectos de ingeniería de datos?
Existen varias fuentes públicas y gratuitas donde puedes encontrar datasets de calidad para tus proyectos. Kaggle ofrece miles de datasets descargables organizados por tema. Las APIs públicas de gobiernos —como datos.gob.es en España o data.gov en Estados Unidos— publican datos abiertos sobre transporte, economía y salud. Para datos en tiempo real, servicios como OpenWeatherMap, CoinGecko o la API de Reddit tienen capas gratuitas más que suficientes para construir pipelines funcionales. El criterio más importante al elegir un dataset es que el problema que resuelves con él sea comprensible para alguien que no conoce el área técnica.
¿Es necesario usar la nube para los proyectos del portafolio?
No es estrictamente necesario para los proyectos de nivel principiante, donde una base de datos local como PostgreSQL es completamente válida. Sin embargo, incluir al menos un proyecto con algún servicio cloud —BigQuery, AWS S3 o Azure Data Lake, que todos tienen capas gratuitas— añade valor real a tu portafolio porque demuestra que sabes trabajar con las mismas plataformas que usan las empresas. A partir del nivel intermedio, la experiencia cloud se vuelve casi un requisito en la mayoría de las ofertas de trabajo, por lo que conviene comenzar a explorarla cuanto antes.
¿Qué diferencia hay entre un proyecto de ingeniería de datos y uno de ciencia de datos?
Un proyecto de ingeniería de datos se centra en mover, transformar y almacenar datos de forma fiable, eficiente y escalable. El objetivo es construir la infraestructura que hace posible el análisis. Un proyecto de ciencia de datos, en cambio, parte de datos ya preparados para entrenar modelos estadísticos o de aprendizaje automático y extraer conclusiones predictivas. Dicho de otra manera, el ingeniero de datos construye la tubería; el científico de datos analiza lo que fluye por ella. En la práctica, ambos perfiles se complementan y muchos proyectos de portafolio tocan las dos disciplinas, pero la distinción es importante para orientar tu desarrollo profesional.
¿Puedo incluir proyectos de cursos en mi portafolio de ingeniería de datos?
Puedes incluirlos, pero con una condición: que los hayas transformado en algo propio. Un proyecto copiado directamente de un curso no dice nada sobre tu capacidad para resolver problemas reales. En cambio, si tomas la estructura de un proyecto de un curso y lo aplicas a un dataset diferente, cambias el problema de negocio que resuelve o añades una capa de orquestación que el curso no incluía, el resultado ya refleja criterio propio. La regla práctica es que, si dos personas del mismo curso tienen el mismo repositorio, ninguno de los dos tiene un proyecto de portafolio real.
¿Qué herramientas de orquestación son más valoradas por los reclutadores?
Apache Airflow sigue siendo la herramienta de orquestación más mencionada en las ofertas de trabajo de ingeniería de datos, especialmente en empresas medianas y grandes que ya tienen infraestructura establecida. Prefect y Dagster son alternativas modernas que ganan terreno en startups y equipos que buscan una experiencia de desarrollo más fluida. Para proyectos en la nube, los servicios nativos como AWS Step Functions, Cloud Composer de Google o Azure Data Factory también aparecen con frecuencia. Dominar Airflow antes que las otras opciones sigue siendo la apuesta más segura si tu objetivo es maximizar las oportunidades laborales en el corto plazo.
Conclusión
Un portafolio de ingeniería de datos bien construido es la herramienta más directa que tienes para demostrar que sabes hacer el trabajo antes de que te contraten. No importa si estás comenzando con un pipeline ETL básico o si ya estás diseñando arquitecturas Data Lake en la nube: cada proyecto que terminas y documentas bien suma evidencia concreta de tus capacidades.
Lo que aprendiste aquí es aplicable desde hoy: elige un dataset público que te llame la atención, construye el pipeline más simple que resuelva un problema real, publícalo en GitHub con un README claro y repite el proceso aumentando la complejidad de forma progresiva. Esa progresión visible en tu portafolio es exactamente lo que los equipos de ingeniería buscan cuando evalúan candidatos.
Si quieres seguir profundizando en los fundamentos y las herramientas que hacen posible estos proyectos, en este sitio web encontrarás más contenido sobre ingeniería de datos pensado para que avances con solidez en cada etapa de tu aprendizaje.
Sigue aprendiendo:
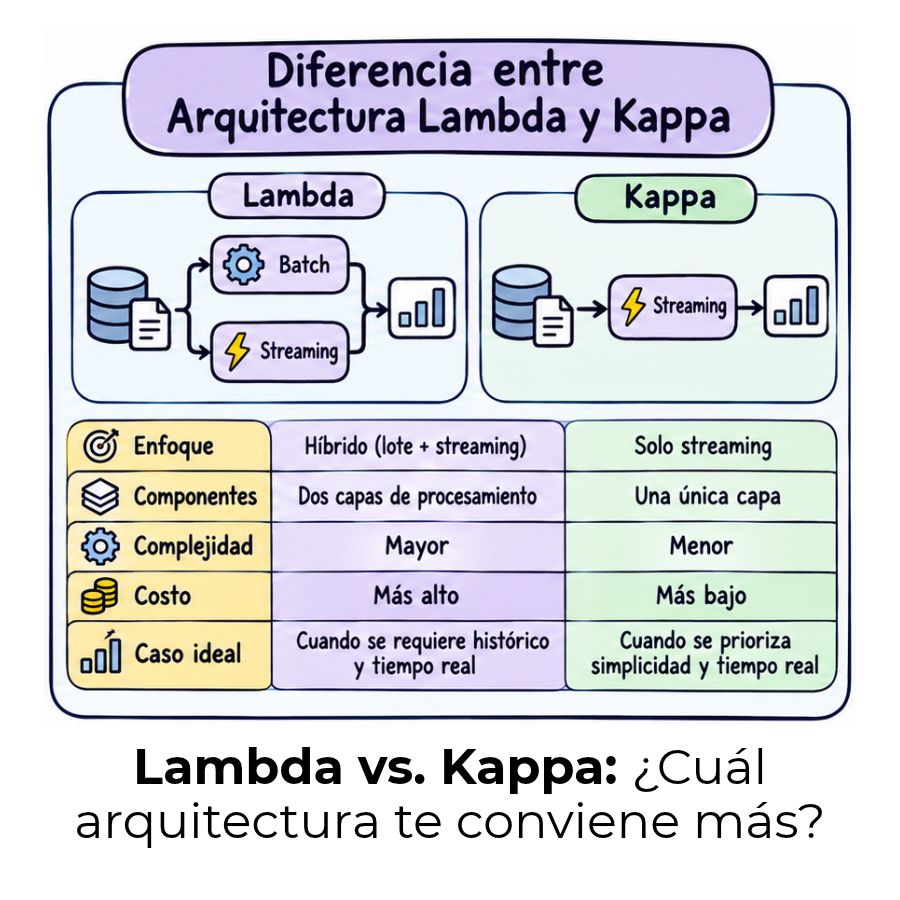
Diferencia entre arquitectura Lambda y Kappa
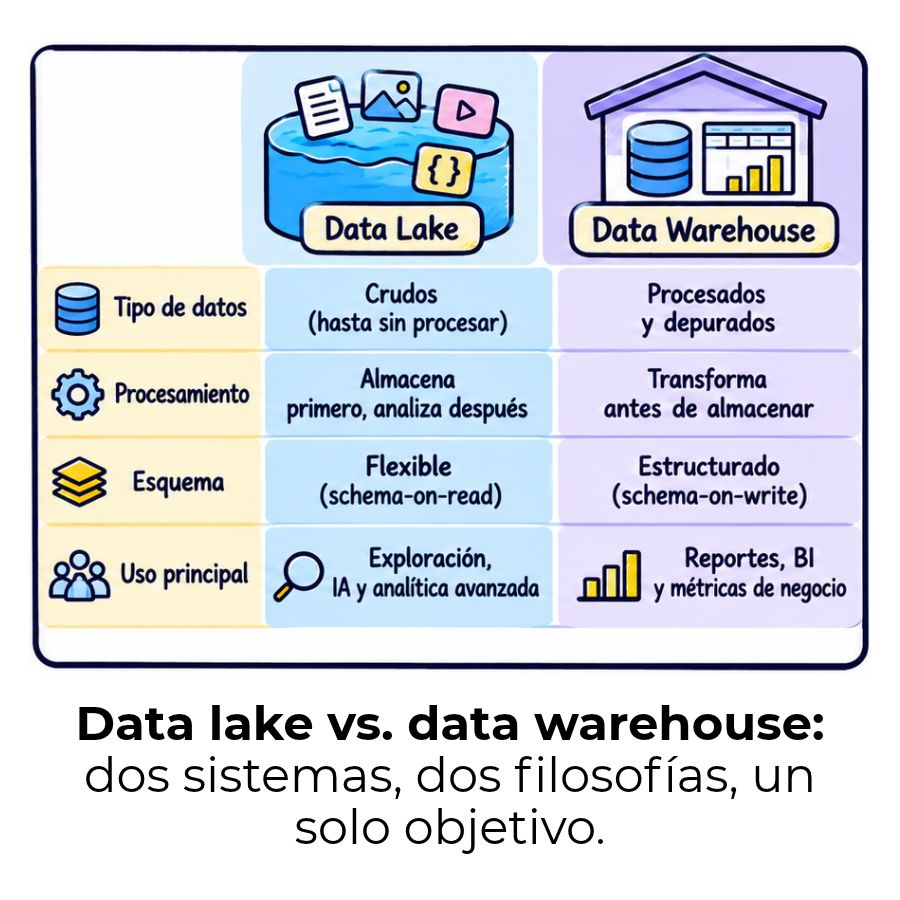
Diferencia entre data lake y data warehouse
Airflow vs. Dagster vs. Prefect: ¿Cuál elegir?
Certificaciones para ingeniero de datos
¿Cómo crear tu primer DAG en Apache Airflow?
Herramientas ETL: Elige la correcta y ahorra horas de trabajo
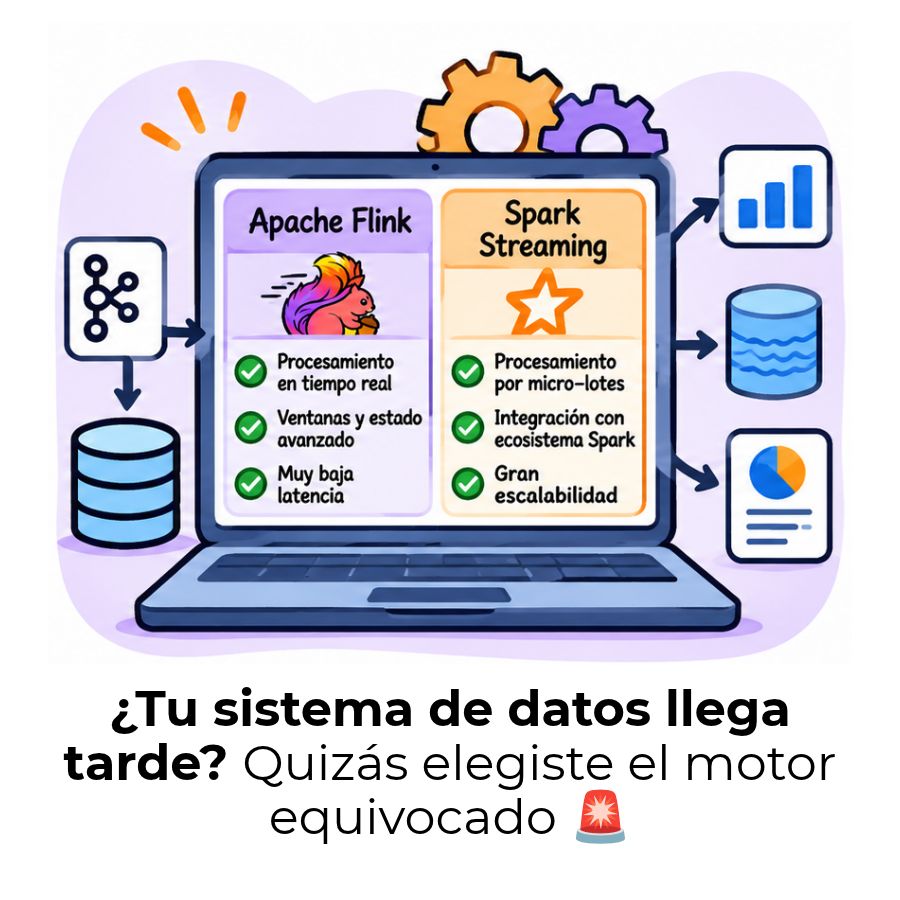
Apache Flink vs. Spark Streaming
DBT: La herramienta que cambió cómo se trabajan los datos
