
Un DAG en Apache Airflow es el archivo Python donde defines qué tareas deben ejecutarse, en qué orden y con qué frecuencia. Cuando creas tu primer DAG, estás dando el primer paso real hacia la automatización de pipelines de datos con una herramienta que usan equipos de ingeniería en todo el mundo.
¿Qué es un DAG en Apache Airflow?
Un DAG (Directed Acyclic Graph) es el elemento central de Apache Airflow: un archivo Python donde defines un conjunto de tareas, el orden en que deben ejecutarse y cuándo deben correr. La palabra «acíclico» es clave, porque significa que el flujo de trabajo siempre avanza hacia delante y nunca regresa sobre sí mismo, lo que garantiza que cada tarea se ejecute exactamente cuando le corresponde.
En términos prácticos, un DAG es el plano de tu pipeline de datos. Tú defines qué pasos existen, qué debe ocurrir antes de cada uno y con qué frecuencia debe ejecutarse todo el proceso. Airflow se encarga de leer ese plano, programarlo y ejecutarlo sin que tengas que intervenir manualmente.
Componentes clave que forman un DAG
Antes de escribir una sola línea de código, conviene entender con claridad qué piezas forman un DAG. No son muchas, pero cada una tiene un papel concreto dentro del flujo de trabajo. Conocerlas de antemano te evita confusiones cuando empieces a construir tu propio pipeline.
Tareas y operadores
Una tarea es la unidad mínima de trabajo dentro de un DAG: representa una acción concreta, como descargar un archivo, transformar datos o enviar una notificación. Cada tarea se define a través de un operador, que es la plantilla predefinida que indica cómo se ejecuta esa acción. El PythonOperator corre una función de Python, el BashOperator ejecuta comandos de terminal y el SqlOperator lanza consultas contra una base de datos.
| Operador | ¿Qué ejecuta? | Caso de uso típico |
|---|---|---|
| PythonOperator | Una función de Python | Transformar o limpiar datos |
| BashOperator | Un comando de terminal | Mover archivos, ejecutar scripts |
| EmailOperator | Un correo electrónico | Alertas y notificaciones |
| SqlOperator | Una consulta SQL | Cargar datos en una base de datos |
El scheduler y el executor
El scheduler es el cerebro de Airflow: lee continuamente los archivos DAG de la carpeta dags/, identifica qué tareas están listas para correr y las envía al executor en el momento correcto. Es importante entender que el scheduler decide cuándo debe ejecutarse cada tarea, pero no la ejecuta directamente. Esa responsabilidad recae en el executor, que gestiona cómo y dónde corren las tareas en la práctica.
Dependencias entre tareas
Las dependencias definen el orden de ejecución dentro del DAG. En Airflow se expresan con el operador >>, que indica que una tarea debe completarse antes de que comience la siguiente. Por ejemplo, extract_task >> transform_task >> load_task establece que primero se extrae, luego se transforma y finalmente se carga, sin que ningún paso se salte el orden.
¿Cómo instalar Apache Airflow en tu entorno local?
Para crear tu primer DAG, necesitas tener Airflow funcionando en tu máquina. El método más directo para un entorno de desarrollo es la instalación mediante pip en un entorno virtual de Python. Este enfoque no requiere configuración de servidores externos y te permite empezar a trabajar en pocos minutos con una configuración mínima.
Requisitos previos
Antes de instalar Airflow, asegúrate de tener cubiertos los siguientes puntos en tu sistema. Sin ellos, la instalación puede fallar o el entorno no funcionará correctamente desde el inicio.
- Python 3.8 o superior: Airflow está escrito en Python y requiere una versión reciente para funcionar sin incompatibilidades.
- pip actualizado: Ejecuta
pip install --upgrade pipantes de instalar Airflow para evitar errores de dependencias. - Un entorno virtual activo: Usar
venvocondaaísla la instalación de otros proyectos y previene conflictos entre paquetes. - Al menos 4 GB de RAM disponibles: El scheduler y el webserver corren simultáneamente, por lo que un sistema con poca memoria puede volverse lento durante las pruebas.
Instalación con pip y configuración inicial
Con el entorno virtual activo, instala Airflow usando el siguiente comando. La variable AIRFLOW_VERSION y la restricción de versiones garantizan que las dependencias sean compatibles entre sí y evitan errores durante la instalación.
bash
# Crear y activar el entorno virtual
python3 -m venv airflow-env
source airflow-env/bin/activate

# Instalar Apache Airflow
pip install apache-airflow

# Inicializar la base de datos de metadatos
airflow db init

# Crear un usuario administrador
airflow users create \
    --username admin \
    --password admin \
    --firstname Tu \
    --lastname Nombre \
    --role Admin \
    --email admin@ejemplo.com

# Iniciar el scheduler (en una terminal)
airflow scheduler

# Iniciar el servidor web (en otra terminal)
airflow webserver --port 8080
Una vez que ambos procesos están corriendo, accede a la interfaz web desde http://localhost:8080 con las credenciales que definiste. Verás el panel principal de Airflow con los DAGs de ejemplo que vienen incluidos por defecto. Ahora estás listo para escribir el tuyo.
¿Cómo crear tu primer DAG en Apache Airflow desde cero?
Crear un DAG en Airflow se reduce a escribir un archivo Python con una estructura bien definida y colocarlo en la carpeta correcta. No necesitas levantar servidores adicionales ni configurar servicios externos. Con el entorno ya listo, el proceso completo tiene cuatro partes que se construyen una sobre otra de forma natural.
Estructura del archivo Python
Todo archivo DAG sigue siempre la misma estructura base: importaciones, objeto DAG, tareas y dependencias. Esta secuencia de cuatro bloques es la que Airflow espera encontrar en cada archivo para detectarlo, parsearlo y registrarlo sin errores en la base de metadatos. Saltarte cualquiera de ellos suele generar que el DAG no aparezca en la interfaz o que arroje errores en el log del scheduler.
Definir el objeto DAG y sus argumentos
El objeto DAG se instancia con el bloque with DAG(...) as dag: y recibe los parámetros que controlan su comportamiento global. El dag_id debe ser único en todo tu entorno de Airflow, ya que es el identificador que aparece en la interfaz y en los logs. El start_date define desde cuándo Airflow considera válidas las ejecuciones, y catchup=False evita que el scheduler intente recuperar todas las ejecuciones pasadas al activar el DAG por primera vez.
python
from airflow import DAG
from airflow.operators.python import PythonOperator
from datetime import datetime

with DAG(
    dag_id="mi_primer_dag",          # Identificador único del DAG
    description="Mi primer pipeline con Airflow",
    start_date=datetime(2024, 1, 1), # Fecha desde la que aplica el schedule
    schedule_interval="@daily",      # Frecuencia de ejecución (diaria)
    catchup=False                    # No recuperar ejecuciones pasadas
) as dag:
    pass  # Aquí irán las tareas
Crear tareas con operadores
Dentro del bloque with DAG(...) as dag:, defines cada tarea usando el operador adecuado. Para tareas que ejecutan lógica de Python, el PythonOperator es el más común en los primeros pasos. Cada tarea necesita un task_id único dentro del DAG, que es el nombre con el que aparecerá en la interfaz gráfica y en los registros de ejecución.
python
from airflow import DAG
from airflow.operators.python import PythonOperator
from datetime import datetime

# Funciones que ejecutará cada tarea
def extraer():
    print("Extrayendo datos...")

def transformar():
    print("Transformando datos...")

def cargar():
    print("Cargando datos al destino...")

with DAG(
    dag_id="mi_primer_dag",
    start_date=datetime(2024, 1, 1),
    schedule_interval="@daily",
    catchup=False
) as dag:

    tarea_extraer = PythonOperator(
        task_id="extraer_datos",
        python_callable=extraer
    )

    tarea_transformar = PythonOperator(
        task_id="transformar_datos",
        python_callable=transformar
    )

    tarea_cargar = PythonOperator(
        task_id="cargar_datos",
        python_callable=cargar
    )
Establecer dependencias entre tareas
El último bloque del archivo define el orden en que las tareas deben ejecutarse. El operador >> es la forma estándar de encadenar tareas en Airflow: indica que la tarea de la derecha no puede comenzar hasta que la de la izquierda haya finalizado con éxito. Si una tarea falla, el scheduler detiene la cadena en ese punto y no continúa con las siguientes, lo que facilita identificar exactamente dónde ocurrió el problema.
python
    # Encadenamos las tareas en orden: extraer → transformar → cargar
    tarea_extraer >> tarea_transformar >> tarea_cargar
Con estas cuatro partes completas, el archivo está listo. Guárdalo como mi_primer_dag.py en la carpeta ~/airflow/dags/. El scheduler lo detectará automáticamente en la siguiente iteración de escaneo y lo registrará en la base de metadatos sin que tengas que hacer nada adicional. Para profundizar en cómo escalar estos procesos, puedes consultar cómo optimizar jobs de Apache Spark, una habilidad complementaria muy útil cuando los volúmenes de datos crecen.
¿Cómo activar y monitorear tu DAG en la interfaz web?
La interfaz web de Airflow es uno de sus puntos más valorados por los equipos de datos. Desde ahí puedes ver el estado de cada ejecución, revisar los logs de cualquier tarea y activar o pausar pipelines con un solo clic, sin tocar el código. Acceder a ella y saber leerla bien marca una diferencia importante cuando algo falla en producción.
Cargar el DAG en Airflow
Una vez que el archivo mi_primer_dag.py está en la carpeta dags/, el scheduler lo detecta automáticamente en su próximo ciclo de escaneo, que ocurre por defecto cada treinta segundos. No necesitas reiniciar ningún servicio. Si el archivo tiene errores de sintaxis, el DAG no aparecerá en la lista y verás el error marcado en la sección de importaciones fallidas dentro del panel de administración.
Usar la UI para ver el estado de las tareas
En la lista principal de DAGs verás un interruptor a la izquierda del nombre: por defecto, los DAGs nuevos están pausados. Actívalo para que el scheduler empiece a programar las ejecuciones según el schedule_interval que definiste. Una vez activo, haz clic en el nombre del DAG y accede a la vista de grafo (Graph View) para ver cada tarea representada visualmente con su estado actual: en espera, en ejecución, completada con éxito o fallida.
Errores comunes al crear un DAG y cómo evitarlos
Cuando trabajas con tu primer DAG, es habitual toparte con una serie de problemas que no siempre son fáciles de diagnosticar a primera vista. La mayoría tienen causas sencillas y se resuelven con pequeños ajustes. Conocerlos antes de que ocurran te ahorra tiempo y frustración desde el primer día en la ingeniería de datos.
- DAG no aparece en la UI: Revisa que el archivo esté en la carpeta
dags/correcta y que no tenga errores de sintaxis. Puedes comprobarlo ejecutandopython mi_primer_dag.pydirectamente desde la terminal. - dag_id duplicado: Si ya existe un DAG con el mismo
dag_id, Airflow puede ignorar el nuevo o mezclarlos. Usa siempre identificadores únicos y descriptivos. - catchup=True sin querer: Cuando
catchupes verdadero y elstart_datees antiguo, Airflow intenta ejecutar todas las corridas pasadas de golpe. Establececatchup=Falsemientras desarrollas y pruebas. - Importaciones incorrectas: Las rutas de módulos de Airflow cambian entre versiones. Si usas Airflow 2.x o 3.x, comprueba que estás importando desde los módulos correctos; por ejemplo,
from airflow.operators.python import PythonOperatoren lugar del módulo anteriorpython_operator. - task_id repetido dentro del mismo DAG: Cada tarea necesita un
task_idúnico en su DAG. Dos tareas con el mismo identificador generan un error al parsear el archivo. - Scheduler no activo: Si el scheduler no está corriendo, los DAGs aparecen en la UI, pero ninguna tarea avanza. Siempre verifica que el proceso
airflow scheduleresté en ejecución.
Preguntas frecuentes
¿Qué significa DAG en Apache Airflow?
DAG son las siglas de Directed Acyclic Graph, que en español se traduce como grafo dirigido acíclico. En el contexto de Apache Airflow, un DAG es el archivo Python que define un flujo de trabajo completo: las tareas que lo forman, el orden en que deben ejecutarse y la frecuencia con la que el scheduler las activa. Se llama acíclico porque el flujo siempre avanza en una dirección y nunca crea bucles que lleven de vuelta a una tarea ya completada, lo que garantiza ejecuciones predecibles y sin bloqueos.
¿Cuántas tareas puede tener un DAG en Airflow?
Airflow no impone un límite fijo en el número de tareas por DAG, pero la práctica recomendada es mantener cada DAG enfocado en un proceso concreto y con una cantidad de tareas manejable. DAGs con cientos de tareas son técnicamente posibles, pero pueden generar tiempos de parseo más largos y hacer que la vista de grafo sea difícil de interpretar. Para flujos de trabajo muy grandes, suele ser más eficiente dividir la lógica en varios DAGs bien definidos y conectarlos mediante sensores o dependencias externas.
¿Qué es un operador en Apache Airflow?
Un operador es la plantilla que define qué hace una tarea dentro de un DAG. Cuando instancias un operador dentro del bloque DAG, estás creando una tarea concreta. Airflow incluye operadores para los casos de uso más habituales: ejecutar funciones Python (PythonOperator), correr comandos de terminal (BashOperator), lanzar consultas SQL, enviar correos o interactuar con servicios en la nube. También puedes crear operadores personalizados cuando ninguno de los disponibles se ajusta a tu caso.
¿Qué diferencia hay entre el scheduler y el executor?
El scheduler y el executor son dos componentes distintos con responsabilidades complementarias. El scheduler decide cuándo debe correr cada tarea: lee los DAGs, comprueba las dependencias y el horario definido, y marca las tareas como listas para ejecutarse. El executor, por su parte, se encarga de cómo se ejecutan esas tareas en la práctica: en el mismo proceso, en workers distribuidos o en contenedores de Kubernetes. El scheduler delega en el executor, pero no ejecuta las tareas directamente.
¿Cómo se define el intervalo de ejecución de un DAG?
El intervalo de ejecución se define con el parámetro schedule_interval al crear el objeto DAG. Puedes usar cadenas predefinidas como @daily, @hourly o @weekly, o escribir una expresión cron personalizada para mayor precisión, como "0 6 * * 1" para ejecutar todos los lunes a las 6:00 de la mañana. En versiones recientes de Airflow, también puedes usar objetos timedelta de Python, como timedelta(hours=6), si prefieres un intervalo relativo en lugar de un horario fijo.
¿Puedo crear un DAG sin saber Python avanzado?
Sí, y es uno de los puntos fuertes de Airflow para quienes empiezan. Los conceptos básicos de Python son suficientes para escribir un DAG funcional: saber definir funciones, importar módulos y entender los diccionarios es más que suficiente para los primeros pipelines. La lógica de orquestación la gestiona Airflow por ti; tú solo tienes que definir qué debe hacerse en cada función y en qué orden deben encadenarse las tareas. A medida que ganas experiencia, puedes explorar funcionalidades más avanzadas como el uso de XCom para pasar datos entre tareas o la TaskFlow API.
¿Dónde se guardan los archivos DAG en Airflow?
Por defecto, Airflow busca los archivos DAG en la carpeta ~/airflow/dags/ dentro del directorio de inicio del usuario. Esta ruta se puede cambiar en el archivo de configuración airflow.cfg mediante el parámetro dags_folder. El scheduler escanea esta carpeta periódicamente y registra automáticamente cualquier archivo Python nuevo que contenga una definición de DAG válida. En entornos con Docker o Kubernetes, la ruta suele mapearse como un volumen para facilitar la sincronización del código.
¿Qué es el parámetro catchup en un DAG de Airflow?
El parámetro catchup controla si Airflow debe ejecutar todas las corridas del DAG que habrían ocurrido entre el start_date y el momento actual, en caso de que el DAG lleve tiempo sin activarse. Cuando catchup=True y el start_date es una fecha antigua, el scheduler puede lanzar decenas o cientos de ejecuciones de golpe, lo que puede saturar el entorno. Establecer catchup=False es la práctica habitual durante el desarrollo y en pipelines donde solo importa la ejecución más reciente.
Conclusión
Crear tu primer DAG en Apache Airflow es el punto de partida para dejar atrás la ejecución manual de scripts y empezar a construir pipelines de datos reales, automatizados y trazables. Con un archivo Python bien estructurado, un par de operadores y el operador >> para encadenar tareas, ya tienes todo lo necesario para que Airflow gestione el flujo por ti.
A lo largo de este recorrido has visto qué es un DAG y para qué sirve cada uno de sus componentes, cómo instalar el entorno, cómo escribir el código completo desde cero y cómo activar y monitorear el pipeline desde la interfaz web. Con esa base ya puedes empezar a construir, probar y ajustar tus propios flujos de trabajo con confianza.
El siguiente paso natural es experimentar con más operadores, explorar cómo pasar datos entre tareas usando XCom y, cuando estés listo, revisar otros contenidos de este sitio web que amplían estos conceptos hacia herramientas y técnicas más avanzadas del ecosistema de datos.
Sigue aprendiendo:
Apache Spark: El motor de datos que no conocías
Buenas prácticas de ingeniería de datos
¿Qué es un data warehouse y para qué sirve?
Cómo ser ingeniero de datos desde cero
Certificaciones para ingeniero de datos
Great Expectations (GX): El secreto que usan los mejores data engineers
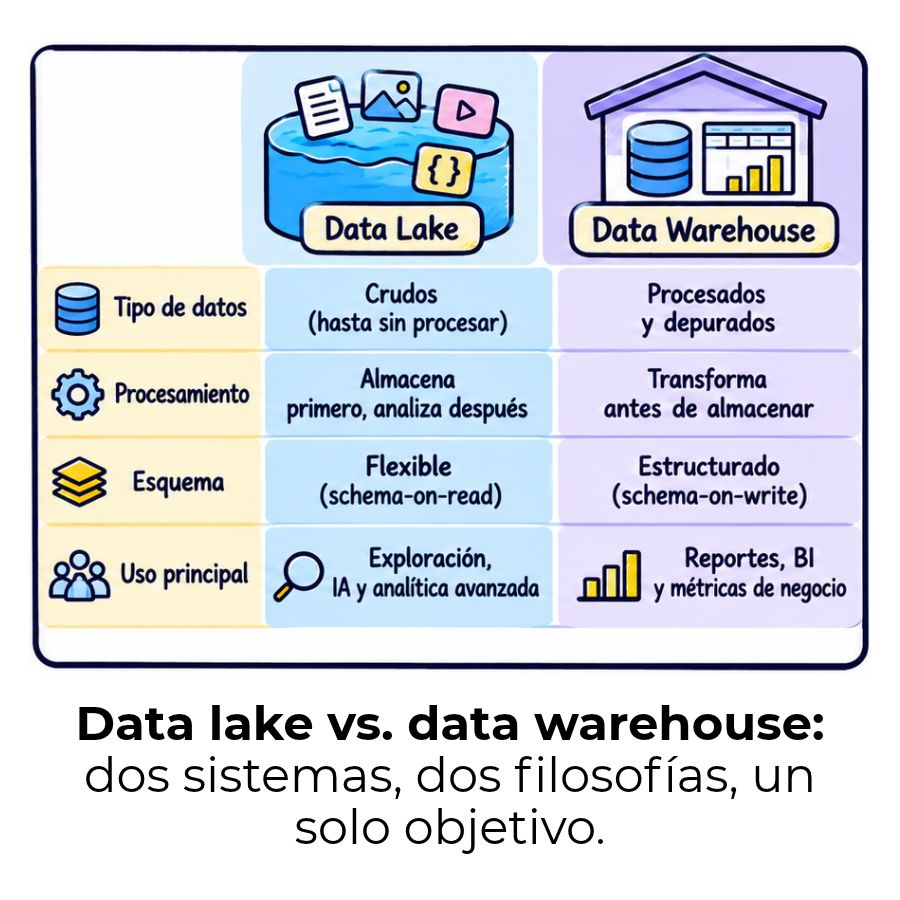
Diferencia entre data lake y data warehouse
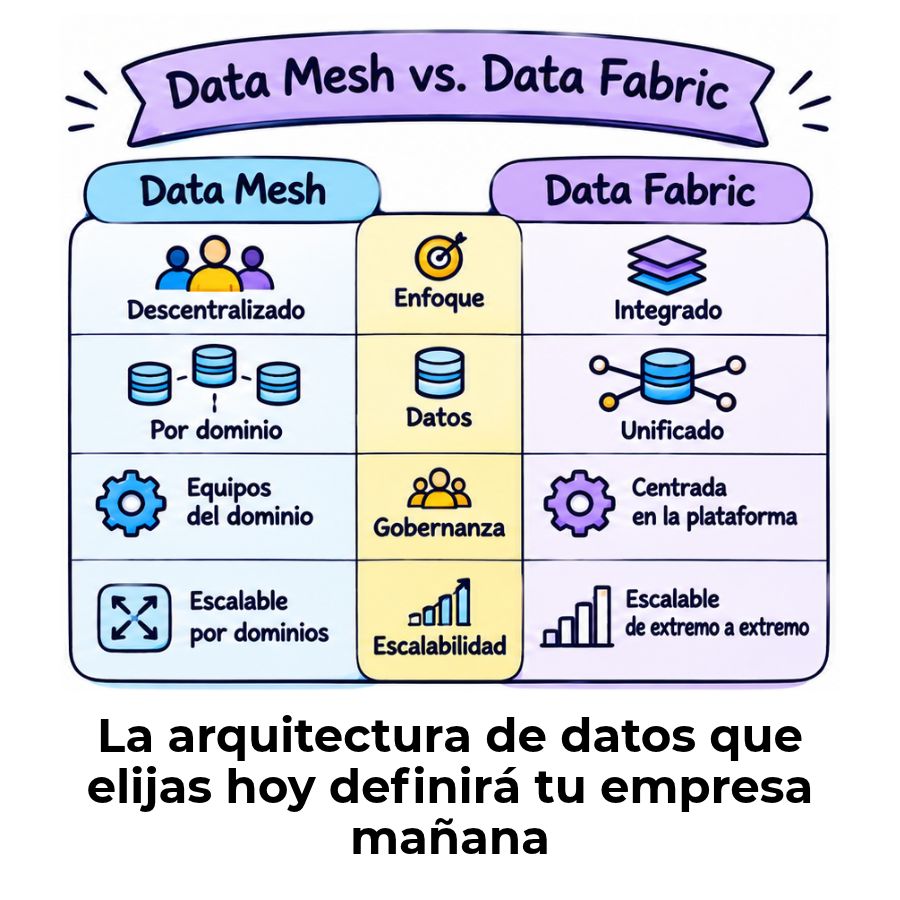
Data Mesh vs. Data Fabric
