
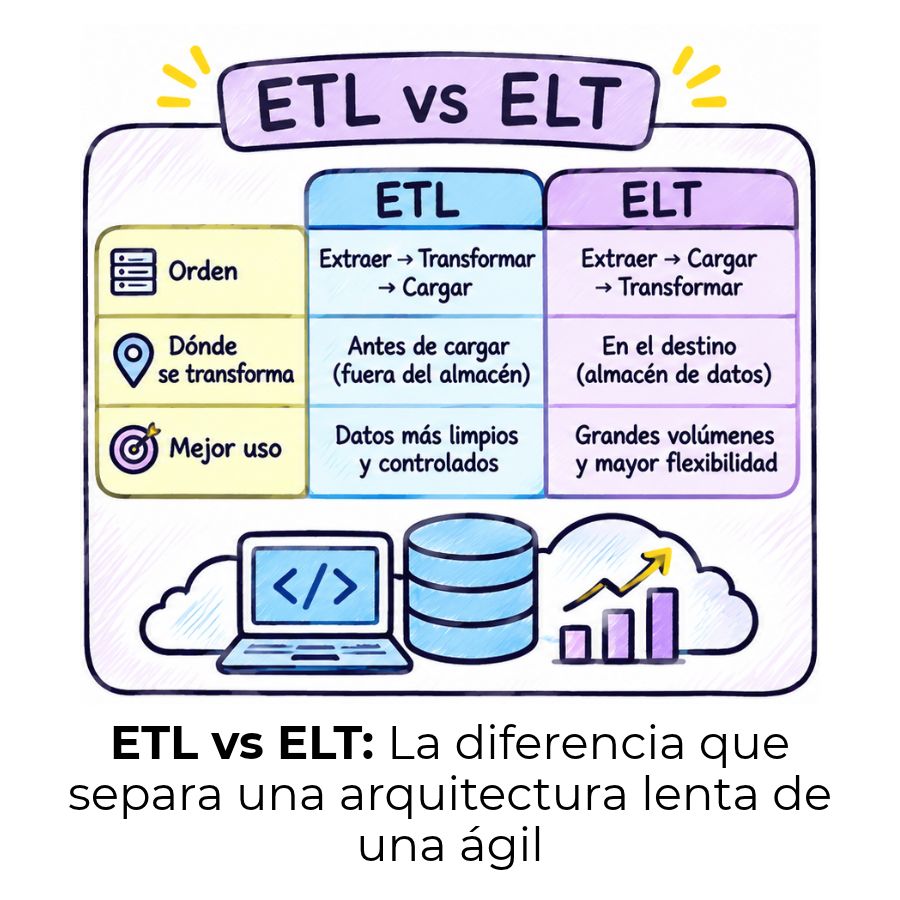
ETL y ELT son dos formas de integrar datos que se diferencian en un punto clave: en ETL, los datos se transforman antes de cargarse al destino, mientras que en ELT se cargan primero y se transforman dentro del sistema de destino. Elegir entre uno y otro depende de tu infraestructura, el tipo de datos que manejas y cuánta flexibilidad necesitas.
¿Qué son ETL y ELT en ingeniería de datos?
Cuando trabajas con datos a escala, necesitas un proceso que los mueva desde múltiples fuentes hasta el lugar donde se van a analizar o almacenar. Ese proceso recibe el nombre de pipeline de datos, y tanto ETL como ELT son las dos filosofías principales para construirlo. Ambos comparten las mismas tres operaciones —extracción, transformación y carga— pero las ejecutan en un orden diferente, y esa diferencia tiene consecuencias reales en rendimiento, costo y arquitectura.
La ingeniería de datos utiliza estos procesos como columna vertebral de cualquier proyecto que involucre grandes volúmenes de información. Entender qué hace cada uno y por qué ese orden importa te permite tomar decisiones técnicas con criterio desde el principio, sin depender de suposiciones ni de modas tecnológicas pasajeras.
¿Qué significa ETL?
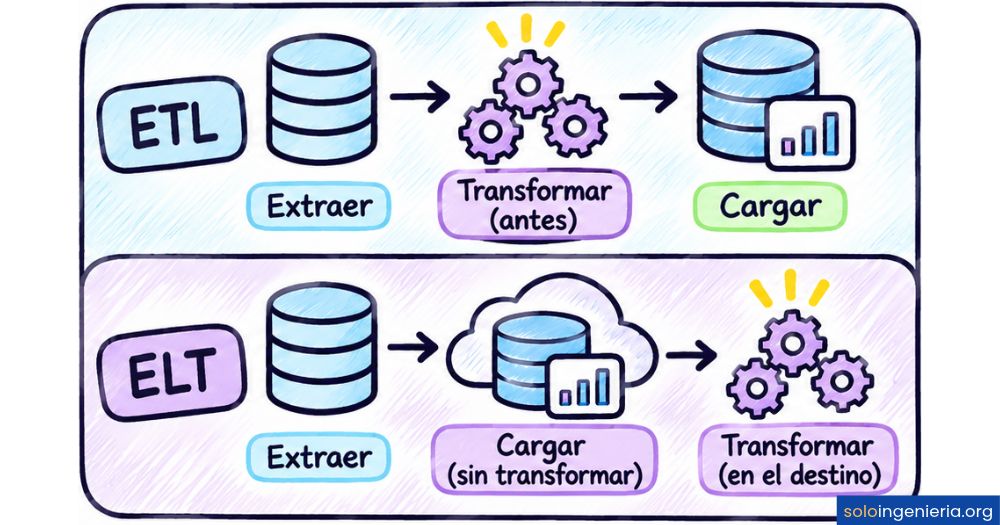
ETL es el acrónimo de Extract, Transform, Load (Extraer, Transformar, Cargar). En este proceso, los datos se extraen de las fuentes de origen —bases de datos relacionales, archivos planos, APIs—, se transforman en un servidor intermedio conocido como área de staging, y solo después se cargan al sistema de destino, que suele ser un data warehouse. La transformación ocurre fuera del destino final, en un entorno controlado y dedicado exclusivamente a esa tarea.
¿Qué significa ELT?
ELT significa Extract, Load, Transform (Extraer, Cargar, Transformar). Aquí, los datos se extraen de las fuentes y se cargan de inmediato en el sistema de destino —un data warehouse en la nube o un data lake— en su estado crudo, sin pasar por ninguna transformación previa. La transformación ocurre directamente dentro del sistema de destino, aprovechando su propia capacidad de cómputo para procesar los datos ya almacenados.
¿Cuál es la diferencia entre ETL y ELT?
La diferencia fundamental entre ETL y ELT está en el momento y el lugar donde ocurre la transformación de los datos. En ETL, los datos nunca llegan al destino sin haber pasado antes por un proceso de limpieza y estructuración en un servidor externo. En ELT, los datos llegan tal como son —en bruto— y el sistema de destino se encarga de transformarlos usando su propia capacidad de procesamiento. Esa distinción cambia profundamente el diseño de la arquitectura, los costos operativos y la flexibilidad del pipeline.
| Característica | ETL | ELT |
|---|---|---|
| Orden de operaciones | Extraer → Transformar → Cargar | Extraer → Cargar → Transformar |
| Dónde se transforma | Servidor intermedio (staging) | Dentro del sistema de destino |
| Tipo de datos | Principalmente estructurados | Estructurados, semiestructurados y no estructurados |
| Velocidad de ingestión | Más lenta (transformación previa) | Más rápida (carga inmediata) |
| Flexibilidad de esquema | Baja (esquema fijo antes de cargar) | Alta (schema-on-read) |
| Infraestructura necesaria | Servidor ETL dedicado | Cloud data warehouse escalable |
| Datos en destino | Solo datos ya transformados | Datos crudos disponibles desde el inicio |
| Encaje ideal | Sistemas heredados, cumplimiento normativo | Analítica en la nube, grandes volúmenes |
Dónde ocurre la transformación: el detalle que lo cambia todo
En ETL, existe un componente intermedio —llamado área de staging o motor ETL— que actúa como una sala de procesamiento antes de que los datos lleguen a su destino. Este servidor intermedio limpia, filtra, agrega y convierte los datos según reglas predefinidas, de modo que lo que entra al data warehouse ya está estructurado y listo para ser consultado. Esa separación entre el procesamiento y el almacenamiento fue durante muchos años la única forma viable de manejar datos a escala.
Con ELT, el paradigma cambia porque el poder de cómputo del sistema de destino —como Snowflake, BigQuery o Amazon Redshift— es suficientemente grande y económico para encargarse de las transformaciones. Los datos llegan en bruto al almacén o data lake, y las transformaciones se ejecutan ahí mismo, en el momento en que se necesitan. Esto elimina la necesidad de mantener un servidor intermedio separado y permite que científicos de datos accedan a los datos originales sin filtros.
Ventajas y limitaciones de ETL
ETL lleva décadas siendo el estándar en proyectos de integración de datos porque ofrece un nivel de control y madurez que muy pocas alternativas pueden igualar. Es la opción preferida cuando los datos contienen información sensible o personal, ya que el proceso de transformación previa permite aplicar enmascaramiento, anonimización o filtros de cumplimiento normativo antes de que los datos lleguen al almacén definitivo, reduciendo así la exposición a riesgos de privacidad.
Sin embargo, ETL tiene limitaciones claras. La rigidez del esquema definido antes de la carga puede convertirse en un cuello de botella cuando los requerimientos de negocio cambian con frecuencia. Además, mantener un servidor intermedio dedicado implica costos de infraestructura fijos y requiere que el equipo tenga experiencia con herramientas especializadas de transformación, lo que eleva la curva de aprendizaje y el tiempo de implementación.
- Control sobre los datos: la transformación previa garantiza que solo entran datos validados y estructurados al destino.
- Madurez tecnológica: cuenta con un ecosistema amplio de herramientas, documentación y profesionales con experiencia.
- Cumplimiento normativo: permite enmascarar o anonimizar datos sensibles antes de almacenarlos.
- Menor carga en el destino: el data warehouse recibe datos ya procesados, lo que reduce el consumo de recursos en destino.
- Estabilidad en esquemas fijos: encaja bien cuando los requerimientos del negocio no cambian con frecuencia.
- Rigidez de esquema: cualquier cambio en la estructura de los datos puede requerir rediseñar el pipeline completo.
- Infraestructura adicional: necesita un servidor intermedio dedicado que supone un costo fijo y mantenimiento constante.
- Latencia más alta: los procesos batch pueden generar retrasos antes de que los datos estén disponibles para el análisis.
- Dificultad con datos no estructurados: no está optimizado para manejar JSON, logs o multimedia de forma nativa.
Ventajas y limitaciones de ELT
ELT surge como respuesta al crecimiento exponencial de los volúmenes de datos y a la aparición de plataformas de cloud computing con capacidad de cómputo elástica. Su mayor fortaleza es la velocidad de ingestión: como los datos se cargan sin transformar, el tiempo que transcurre desde que se generan hasta que están disponibles en el sistema de destino es significativamente menor que en ETL. Esto resulta clave en contextos donde los equipos de análisis necesitan datos actualizados con frecuencia o casi en tiempo real.
El lado menos favorable de ELT aparece cuando no se gestiona bien la gobernanza de datos. Cargar datos crudos sin un catálogo claro puede derivar en lo que se conoce como data swamp: un depósito de datos difícil de navegar, donde nadie sabe con seguridad qué hay, en qué estado está o si es confiable. Además, las transformaciones que se realizan dentro del cloud warehouse consumen recursos de la plataforma, lo que puede encarecer los costos si los volúmenes son muy altos.
- Ingestión rápida: los datos llegan al destino casi de inmediato, sin esperar procesos de transformación previos.
- Flexibilidad de esquema: permite trabajar con schema-on-read, lo que facilita iterar sobre los datos sin rediseñar el pipeline.
- Datos originales disponibles: los científicos de datos pueden acceder a los datos en su estado crudo para exploración y modelado.
- Escalabilidad nativa en la nube: aprovecha el cómputo elástico de plataformas como BigQuery o Snowflake.
- Menor dependencia de herramientas externas: la transformación usa SQL dentro del propio warehouse, lo que reduce la curva técnica.
- Riesgo de data swamp: sin buena gobernanza, el almacén se llena de datos sin catalogar que nadie sabe usar.
- Costos variables en la nube: el cómputo de transformaciones dentro del warehouse puede dispararse con volúmenes altos.
- Datos sensibles expuestos: cargar información sin filtrar implica mayor responsabilidad en controles de acceso y seguridad.
- Dependencia de infraestructura cloud: no es la opción más adecuada si el equipo trabaja con sistemas locales o heredados.
¿Cuándo usar ETL y cuándo usar ELT?
No existe una respuesta universal a esta pregunta. La elección correcta depende de la combinación específica de factores técnicos, organizativos y operativos de cada proyecto: el tipo de datos que manejas, la infraestructura disponible, el nivel de cumplimiento normativo que exige tu sector y la frecuencia con la que los requerimientos de transformación cambian. Analizar cada uno de esos factores antes de decidir te ahorra rediseños costosos más adelante.
Señales de que ETL encaja mejor en tu proyecto
ETL sigue siendo la opción más sólida en escenarios donde el control sobre los datos y el cumplimiento normativo son prioritarios. Si trabajas en sectores como finanzas, salud o banca, donde la información personal o financiera debe pasar por filtros de anonimización antes de cualquier almacenamiento, ETL te ofrece ese punto de control de forma nativa. También encaja cuando los sistemas de origen son relacionales y los esquemas de datos son estables y bien definidos desde el inicio del proyecto.
- Tus datos contienen información personal o sensible que debe anonimizarse antes de almacenarse.
- Trabajas con sistemas heredados o bases de datos relacionales en infraestructura local.
- Los esquemas de datos son estables y no cambian con frecuencia.
- Necesitas transformaciones complejas que requieren lógica de negocio avanzada antes de la carga.
- El data warehouse tiene capacidad de almacenamiento limitada y no puedes permitirte guardar datos crudos.
Señales de que ELT es la opción más adecuada
ELT brilla en entornos donde la velocidad de disponibilidad de los datos y la flexibilidad para iterar son más importantes que la uniformidad del esquema. Si tu equipo ya opera sobre un cloud data warehouse con capacidad de cómputo elástica y necesitas que los datos estén disponibles lo antes posible para análisis exploratorio o modelos de machine learning, ELT elimina la fricción del paso de transformación previa y acelera el tiempo desde la ingestión hasta el análisis.
- Trabajas en la nube con plataformas como Snowflake, BigQuery o Amazon Redshift.
- Manejas grandes volúmenes de datos estructurados, semiestructurados o no estructurados.
- Los requerimientos de transformación cambian con frecuencia y necesitas flexibilidad para iterar sin rediseñar el pipeline.
- Los científicos de datos necesitan acceso a los datos originales para exploración y modelado.
- El equipo tiene buenas habilidades en SQL y prefiere operar dentro de una sola plataforma.
ETL y ELT en la nube: Snowflake, BigQuery y Redshift
El auge del cloud computing fue el principal impulsor de ELT como enfoque viable a escala. Plataformas como Snowflake, Google BigQuery y Amazon Redshift cambiaron las reglas del juego al ofrecer capacidad de cómputo elástica que crece o se reduce según la demanda, haciendo que transformar datos dentro del propio warehouse sea técnicamente eficiente y económicamente razonable en la mayoría de los casos. Esta evolución hizo que muchos equipos migraran de pipelines ETL clásicos hacia arquitecturas ELT nativas en la nube.
Sin embargo, no todos los proyectos en la nube adoptan ELT de forma exclusiva. ETL sigue siendo relevante incluso en arquitecturas cloud cuando existen restricciones de cumplimiento que exigen que ciertos datos nunca lleguen a la plataforma sin haber sido previamente depurados. La clave está en entender que la nube no obliga a elegir ELT: ofrece las condiciones para que ELT sea viable, pero la decisión final sigue dependiendo de las necesidades del proyecto.
El enfoque híbrido ETLT: lo mejor de ambos mundos
Cuando ninguno de los dos enfoques por separado cubre todas las necesidades de un proyecto, muchos equipos optan por una estrategia combinada conocida como ETLT. ETLT aplica una transformación ligera antes de la carga —típicamente para enmascarar datos sensibles o filtrar registros inválidos— y luego realiza transformaciones más complejas dentro del destino, siguiendo el modelo ELT. Este enfoque es especialmente común en sectores con requisitos de cumplimiento normativo que, al mismo tiempo, operan sobre arquitecturas cloud modernas.
Un ejemplo práctico: una organización puede usar ETL para las canalizaciones que alimentan reportes regulatorios —donde la disciplina de datos y el control son irrenunciables— y al mismo tiempo utilizar ELT para los flujos de datos en tiempo real que alimentan modelos de machine learning o paneles de analítica. No hay una sola arquitectura correcta; hay una arquitectura correcta para cada caso de uso concreto dentro del mismo proyecto.
La elección entre ETL y ELT no es una decisión de paradigma para toda la organización, sino una decisión por pipeline, basada en qué necesita cada flujo de datos específico.
Herramientas populares para ETL y ELT
El ecosistema de herramientas para ETL y ELT es amplio y maduro. Elegir la herramienta correcta depende tanto del enfoque que adoptes como de las habilidades técnicas de tu equipo y del stack tecnológico que ya utilizas. A continuación encontrarás las opciones más usadas en proyectos de ingeniería de datos reales, organizadas por enfoque para que sea más fácil identificar cuál encaja con tu situación.
Si quieres ir un paso más allá y construir tus propios pipelines desde cero, puedes explorar cómo funciona ETL con Python usando bibliotecas como Pandas, SQLAlchemy o Apache Airflow, que te dan control total sobre cada paso del proceso sin depender de plataformas de terceros.
- Apache NiFi: automatización de flujos de datos con interfaz visual y sin código.
- Talend: plataforma con amplia compatibilidad con conectores y transformaciones complejas.
- Informatica PowerCenter: estándar empresarial para proyectos de gran escala con cumplimiento normativo.
- Microsoft SSIS: integrado en el ecosistema SQL Server, ideal para entornos Windows.
- Pentaho Data Integration: opción open source con capacidades de ETL completas.
- dbt (data build tool): la herramienta de referencia para transformaciones SQL dentro del warehouse.
- Fivetran: conectores gestionados que cargan datos automáticamente en la plataforma de destino.
- Airbyte: alternativa open source a Fivetran con soporte para cientos de conectores.
- Stitch: solución sencilla para equipos que necesitan ingestión rápida sin configuración compleja.
- AWS Glue: servicio serverless de integración de datos nativo en el ecosistema Amazon.
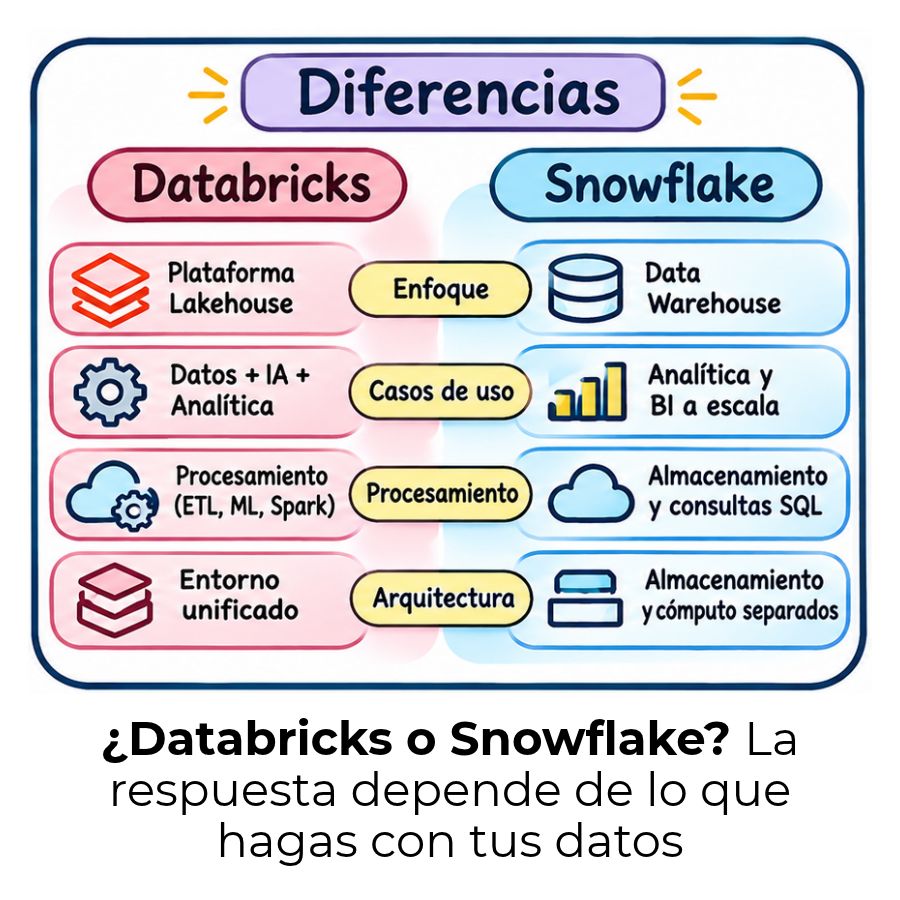
Para profundizar en los conceptos que rodean estas herramientas y comprender mejor cómo encajan dentro de una arquitectura moderna, el artículo sobre lakehouse ofrece una perspectiva útil sobre cómo las plataformas actuales combinan lo mejor de los data lakes y los data warehouses, lo que influye directamente en qué enfoque —ETL o ELT— tiene más sentido adoptar.
Preguntas frecuentes
¿Qué diferencia hay entre ETL y ELT?
La diferencia principal está en el orden y el lugar donde ocurre la transformación de los datos. En ETL, los datos se transforman en un servidor intermedio antes de llegar al sistema de destino, por lo que el data warehouse recibe únicamente datos ya procesados y estructurados. En ELT, los datos se cargan primero en el sistema de destino en su estado crudo y la transformación ocurre ahí dentro, aprovechando el cómputo propio de la plataforma. Esa distinción impacta directamente en la velocidad de ingestión, la flexibilidad del esquema, los costos de infraestructura y el nivel de control sobre los datos sensibles.
¿Cuál es más rápido, ETL o ELT?
En términos de velocidad de ingestión —el tiempo que tarda un dato desde su origen hasta estar disponible en el destino— ELT es generalmente más rápido, porque elimina el paso de transformación previa a la carga. Los datos llegan al warehouse de inmediato y las transformaciones se ejecutan después, en paralelo con otros procesos. ETL, al requerir procesamiento en un servidor intermedio antes de la carga, introduce una latencia adicional que puede ser significativa en proyectos con grandes volúmenes o necesidades de datos casi en tiempo real.
¿ETL o ELT, cuál debo elegir para mi proyecto de datos?
La respuesta depende de varios factores concretos: el tipo de datos que manejas, la infraestructura disponible, el nivel de cumplimiento normativo que exige tu sector y la frecuencia con la que los requerimientos cambian. Si trabajas con datos sensibles en sistemas locales y esquemas estables, ETL suele ser la opción más adecuada. Si operas en la nube, manejas grandes volúmenes y necesitas flexibilidad para iterar rápido, ELT es generalmente más eficiente. Muchas organizaciones terminan usando ambos de forma complementaria según el tipo de pipeline.
¿Qué tipo de datos maneja mejor ELT que ETL?
ELT maneja mejor los datos no estructurados y semiestructurados —como archivos JSON, logs de aplicaciones, registros de eventos o datos de redes sociales— porque no exige que el esquema esté definido antes de la carga. Con ETL, el esquema debe estar fijado desde el inicio, lo que dificulta trabajar con datos cuya estructura varía o no está totalmente definida en el momento de la ingestión. ELT permite cargar ese tipo de datos en crudo y definir la estructura en el momento en que se necesitan consultarlos.
¿Pueden usarse ETL y ELT juntos en el mismo proyecto?
Sí, y de hecho es una práctica habitual en organizaciones con necesidades diversas de datos. El enfoque ETLT combina una transformación ligera antes de la carga —para filtrar registros inválidos o enmascarar datos sensibles— con transformaciones más complejas dentro del sistema de destino. También es común usar ETL para pipelines de reportes regulatorios que exigen control estricto, y ELT para flujos de datos en tiempo real que alimentan modelos de analítica o machine learning. No son enfoques mutuamente excluyentes.
¿Es ELT más costoso que ETL?
No necesariamente. Los costos de cada enfoque dependen del contexto. ETL requiere mantener un servidor intermedio dedicado, lo que supone un costo fijo de infraestructura independientemente del volumen. ELT elimina ese servidor, pero las transformaciones dentro del cloud warehouse consumen recursos de la plataforma que se cobran por uso, lo que puede resultar más caro si los volúmenes son muy altos o las consultas no están bien optimizadas. Con una buena gestión de recursos y consultas eficientes, ELT puede ser muy económico en la nube.
¿Qué herramientas se usan para ELT en la nube?
Las herramientas más usadas para ELT en la nube son dbt (data build tool) para las transformaciones SQL dentro del warehouse, Fivetran y Airbyte para la ingestión automatizada de datos desde múltiples fuentes, y AWS Glue para entornos dentro del ecosistema Amazon. Las plataformas de destino más comunes son Snowflake, Google BigQuery y Amazon Redshift, que ofrecen cómputo elástico y están diseñadas para soportar transformaciones a gran escala directamente dentro del warehouse sin necesidad de infraestructura externa.
Conclusión
ETL y ELT son dos formas distintas de resolver el mismo problema: mover datos desde sus fuentes hasta el lugar donde se van a analizar. La diferencia no es trivial, porque el orden en que transformas y cargas los datos define aspectos tan concretos como la velocidad de ingestión, el nivel de control sobre la información sensible, los costos de infraestructura y la flexibilidad para adaptarte a cambios en los requerimientos del negocio.
Si operas en entornos con datos sensibles, esquemas estables y sistemas heredados, ETL te ofrece el control que necesitas. Si tu trabajo gira en torno a la nube, grandes volúmenes y analítica ágil, ELT acelera significativamente tus pipelines. Y si tus necesidades son mixtas, el enfoque ETLT te permite combinar lo mejor de ambos. Lo importante es que ahora tienes los criterios necesarios para evaluar cada situación con claridad y tomar la decisión con fundamento técnico real.
La ingeniería de datos es un campo que sigue evolucionando, y entender estos fundamentos te da una base sólida para seguir aprendiendo. En este sitio web encontrarás más contenido sobre ETL y otros conceptos clave que te ayudarán a construir ese conocimiento paso a paso.
Sigue aprendiendo:
ETL con Python: Extrae, transforma y carga datos
Diferencia entre Databricks y Snowflake
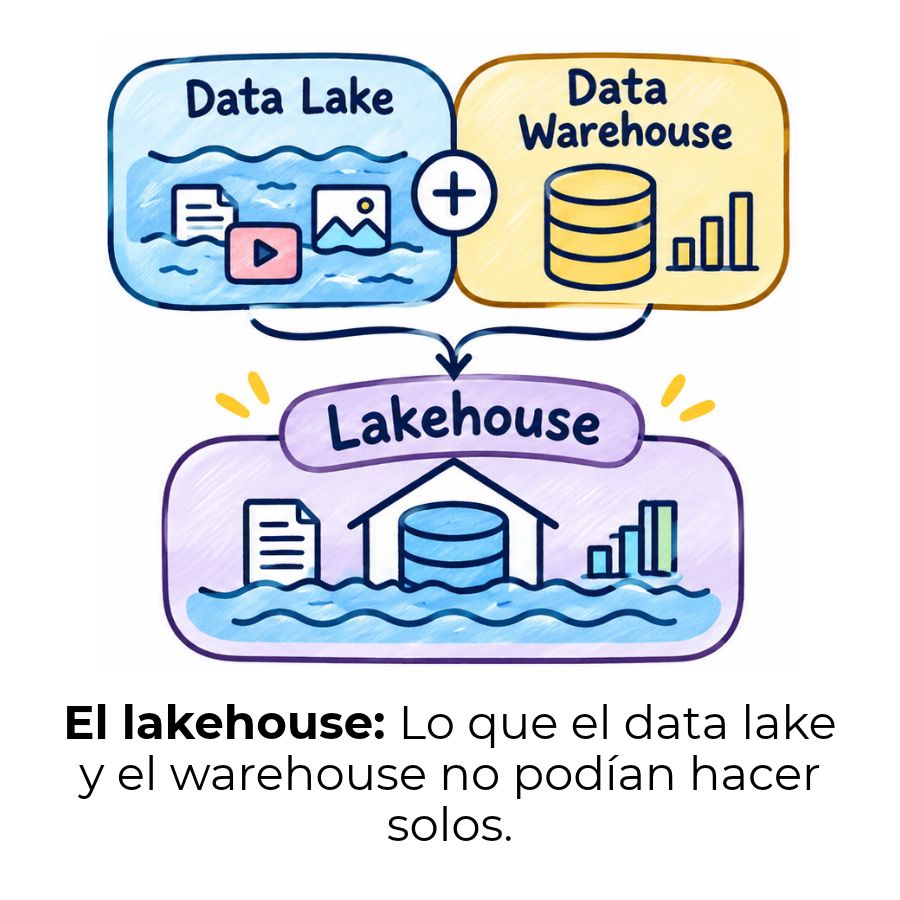
Lakehouse: La arquitectura que unifica todo
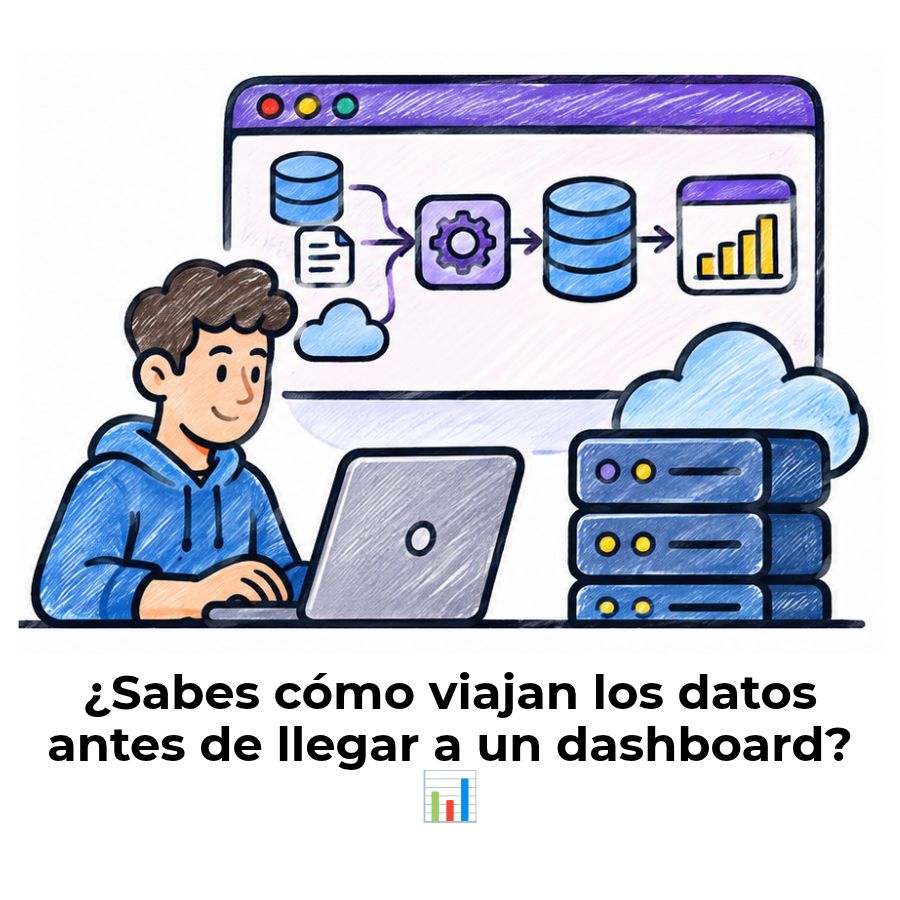
Pipeline de datos: El mecanismo que nadie te explica bien
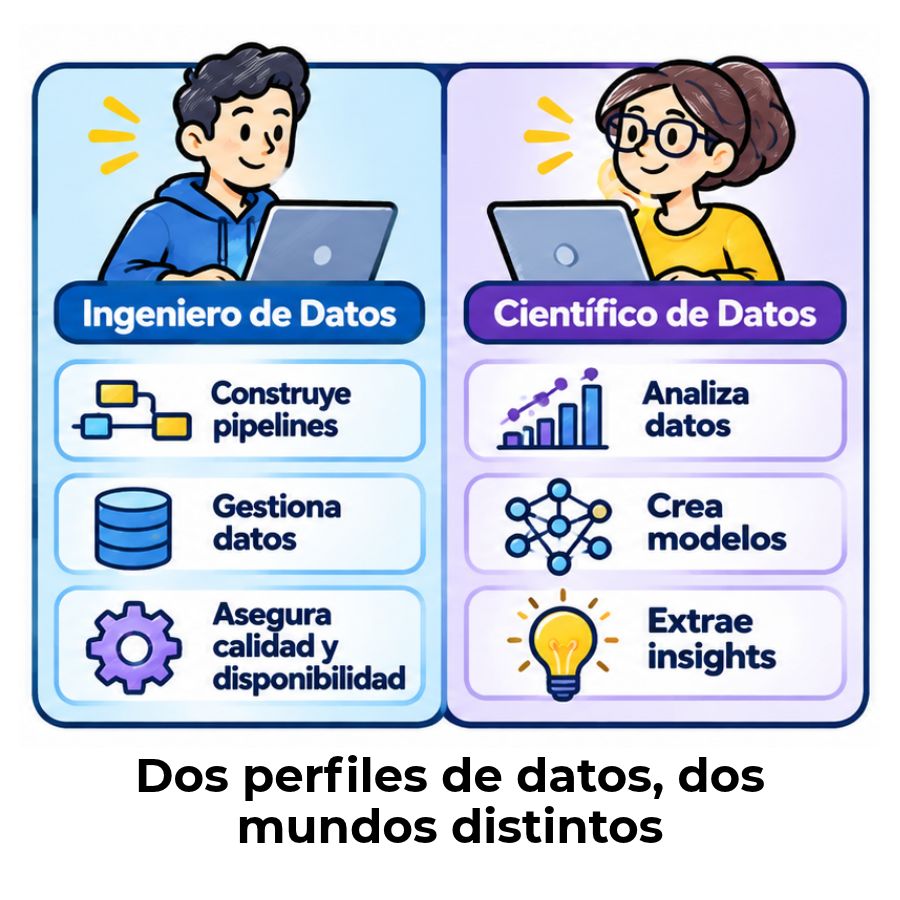
Ingeniero de datos vs. Científico de datos
AWS Glue: El secreto detrás de los grandes pipelines de datos
¿En qué consiste la ingeniería de base de datos?
Calidad de datos: El secreto que separa buenos de malos análisis
