
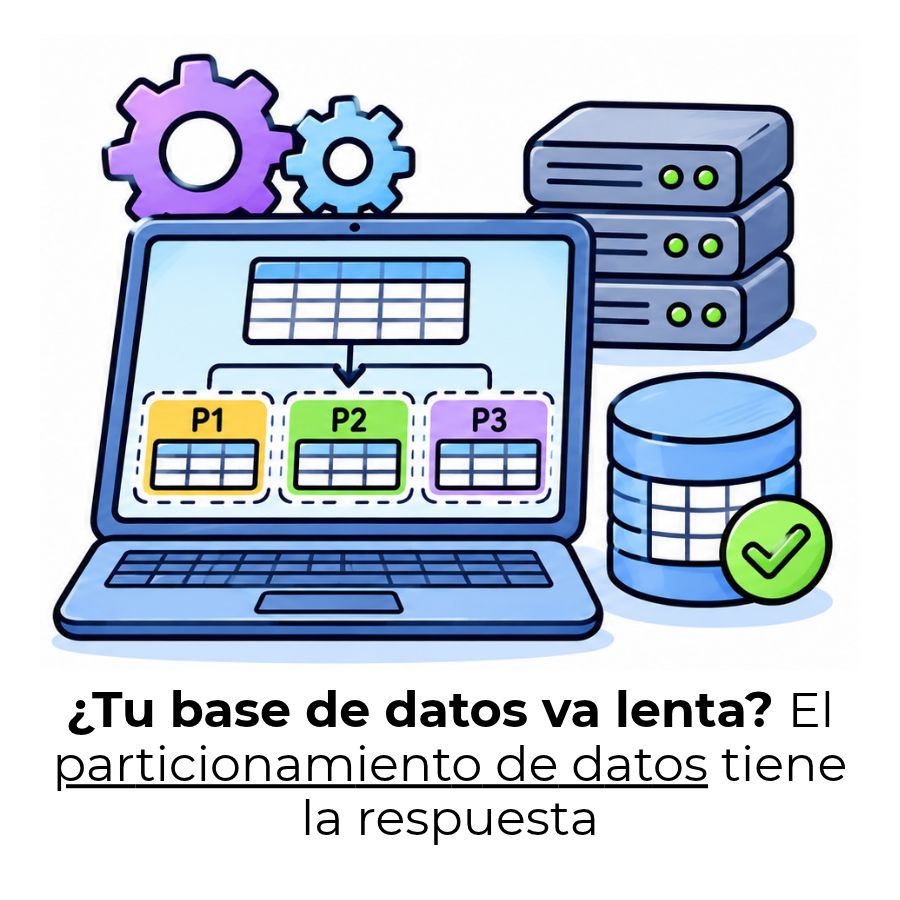
Imagina que tienes que encontrar una transacción específica entre quinientos millones de registros sin ningún orden. Ahí es donde el particionamiento de datos deja de ser un concepto técnico y se convierte en la diferencia entre una consulta que tarda segundos y una que tarda horas.
¿Qué es el particionamiento de datos?
El particionamiento de datos es una técnica que consiste en dividir un conjunto de datos grande en segmentos más pequeños, llamados particiones. Cada partición contiene un subconjunto del total de datos y puede almacenarse, consultarse y gestionarse de forma independiente, aunque en términos lógicos todas pertenecen al mismo conjunto original. Esta separación permite que los sistemas trabajen solo con la porción de datos que necesitan, en lugar de recorrer toda la tabla cada vez.
Desde el punto de vista práctico, cuando una base de datos recibe una consulta, el motor busca únicamente en la partición relevante en lugar de escanear millones de filas completas. Esto reduce el tiempo de respuesta, disminuye el consumo de recursos y permite que varios procesos trabajen en paralelo sobre distintas particiones al mismo tiempo.
Concepto de partición y por qué importa
Una partición es, en términos sencillos, un fragmento lógico o físico de un conjunto de datos mayor. La clave está en que cada partición puede procesarse de forma independiente, lo que permite a los motores de base de datos y a los frameworks de procesamiento distribuido trabajar en paralelo. Cuando una consulta filtra por una columna que coincide con la clave de partición, el sistema descarta automáticamente las particiones irrelevantes, un proceso conocido como partition pruning o poda de particiones.
Esto importa porque los conjuntos de datos modernos crecen de forma sostenida. Un sistema diseñado sin particionamiento que funciona bien con diez millones de registros puede volverse inmanejable con mil millones. El particionamiento no elimina los datos, pero organiza su acceso de manera que el rendimiento escala junto con el volumen.
Diferencia entre partición lógica y física
La partición lógica define cómo se agrupan los datos según una regla (por ejemplo, por mes o por región), mientras que la partición física determina dónde se almacenan realmente esos datos, ya sea en distintos discos, nodos de un clúster o directorios de un sistema de archivos distribuido. Ambos conceptos trabajan juntos, pero son independientes: puedes tener una misma lógica de partición implementada en distintos sistemas físicos según la infraestructura disponible.
Tipos de particionamiento de datos
Existen tres grandes tipos de particionamiento según el eje por el que se divide el conjunto de datos: horizontal, vertical y funcional. Cada uno responde a un problema diferente y se aplica en contextos distintos, por lo que conocerlos bien es el primer paso para tomar decisiones correctas en un proyecto de ingeniería de datos.
Particionamiento horizontal (sharding)
El particionamiento horizontal divide el conjunto de datos por filas. Cada partición contiene el mismo esquema de columnas, pero almacena un subconjunto distinto de registros. Esta técnica es la más utilizada en sistemas de big data y en entornos distribuidos como Apache Hadoop y Apache Spark, donde los datos se reparten entre múltiples nodos de un clúster para procesarse en paralelo. Cuando se aplica entre servidores diferentes, se conoce también como sharding.
Particionamiento vertical
El particionamiento vertical divide el conjunto de datos por columnas en lugar de por filas. Cada partición mantiene el mismo número de registros, pero incluye solo un subconjunto de las columnas originales. Es especialmente útil cuando algunas columnas se consultan con mucha frecuencia y otras casi nunca, o cuando es necesario almacenar datos sensibles en una ubicación separada con controles de acceso diferentes al resto de la información.
Particionamiento funcional
El particionamiento funcional agrupa los datos según el dominio de negocio o la funcionalidad que los utiliza. En lugar de dividir por filas o columnas, separa los datos según quién los consume y para qué. Por ejemplo, los datos de usuarios, pedidos e inventario van a almacenes distintos porque los gestiona cada equipo o microservicio de forma independiente. Esta estrategia es habitual en arquitecturas basadas en microservicios y en diseños de bases de datos orientados a dominios.
Estrategias de particionamiento: rango, hash y lista
Dentro del particionamiento horizontal existen tres estrategias principales para decidir a qué partición pertenece cada registro. Elegir la estrategia incorrecta puede provocar que toda la carga de trabajo caiga sobre una sola partición, anulando los beneficios del particionamiento. Comprender cuándo aplicar cada una es una habilidad central en ingeniería de datos y está estrechamente relacionada con conceptos como el linaje de datos, que permite rastrear el origen y la transformación de cada fragmento.
Particionamiento por rango
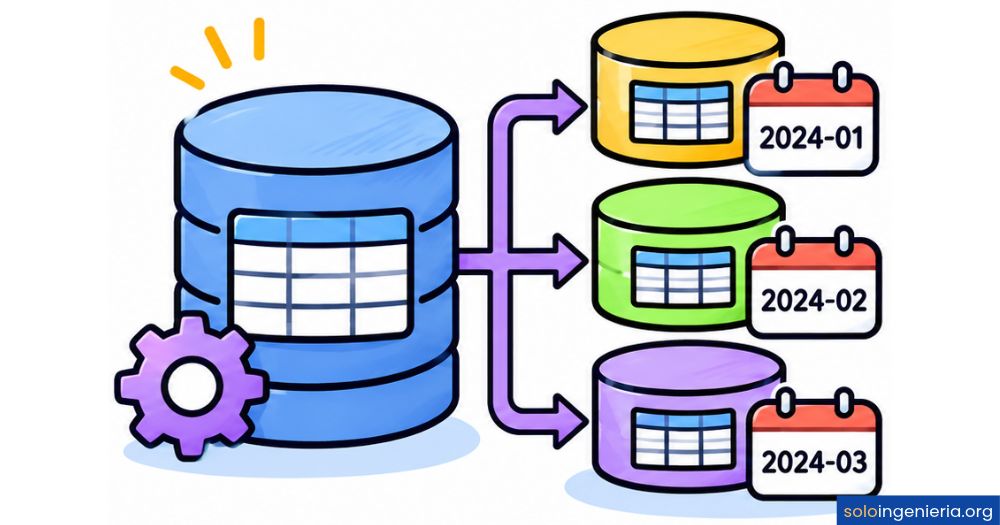
El particionamiento por rango asigna cada registro a una partición según el valor de una columna dentro de un intervalo definido. Es la estrategia predeterminada para datos de series temporales, como registros de eventos, transacciones financieras o logs de sistema, porque permite consultar un período concreto sin leer datos de otras fechas. Además, eliminar datos antiguos es tan simple como descartar la partición correspondiente, una operación que no requiere borrar fila por fila.
Particionamiento por hash
El particionamiento por hash aplica una función matemática a la clave de partición (por ejemplo, el identificador de un cliente) para determinar a qué partición pertenece el registro. Su principal ventaja es que distribuye los datos de forma uniforme entre todas las particiones, lo que evita los puntos calientes donde una sola partición acumula mucho más trabajo que las demás. Es la opción más adecuada para sistemas de alta escritura concurrente donde la distribución equitativa de la carga es prioritaria.
Particionamiento por lista
El particionamiento por lista asigna cada registro a una partición según el valor exacto de una columna que pertenece a un conjunto predefinido de categorías. Funciona mejor cuando los datos tienen categorías discretas y conocidas, como regiones geográficas, códigos de estado o tipos de producto. Las consultas que filtran por una de esas categorías se vuelven muy eficientes porque el motor sabe exactamente qué partición leer, sin necesidad de evaluar las demás.
Particionamiento compuesto
El particionamiento compuesto combina dos estrategias en capas. Un caso habitual es aplicar primero particionamiento por rango (por ejemplo, por año) y luego por hash dentro de cada rango. Este enfoque aprovecha las ventajas de ambas estrategias: las consultas por período son eficientes gracias al rango, y la distribución dentro de cada período es uniforme gracias al hash. Se utiliza cuando ninguna estrategia sola satisface todos los requisitos de acceso y distribución del sistema.
¿Cómo elegir la estrategia de particionamiento correcta?
No existe una estrategia de particionamiento universalmente mejor. La decisión correcta depende de dos factores que deben analizarse juntos: el tipo de dato que se almacena y el patrón de consulta que predomina en el sistema. Equivocarse en esta elección es uno de los errores más costosos en un proyecto de datos, porque rediseñar el particionamiento de una tabla en producción con millones de registros es una operación lenta y arriesgada. Los contratos de datos pueden ayudar a definir estas reglas desde el diseño inicial del sistema.
Criterios según el tipo de dato
El tipo de dato que almacena la tabla condiciona directamente qué estrategia tiene sentido. Los datos con una dimensión temporal clara (eventos, transacciones, métricas) se benefician casi siempre del particionamiento por rango. Los datos con identificadores únicos de alta cardinalidad (usuarios, pedidos, sesiones) se distribuyen mejor con hash. Los datos con categorías acotadas y conocidas (país, estado del pedido, tipo de producto) encajan con la estrategia por lista.
Criterios según el patrón de consulta
El patrón de acceso es igual o más importante que el tipo de dato. Si la mayoría de las consultas filtran por un período de tiempo, el rango garantiza que solo se lee la partición pertinente. Si las consultas son aleatorias y distribuidas, el hash evita que un solo nodo concentre toda la carga. Si se consulta frecuentemente por una categoría específica, la estrategia por lista permite que la poda de particiones sea máxima. Analizar las consultas más frecuentes antes de decidir es el mejor punto de partida.
Particionamiento de datos en herramientas reales
El particionamiento de datos no es un concepto abstracto: está implementado de forma nativa en las principales herramientas que usan hoy los equipos de datos. Conocer cómo lo aplica cada plataforma te permite aprovechar su potencial sin reinventar la rueda. Entender estas diferencias también es útil cuando se evalúa la diferencia entre DBT y Airflow en el contexto de transformar y orquestar datos particionados.
Apache Spark y el particionamiento distribuido
En Apache Spark, el particionamiento define cómo se distribuyen los datos entre los nodos del clúster para su procesamiento en paralelo. Cada partición es un fragmento lógico que una tarea independiente puede procesar sin depender de las demás. Spark soporta tanto particionamiento por hash como por rango, y permite aplicar estrategias personalizadas mediante el método partitionBy(). Una regla práctica habitual es usar entre dos y tres veces el número de núcleos de CPU disponibles como número de particiones inicial.
Cuando los datos se leen desde HDFS (el sistema de archivos distribuido de Hadoop), cada bloque del sistema de archivos se convierte en una partición de Spark. Esto significa que el particionamiento físico del almacenamiento influye directamente en el paralelismo del procesamiento. Ajustar el número de particiones con repartition() o coalesce() es una operación habitual en la optimización de pipelines de datos.
Snowflake, BigQuery y bases de datos modernas
Las plataformas de datos modernas como Snowflake, BigQuery y Amazon Redshift implementan particionamiento de forma nativa y, en muchos casos, de manera automática. En BigQuery, las tablas se particionan típicamente por una columna de fecha o por tiempo de ingesta, lo que permite que las consultas con filtro de fecha lean solo los datos relevantes y reduzcan el volumen procesado. En Snowflake, el particionamiento se gestiona de forma automática a través del microparticionamiento, que divide los datos en segmentos de entre cincuenta y quinientos megabytes según el orden de inserción y las estadísticas de las columnas.
Errores comunes al particionar datos
El particionamiento mal aplicado puede perjudicar más que ayudar. Los problemas más habituales no surgen de no particionar, sino de particionar sin analizar el patrón de acceso real. Identificar estos errores antes de que lleguen a producción es una parte esencial del trabajo de un ingeniero de datos.
- Hotspot o partición caliente: Ocurre cuando una sola partición recibe la gran mayoría de las escrituras o lecturas, anulando los beneficios del paralelismo. Es frecuente con particionamiento por rango en datos de series temporales, donde la partición más reciente concentra toda la actividad.
- Sobreparticionamiento: Crear demasiadas particiones genera millones de archivos pequeños que sobrecargan el sistema de metadatos y ralentizan las operaciones de planificación de consultas, incluso cuando el volumen total de datos es manejable.
- Clave de partición mal elegida: Seleccionar una columna con baja cardinalidad (por ejemplo, un booleano) como clave de partición produce muy pocas particiones, con lo que el paralelismo es mínimo y el sistema no puede escalar.
- Data skew o sesgo de datos: Surge cuando la distribución de los datos no es uniforme y algunas particiones son mucho más grandes que otras. Las tareas que procesan las particiones grandes terminan mucho más tarde, dejando recursos ociosos mientras esperan.
- Ignorar el patrón de consulta: Aplicar particionamiento por hash cuando el sistema hace consultas por rango de fechas elimina completamente el beneficio de la poda de particiones, ya que el motor debe leer todas las particiones para cada consulta.
Ventajas del particionamiento de datos
Cuando se aplica correctamente, el particionamiento produce mejoras concretas y medibles en el rendimiento, la escalabilidad y la gestión de los sistemas de datos. Estas ventajas son la razón por la que plataformas como Spark, BigQuery y Snowflake implementan particionamiento de forma nativa.
Preguntas frecuentes
¿Qué diferencia hay entre particionamiento y sharding?
El particionamiento es el concepto general de dividir un conjunto de datos en partes más pequeñas, independientemente de si esas partes están en el mismo servidor o en servidores distintos. El sharding es un tipo específico de particionamiento horizontal donde cada partición se almacena en un nodo o servidor diferente, lo que permite distribuir tanto el almacenamiento como la carga de trabajo entre múltiples máquinas. En la práctica, sharding implica particionamiento, pero no todo particionamiento implica sharding; una tabla puede estar particionada en un único servidor sin distribuirse entre nodos.
¿Cuándo es necesario aplicar particionamiento de datos?
El particionamiento se vuelve necesario cuando el volumen de datos crece hasta el punto en que las consultas sobre la tabla completa empiezan a ser lentas o consumen recursos excesivos. Una señal clara es cuando los tiempos de respuesta aumentan de forma sostenida aunque el hardware no haya cambiado. También es recomendable aplicarlo desde el diseño inicial cuando se sabe que el sistema manejará grandes volúmenes de datos con patrones de acceso bien definidos, como series temporales o datos segmentados por región o categoría.
¿El particionamiento de datos mejora el rendimiento de las consultas?
Sí, siempre que la estrategia de particionamiento esté alineada con el patrón de consulta predominante. Cuando una consulta filtra por la columna usada como clave de partición, el motor de base de datos aplica poda de particiones y lee únicamente los datos relevantes. Esto reduce drásticamente el volumen de datos procesados y, por tanto, el tiempo de respuesta y el costo computacional. Sin embargo, si la consulta no filtra por la clave de partición, el sistema debe leer todas las particiones, lo que puede resultar incluso menos eficiente que sin particionamiento.
¿Qué es una clave de partición y cómo se elige?
La clave de partición es la columna o conjunto de columnas que el sistema usa para decidir a qué partición pertenece cada registro. Elegirla correctamente es la decisión más importante del diseño de particionamiento, porque de ella dependen tanto el rendimiento de las consultas como la uniformidad de la distribución de datos. Una buena clave de partición tiene alta cardinalidad, se usa frecuentemente en los filtros de las consultas y distribuye los registros de manera relativamente equilibrada entre las particiones disponibles.
¿Qué es el data skew y cómo afecta al particionamiento?
El data skew, o sesgo de datos, ocurre cuando los registros no se distribuyen de forma uniforme entre las particiones, de modo que algunas contienen muchos más datos que otras. En un sistema distribuido, el sesgo provoca que las tareas que procesan las particiones más grandes tarden mucho más, mientras los nodos que procesan las particiones pequeñas quedan ociosos esperando. El resultado es que el tiempo total del proceso lo determina la partición más cargada, no el promedio. Para mitigarlo, se puede cambiar la clave de partición, usar salting (añadir un sufijo aleatorio a la clave) o aplicar redistribución explícita con repartition().
¿Cuál es la diferencia entre particionamiento horizontal y vertical?
El particionamiento horizontal divide el conjunto de datos por filas: cada partición tiene el mismo esquema pero contiene un subconjunto distinto de registros. El particionamiento vertical, en cambio, divide el conjunto de datos por columnas: cada partición tiene el mismo número de registros, pero solo incluye un subconjunto de las columnas originales. La elección entre uno y otro depende del problema que se quiere resolver: el horizontal es ideal para escalar el volumen de registros, mientras que el vertical es útil cuando distintas columnas tienen patrones de acceso o requisitos de seguridad muy diferentes.
¿Qué herramientas soportan particionamiento de datos de forma nativa?
Las principales herramientas de procesamiento y almacenamiento de datos modernas soportan particionamiento de forma nativa. Apache Spark, Snowflake, Google BigQuery, Amazon Redshift, Apache Hive y Apache Kafka son algunos de los ejemplos más habituales en entornos profesionales. Cada una implementa el particionamiento de forma diferente: mientras Spark requiere configuración explícita a través de su API, Snowflake gestiona el microparticionamiento de forma automática. Elegir la herramienta adecuada implica también entender cómo gestiona el particionamiento internamente y qué control ofrece al equipo de datos.
Conclusión
El particionamiento de datos es una técnica que transforma la forma en que un sistema organiza y accede a grandes volúmenes de información. Dividir los datos en fragmentos manejables no solo acelera las consultas, sino que permite escalar los sistemas sin que el rendimiento se deteriore con el crecimiento del volumen. Aplicarlo bien marca una diferencia real en cualquier proyecto de ingeniería de datos.
A lo largo de este recorrido has visto los tres grandes tipos de particionamiento (horizontal, vertical y funcional), las estrategias concretas para implementarlo (rango, hash, lista y compuesto) y los errores más habituales que debes evitar. Con esta base puedes analizar el patrón de acceso de tu sistema y elegir la estrategia que mejor se adapte a él, en lugar de aplicar una solución genérica que no siempre funciona.
Si quieres seguir construyendo tu conocimiento en ingeniería de datos, en este sitio web encontrarás más contenido sobre los conceptos, herramientas y prácticas que usan los equipos de datos profesionales. Cada tema que domines te acerca un paso más a diseñar sistemas que funcionen de verdad a escala.
Sigue aprendiendo:
Diferencia entre arquitectura Lambda y Kappa
¿Qué hace un ingeniero de datos?
Dimensiones de cambio lento: Conserva tu historial sin perder datos
Stack de datos moderno: La revolución silenciosa del análisis
AWS Glue: El secreto detrás de los grandes pipelines de datos
Data Mesh: La arquitectura que descentraliza datos
Arquitectura de datos: El secreto que mueve los datos de tu empresa
¿Cómo crear tu primer DAG en Apache Airflow?
