
Imagina que un cliente cambia de ciudad y, al mes siguiente, tus reportes siguen mostrando la dirección anterior. No es un bug: es una decisión de diseño. Las dimensiones de cambio lento son el mecanismo que define qué hace tu data warehouse cuando un dato se modifica, y entenderlas es más importante de lo que parece.
¿Qué son las dimensiones de cambio lento (SCD)?
En cualquier sistema de almacenamiento de datos, la información no permanece estática para siempre. Los clientes cambian de dirección, los productos se reclasifican, los empleados cambian de departamento. Las dimensiones de cambio lento, o SCD (Slowly Changing Dimensions), son el conjunto de estrategias que define cómo reacciona un data warehouse cuando los atributos de una dimensión se modifican con el tiempo.
El término fue popularizado por Ralph Kimball en su libro The Data Warehouse Toolkit, que se convirtió en la referencia central del modelado dimensional. Kimball definió originalmente los tipos 1, 2 y 3, y con el tiempo la comunidad añadió variantes adicionales para escenarios más específicos. Hoy, los tipos 0, 1, 2, 3, 4 y 6 son los más documentados y utilizados en proyectos reales.
El concepto de dimensión en un data warehouse
En el modelado dimensional, una dimensión es una tabla que agrupa atributos descriptivos relacionados con un mismo concepto, como clientes, productos, vendedores o ubicaciones geográficas. Estas tablas se combinan con las tablas de hechos, que registran las transacciones o métricas del negocio, para dar contexto a los datos y permitir el análisis.
A diferencia de las tablas de hechos, que crecen de forma continua con nuevas filas, las dimensiones tienden a ser relativamente estables. No obstante, esa estabilidad es relativa: un cliente puede cambiar de dirección, un producto puede pasar a otra categoría o un vendedor puede ser asignado a otra región. Es en esos momentos donde entra en juego la estrategia SCD.
¿Por qué se llaman «de cambio lento»?
El nombre no implica que los cambios sean insignificantes, sino que ocurren con mucho menos frecuencia que los eventos registrados en las tablas de hechos. Una venta puede generarse miles de veces al día, pero la dirección de un cliente cambia, quizás, una vez al año. Esa cadencia baja pero real es lo que da nombre a estas dimensiones: cambian, pero lo hacen despacio.
El reto no está en detectar que el cambio ocurrió, sino en decidir qué hacer con él. ¿Se reemplaza el valor anterior y se pierde el historial? ¿Se conservan ambas versiones en registros separados? ¿Se añade una columna adicional para guardar el valor previo? Cada una de esas respuestas corresponde a un tipo diferente de SCD, y elegir mal puede distorsionar por completo el análisis histórico del negocio.
Tipos de dimensiones de cambio lento
Existen varios tipos de SCD, cada uno con una lógica diferente para gestionar los cambios en los atributos de una dimensión. Los más utilizados en proyectos reales son el tipo 1 y el tipo 2, aunque los demás aparecen con frecuencia en escenarios específicos. A continuación se describe cada uno con sus características, ventajas y casos de uso.
SCD tipo 0: sin cambios
El tipo 0 es la opción más simple de todas: los atributos de la dimensión se tratan como inmutables desde su carga inicial. Si el valor cambia en el sistema fuente, el data warehouse simplemente ignora ese cambio y conserva el valor original. No se trata de un olvido ni de un error; es una decisión de diseño consciente.
Este tipo se aplica a atributos que, por definición de negocio, no deben actualizarse nunca: la fecha de nacimiento de un cliente, el número de documento de identidad o el año de fundación de una empresa. Si bien técnicamente podrían modificarse en la fuente, el data warehouse elige no reflejar esa modificación para preservar la coherencia histórica del modelo.
SCD tipo 1: sobrescribir el valor
En el tipo 1, cuando un atributo cambia, el valor anterior se reemplaza directamente por el nuevo sin dejar ningún registro del estado previo. Es la estrategia más sencilla de implementar y la que menos complejidad añade al modelo dimensional. No requiere columnas adicionales, nuevas filas ni tablas de soporte.
Su limitación más importante es que destruye el historial. Si necesitas saber qué dirección tenía un cliente hace seis meses, el tipo 1 no te lo podrá responder. Por eso se recomienda únicamente para atributos donde el valor histórico carece de relevancia analítica, como corregir un error ortográfico en un nombre o actualizar un número de teléfono de contacto.
⚠️ Cuándo usar SCD tipo 1
- Corrección de errores: Un nombre mal escrito, un código equivocado o una categoría asignada por error.
- Datos de contacto: Teléfonos o correos electrónicos donde solo importa el valor actual.
- Atributos sin valor histórico: Campos que el negocio nunca necesitará consultar por período de tiempo.
SCD tipo 2: añadir una nueva fila
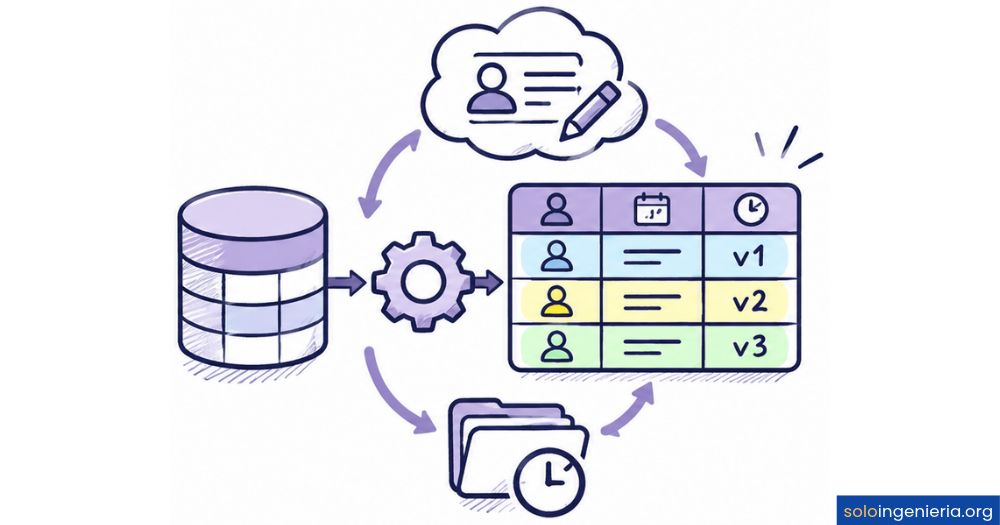
El tipo 2 es el más utilizado en proyectos de data warehousing. Cuando un atributo cambia, el registro existente se marca como expirado y se inserta una nueva fila que representa el estado actual del dato. Ambas filas coexisten en la tabla, identificadas por fechas de vigencia o indicadores de registro activo.
Esta estrategia conserva el historial completo de cada cambio, lo que permite responder preguntas como: ¿en qué región estaba asignado ese vendedor durante el tercer trimestre del año pasado? Para que funcione correctamente, se requiere una clave subrogada que identifique de forma única cada versión del registro, ya que la clave natural del negocio se repite entre versiones.
Ejemplo de tabla con SCD tipo 2: cada versión del cliente ocupa su propia fila.
SCD tipo 3: añadir una nueva columna
En lugar de crear filas nuevas, el tipo 3 agrega columnas adicionales a la tabla de dimensión para almacenar el valor anterior de un atributo. Permite conocer el valor actual y el valor previo, pero no guarda un historial más profundo. Si el atributo cambia por segunda vez, el valor del primer estado se pierde definitivamente.
Este tipo es útil en casos donde solo interesa comparar el estado actual con el estado inmediatamente anterior. Por ejemplo, una empresa que quiere saber si un producto cambió de categoría recientemente, sin necesidad de rastrear todos los cambios anteriores. Su ventaja es que las consultas son simples y no requieren uniones entre filas de la misma entidad.
SCD tipo 4: tabla histórica separada
El tipo 4 divide la información en dos tablas: una que contiene únicamente el registro actual de cada entidad y otra que almacena el historial completo de todos los cambios registrados. La tabla principal permanece liviana y optimizada para las consultas del día a día, mientras que la tabla histórica absorbe toda la complejidad del seguimiento de versiones.
Esta separación resulta especialmente útil cuando las dimensiones son muy anchas, es decir, cuando tienen muchas columnas, y cuando las consultas históricas son poco frecuentes. Al no mezclar registros actuales e históricos en la misma tabla, las consultas habituales son más rápidas y el modelo es más fácil de mantener en el tiempo.
SCD tipo 6: enfoque híbrido
El tipo 6 combina las estrategias de los tipos 1, 2 y 3 en una sola estructura, de ahí su nombre (1 + 2 + 3 = 6). Cada fila incluye el valor actual del atributo, el valor previo y además participa en el sistema de versiones por filas propio del tipo 2. El resultado es una tabla que permite consultar tanto el estado actual como cualquier versión histórica sin necesidad de hacer uniones complejas.
El precio de esa flexibilidad es una mayor complejidad en el proceso ETL y en el mantenimiento del modelo. Se recomienda solo cuando el equipo de datos tiene experiencia sólida en modelado dimensional y cuando los requerimientos de análisis realmente justifican esa sofisticación. Para la mayoría de los casos, el tipo 2 es suficiente.
¿Cómo elegir el tipo de SCD correcto?
La elección del tipo de SCD no depende de preferencias personales ni de modas tecnológicas: depende de qué preguntas necesitará responder el negocio con esos datos en el futuro. Antes de decidir, conviene plantearse tres preguntas clave: ¿el historial de este atributo tiene valor analítico?, ¿con qué frecuencia cambia?, ¿cuántos cambios hacia atrás necesita rastrear el sistema?
Una regla práctica que siguen muchos equipos es la siguiente: aplica el tipo 1 cuando el historial no importa, el tipo 2 cuando necesitas rastrear todos los cambios y el tipo 3 cuando solo te interesa comparar el estado actual con el inmediatamente anterior. No existe un tipo universalmente correcto; la decisión es siempre por atributo, no por tabla completa. Un mismo cliente puede tener algunos campos con tipo 1 y otros con tipo 2.
| Tipo SCD | ¿Conserva historial? | Complejidad | Caso de uso típico |
|---|---|---|---|
| Tipo 0 | N/A (nunca cambia) | Mínima | Fecha de nacimiento, número de documento |
| Tipo 1 | No | Baja | Corrección de errores, teléfonos de contacto |
| Tipo 2 | Completo | Media | Cambios de región, categoría de cliente, rol de empleado |
| Tipo 3 | Limitado (solo el anterior) | Baja–Media | Comparativa entre estado actual y estado previo |
| Tipo 4 | Completo (tabla separada) | Media–Alta | Dimensiones anchas con consultas históricas poco frecuentes |
| Tipo 6 | Máximo | Alta | Análisis histórico complejo con acceso directo al valor actual |
Dimensiones de cambio lento en el proceso ETL
Las SCD no viven aisladas en el modelo dimensional: su implementación real ocurre dentro del proceso ETL (extracción, transformación y carga). En cada ejecución del ETL, el sistema debe comparar los datos entrantes con los datos existentes en la dimensión para detectar qué cambió, qué se mantuvo igual y qué es completamente nuevo. Esa comparación define qué acción tomar según el tipo de SCD configurado.
Para el tipo 2, el ETL debe, además, generar claves subrogadas nuevas, establecer las fechas de vigencia del registro expirado y del registro nuevo, y actualizar el indicador de fila activa. Este proceso es conocido como operación UPSERT (insertar si no existe, actualizar si ya existe), y es uno de los patrones más comunes en pipelines de datos modernos.
Flujo típico del ETL para SCD tipo 2
- Extracción: Se obtienen los registros actualizados del sistema fuente.
- Comparación: Se contrasta cada registro con su versión existente en la dimensión.
- Detección del cambio: Si algún atributo monitoreado difiere, se activa la lógica SCD tipo 2.
- Cierre del registro anterior: Se actualiza la fecha de fin y se marca como inactivo.
- Inserción del nuevo registro: Se crea una fila nueva con clave subrogada generada, fecha de inicio y estado activo.
- Carga: Los cambios se aplican a la tabla de dimensiones en el data warehouse.
Herramientas como Azure Data Factory, dbt, Apache Spark y los dataflows de Microsoft Fabric incluyen componentes nativos para manejar SCD, lo que reduce significativamente el código personalizado necesario. Aun así, comprender la lógica subyacente es fundamental para depurar errores y tomar decisiones de diseño informadas.
Si te interesa explorar las herramientas y tecnologías que forman parte del ecosistema de trabajo de un profesional del área, puedes revisar los lenguajes para ser ingeniero de datos más demandados en el mercado actual, donde también se abordan los entornos en los que suelen implementarse estas estrategias.
Errores comunes al implementar SCD
Implementar dimensiones de cambio lento parece sencillo sobre el papel, pero en la práctica aparecen errores que pueden comprometer la integridad del historial y la fiabilidad de los reportes. El error más frecuente es aplicar el mismo tipo de SCD a todos los atributos de una tabla sin analizar cada uno por separado. No todos los campos de una misma dimensión merecen el mismo tratamiento.
Otro error habitual es aplicar el tipo 2 a atributos que cambian con mucha frecuencia, como el saldo de una cuenta o el precio diario de un producto. En esos casos, la tabla de dimensiones crece de forma descontrolada y el rendimiento del data warehouse se deteriora. Para atributos que cambian a diario o varias veces por semana, suele ser más adecuado modelarlos directamente en la tabla de hechos o utilizar mini-dimensiones (tipo 5).
La falta de documentación es también un problema crítico. Si el equipo no deja registro de qué tipo de SCD aplica a cada campo y por qué, el modelo se vuelve opaco para cualquier persona que se integre después al proyecto. Con el tiempo, nadie recuerda por qué ciertos campos tienen historial y otros no, y aparecen decisiones inconsistentes que degradan la calidad de los datos. Los proyectos de ingeniería de datos para portafolio más valorados son precisamente los que incluyen documentación del modelo dimensional, con las decisiones de SCD explícitas y justificadas.
Para profundizar aún más en este campo y construir una base sólida, el punto de partida siempre es la ingeniería de datos como disciplina, que proporciona el contexto necesario para entender dónde encajan las SCD dentro del ciclo completo de vida de los datos.
Preguntas frecuentes
¿Qué diferencia hay entre SCD tipo 1 y tipo 2?
La diferencia fundamental está en el tratamiento del historial. El tipo 1 sobrescribe el valor anterior sin conservar ningún registro del estado pasado, lo que simplifica el modelo, pero elimina la posibilidad de hacer análisis histórico sobre ese atributo. El tipo 2, en cambio, inserta una nueva fila cada vez que el atributo cambia, marcando la fila anterior como expirada y conservando todas las versiones anteriores accesibles para las consultas. Cuando el historial tiene valor analítico para el negocio, el tipo 2 es la opción adecuada; cuando no lo tiene, el tipo 1 es suficiente.
¿Cuál es el tipo de SCD más usado en la práctica?
El tipo 2 es el más utilizado en proyectos reales de data warehousing. Su capacidad para conservar el historial completo de los cambios lo hace adecuado para la mayoría de los escenarios analíticos donde importa saber cómo era el dato en un punto específico del tiempo. El tipo 1 también es muy frecuente, aunque suele aplicarse de forma complementaria al tipo 2 dentro del mismo modelo, en atributos donde el historial no tiene relevancia para el negocio.
¿Las dimensiones de cambio lento afectan el rendimiento del data warehouse?
Sí, especialmente el tipo 2. Al crear múltiples filas por cada entidad, la tabla de dimensiones crece con el tiempo y las consultas que buscan el registro activo deben filtrar por el indicador de estado o la fecha de vigencia. En la mayoría de los sistemas modernos, este impacto es manejable con índices adecuados, pero puede convertirse en un problema serio si se aplica tipo 2 a atributos que cambian con mucha frecuencia o si la tabla dimensión tiene millones de registros base.
¿Se pueden combinar varios tipos de SCD en una misma tabla?
Sí, y de hecho es una práctica habitual y recomendada. La decisión del tipo de SCD se toma a nivel de atributo, no de tabla. Esto significa que, en una misma dimensión de clientes, el nombre puede manejarse con tipo 1 (sobrescribir si hay un error), la ciudad con tipo 2 (conservar historial completo de cambios de residencia) y el segmento de cliente con tipo 3 (guardar el segmento actual y el anterior). La clave es documentar claramente qué tipo aplica a cada campo y mantener esa documentación actualizada.
¿Qué es una clave subrogada y por qué se usa en SCD tipo 2?
Una clave subrogada es un identificador artificial generado por el propio data warehouse, independiente del identificador del sistema fuente. En el tipo 2, como el mismo cliente puede tener varias filas (una por cada versión de su registro), la clave natural del negocio se repite entre filas. La clave subrogada permite identificar de forma única cada versión, vincularla correctamente con los registros de la tabla de hechos correspondientes a ese período y evitar ambigüedades en los joins entre tablas.
¿Qué herramientas soportan la implementación de SCD?
Varias plataformas incluyen soporte nativo o semi-nativo para SCD. Azure Data Factory y Dataflow Gen2 de Microsoft Fabric ofrecen componentes específicos para tipo 1 y tipo 2. dbt permite implementar SCD tipo 2 mediante el uso de snapshots con configuración declarativa. Apache Spark y herramientas ETL como Talend o Informatica también disponen de transformaciones dedicadas a este patrón. La elección de la herramienta dependerá del stack tecnológico del proyecto y del tipo de SCD a implementar.
¿Cuándo conviene usar SCD tipo 4 en lugar de tipo 2?
El tipo 4 es preferible al tipo 2 cuando la dimensión es muy ancha, es decir, cuando tiene muchas columnas, y cuando la mayoría de las consultas del negocio solo necesitan el estado actual de los datos. Al separar el registro actual en una tabla liviana y el historial en una tabla secundaria, las consultas habituales son más rápidas porque no tienen que filtrar entre múltiples versiones del mismo registro. El tipo 2 sigue siendo más adecuado cuando los accesos históricos son frecuentes y el rendimiento de las consultas al historial también es prioritario.
Conclusión
Las dimensiones de cambio lento son el mecanismo que decide qué recuerda tu data warehouse cuando los datos evolucionan con el tiempo. Cada tipo ofrece un equilibrio diferente entre simplicidad, fidelidad histórica y rendimiento: desde el tipo 1, que prioriza la sencillez, hasta el tipo 2, que conserva cada versión de un dato para el análisis más riguroso.
El paso más importante que puedes dar es analizar cada atributo de tus dimensiones por separado y decidir qué tipo de SCD le corresponde según el valor analítico de su historial. No existe una única respuesta correcta para todos los campos: la combinación de tipos dentro de una misma tabla es una práctica habitual y recomendada. Documentar esas decisiones te ahorrará rediseños costosos más adelante.
Si sientes que este tema ha abierto más preguntas de las que ha cerrado, es una buena señal: el modelado dimensional es un campo rico y con mucho por explorar. Este sitio web tiene más contenido sobre ingeniería de datos que puede ayudarte a seguir construyendo esa comprensión de forma progresiva y sólida.
Sigue aprendiendo:
Change Data Capture (CDC): El secreto detrás de los datos en vivo
DBT: La herramienta que cambió cómo se trabajan los datos
Arquitectura de datos: El secreto que mueve los datos de tu empresa
¿Qué es ETL? – Extracción, Transformación y Carga
Diferencia entre Parquet y CSV
Modelado dimensional: Organiza datos para tomar mejores decisiones
Stack de datos moderno: La revolución silenciosa del análisis
Azure Data Factory (ADF): El servicio que mueve tus datos en la nube ☁️
