
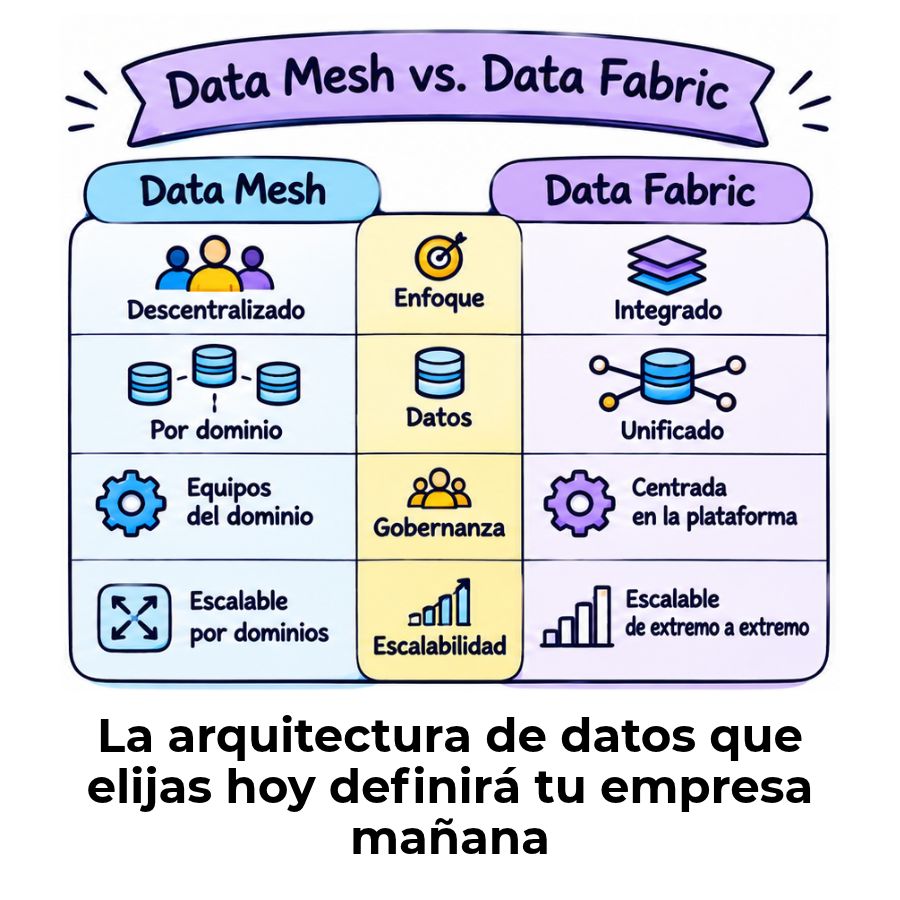
Data Mesh y Data Fabric son dos arquitecturas modernas para gestionar grandes volúmenes de datos, pero su enfoque es diferente: mientras Data Mesh distribuye la responsabilidad de los datos entre los equipos de cada área, Data Fabric construye una capa tecnológica unificada que conecta fuentes sin necesidad de moverlas.
¿Qué son Data Mesh y Data Fabric?
Antes de comparar ambos enfoques, conviene tener claro qué significa cada uno por separado. Aunque los dos buscan resolver el caos que generan los datos dispersos en grandes organizaciones, parten de premisas muy distintas: uno es principalmente un modelo organizacional y el otro, una arquitectura tecnológica.
Definición de Data Fabric
Data Fabric es una arquitectura tecnológica que conecta y unifica fuentes de datos dispersas sin necesidad de moverlas físicamente a un único repositorio. Funciona como una capa inteligente que cubre bases de datos locales, almacenes en la nube y sistemas heredados, permitiendo que todos los datos sean accesibles desde un único punto. Su motor principal son los metadatos: los analiza de forma automatizada para facilitar el descubrimiento, la integración y el gobierno de la información.
El término fue popularizado por analistas del sector tecnológico hacia 2015 y retomado con fuerza por firmas especializadas en arquitecturas de datos. Su valor central radica en que no obliga a centralizar físicamente los datos, sino en ofrecer acceso unificado a través de servicios, APIs y virtualización, lo que lo convierte en una solución viable para organizaciones con infraestructuras complejas y distribuidas.
Definición de Data Mesh
Data Mesh es un modelo organizacional y arquitectónico que distribuye la propiedad de los datos entre los equipos de cada área de negocio, tratándolos como productos. En lugar de que un equipo central de datos controle toda la información de la empresa, cada dominio —como ventas, marketing o finanzas— gestiona sus propios datos con autonomía, calidad y estándares propios. Fue propuesto por Zhamak Dehghani en un artículo que cuestionó el modelo del data lake centralizado.
Lo que hace diferente al Data Mesh no es la tecnología que usa, sino la forma en que organiza las responsabilidades dentro de la empresa. Cada equipo de dominio actúa como productor de datos para los demás, con la obligación de garantizar que esos datos sean accesibles, comprensibles y de calidad. Este cambio de mentalidad es el que más tiempo y esfuerzo requiere en cualquier implementación.
¿En qué se diferencian Data Mesh y Data Fabric?
La diferencia más importante entre ambos enfoques no está en sus herramientas, sino en la pregunta que cada uno responde. Data Mesh responde quién es responsable de los datos; Data Fabric responde cómo se conectan e integran esos datos. Son ángulos distintos del mismo problema y, por eso, muchas organizaciones acaban usando ambos de forma complementaria.
| Dimensión | Data Mesh | Data Fabric |
|---|---|---|
| Naturaleza principal | Organizacional y cultural | Tecnológica y arquitectónica |
| ¿Qué descentraliza? | La propiedad y responsabilidad de los datos | El acceso, sin descentralizar el control |
| Motor principal | Equipos de dominio autónomos | Metadatos automatizados e inteligencia |
| Gobernanza | Federada: cada dominio define sus reglas bajo un marco común | Centralizada y automatizada por la capa técnica |
| Escalabilidad | Añadiendo nuevos dominios y equipos | Incorporando nuevas fuentes y automatizando pipelines |
| Complejidad principal | Organizacional y de cambio cultural | Técnica e infraestructural |
| Resultado esperado | Datos de alta calidad gestionados por quienes más los conocen | Acceso unificado a datos distribuidos sin moverlos |
Una forma sencilla de recordarlo: Data Mesh pone el foco en las personas y los equipos, mientras que Data Fabric pone el foco en la tecnología y la automatización. Elegir entre uno u otro depende de cuál es el problema más urgente que tu organización necesita resolver.
Los cuatro principios del Data Mesh
El Data Mesh no es simplemente una herramienta que se instala: es un paradigma que requiere repensar cómo una organización se relaciona con sus datos. Se sostiene sobre cuatro principios que, tomados en conjunto, definen tanto la estructura técnica como el modelo de trabajo de los equipos implicados.
El primer principio, la propiedad de datos por dominio, es el más disruptivo: elimina el modelo en el que un único equipo central se convierte en cuello de botella. El segundo, datos como producto, exige que cada equipo publique sus datos con la misma responsabilidad que si lanzara un servicio para clientes internos. El tercero, la infraestructura de autoservicio, garantiza que los dominios puedan operar de forma autónoma sin necesitar especialistas externos para cada tarea técnica. Y el cuarto, la gobernanza federada, mantiene la coherencia global sin ahogar la autonomía local.
Estos principios no son independientes: se refuerzan entre sí. Sin gobernanza federada, la autonomía de los dominios genera silos. Sin infraestructura de autoservicio, la propiedad por dominio se convierte en una carga imposible para equipos que no son especialistas en datos. La coherencia entre los cuatro principios es lo que hace que el modelo funcione en la práctica, y también lo que lo convierte en un reto organizacional de envergadura.
¿Cómo funciona Data Fabric técnicamente?
Data Fabric no es un producto concreto ni una plataforma específica: es un patrón arquitectónico que se implementa combinando diferentes tecnologías. Su núcleo es una capa de abstracción inteligente que hace que los datos sean accesibles desde cualquier punto sin importar dónde residen físicamente. Para conseguirlo, se apoya en tres pilares técnicos que trabajan de forma coordinada.
Metadatos y automatización en Data Fabric
Los metadatos son el motor de Data Fabric. En lugar de mover datos de un sistema a otro, Data Fabric analiza continuamente los metadatos de cada fuente para entender qué contienen, cómo se relacionan y cómo pueden usarse. Este análisis automatizado permite descubrir nuevas fuentes de datos, detectar relaciones entre conjuntos aparentemente desconectados y aplicar reglas de gobernanza de forma consistente sin intervención manual constante. Es precisamente esta automatización la que lo diferencia de enfoques de integración más tradicionales.
Los catálogos de datos con capacidades de inteligencia artificial son una pieza clave en esta capa. Aprenden del comportamiento de los usuarios y del linaje de los datos para sugerir conexiones, alertar sobre inconsistencias y recomendar políticas de acceso. Esto reduce drásticamente el trabajo manual de los ingenieros de datos y acelera el tiempo que tarda una organización en pasar de un dato crudo a un dato útil.
Virtualización de datos y acceso unificado
La virtualización de datos es la técnica que permite a Data Fabric ofrecer una vista unificada sin consolidar físicamente la información. Cuando un analista consulta un dato, Data Fabric lo recupera directamente desde su fuente original, ya sea una base de datos on-premise, un almacén en la nube o un sistema heredado, y lo presenta como si todo viniera del mismo lugar. Esto elimina la necesidad de duplicar datos y mantener copias actualizadas en múltiples sitios.
El resultado práctico es que los equipos de análisis y ciencia de datos pueden trabajar con información de múltiples fuentes sin esperar a que un equipo de ingeniería construya un pipeline específico para cada caso. Data Fabric reduce esa dependencia al proporcionar acceso directo y gobernado desde la capa de abstracción, lo que acelera considerablemente los ciclos de análisis.
¿Cuándo usar Data Mesh y cuándo Data Fabric?
La elección entre uno y otro no es una cuestión de cuál es mejor en términos absolutos, sino de cuál resuelve mejor el problema concreto que tu organización enfrenta. El punto de partida debe ser un diagnóstico honesto de dónde está el mayor obstáculo: en la organización o en la tecnología.
- Tu organización tiene múltiples áreas con datos muy distintos entre sí
- El equipo central de datos es un cuello de botella constante
- Los equipos de negocio conocen sus datos mejor que el equipo técnico
- Quieres escalar la gestión de datos junto con el crecimiento de la empresa
- Estás dispuesto a invertir en un cambio cultural profundo
- Tienes datos en múltiples sistemas que necesitas conectar con rapidez
- No puedes permitirte una transformación organizacional inmediata
- Necesitas resultados visibles en el corto plazo
- Tu infraestructura es híbrida (on-premise + nube) y muy fragmentada
- Buscas automatizar la gobernanza sin rediseñar la estructura de equipos
Una regla práctica: si el problema principal es que nadie sabe quién es responsable de qué dato, la solución apunta a Data Mesh. Si el problema es que los datos existen pero son inaccesibles o están dispersos en sistemas incompatibles, la solución apunta a Data Fabric. Muchas organizaciones maduras acaban necesitando los dos enfoques, pero raramente tiene sentido implementarlos a la vez desde el inicio.
También importa el tamaño y la madurez de la organización. Data Mesh requiere un nivel mínimo de madurez en gestión de datos y una cultura organizacional que tolere la autonomía de los equipos. Data Fabric, en cambio, puede aportar valor más rápidamente porque no exige transformar la cultura antes de ver resultados, y eso lo convierte en un punto de entrada más accesible para organizaciones que están comenzando a modernizar su arquitectura de datos. Si quieres profundizar en las herramientas técnicas que se usan en estos procesos, explorar las librerías de Python para ingeniería de datos te dará una base muy sólida sobre las tecnologías que sostienen estas arquitecturas.
¿Pueden trabajar juntos Data Mesh y Data Fabric?
Esta es una de las preguntas que más confusión genera, y la respuesta es sí, con matices. Data Mesh y Data Fabric no son enfoques mutuamente excluyentes; de hecho, en muchas organizaciones, uno actúa como la infraestructura que habilita al otro. La confusión surge porque se presentan como alternativas cuando en realidad operan en capas distintas del problema.
En la práctica, Data Fabric puede actuar como la infraestructura técnica sobre la que opera un modelo Data Mesh. Los dominios gestionan sus datos como productos (Data Mesh), mientras que Data Fabric garantiza que esos productos sean accesibles, seguros y consistentes para el resto de la organización. La capa técnica de Data Fabric resuelve el problema de la integración; la estructura organizacional de Data Mesh resuelve el problema de la responsabilidad.
Esta combinación no es siempre necesaria ni recomendable desde el inicio. Intentar implementar ambos enfoques simultáneamente desde cero puede ser una fuente de complejidad innecesaria. Lo más habitual en organizaciones que han avanzado en este camino es adoptar primero uno de los dos enfoques, consolidarlo y luego incorporar el otro de forma progresiva. El campo de la ingeniería de datos ofrece muchos más conceptos y herramientas que complementan esta visión arquitectónica.
Desafíos de implementar cada arquitectura
Tanto Data Mesh como Data Fabric tienen ventajas claras, pero ninguno de los dos se implementa sin fricciones. Conocer los obstáculos más comunes antes de empezar es lo que separa una adopción exitosa de un proyecto que se abandona a mitad de camino. Los retos son distintos para cada enfoque, porque las complejidades que enfrentan también lo son.
Retos del Data Mesh
El mayor desafío del Data Mesh no es técnico, sino cultural. Requiere que los equipos de negocio asuman una responsabilidad sobre sus datos que históricamente nunca han tenido. Esto implica aprender a publicar datos con estándares de calidad, mantener documentación actualizada y pensar en otros equipos como consumidores de su información. Para muchas organizaciones, ese cambio de mentalidad es el obstáculo más difícil de superar y el que más tiempo requiere.
Además, la coordinación entre dominios autónomos genera sus propios problemas. Sin una gobernanza federada bien definida, los dominios pueden empezar a aplicar estándares distintos, crear definiciones incompatibles de los mismos conceptos y generar, paradójicamente, nuevos silos de datos. La autonomía sin marco común es uno de los errores más frecuentes en implementaciones de Data Mesh que no llegan a buen término.
Retos del Data Fabric
Data Fabric concentra su complejidad en la capa técnica. Implementar una arquitectura de este tipo requiere herramientas sofisticadas de gestión de metadatos, integración de sistemas heterogéneos y configuración de reglas de acceso que funcionen de forma consistente en entornos muy distintos. No es una solución que se active con un solo producto: es la combinación de varias tecnologías que deben colaborar sin fricciones.
El coste de mantenimiento también puede ser un reto significativo. La capa de metadatos necesita actualizarse continuamente para reflejar los cambios en las fuentes de datos, los nuevos sistemas incorporados y las políticas de gobernanza que evolucionan con el tiempo. Si ese mantenimiento no está garantizado, la promesa de acceso unificado empieza a degradarse, y la capa técnica se convierte en un nuevo punto de fallo en lugar de una solución.
Preguntas frecuentes
¿Qué diferencia hay entre Data Mesh y Data Fabric?
La diferencia principal radica en su naturaleza: Data Mesh es un modelo organizacional que distribuye la propiedad de los datos entre equipos de dominio, mientras que Data Fabric es una arquitectura tecnológica que conecta fuentes de datos dispersas sin moverlas físicamente. Data Mesh pregunta quién es responsable de los datos; Data Fabric responde cómo se integran y hacen accesibles. Uno es un cambio de estructura empresarial y el otro es una solución de infraestructura técnica.
¿Cuál es mejor, Data Mesh o Data Fabric?
Ninguno es mejor en términos absolutos: depende del problema que necesitas resolver. Si el obstáculo principal es que nadie sabe quién gestiona qué dato o que el equipo central es un cuello de botella, Data Mesh es la respuesta. Si el problema es que tienes datos en múltiples sistemas incompatibles y necesitas acceso unificado sin grandes transformaciones organizacionales, Data Fabric es más adecuado. Muchas organizaciones acaban combinando ambos enfoques en diferentes fases de su madurez en la gestión de datos.
¿Qué es un dominio en Data Mesh?
En Data Mesh, un dominio es una unidad de negocio o área funcional que tiene plena responsabilidad sobre los datos que genera y utiliza. Puede ser el área de ventas, marketing, logística, finanzas o cualquier otra división que tenga datos propios y diferenciados. Cada dominio actúa como productor de datos para los demás equipos, con la obligación de publicarlos con calidad, documentación y contratos de acceso claros. Este concepto es el corazón del modelo Data Mesh y la pieza que más cambia respecto a los modelos centralizados tradicionales.
¿Qué significa tratar los datos como un producto?
Tratar los datos como un producto significa que el equipo que genera esos datos asume la responsabilidad de publicarlos con la misma calidad, documentación y accesibilidad que se espera de cualquier producto destinado a usuarios. Los datos como producto deben ser descubribles, comprensibles, fiables y consumibles por otros equipos sin necesidad de contactar directamente al equipo productor para entender qué contienen o cómo usarlos. Este enfoque elimina la dependencia de acuerdos informales entre equipos y convierte los datos en activos reutilizables de forma autónoma.
¿Qué es la gobernanza federada en Data Mesh?
La gobernanza federada es el mecanismo que permite que Data Mesh mantenga coherencia global sin centralizar el control. Consiste en definir un conjunto de reglas y estándares comunes que todos los dominios deben cumplir, pero dejar a cada dominio la libertad de aplicarlos a su manera dentro de ese marco. Garantiza que los datos de distintos dominios puedan interoperar sin imponer un control jerárquico que anule la autonomía local. Es el equilibrio entre consistencia organizacional y flexibilidad operativa.
¿Qué tecnologías se usan en Data Fabric?
Data Fabric no prescribe tecnologías específicas, pero sí se apoya en un conjunto de capacidades técnicas bien definidas. Los catálogos de datos con capacidades de inteligencia artificial, los motores de virtualización de datos, las herramientas de integración basadas en APIs y los sistemas de gestión de metadatos activos son los pilares más comunes. Plataformas como IBM Data Fabric o soluciones de proveedores cloud como AWS, Azure y Google Cloud implementan variantes de este patrón arquitectónico con sus propias herramientas nativas.
¿Se pueden combinar Data Mesh y Data Fabric?
Sí, y de hecho es una combinación cada vez más frecuente en organizaciones con arquitecturas de datos maduras. Data Fabric puede actuar como la infraestructura técnica compartida sobre la que los dominios del Data Mesh publican y consumen sus productos de datos. Mientras cada dominio gestiona su propia información con autonomía, la capa de Data Fabric asegura que esa información sea accesible, integrada y gobernada de forma consistente para toda la organización. No son enfoques que se anulen entre sí, sino que responden a preguntas distintas del mismo problema.
¿Qué es la virtualización de datos en Data Fabric?
La virtualización de datos es una técnica que permite acceder a información almacenada en diferentes sistemas como si todos formaran parte de una misma fuente, sin necesidad de copiarlos o consolidarlos físicamente. En el contexto de Data Fabric, la virtualización actúa como el mecanismo principal para ofrecer una vista unificada de datos distribuidos en bases de datos locales, almacenes en la nube y sistemas heredados. El usuario o la aplicación consulta a través de la capa de virtualización, y esta recupera los datos directamente de su origen, aplicando las reglas de acceso y gobernanza correspondientes en tiempo real.
Conclusión
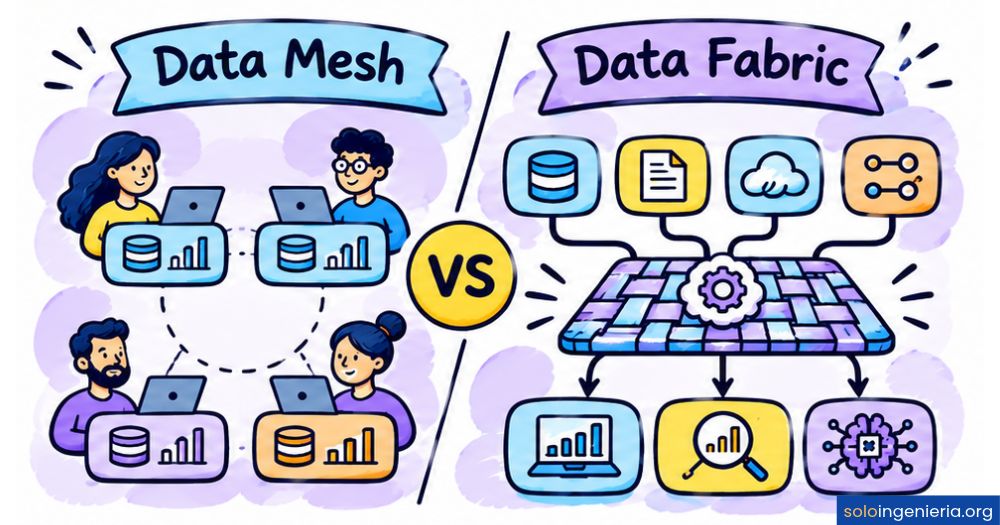
Data Mesh y Data Fabric son dos respuestas distintas al mismo problema: la dificultad de gestionar datos dispersos en organizaciones complejas. Data Mesh redistribuye la responsabilidad hacia los equipos de negocio que mejor conocen sus datos; Data Fabric construye una capa técnica que conecta fuentes sin moverlas. Entender esta diferencia de raíz es el primer paso para tomar decisiones de arquitectura con claridad.
Lo que has visto en este artículo te da las herramientas para diagnosticar cuál es el cuello de botella real en tu contexto. Si el problema es cultural y organizacional, el camino apunta a Data Mesh. Si es técnico e infraestructural, apunta a Data Fabric. Y si ya tienes cierta madurez en datos, combinarlos puede ser la estrategia más poderosa. Ningún enfoque funciona sin análisis previo y sin disposición a adaptar la estrategia cuando aparecen nuevos retos.
La ingeniería de datos avanza rápido, y estos conceptos seguirán evolucionando. En este sitio web encontrarás más contenido sobre arquitecturas, herramientas y prácticas que te ayudarán a seguir construyendo criterio en este campo. Cada concepto que dominas es un paso más hacia decisiones técnicas más sólidas y fundamentadas.
Sigue aprendiendo:
¿Qué es PySpark y para qué sirve?
Procesamiento de datos en tiempo real
Proyectos de ingeniería de datos para portafolio
Calidad de datos: El secreto que separa buenos de malos análisis
¿Cómo crear tu primer DAG en Apache Airflow?
¿Qué es un data warehouse y para qué sirve?
Apache Flink vs. Spark Streaming
Ingesta de datos: Transforma fuentes caóticas en valor real
