
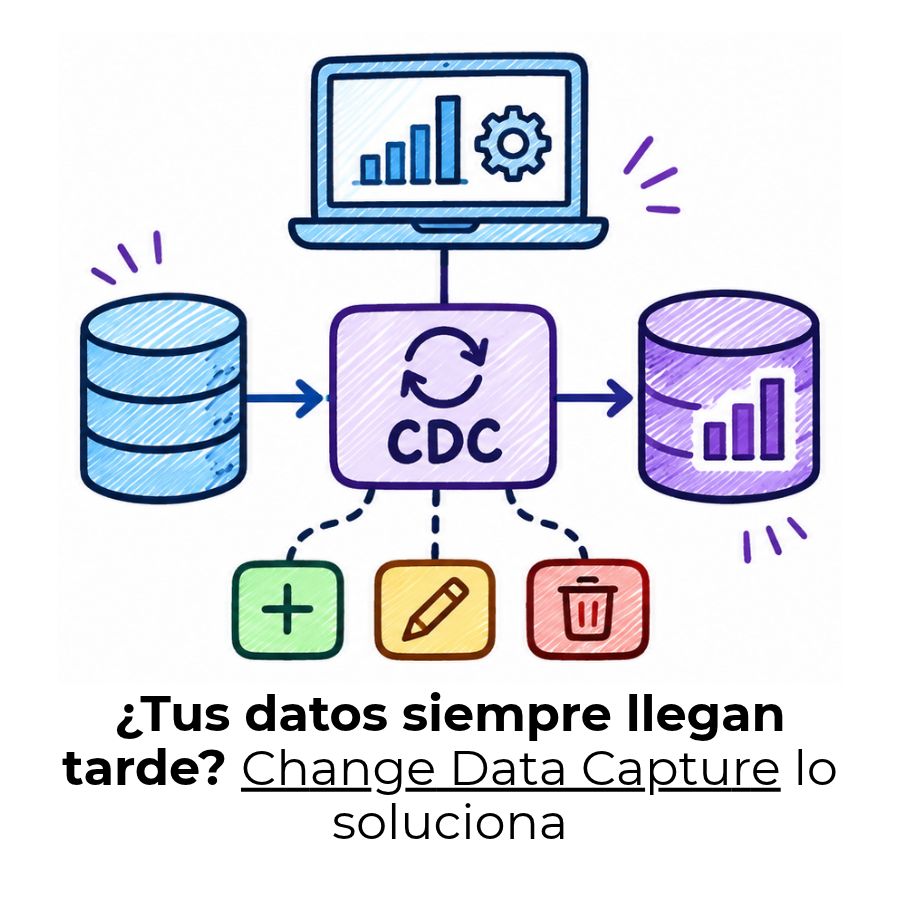
Change Data Capture, conocido como CDC, es una técnica de integración de datos que detecta y transmite en tiempo real los cambios ocurridos en una base de datos, como inserciones, actualizaciones y eliminaciones, hacia otros sistemas. Si te preguntas cómo funcionan los pipelines modernos que mantienen los datos sincronizados sin procesar millones de filas repetidas, esta es la respuesta.
¿Qué es Change Data Capture (CDC)?
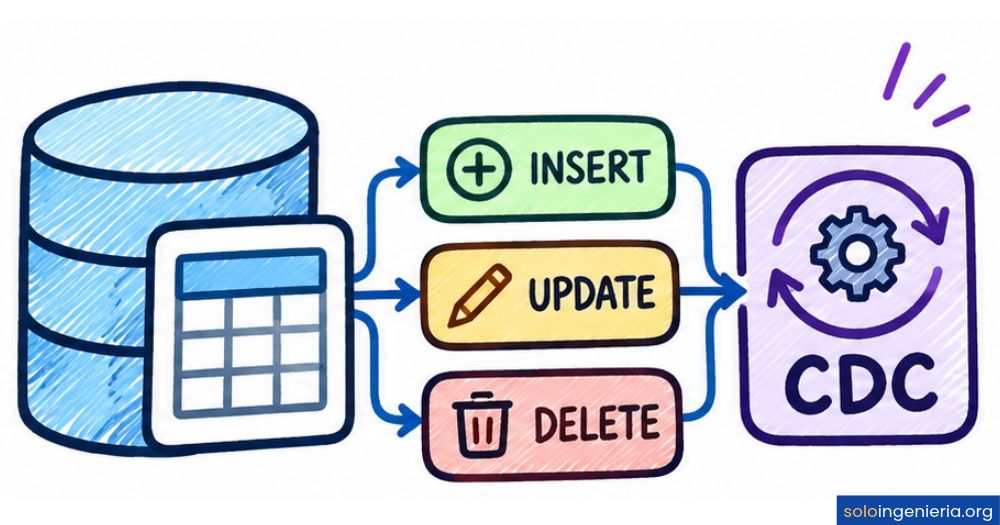
Change Data Capture (CDC) es una técnica de integración de datos que identifica y registra los cambios producidos en una base de datos —inserciones, actualizaciones y eliminaciones— y los transmite hacia sistemas externos de forma continua, sin necesidad de copiar el conjunto completo de datos cada vez. Es, en esencia, el mecanismo que permite que distintos sistemas permanezcan sincronizados con lo que ocurre en la fuente de verdad.
Cuando trabajas con datos, mantener la coherencia entre múltiples sistemas es uno de los desafíos más frecuentes. Una aplicación de comercio electrónico, por ejemplo, necesita que su catálogo de inventario, su sistema de pagos y su base analítica reflejen el mismo estado en todo momento. CDC hace posible esa sincronización propagando únicamente los registros que cambiaron, no la totalidad de la base de datos.
El problema que CDC resuelve en las bases de datos
Antes de CDC, la solución habitual para mantener sistemas sincronizados era el procesamiento por lotes: copiar todos los datos de la fuente hacia el destino cada cierta cantidad de horas. Ese enfoque tiene un defecto evidente: durante el intervalo entre copias, los sistemas de destino trabajan con información desactualizada. Para aplicaciones que requieren datos frescos, como análisis financiero o control de inventario, ese retraso tiene consecuencias directas.
CDC elimina ese problema al observar continuamente la base de datos y transmitir solo los registros que cambiaron, en el momento en que el cambio ocurre. No hay ventanas de tiempo, no hay copia masiva de filas sin modificar. Solo viajan los datos que realmente son nuevos, lo que reduce el consumo de recursos y mejora la frescura de la información en todos los sistemas conectados.
CDC como técnica de integración de datos en tiempo real
Dentro de la ingeniería de datos, CDC se clasifica como una técnica de integración continua. Se diferencia del ETL clásico en que no extrae, transforma y carga datos en momentos fijos, sino que actúa de forma reactiva: cada transacción confirmada en la base de datos de origen desencadena un evento que CDC captura y propaga. Eso permite construir pipelines que responden a los datos tal como evolucionan, no como eran hace una hora.
¿Cómo funciona el proceso de CDC?
El flujo de CDC tiene tres etapas bien definidas que se suceden de forma automática. Entender cada una te ayuda a elegir la arquitectura correcta y a diagnosticar problemas cuando algo no funciona como se espera. El proceso completo puede ocurrir en milisegundos, lo que convierte a CDC en la base de muchas arquitecturas de datos en tiempo real.
El motor CDC monitoriza el registro de transacciones de la base de datos de origen. Cuando detecta un cambio confirmado (INSERT, UPDATE o DELETE), lo lee y lo convierte en un evento estructurado.
El evento de cambio puede filtrarse, enriquecerse o transformarse antes de continuar. Esto permite eliminar datos irrelevantes, añadir contexto o adaptar el formato al sistema de destino.
El evento transformado llega al sistema de destino: un data warehouse, una cola de mensajes, un índice de búsqueda o un lago de datos. El destino aplica el cambio y queda sincronizado.
Captura del cambio en la fuente
La mayoría de los motores de bases de datos relacionales mantienen un registro interno de todas las transacciones confirmadas: se llama transaction log o write-ahead log (WAL). CDC lee ese registro sin intervenir en las operaciones normales de la base de datos, lo que lo convierte en un método de captura de bajo impacto. No añade carga extra a las consultas de la aplicación ni ralentiza las escrituras.
Transformación y enrutamiento del evento
Una vez capturado el cambio, el motor CDC lo convierte en un evento con estructura definida. Ese evento puede incluir el valor anterior del registro, el valor nuevo y metadatos como el nombre de la tabla, el tipo de operación y la marca de tiempo. En arquitecturas modernas, esta fase permite aplicar reglas de negocio, anonimizar datos sensibles o enrutar el evento hacia destinos diferentes según el tipo de cambio detectado.
Entrega al sistema de destino
El evento llega al destino a través de un canal de mensajería —como Apache Kafka— o directamente mediante conexiones de replicación. El destino puede ser un solo sistema o varios al mismo tiempo, lo que permite alimentar un data warehouse, actualizar una caché y notificar a un servicio de microservicios con un único flujo de eventos. Esta capacidad de distribución es una de las razones por las que CDC se ha vuelto fundamental en el procesamiento de datos en tiempo real.
Métodos de captura de datos: ¿cuál se adapta mejor a tu caso?
No existe un único modo de implementar CDC. Cada método tiene características distintas en cuanto a impacto sobre la base de datos de origen, fidelidad del cambio capturado y complejidad de implementación. Elegir el método correcto depende del volumen de cambios, la tolerancia a la latencia y las capacidades del motor de base de datos que uses.
CDC basado en registros de transacciones (log-based)
El método más extendido en entornos de producción es el basado en logs. Lee directamente el registro de transacciones del motor de base de datos, sin necesidad de agregar columnas adicionales ni crear disparadores. Es asíncrono respecto a la operación de escritura, lo que significa que tiene un impacto mínimo sobre el rendimiento de la base de datos de origen y soporta volúmenes altos de cambios sin degradar la experiencia de la aplicación principal.
«El CDC basado en logs es el estándar para la integración de datos empresarial: captura cambios a nivel de fila desde el registro de transacciones sin afectar a las operaciones de la base de datos de origen.»
CDC basado en disparadores (trigger-based)
En este enfoque, se crean disparadores (triggers) directamente sobre las tablas de la base de datos. Cada vez que ocurre un INSERT, UPDATE o DELETE, el disparador escribe el cambio en una tabla auxiliar que el sistema CDC lee posteriormente. Su ventaja es que funciona con prácticamente cualquier motor de base de datos, pero su desventaja es el impacto en el rendimiento: cada escritura implica una operación adicional que puede afectar la velocidad de la aplicación, especialmente bajo carga alta.
CDC basado en marcas de tiempo (timestamp-based)
Este método consulta periódicamente la base de datos buscando registros cuya columna de fecha de modificación sea posterior al último punto de control. Es sencillo de implementar, pero tiene limitaciones importantes: no detecta eliminaciones de registros a menos que uses marcado lógico, y la frecuencia de consulta introduce cierta latencia. Es adecuado para sistemas con baja frecuencia de cambios donde la simplicidad pesa más que la precisión.
| Método CDC | Impacto en origen | Detecta eliminaciones | Latencia |
|---|---|---|---|
| Log-based | Mínimo | Sí | Muy baja (ms) |
| Trigger-based | Moderado-alto | Sí | Baja |
| Timestamp-based | Bajo | No (sin marcado) | Media-alta |
CDC frente a ETL y procesamiento por lotes: diferencias clave
ETL (Extract, Transform, Load) es el proceso clásico para mover datos entre sistemas. Funciona por ciclos: extrae todos los datos de la fuente, los transforma y los carga en el destino en momentos programados. CDC, en cambio, no extrae bloques completos de datos en momentos fijos, sino que captura y transmite únicamente los cambios a medida que ocurren. Son enfoques complementarios, no mutuamente excluyentes.
El procesamiento por lotes tiene sentido cuando los datos de destino no necesitan frescura inmediata y los volúmenes son manejables. Pero cuando el negocio requiere reaccionar a los datos en segundos —o cuando el volumen de registros hace que procesar la tabla entera sea prohibitivo—, CDC se convierte en la opción más eficiente. Mueve menos datos, con menos latencia y con menor carga sobre la infraestructura.
| Característica | ETL / Batch | CDC |
|---|---|---|
| Frecuencia de ejecución | Programada (horas/días) | Continua (ms/segundos) |
| Volumen de datos movidos | Todo el conjunto | Solo los cambios |
| Frescura del dato | Horas de retraso | Casi en tiempo real |
| Detecta eliminaciones | Con lógica adicional | Nativo |
| Carga sobre la fuente | Alta (picos de lectura) | Baja (lectura de log) |
Casos de uso reales de Change Data Capture
CDC se aplica en situaciones donde la frescura del dato no es opcional, sino un requisito del negocio. Desde la sincronización de plataformas analíticas hasta la detección de fraude bancario, los casos de uso son amplios y cubren sectores muy distintos. Conocerlos te ayuda a identificar cuándo CDC es la herramienta correcta en tu propia arquitectura.
Sincronización de almacenes de datos y data lakehouses
Los data warehouses y data lakehouses —plataformas como Databricks o Snowflake— necesitan reflejar el estado actualizado de los sistemas transaccionales para que los análisis sean relevantes. CDC es el método estándar para «hidratar» estas plataformas: en lugar de recargar tablas enteras cada noche, solo se propagan los registros que cambiaron durante el día. El ahorro en tiempo de procesamiento y en costes de infraestructura es significativo.
Detección de fraude y cumplimiento normativo
En el sector financiero, cada transacción debe analizarse lo antes posible. CDC permite que los modelos de detección de fraude reciban datos de cada operación en tiempo real, en lugar de esperar al cierre de lote. Esta capacidad de reacción inmediata puede detener una transacción fraudulenta antes de que se complete. Además, los registros de cambio que genera CDC sirven como pista de auditoría para cumplir con normativas como GDPR, HIPAA o SOX.
Arquitecturas basadas en eventos y microservicios
En un sistema de microservicios, cada servicio tiene su propia base de datos. Cuando el servicio de pedidos actualiza el estado de un pedido, el servicio de inventario y el de notificaciones deben enterarse. CDC hace posible esa comunicación publicando cada cambio como un evento en un bus de mensajes, sin que los servicios dependan de llamadas directas entre sí. Esto reduce el acoplamiento y mejora la resiliencia del sistema. Es uno de los pilares de las prácticas modernas de DataOps.
Otros sectores donde CDC tiene impacto directo
Herramientas populares para implementar CDC
El ecosistema de herramientas para CDC es amplio. Existen soluciones de código abierto, plataformas gestionadas en la nube y productos empresariales, cada una con un perfil distinto de casos de uso. La elección depende de tu base de datos de origen, el volumen de cambios y los recursos disponibles para configurar y mantener la infraestructura.
Debezium y Apache Kafka
Debezium es el proyecto de código abierto más adoptado para CDC basado en logs. Ofrece conectores nativos para MySQL, PostgreSQL, MongoDB, SQL Server y Oracle, entre otros. Funciona leyendo el log de transacciones de cada motor y publicando los eventos de cambio en tópicos de Apache Kafka, que actúa como capa de distribución hacia los sistemas de destino. Esta combinación es el referente de facto para arquitecturas de streaming a gran escala.
Apache Kafka no solo almacena los eventos de forma confiable, sino que permite que múltiples consumidores los lean de forma independiente y en paralelo. Un único flujo de cambios puede alimentar al mismo tiempo un data warehouse, un motor de búsqueda y un sistema de alertas, sin que los consumidores interfieran entre sí. Esa capacidad de difusión lo convierte en el complemento ideal para CDC en entornos distribuidos.
Otras soluciones del ecosistema
Más allá de Debezium, el mercado ofrece alternativas para distintos perfiles de usuario. Las plataformas en la nube como Google Cloud Datastream o AWS Database Migration Service proporcionan CDC gestionado sin necesidad de administrar infraestructura propia. Para entornos empresariales con requisitos estrictos de soporte y certificación, existen soluciones comerciales como Striim, Qlik Replicate o HVR que añaden interfaces visuales, monitoreo avanzado y conectores certificados para sistemas legados.
Ventajas y limitaciones de CDC
CDC no es la solución perfecta para todos los escenarios. Tiene ventajas claras que lo hacen muy atractivo en arquitecturas modernas, pero también limitaciones que debes considerar antes de adoptarlo. Conocer ambas caras te permite tomar decisiones de arquitectura más fundamentadas y evitar sorpresas en producción.
Ventajas principales de CDC:
- Baja latencia: Los datos llegan a los sistemas de destino en milisegundos o segundos después de producirse el cambio, sin esperar ventanas de procesamiento.
- Eficiencia en el uso de recursos: Al mover solo los registros modificados, el consumo de red, cómputo y almacenamiento es significativamente menor que en un proceso de carga completa.
- Captura de eliminaciones: A diferencia del procesamiento basado en marcas de tiempo, CDC detecta los DELETE de forma nativa, sin necesidad de lógica adicional en la aplicación.
- Pista de auditoría: El flujo de eventos generado por CDC documenta quién cambió qué y cuándo, lo que facilita el cumplimiento normativo y la trazabilidad del dato.
- Distribución a múltiples destinos: Un único flujo CDC puede alimentar varios sistemas al mismo tiempo, sin duplicar la carga sobre la base de datos de origen.
Limitaciones que debes tener en cuenta:
- Complejidad operativa: Configurar y mantener una canalización CDC requiere conocimiento del motor de base de datos, del formato del log de transacciones y de la infraestructura de mensajería.
- Dependencia de la estructura del log: Cambios en el esquema de la base de datos —nuevas columnas, renombramientos— pueden romper el flujo CDC si no se gestiona la evolución del esquema.
- Reordenación de eventos: En entornos distribuidos, garantizar el orden correcto de los eventos de cambio puede requerir configuración adicional y un diseño cuidadoso del consumidor.
- No todo motor lo soporta igual: Algunos motores de base de datos tienen soporte limitado o experimental para CDC basado en logs, lo que puede obligar a usar métodos menos eficientes.
Preguntas frecuentes
¿Qué significa CDC en ingeniería de datos?
CDC son las siglas de Change Data Capture, que en español se traduce como «captura de datos modificados». En el contexto de la ingeniería de datos, hace referencia a la técnica que permite identificar, registrar y transmitir los cambios producidos en una base de datos —inserciones, actualizaciones y eliminaciones— hacia otros sistemas, de forma continua y con baja latencia. Es un componente fundamental de los pipelines de datos modernos que requieren información fresca sin procesar volúmenes completos de datos en cada ciclo.
¿Cuál es la diferencia entre CDC y ETL?
ETL es el proceso de extraer datos de una fuente, transformarlos y cargarlos en un destino, generalmente en ciclos programados que mueven el conjunto completo o grandes porciones de datos. CDC, por su parte, es una estrategia de captura que opera dentro del proceso de extracción: detecta únicamente los cambios producidos desde la última captura y los transmite de forma continua. Dicho de otra forma, CDC puede ser parte de un pipeline ETL, pero ETL no reemplaza a CDC cuando el requisito es frescura del dato en tiempo real.
¿Qué es el CDC basado en logs y por qué es el más usado?
El CDC basado en logs lee el registro de transacciones que todos los motores de bases de datos relacionales mantienen internamente para garantizar la consistencia de los datos. Este registro contiene un historial de cada cambio confirmado. Al leerlo directamente, el motor CDC captura los cambios sin añadir carga extra a las operaciones normales de la base de datos, lo que lo convierte en el método más eficiente y de menor impacto. Su bajo overhead y su capacidad para capturar inserciones, actualizaciones y eliminaciones con alta fidelidad explican por qué se ha convertido en el estándar de la industria.
¿Cuándo conviene usar CDC en lugar de procesamiento por lotes?
CDC es la opción más adecuada cuando el negocio depende de que los datos en los sistemas de destino sean frescos —con latencia de segundos o minutos, no de horas—, cuando el volumen de registros hace que replicar la tabla entera sea demasiado costoso, o cuando necesitas capturar eliminaciones de registros de forma nativa. El procesamiento por lotes sigue siendo válido para cargas históricas, informes no urgentes o situaciones donde la complejidad operativa de CDC no se justifica.
¿Qué herramientas de código abierto existen para CDC?
Debezium es la herramienta de código abierto más adoptada para CDC basado en logs. Ofrece conectores para MySQL, PostgreSQL, MongoDB, SQL Server y Oracle, y se integra de forma nativa con Apache Kafka. Apache Kafka Connect es otro componente del mismo ecosistema que facilita la conexión entre fuentes y destinos. Para escenarios más específicos, proyectos como Maxwell’s Daemon (para MySQL) o pglogical (para PostgreSQL) ofrecen alternativas ligeras y bien documentadas.
¿Cómo afecta CDC al rendimiento de la base de datos de origen?
El impacto depende del método elegido. El CDC basado en logs tiene un efecto mínimo sobre la base de datos de origen porque lee el registro de transacciones de forma asíncrona, sin intervenir en el flujo de escritura de la aplicación. El CDC basado en disparadores, en cambio, añade una operación adicional por cada escritura, lo que puede degradar el rendimiento bajo carga alta. Para bases de datos de producción con alta concurrencia, el método log-based es siempre la opción preferida por su bajo overhead.
¿Es posible usar CDC con bases de datos en la nube?
Sí, y de hecho las principales plataformas en la nube ofrecen soporte nativo o servicios gestionados para CDC. Amazon RDS y Aurora tienen soporte para CDC a través de AWS Database Migration Service. Google Cloud ofrece Datastream como servicio de CDC gestionado para bases de datos relacionales. Azure dispone de CDC nativo en SQL Server y lo expone a través de Azure Data Factory. Además, herramientas como Debezium funcionan perfectamente con instancias de bases de datos en la nube cuando se configuran correctamente los permisos de acceso al log de transacciones.
Conclusión
Change Data Capture es la técnica que permite que los sistemas de datos modernos operen con información actualizada en tiempo real, sin el coste de replicar bases de datos completas en cada ciclo. Su lógica es simple y poderosa: captura solo lo que cambió, en el momento en que cambió, y lo transmite a donde se necesite.
A lo largo de este recorrido has visto cómo funciona el proceso paso a paso, qué métodos existen y cuándo cada uno tiene sentido, qué herramientas implementan CDC en la práctica y en qué escenarios reales marca la diferencia. Con ese mapa en mente, puedes identificar cuándo CDC es la pieza que falta en tu arquitectura de datos y qué método se adapta mejor a tu situación.
Si CDC ha despertado tu curiosidad por los pipelines de datos modernos, en este sitio web encontrarás más contenido sobre integración de datos, streaming y arquitecturas de ingeniería que te ayudarán a seguir construyendo ese conocimiento con solidez.
Sigue aprendiendo:
¿Cómo optimizar jobs de Apache Spark?
Pipeline de datos: El mecanismo que nadie te explica bien
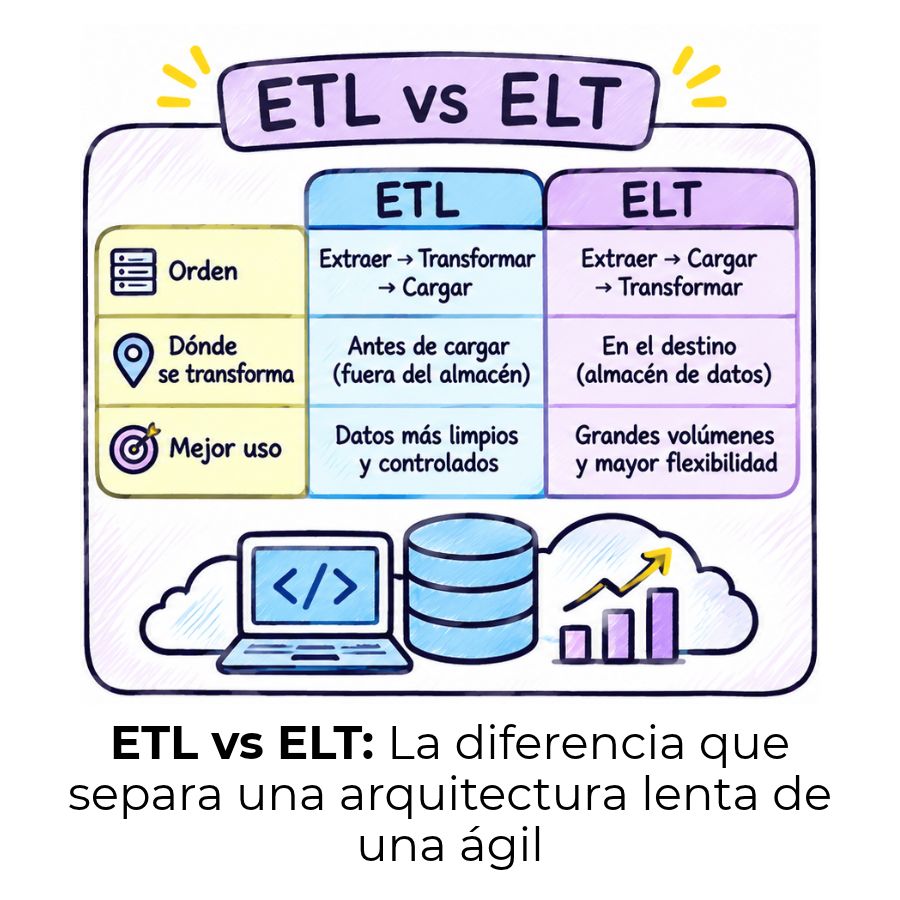
ETL vs. ELT: Transforma tus datos con la estrategia correcta
Arquitectura de datos: El secreto que mueve los datos de tu empresa
¿Qué es un data lake y cómo funciona?
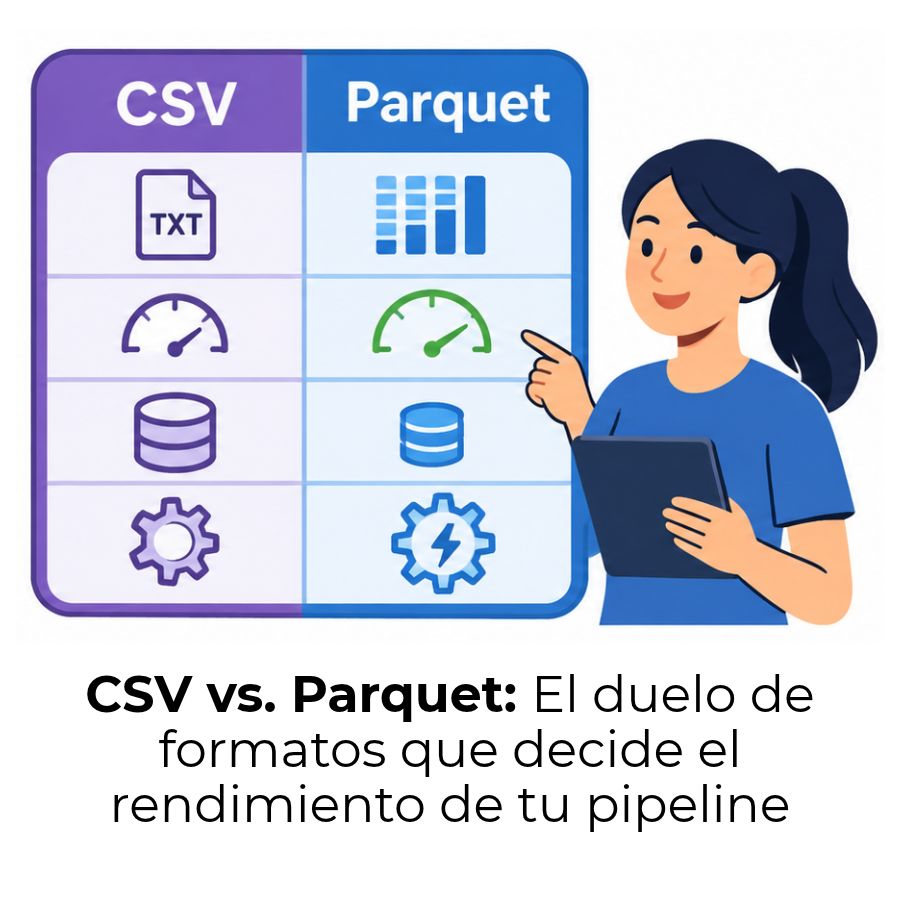
Diferencia entre Parquet y CSV
AWS Glue: El secreto detrás de los grandes pipelines de datos
Cómo ser ingeniero de datos desde cero
