
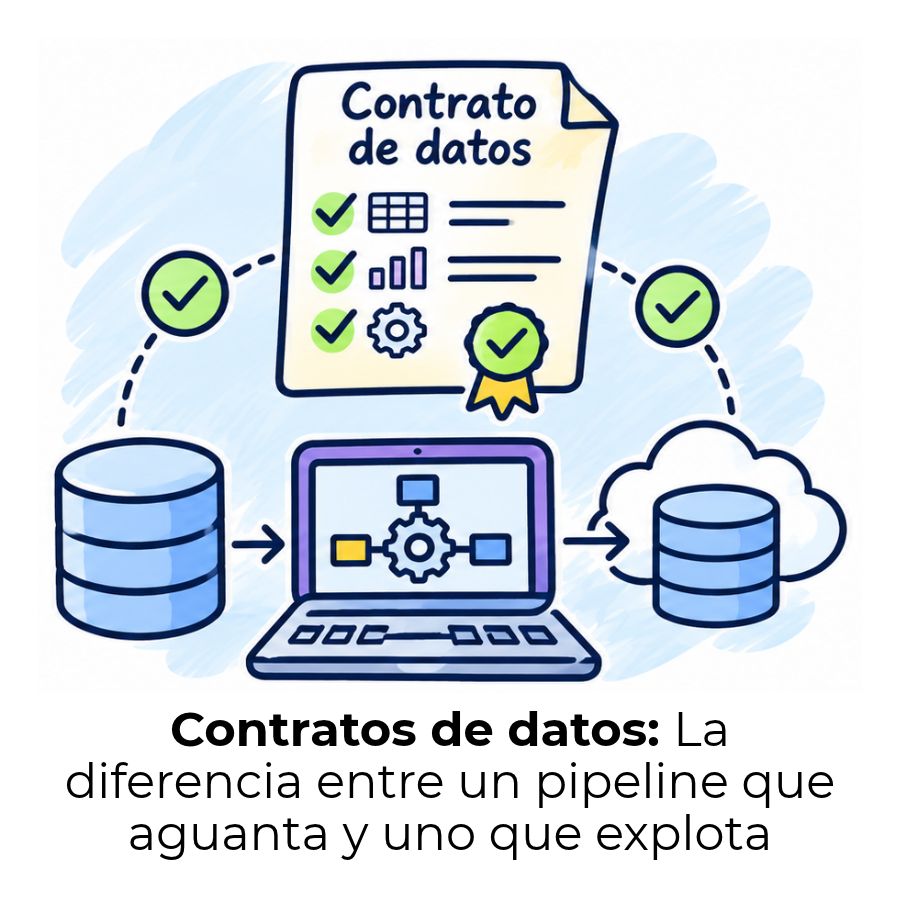
Imagina que llegas al trabajo y tu pipeline de datos falló durante la noche. Nadie cambió el código, pero alguien modificó un campo sin avisar. Esa situación, que les ocurre a muchos equipos, tiene solución. Y esa solución tiene nombre: contrato de datos.
¿Qué es un contrato de datos?
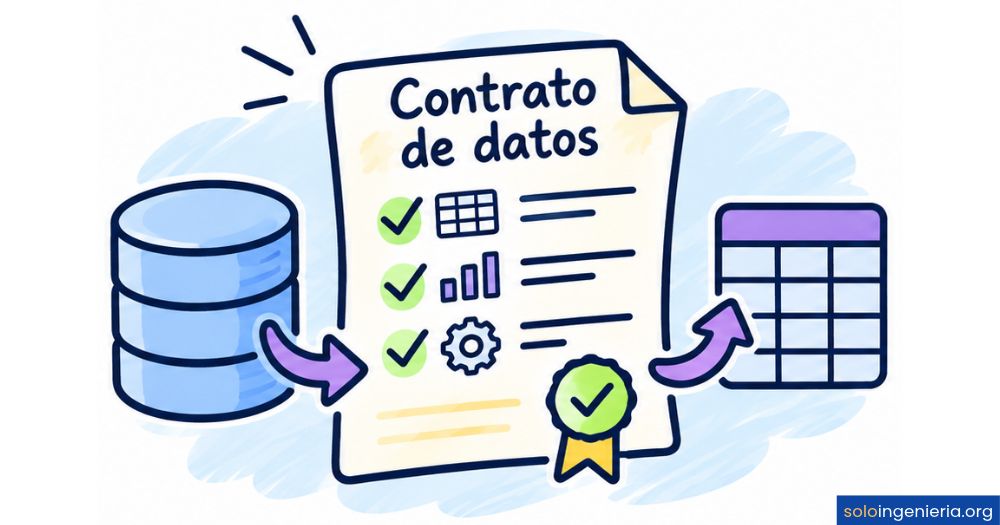
Un contrato de datos es un acuerdo formal, explícito y versionado entre quien produce un dataset y quienes lo consumen, que especifica qué campos contiene ese dataset, qué tipo de dato tiene cada campo, qué reglas de calidad debe cumplir y bajo qué condiciones de servicio se entrega. No es un documento de Word ni una hoja de cálculo compartida: es un archivo legible tanto por personas como por máquinas, generalmente escrito en YAML o JSON, que vive en un sistema de control de versiones.
La mejor analogía para entenderlo es la de un contrato de API. Cuando consumes una API, existe una especificación que te dice qué endpoints hay, qué parámetros recibe cada uno y qué formato devuelve. Un contrato de datos hace lo mismo, pero para datasets: te dice qué columnas vas a recibir, con qué tipos, con qué restricciones y con qué frecuencia de actualización. Si la API cambia sin avisar, tu código falla. Si el dataset cambia sin avisar, tu pipeline falla.
Diferencia entre un contrato de datos y un esquema
Un esquema describe la forma de los datos: qué columnas hay, qué tipo tiene cada una y si admite nulos. Es útil, pero incompleto. Un contrato de datos va mucho más allá: además del esquema, incluye el significado de cada campo, quién es el propietario, qué reglas de calidad deben cumplirse, con qué frecuencia se actualizarán los datos y cómo se gestionarán los cambios futuros. El esquema te dice cómo son los datos; el contrato te dice qué significan y quién responde por ellos.
Diferencia entre un contrato de datos y un SLA
Un SLA (acuerdo de nivel de servicio) se centra exclusivamente en compromisos operativos: disponibilidad del sistema, latencia de entrega o porcentaje de tiempo activo. El contrato de datos absorbe el SLA como uno de sus componentes, pero añade el esquema, las reglas de calidad, la semántica de cada campo y la política de cambios. Dicho de otra forma: el SLA te garantiza que los datos llegarán a tiempo; el contrato de datos te garantiza que, cuando lleguen, tendrán el formato, el significado y la calidad que esperabas.
¿Por qué fallan los pipelines sin contratos de datos?
La causa más frecuente de fallos en pipelines de datos no es un error de código. Es una expectativa no escrita. Un equipo de ingeniería modifica el nombre de una columna o cambia un tipo de dato de cadena a entero, y ningún consumidor lo sabe hasta que sus dashboards o modelos de machine learning empiezan a devolver errores. El problema no es el cambio en sí, sino que nadie acordó cómo comunicarlo. Los contratos de datos institucionalizan esa comunicación antes de que ocurra el problema.
- Un campo cambia de tipo sin aviso
- El pipeline falla en producción
- Los consumidores no saben a quién acudir
- Se pierde tiempo depurando en lugar de construir
- La confianza entre equipos se deteriora
- Los cambios se anuncian y versionan
- Las validaciones detectan roturas antes del despliegue
- Hay un propietario explícito para cada dataset
- Los consumidores saben exactamente qué esperar
- Los equipos colaboran con confianza
Otro escenario habitual es el de los equipos de machine learning. Un modelo se entrena con datos que cumplen ciertas distribuciones y formatos. Si el pipeline de ingesta cambia sin aviso, el modelo puede seguir funcionando técnicamente, pero con un rendimiento degradado que nadie detecta durante semanas. Un contrato de datos fuerza a que cualquier cambio en la fuente pase primero por una revisión acordada, lo que convierte un problema silencioso en uno visible y tratable.
Componentes de un contrato de datos
Un contrato de datos no es un único campo o una sola sección: es un documento estructurado que agrupa varias capas de información, cada una con una función distinta. Entender qué contiene cada capa es el primer paso para saber escribir o evaluar un contrato correctamente.
Esquema y tipos de datos
El esquema es la base de cualquier contrato. Define qué columnas existen en el dataset, qué tipo de dato tiene cada una (cadena de texto, entero, fecha, booleano), si puede contener valores nulos y cuáles son los valores permitidos para los campos enumerados. Sin un esquema explícito y versionado, cualquier cambio en la fuente de datos puede romper silenciosamente todos los procesos que dependían de él. El esquema también documenta las claves primarias y las relaciones entre campos, que son esenciales para que los consumidores interpreten el dataset correctamente.
Reglas de calidad
Las reglas de calidad convierten el contrato en un estándar de validación, no solo en un documento descriptivo. Especifican condiciones que el dataset debe cumplir antes de considerarse válido: ausencia de registros duplicados, completitud de campos obligatorios, rangos válidos para valores numéricos e integridad referencial entre tablas. Estas reglas se ejecutan automáticamente en el pipeline y, cuando alguna falla, se genera una alerta que llega al propietario del dataset, deteniendo el flujo antes de que los datos corruptos lleguen a los consumidores.
Propiedad y responsabilidad
Cada contrato de datos debe tener un propietario identificado. Eso significa que hay un equipo o una persona concreta que responde cuando el dataset falla, que gestiona las solicitudes de cambio y que mantiene el contrato actualizado. La propiedad es uno de los puntos más importantes del contrato porque elimina la ambigüedad que provoca que nadie actúe cuando hay un problema. El contrato también indica el canal de contacto para incidentes, que suele ser un canal de Slack, un correo de equipo o un sistema de tickets.
Niveles de servicio (SLA)
El componente de SLA dentro de un contrato de datos define compromisos operativos concretos: con qué frecuencia se actualizará el dataset, cuál es la latencia máxima aceptable desde que se generan los datos hasta que están disponibles para los consumidores y qué disponibilidad se garantiza. Incluir el SLA en el contrato hace que esas expectativas sean parte del acuerdo formal, no una suposición verbal. Si el dataset no cumple el SLA definido, el sistema de monitorización lo detecta y lo notifica de forma automática al equipo responsable.
¿Cómo se implementa un contrato de datos?
Implementar un contrato de datos no requiere herramientas complejas desde el primer día. Lo que sí requiere es un proceso claro que involucre tanto al equipo productor como a los equipos consumidores antes de que el dataset esté en producción. A continuación se detalla el flujo habitual que siguen los equipos que adoptan esta práctica.
Enfoque contract-first
El enfoque contract-first invierte el orden habitual de trabajo. En lugar de producir los datos primero y documentarlos después, el contrato se escribe antes de que el dataset exista. Los consumidores y el productor acuerdan el esquema, las reglas de calidad y los SLAs desde el inicio, y el pipeline se construye para cumplir ese acuerdo. Este enfoque elimina la mayoría de las sorpresas porque todos los equipos trabajan con las mismas expectativas desde el primer día, sin necesidad de renegociar después de que algo ya está en producción.
Validación en pipelines CI/CD
Integrar la validación del contrato en el pipeline de integración y despliegue continuo (CI/CD) es lo que convierte el documento en un mecanismo de control real. Cada vez que se propone un cambio en el dataset, el sistema comprueba automáticamente si ese cambio viola el contrato: si añade campos opcionales, el contrato puede evolucionar sin romper a los consumidores; si elimina campos o cambia tipos, se bloquea el despliegue hasta que los consumidores aprueben el cambio. Esta integración hace que el cumplimiento del contrato sea automático, no manual.
Ejemplo real de un contrato de datos en YAML
Un contrato de datos escrito en YAML parece, a primera vista, un archivo de configuración técnico. Pero si lo lees con calma, verás que cada sección responde a una pregunta concreta: ¿qué datos hay, quién los produce, qué calidad deben tener y cuándo estarán disponibles? El siguiente ejemplo modela un contrato para una tabla de pedidos en un sistema de comercio electrónico.
apiVersion: v2.1.0

id: orders-v1
name: Pedidos confirmados
version: 1.0.0
status: active
description: >
  Dataset con los pedidos confirmados del sistema de e-commerce.
  Contiene únicamente los pedidos en estado pending, complete o cancelled.
  Excluye pedidos de prueba y pedidos internos.

# ─── PROPIETARIO ───────────────────────────────────────────
owner:
  team: data-engineering
  steward: revenue-analytics
  contact: #data-contracts (Slack)

# ─── ESQUEMA ────────────────────────────────────────────────
schema:
  fields:
    - name: order_id
      type: string
      primaryKey: true
      nullable: false
      description: Identificador único del pedido (UUID v4)

    - name: customer_id
      type: string
      nullable: false
      description: Identificador del cliente. Referencia a customers.customer_id

    - name: order_status
      type: string
      nullable: false
      enum: [pending, complete, cancelled]
      description: Estado actual del pedido

    - name: order_total_eur
      type: float
      nullable: false
      minimum: 0.01
      description: Importe total del pedido en euros, impuestos incluidos

    - name: created_at
      type: timestamp
      nullable: false
      description: Fecha y hora de creación del pedido (UTC)

# ─── CALIDAD ────────────────────────────────────────────────
quality:
  rules:
    - name: sin_duplicados
      check: order_id es único en toda la tabla
      threshold: 0 duplicados permitidos

    - name: completitud_campos_clave
      check: order_id, customer_id y created_at no pueden ser nulos

    - name: importe_positivo
      check: order_total_eur > 0 en todos los registros

    - name: estado_valido
      check: order_status pertenece al enum declarado

# ─── NIVELES DE SERVICIO ────────────────────────────────────
sla:
  freshness: 15 minutos desde la generación del evento
  availability: 99.5 % mensual
  support_response: 4 horas en días laborables

# ─── VERSIÓN Y POLÍTICA DE CAMBIOS ─────────────────────────
versioning:
  breaking_changes: requieren aprobación de todos los consumidores
  deprecation_notice: 30 días antes de cualquier cambio mayor
  changelog: CHANGELOG.md en el mismo repositorio
Fíjate en que el contrato no solo dice qué columnas hay, sino que explica qué significa cada una, quién la mantiene y bajo qué condiciones puede cambiar. Cada campo del contrato responde a una pregunta real que cualquier consumidor se haría antes de confiar en ese dataset para alimentar un modelo, un dashboard o un proceso de negocio crítico. Ese es el propósito fundamental del documento.
Contratos de datos y data mesh
El campo de la ingeniería de datos ha evolucionado hacia arquitecturas distribuidas donde cada dominio de negocio gestiona sus propios datos. En ese modelo, conocido como data mesh, cada equipo es responsable de producir datos de calidad para el resto de la organización. Los contratos de datos son la pieza que hace posible esa autonomía sin sacrificar la fiabilidad: cada equipo publica sus datasets con un contrato explícito que otros equipos pueden consumir con confianza, sin depender de un equipo central de datos para validar cada entrega.
Sin contratos de datos, una arquitectura data mesh produce datasets que nadie se atreve a usar en producción. Con contratos, cada dataset tiene una interfaz versionada y aplicable que lo convierte en un producto de datos confiable.
En la práctica, esto significa que el equipo de ventas puede publicar su tabla de oportunidades con un contrato que garantiza su esquema, su calidad y su frescura, y el equipo de finanzas puede consumirla sin necesidad de entender cómo se genera internamente. El contrato actúa como la interfaz pública del dataset, exactamente igual que una API pública actúa como la interfaz de un microservicio. Puedes cambiar la implementación interna tanto como quieras; lo que no puedes cambiar sin aviso es lo que el contrato promete. También es relevante conocer el linaje de datos para entender de dónde vienen los datos que sustentan cada contrato.
Herramientas para trabajar con contratos de datos
Existen varias herramientas que facilitan la creación, validación y gestión de contratos de datos dentro de un stack moderno. Ninguna es obligatoria al empezar: puedes comenzar con un archivo YAML en un repositorio de Git y evolucionar hacia plataformas más especializadas conforme tu equipo madure. Lo importante no es la herramienta, sino establecer el hábito de acordar y versionar las expectativas sobre los datos.
La elección de herramienta depende de tu stack actual y de la madurez de tu equipo. Si ya usas dbt para transformaciones, activar los contratos nativos de dbt es el camino más directo. Si tienes pipelines en Python, Soda Core o Great Expectations se integran con facilidad. Lo que no deberías hacer es esperar a tener la herramienta perfecta antes de empezar a formalizar acuerdos: un contrato en YAML bien escrito y versionado en Git ya es infinitamente mejor que ningún contrato.
Preguntas frecuentes
¿Qué diferencia hay entre un contrato de datos y una política de gobernanza?
Una política de gobernanza es una norma organizacional de alto nivel que establece cómo deben gestionarse los datos en toda la empresa: quién puede acceder a qué, durante cuánto tiempo se retienen, cómo se protege la privacidad. Un contrato de datos es específico a un dataset concreto y regula la relación técnica y operativa entre el productor y los consumidores de ese dataset. Dicho de otra forma, la gobernanza define las reglas del juego para todos los datos; el contrato aplica esas reglas a un conjunto de datos en particular, añadiendo esquema, calidad y SLAs que la política general no especifica.
¿Quién escribe y mantiene un contrato de datos?
El contrato lo escribe principalmente el equipo productor del dataset, pero no de forma unilateral. Los consumidores participan en la definición inicial para asegurarse de que el contrato responde a sus necesidades reales. Una vez en producción, el propietario declarado en el contrato es responsable de mantenerlo actualizado, de coordinar los cambios con los consumidores y de garantizar que las validaciones automáticas sigan pasando. En equipos grandes, esta responsabilidad recae normalmente en el ingeniero de datos o en el data steward asignado al dominio correspondiente.
¿Los contratos de datos sirven para pipelines en tiempo real?
Sí, y de hecho son especialmente útiles en contextos de streaming. En pipelines de tiempo real basados en Kafka u otras plataformas de eventos, el contrato define el formato del mensaje, las claves de partición, la semántica de los campos y las garantías de entrega. Si un productor emite un evento con un campo nuevo o cambia el tipo de un campo existente, el sistema de validación detecta inmediatamente la violación del contrato antes de que los consumidores del stream reciban datos con un formato inesperado. Herramientas como Confluent Schema Registry permiten aplicar contratos a nivel de tópico en Kafka.
¿Un contrato de datos reemplaza las pruebas de calidad?
No los reemplaza, los complementa con una lógica diferente. Las pruebas de calidad comprueban valores concretos dentro de los datos, como que no haya nulos donde no se esperan o que los importes sean positivos. El contrato actúa antes y es más amplio: define toda la interfaz productor-consumidor (esquema, tipos, semántica, SLA y propietario) y bloquea los cambios no acordados antes de que lleguen a producción. Las pruebas de calidad detectan problemas en los valores; el contrato previene problemas en la estructura y en los acuerdos entre equipos. Usados juntos, cubren dos capas distintas del ciclo de vida del dato.
¿Qué lenguaje se usa para escribir contratos de datos?
YAML es el formato más extendido porque combina legibilidad humana con compatibilidad con herramientas automáticas. JSON es una alternativa válida, especialmente cuando el contrato se integra con APIs o plataformas que ya lo utilizan. El estándar abierto más adoptado hoy es el Open Data Contract Standard (ODCS), promovido por el proyecto Bitol bajo licencia Apache 2.0, que define una estructura YAML con secciones estandarizadas para esquema, calidad, SLA, propiedad y versión. Usar un estándar abierto facilita la interoperabilidad entre herramientas y la adopción por parte de nuevos miembros del equipo.
¿Cuándo es obligatorio versionar un contrato de datos?
Desde el primer día. Versionar el contrato desde el inicio no añade complejidad significativa y evita problemas graves a medida que el dataset evoluciona. El versionado semántico (MAJOR.MINOR.PATCH) es el enfoque más habitual: se incrementa la versión mayor cuando hay cambios que rompen la compatibilidad con los consumidores, la versión menor cuando se añaden campos opcionales nuevos y la versión de parche cuando solo se corrigen errores en la documentación o en las reglas de calidad. Los consumidores suscriben una versión específica del contrato y reciben notificación cuando hay cambios mayores que requieren su aprobación antes del despliegue.
¿Qué pasa cuando se viola un contrato de datos?
Cuando el sistema detecta que los datos no cumplen el contrato, el comportamiento esperado depende de dónde se integra la validación. En un pipeline CI/CD, el despliegue se bloquea automáticamente y se notifica al propietario del dataset para que corrija el problema antes de que llegue a producción. En un pipeline de ingesta en tiempo real, el mensaje o el lote que viola el contrato puede enrutarse a una cola de errores para su revisión manual, en lugar de procesarse y propagar datos incorrectos a los consumidores. El objetivo en ambos casos es el mismo: que los datos defectuosos nunca alcancen los sistemas que dependen de ellos.
Conclusión
Un contrato de datos es mucho más que un documento técnico: es el acuerdo que hace posible que dos equipos trabajen con los mismos datos sin sorpresas. Cuando formalizas las expectativas sobre un dataset (su esquema, su calidad, su propietario y sus niveles de servicio), transformas una promesa implícita en un compromiso verificable y versionado que todos pueden consultar y validar automáticamente.
Lo que has leído aquí te da los fundamentos para empezar: entiendes qué es un contrato de datos, qué contiene cada una de sus secciones, cómo se implementa paso a paso y en qué se diferencia de conceptos cercanos como el esquema, el SLA o las pruebas de calidad. El siguiente paso práctico es tomar un dataset que uses habitualmente y escribir su primer contrato, aunque sea en un archivo YAML sencillo en un repositorio de Git. Empezar pequeño y versionar desde el primer día es suficiente para notar la diferencia.
La ingeniería de datos avanza rápido, y los contratos de datos son solo una de las piezas que construyen equipos más fiables y colaborativos. Si este tema te ha resultado útil, en este sitio web encontrarás más contenido sobre arquitecturas de datos, buenas prácticas de ingeniería y conceptos que te ayudarán a seguir desarrollando tu criterio técnico.
Sigue aprendiendo:
100 preguntas de entrevista para ingeniero de datos
¿Qué hace un ingeniero de datos?
Procesamiento de datos en tiempo real
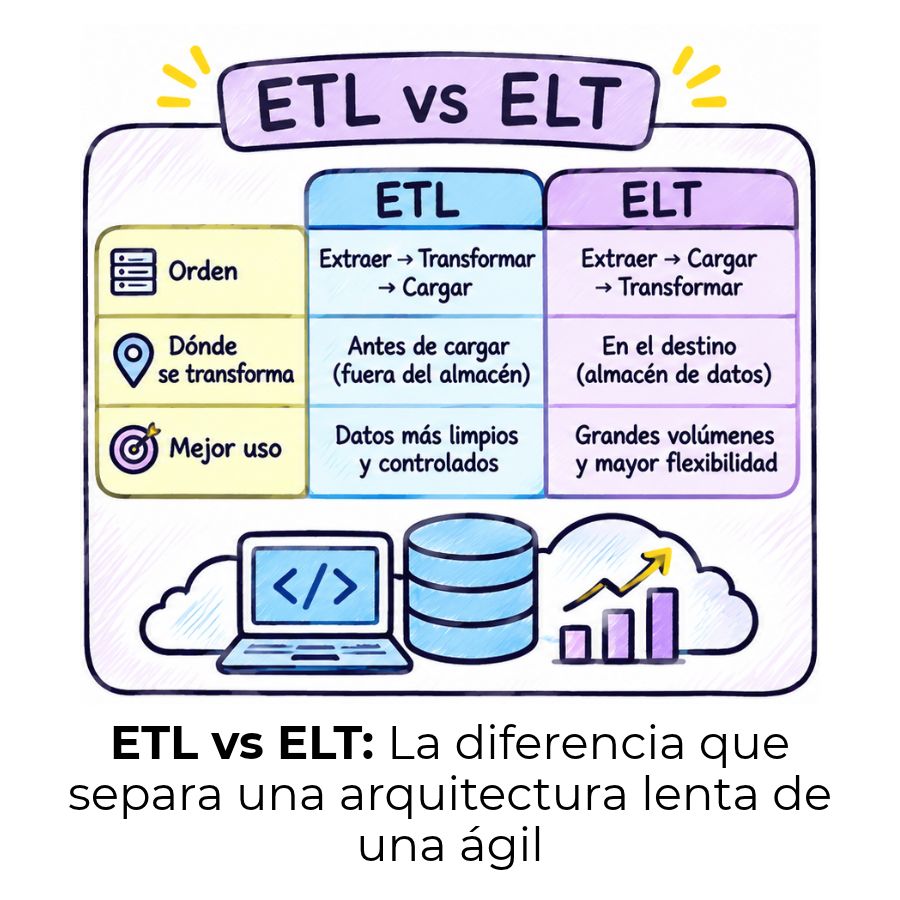
ETL vs. ELT: Transforma tus datos con la estrategia correcta
¿Qué lenguaje aprender para ser ingeniero de datos?
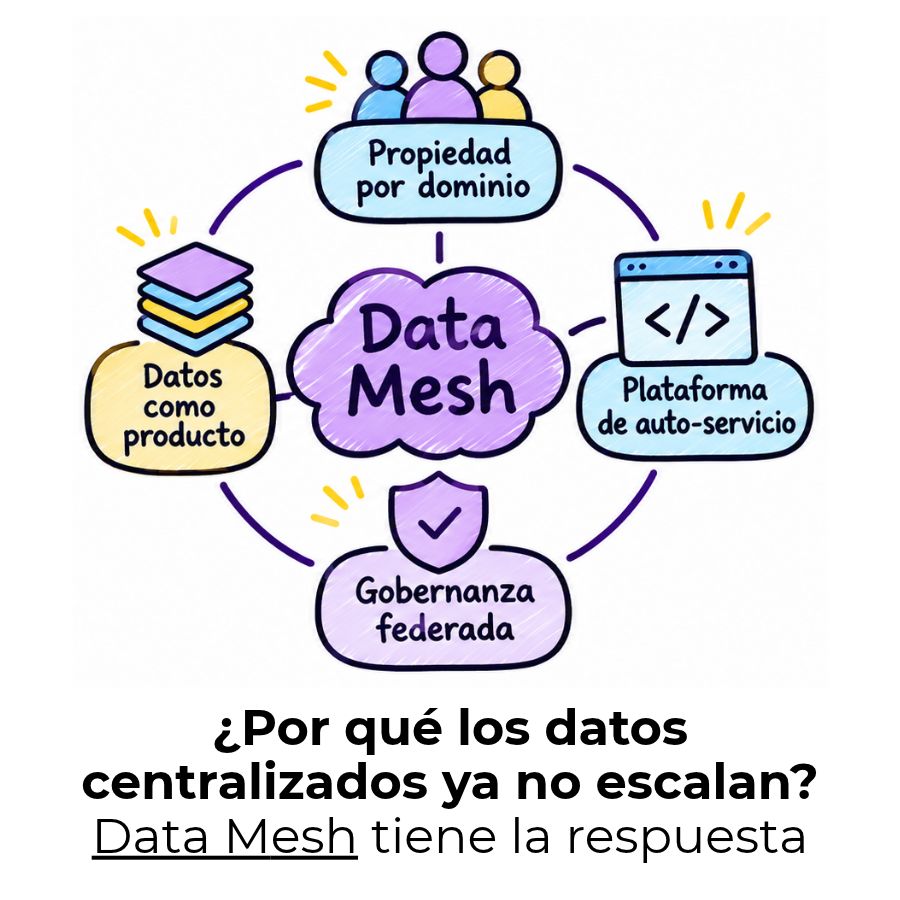
Data Mesh: La arquitectura que descentraliza datos
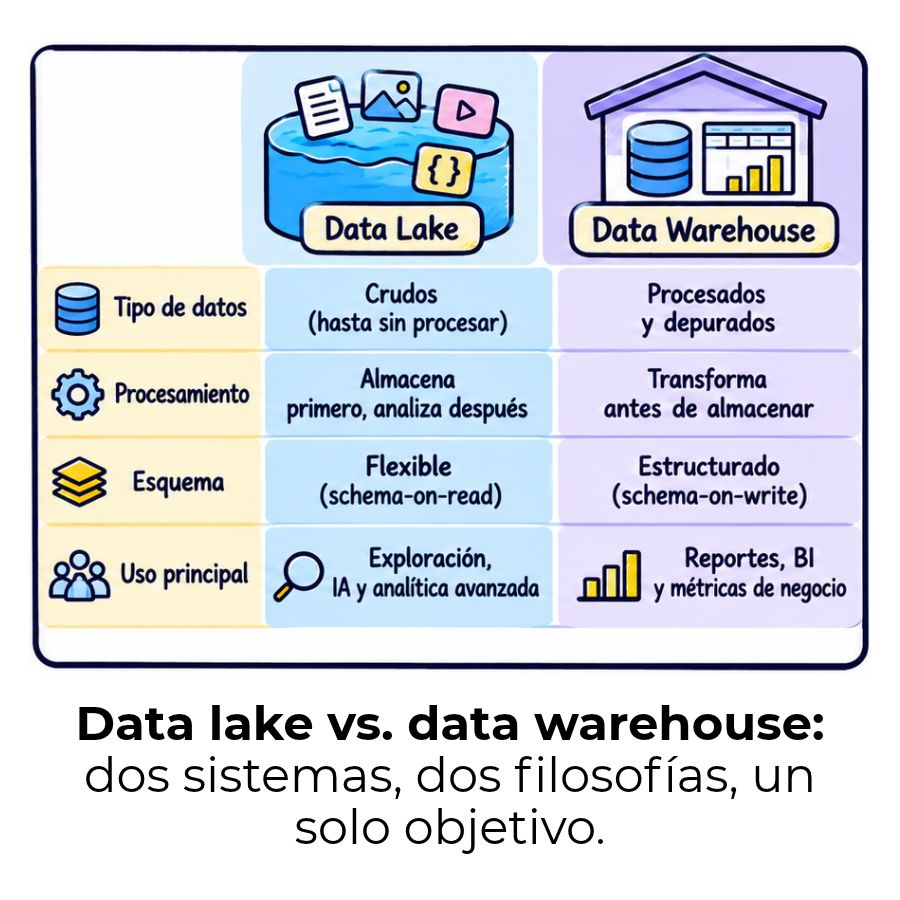
Diferencia entre data lake y data warehouse
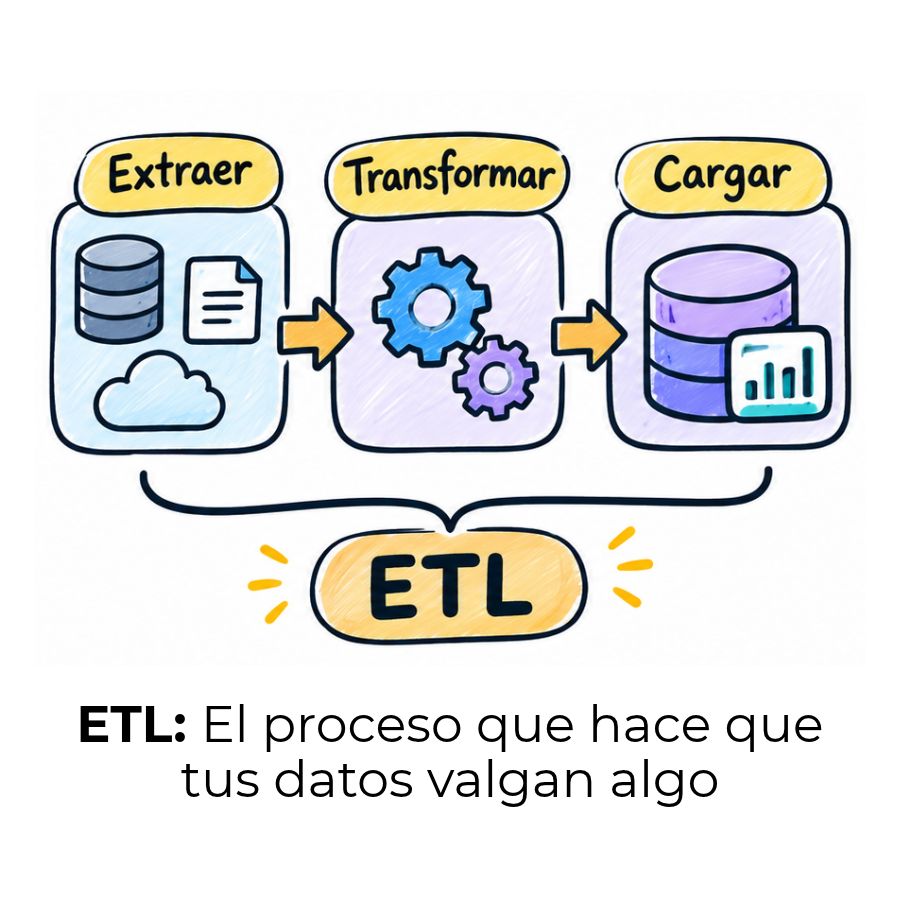
¿Qué es ETL? – Extracción, Transformación y Carga
